1. Self-Attention
1. 왜 RNN 없이 Attention을 사용하는가?
RNN은 이전 시점의 hidden state를 다음 시점으로 전달하면서 단어를 순서대로 처리한다.
단어1 → 단어2 → 단어3 → 단어4
  h1  →  h2  →  h3  →  h4
하지만 Attention을 사용하면 멀리 떨어진 단어의 정보도 직접 참고할 수 있다.
그렇다면 RNN처럼 정보를 순서대로 전달하지 않고,
Attention만으로 단어 간 관계를 계산할 수 있지 않을까?
이러한 아이디어가 Self-Attention으로 이어진다.
2. RNN의 한계
장기 의존성
- RNN은 입력을 왼쪽에서 오른쪽으로 순차적으로 처리한다.
- 멀리 떨어진 두 단어의 관계를 파악하려면 여러 단계를 거쳐야 한다.
- 단어 사이의 거리가 멀어질수록 정보 전달과 학습이 어려워질 수 있다.
- 최대 상호작용 거리는
O(sequence length)이다.
예시)
The chef who ............... was
    ↑                        ↑
    여러 단계를 거쳐야 관계를 파악
병렬화가 어렵다.
h2를 계산하려면 먼저h1이 필요하다.h3를 계산하려면 먼저h2가 필요하다.- 따라서 모든 단어를 동시에 계산하기 어렵다.
- 대규모 데이터 학습에서 GPU를 효율적으로 활용하기 어렵다.
3. Self-Attention
Self-Attention은 같은 문장 안의 단어들이 서로를 직접 참고하여 단어 간 관계를 학습하는 방법이다.
기존 Seq2Seq Attention
Decoder가 단어를 생성할 때 Encoder의 단어들을 참고한다.
Encoder 입력 문장
↓
h1  h2  h3  h4  h5
 \   |   |   |   /
      ↓ 참고
   Decoder
      ↓
   출력 단어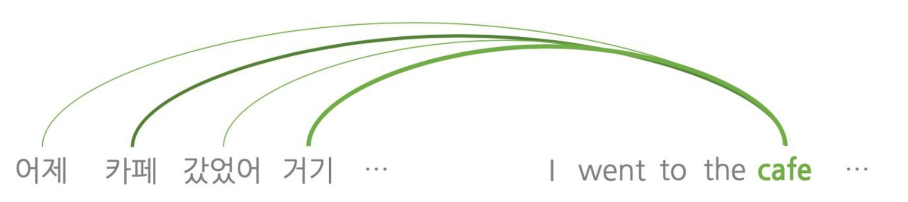
즉,
Decoder → Encoder를 참고
하는 구조이다.
Self-Attention
Self-Attention에서는 같은 문장 안의 단어들이 서로를 참고한다.
단어1 ↔ 단어2 ↔ 단어3 ↔ 단어4
  ↖      ↕       ↕      ↗
      서로 관계 계산
예를 들어
어제 카페 갔었어 거기 사람 많더라에서 거기라는 단어를 이해하기 위해 같은 문장 안의 카페와 같은 단어를 직접 참고할 수 있다.
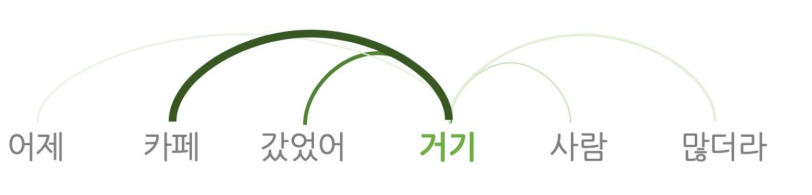
즉, 문장 내부의 단어 ↔ 문장 내부의 다른 단어
사이의 관계를 계산하는 것이 Self-Attention이다.
4. Self-Attention의 장점
장기 의존성 처리에 유리
- 멀리 떨어진 단어끼리도 직접 관계를 계산할 수 있다.
- 여러
hidden state를 순서대로 거칠 필요가 없다. - 최대 상호작용 거리는
O(1)이다.
병렬 처리가 가능
- RNN처럼 이전 단어의 계산이 끝날 때까지 기다릴 필요가 없다.
- 여러 단어의 Attention을 동시에 계산할 수 있다.
단어 간 관계를 직접 학습
- 각 단어가 문장 안의 다른 단어들을 직접 참고한다.
- 현재 단어와 관련성이 높은 단어에 더 집중할 수 있다.
5. Seq2Seq Attention vs Self-Attention
| Seq2Seq Attention | Self-Attention |
|---|---|
| Decoder가 Encoder의 단어를 참고 | 같은 문장 내부의 단어들이 서로 참고 |
| Encoder ↔ Decoder 사이의 관계를 계산 | 단어 ↔ 단어 사이의 관계를 계산 |
| 출력 단어를 만들 때 입력 문장의 필요한 부분에 집중 | 각 단어의 의미를 만들 때 같은 문장의 다른 단어에 집중 |
Attention = 다른 시퀀스를 참고
Self-Attention = 자기 자신이 속한 시퀀스 내부를 참고
6. Self-Attention의 Query, Key, Value
Self-Attention에서는 각 단어를 바로 서로 비교하는 것이 아니라,
각 단어를 Query(Q), Key(K), Value(V) 벡터로 변환한다.
Query, Key, Value
Query (Q)
현재 단어가 다른 단어에서 어떤 정보를 찾고 싶은지를 나타내는 벡터
쉽게 말하면:
"나는 지금 어떤 정보를 찾고 있지?"
Key (K)
각 단어가 자신이 어떤 정보를 가지고 있는지를 나타내는 벡터
쉽게 말하면:
"나는 이런 정보를 가지고 있어."
Value (V)
실제로 다른 단어가 참고하게 될 정보를 담고 있는 벡터
쉽게 말하면:
"나를 참고한다면 이 정보를 가져가."
따라서 각 단어마다
단어
 ↓
├─ Query
├─ Key
└─ Value
3개의 벡터가 만들어진다.
Self-Attention 계산 과정
1단계: 각 단어에서 Q, K, V 생성
각 단어를 Query, Key, Value 벡터로 변환한다.
단어 i
  ↓
┌─ qi : Query
├─ ki : Key
└─ vi : Value
2단계: Query와 Key를 비교
현재 단어의 Query와 다른 단어들의 Key를 비교해서
두 단어가 얼마나 관련 있는지 계산한다.
현재 단어의 Query
        ↓
다른 단어들의 Key와 비교
        ↓
    관련성 점수 계산
수식으로는
eᵢⱼ = qᵢᵀkⱼ- 점수가 크다 → 두 단어의 관련성이 높다.
- 점수가 작다 → 관련성이 낮다.
이 점수에 Softmax를 적용하여 각 단어에 줄 Attention 가중치를 구한다.
αᵢⱼ = softmax(eᵢⱼ)3단계: Value에서 필요한 정보를 가져온다.
Attention 가중치를 각 단어의 Value에 곱하여 필요한 정보를 가져온다.
oᵢ = Σ αᵢⱼvⱼ즉,
Query로 필요한 정보 검색
↓
Key와 비교해서 관련성 계산
↓
관련성이 높은 Value를 많이 가져옴
↓
새로운 단어 표현 생성이라고 이해하면 된다.
7. Self-Attention의 한계
Self-Attention은 단어 간 관계를 효율적으로 계산할 수 있지만 한계도 존재한다.
순서 정보 부족
- Self-Attention은 기본적으로 단어 간 유사도를 계산한다.
- 따라서 단어가 문장에서 몇 번째 위치에 있는지에 대한 순서 정보를 자체적으로 고려하지 않는다.
즉, RNN처럼
단어1 → 단어2 → 단어3의 순서가 구조 자체에 포함되어 있지 않다.
비선형성 부족
- Attention 계산은 본질적으로 여러
Value를 가중 평균하는 형태이다. - 따라서 Attention 계산만으로는 복잡한 패턴이나 깊은 표현을 학습하는 데 한계가 있다.
미래 참조 문제
언어 모델은 문장을 왼쪽에서 오른쪽으로 생성해야 한다.
나는 → 오늘 → 학교에 → ?현재 시점에서는 아직 생성되지 않은 미래 단어를 보면 안 된다.
하지만 Self-Attention은 기본적으로 모든 단어를 동시에 보기 때문에
아직 생성되지 않은 미래 단어까지 참고할 수 있는 문제가 발생한다.
Self-Attention 한계 해결
- 순서 정보 부족
Positional Encoding을 사용하여 각 단어에 위치 정보를 추가한다.
- 비선형성 부족
Feed Forward Network(FFN)와 활성화 함수를 사용하여 복잡한 패턴을 학습한다.
- 미래 참조 문제
Masking(Causal Mask)을 사용하여 현재 시점 이후의 단어를 보지 못하게 한다.
2. Transformer
Transformer는 RNN 없이 Attention을 중심으로 문장의 단어 관계를 처리하는 신경망 아키텍처이다.
1. Multi-Headed Attention
- 문장에서 같은 단어라도 여러 이유 (문법적 관계, 의미적 맥락 등)로 다른 단어에 주목할 수 있다.
- 단일
Self-Attention Head로는 한가지 관점에서의 단어 간 관계 밖에 파악할 수 없다
→ 따라서 여러 Attention Head를 두어 다양한 관점에서 동시에 정보를 파악한다.
2. Scaled Dot-Product Attention
Self-Attention에서는 Query(Q)와 Key(K)의 내적으로 단어 간 관련성을 계산한다.
하지만 Q와 K의 차원이 커지면 내적값도 너무 커질 수 있고,
Softmax 값이 한쪽으로 지나치게 몰려 학습이 불안정해질 수 있다.
따라서 내적값을 √d_k로 나누어 크기를 조절한다.
Q와 K 내적
    ↓
√d_k로 나눔
    ↓
Softmax
    ↓
Attention 가중치 계산
    ↓
Value에 적용
Scaled Dot-Product = Attention 점수가 너무 커지지 않도록 크기를 조절하는 방법
3. Residual Connection
신경망이 깊어질수록 기울기 소실이나 폭주로 인해 학습이 어려워질 수 있다.
Residual Connection은 Layer를 통과한 결과에 원래 입력값을 다시 더해주는 방법이다.
입력 x
 ├──────────┐
 ↓          │
Layer       │
 ↓          │
결과 + x ←──┘- 원래 정보를 계속 유지할 수 있다.
- 깊은 신경망에서도 정보와 기울기가 잘 전달되도록 돕는다.
Residual Connection = Layer 결과 + 원래 입력
4. Layer Normalization
신경망의 층이 깊어지면 각 Layer에서 값의 크기가 달라져 학습이 불안정해질 수 있다.
Layer Normalization은 각 Layer의 값을 정규화하여 학습을 안정적으로 만들어준다.
Transformer에서는 Residual Connection과 Layer Normalization을 함께 사용한다.
Add & Norm = Residual Connection + Layer Normalization
5. Transformer Encoder
Encoder에서는 입력 문장이 처음부터 전부 주어진다.
예를 들어
나는 오늘 학교에 간다라는 문장이 들어오면 모든 단어를 이미 알고 있기 때문에
각 단어가 앞뒤의 모든 단어를 참고할 수 있다.
따라서 Encoder의 Self-Attention에는 Masking을 사용하지 않는다.
- 모든 입력 단어를 서로 참고할 수 있다.
- 앞뒤 문맥을 모두 활용하는 양방향 문맥을 사용한다.
Encoder = Masking 없이 전체 입력 문장을 참고
6. Transformer Decoder
Decoder는 현재까지 생성된 단어를 이용해 다음 단어를 예측한다.
예를 들어
나는 오늘 학교에 ?에서 다음 단어를 예측할 때 정답인 미래 단어를 미리 보면 안 된다.
따라서 Decoder에서는 Masked Self-Attention을 사용한다.
- 아직 생성되지 않은 미래 단어를 가린다.
- 현재까지 생성된 단어만 이용해 다음 단어를 예측한다.
Decoder = Masking을 이용해 미래 단어를 보지 못하게 함
Decoder 내부에는 Feed-Forward Network도 존재하며,
Attention을 거친 각 단어의 표현을 한 번 더 변환한다.
7. Encoder와 Decoder의 차이
| Encoder | Decoder |
|---|---|
| 모든 입력 단어를 참고 | 현재까지 생성된 단어만 참고 |
| Masking 사용 X | Masked Self-Attention 사용 |
| 양방향 문맥 | 단방향 문맥 |
| 입력 문장을 이해 | 출력 문장을 생성 |
8. Cross-Attention
번역에서는 Decoder가 자기 문장만 봐서는 입력 문장의 내용을 알 수 없다.
따라서 Decoder가 Encoder에서 처리한 입력 문장의 정보도 참고해야 한다.
이때 사용하는 것이 Cross-Attention이다.
Encoder의 출력
      ↓
Cross-Attention
      ↑
   Decoder
Cross-Attention에서는
Query(Q)→ Decoder에서 가져온다.Key(K)→ Encoder에서 가져온다.Value(V)→ Encoder에서 가져온다.
즉,
Decoder가 Q를 이용해 Encoder의 K와 비교하고, 필요한 V 정보를 가져오는 방식이다.
9. Transformer의 결과
Neural Machine Translation task에서 당시 최고 성능을 달성했을 뿐 아니라, 가장 효율적인 학습으로 비용까지 절감할 수 있었다.
💡Transformer의 등장은 대부분 최신 모델들이 성능 향상을 위해 사전학습을 결합하도록 했다. 또한 뛰어난 병렬 처리 능력 덕분에 대규모 사전학습에 적합해 NLP 표준 아키텍처로 자리 잡았다.