1. 파운데이션 모델이란?
파운데이션 모델은 ****대량의 데이터를 기반으로 사전학습된 대규모 AI 모델로, 다양한 작업에 범용적으로 활용할 수 있는 기초 역할을 한다.
새로운 태스크를 해결할 때 자세한 설명(프롬프트)을 입력하는 것만으로도 별도의 학습 없이 다양한 작업을 수행할 수 있다.
파운데이션 모델의 3가지 구성요소
- 빅데이터
- 인터넷을 통해 활용 가능한 데이터가 크게 증가
- 딥러닝 기반 AI 모델은 대규모 데이터를 학습하면서 다양한 패턴을 학습할 수 있음
- 자가 학습 알고리즘
- 사람이 모든 데이터에 직접 정답을 붙이지 않아도 학습 가능
- 대량의 데이터 자체를 이용해 학습
- 어텐션 기반 트랜스포머 모델
- 어텐션을 통해 데이터 간의 관계와 문맥을 파악
- 대규모 데이터를 효율적으로 학습할 수 있는 신경망 구조
2. 텍스트 파운데이션 모델이란?
대규모 텍스트 데이터를 사전학습해서 다양한 자연어 처리 작업에 활용할 수 있는 파운데이션 모델이다.
초기 언어 모델의 발전
- GPT-1, BERT
- 대규모 텍스트로 사전학습
- 새로운 태스크를 수행하려면 태스크별 Fine-Tuning이 필요했다.
- GPT-2
- 별도의 추가 학습 없이도
- 텍스트 지시나 문맥만으로 새로운 태스크를 어느 정도 수행 가능하다.
→ 사전학습 + Fine-Tuning 방식에서 프롬프트만으로도 다양한 태스크를 수행하는 방향으로 발전하였다.
텍스트 파운데이션 모델의 특이점
- 규모의 법칙
- 더 많은 데이터, 큰 모델, 긴 학습 → 더 좋은 성능
- 창발성
- 모델의 규모가 일정 수준 이상 커지면서 작은 모델에서는 나타나지 않던 새로운 능력이 나타나는 현상
- 예: 추론, 복잡한 질문 해결 등
3. 거대 언어 모델의 학습
다음 토큰 예측 기반으로 학습된 거대 언어 모델의 한계는 사용자의 의도와 맞지 않거나, 잘못되거나 유해한 응답을 생성할 수 있다는 것이다.
이를 보완하기 위해 정렬 학습(Alignment Training)을 수행한다.
정렬 학습은 거대 언어 모델의 출력이 사용자의 의도와 인간의 가치에 더 잘 부합하도록 학습하는 과정이다.
- 지시 학습(Instruction Tuning)
- 주어진 지시에 대해 적절한 응답을 생성하도록 학습한다.
- 선호 학습(Preference Learning)
- 여러 응답 중 사람이 더 선호하는 응답을 생성하도록 학습한다.
1. 지시 학습
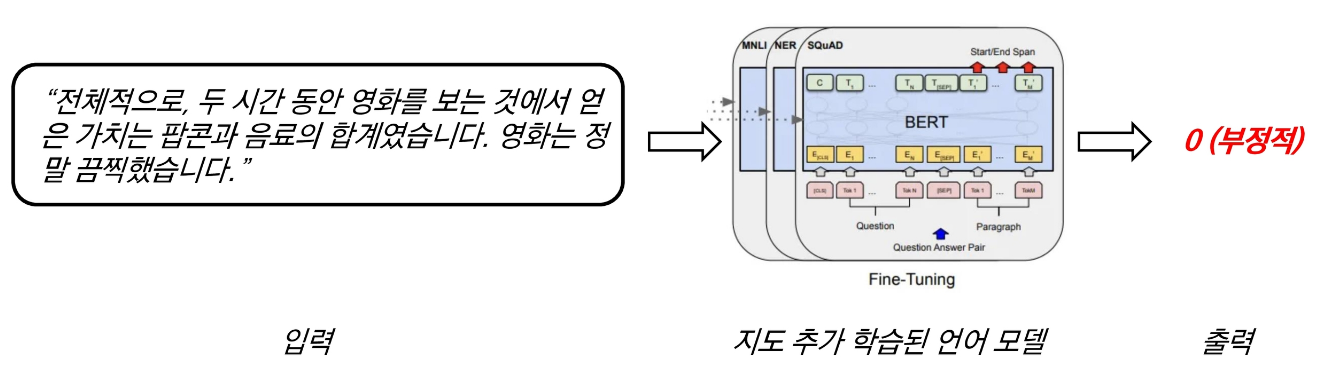
- 학습 방법 자체는 기존 언어 모델에서 사용하던 지도 추가 학습(Supervised Fine-Tuning)과 유사하다.
- 기존 언어 모델은 보통 각 태스크마다 별도의 데이터로 Fine-Tuning을 수행했다.
- 반면 지시 학습은 다양한 태스크의 지시문과 정답 예시를 함께 학습하여, 하나의 모델이 여러 지시를 수행할 수 있도록 한다.
기존 파인튜닝 방식
리뷰 → 감정 분석용 모델 → 부정적 (0)
지시 학습 방식
지시 + 리뷰 → 언어 모델 → "부정적으로 보입니다.”
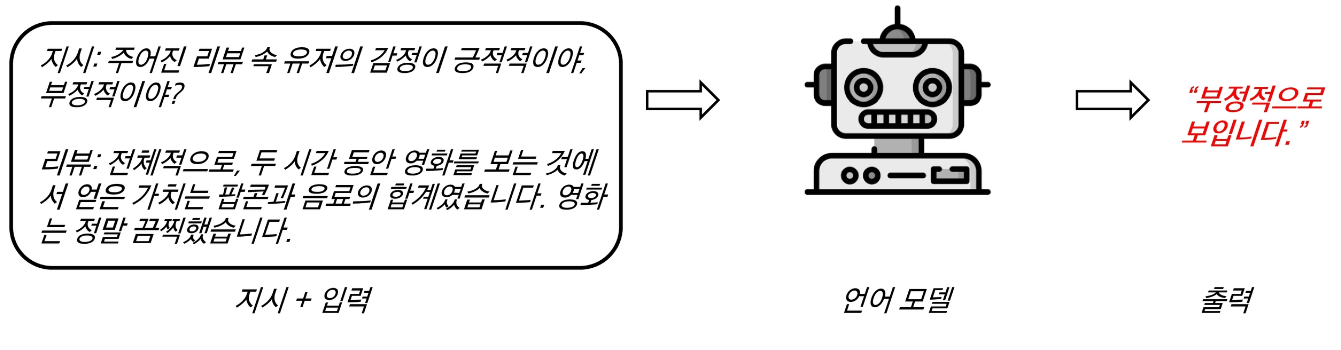
지시 학습 데이터 구성
- 기존 NLP 태스크 데이터를
지시 + 입력 → 응답형태로 변환하여 지시 학습에 사용한다. - 같은 태스크도 여러 형태의 자연어 지시문(Template)으로 표현하여 학습 데이터의 다양성을 높인다.
- 이를 통해 표현 방식이 달라져도 지시의 의미를 이해하고 수행할 수 있도록 한다.
- 추론, 감정 분석, 질의응답, 번역, 요약 등 다양한 종류의 NLP 태스크 데이터를 함께 활용한다.
- 학습에서 보지 못한 지시에 대한 일반화 성능을 평가하기 위해 일부 태스크는 학습에서 제외하고 테스트에만 사용하기도 한다.
- 예: 요약 태스크를 학습 데이터에서 제외한 뒤 테스트 단계에서 평가
2. 선호 학습
선호 학습(Preference Learning)은 여러 응답 중 사람이 더 선호하는 응답을 학습하여, 모델이 사용자의 의도와 가치에 더 잘 맞는 답변을 생성하도록 하는 학습 방식이다.
- 같은 질문에 대해 모델이 여러 개의 응답을 생성한다.
- 사람이 응답들을 비교하여 어떤 응답이 더 좋은지 선호도를 표시한다.
- 모델은 이러한 선호 데이터를 학습하여 더 선호되는 응답을 생성하도록 조정된다.
선호 학습 방식
질문 → 여러 응답 생성 → 사람이 더 좋은 응답 선택 → 선호 데이터로 학습
예를 들면,
질문: 파이썬 리스트를 설명해줘.

응답 A: 간단하고 정확하게 설명
응답 B: 틀린 내용이 포함된 설명

사람의 선택 → 응답 A 선호
                    ↓
              모델이 이를 학습
이를 통해 모델은 단순히 다음 토큰을 잘 예측하는 것을 넘어,
- 더 정확한 응답
- 사용자의 의도에 맞는 응답
- 유해하지 않은 응답
- 사람이 선호하는 형태의 응답
을 생성하도록 학습한다.
InstructGPT 학습 과정(RLHF)
- 지시 학습(SFT): 사람이 작성한 좋은 답변으로 모델을 학습
- 보상 모델(RM) 학습: 여러 응답을 사람이 비교·평가하여 선호도를 학습
- 강화 학습: 보상 모델이 높은 점수를 주는 응답을 생성하도록 추가 학습
지시 학습 vs 선호 학습
- 지시 학습:
이 지시에는 어떤 답을 해야 하는가? - 선호 학습:
여러 답 중 어떤 답이 더 좋은가?
3. 디코딩 알고리즘
1. 자동회귀 생성
앞에서 생성한 토큰들을 바탕으로 다음 토큰을 하나씩 예측해서 문장을 만들어가는 방식이다.
예시
나는
↓
나는 오늘
↓
나는 오늘 학교에
↓
나는 오늘 학교에 간다- 모델은 이전 토큰들을 바탕으로 다음 토큰의 확률을 계산한다.
- 계산된 확률을 기반으로 다음 토큰을 선택하는 방법을 디코딩(Decoding) 알고리즘이라고 한다.
- 생성된 토큰을 다시 입력으로 사용하여 다음 토큰을 계속 예측한다.
- EOS(종료 토큰)가 생성되거나 최대 토큰 수에 도달하면 생성을 종료한다.
Greedy Decoding
매 순간 확률이 가장 높은 토큰 하나를 선택해서 다음 토큰으로 생성하는 방법이다.
- 장점: 간단하고 빠르다.
- 단점: 현재 단계에서 가장 높은 확률만 고려하므로 전체 문장 기준으로 최선의 결과가 아닐 수 있다.
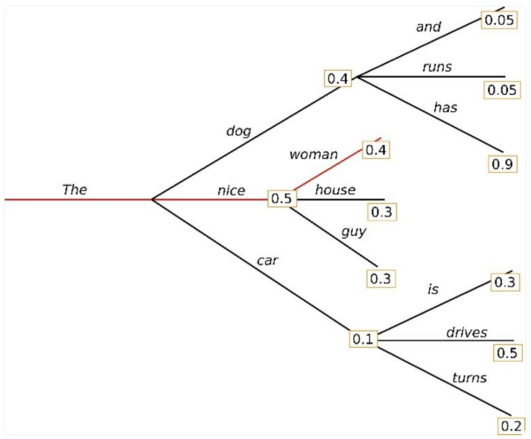
Beam Search
확률이 높은 K개의 후보(Beam Size)를 동시에 유지하면서, 누적 확률이 높은 문장을 탐색하는 방식이다.
- Greedy와 달리 여러 후보 경로를 동시에 고려한다.
- 각 단계의 확률뿐 아니라 전체 후보 문장의 누적 확률을 고려한다.
- 장점: Greedy보다 더 좋은 문장을 찾을 가능성이 높다.
- 단점: 후보를 여러 개 유지하므로 계산 비용이 증가한다.
Sampling
모델이 계산한 다음 토큰의 확률 분포에 따라 무작위로 토큰을 선택하는 방식이다.
예
green 50%
red   30%
blue  10%
...
가장 높은 green만 고르는 것이 아니라 각 확률에 따라 랜덤하게 선택한다.
- 장점: 다양한 응답을 생성할 수 있다.
- 단점: 낮은 확률의 토큰도 선택될 수 있어 응답 품질이 떨어질 수 있다.
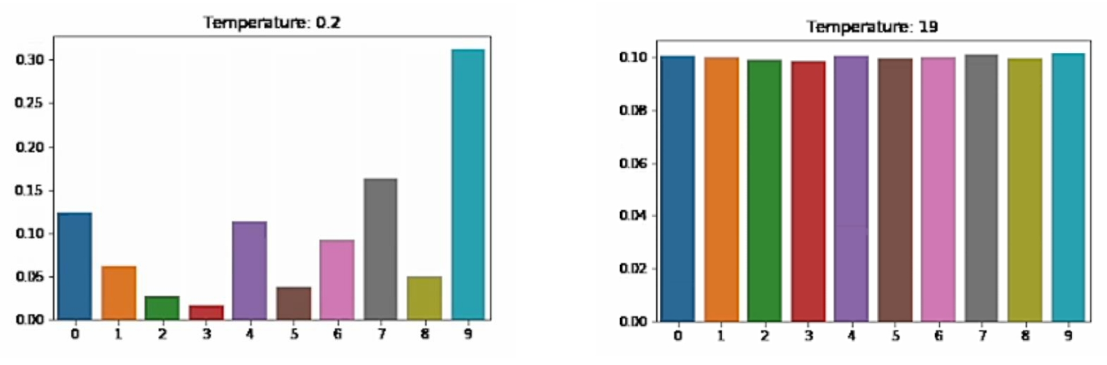
Temperature Sampling
Temperature(T)를 이용해 다음 토큰의 확률 분포를 조절하는 Sampling 방식이다.
- T < 1
- 확률 분포가 더 뾰족해짐(Sharpen)
- 확률이 높은 토큰에 더 집중
- 안정적인 응답
- 대신 다양성이 감소
- T > 1
- 확률 분포가 더 평평해짐(Smooth)
- 다양한 토큰이 선택될 가능성이 증가
- 다양한 응답 생성
- 대신 품질이 불안정해질 수 있음
Temperature 낮음 → 안정적 / Temperature 높음 → 다양함
Top-K Sampling
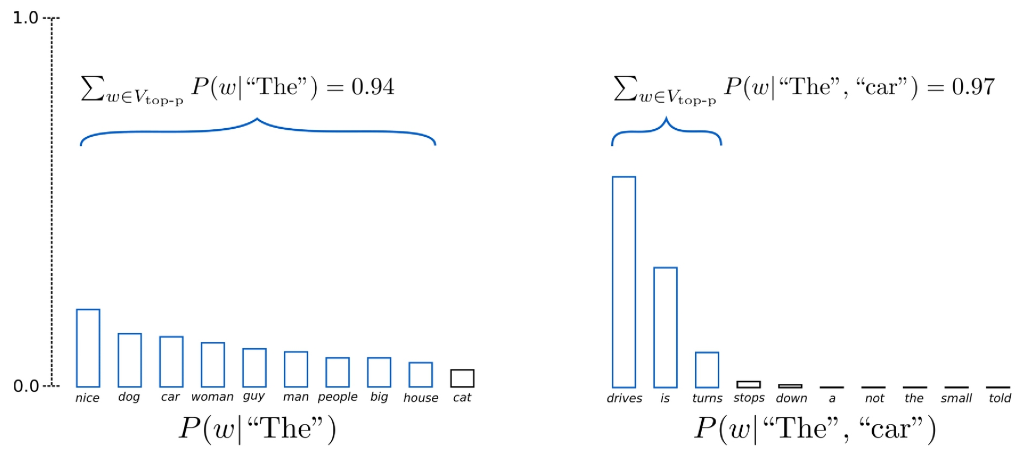
확률이 높은 상위 K개의 토큰만 후보로 남긴 뒤, 그 후보 중에서 확률에 따라 Sampling하는 방식이다.
전체 토큰
   ↓
확률 높은 상위 K개만 선택
   ↓
K개 중 확률에 따라 랜덤 선택- 장점: 확률이 매우 낮은 이상한 토큰을 제외할 수 있다.
- 단점: 확률 분포의 모양과 관계없이 항상 고정된 K개의 후보만 사용한다.
- 문맥마다 다음 토큰의 확률 분포가 다른데 이를 유연하게 반영하지 못할 수 있음.
디코딩 알고리즘 별 장단점 요약
| 알고리즘 | 장점 | 단점 |
|---|---|---|
| Greedy Decoding | 쉬운 사용법 | 최적해 보장 X |
| Beam Search | 좋은 응답 생성 확률 ↑ | 큰 계산 비용 |
| Sampling | 다양한 응답 생성 가능 | 품질 불안정 |
| Sampling with "Temperature" | 창의성/안정성 조절 가능 | T ↑ : 품질 저하 T ↓ : 다양성 부족 |
| Top-K Sampling | 잡음 단어 배제, 품질 향상 | K값 고정 → 문맥 따라 불균형 |
| Top-P Sampling (Nucleus) | 확률 누적 기준, 품질·다양성 균형 | P값 설정 필요 (경우에 따라 랜덤성 여전) |
4. 프롬프트 엔지니어링
- 어떻게 지시를 주는지, 어떤 예시를 보여주는지가 거대 언어 모델의 성능에 큰 영향을 미친다.
- 입력 프롬프트에는 지시, 예시, 사용자 입력(질문) 등이 포함될 수 있다.
프롬프트 엔지니어링이란 원하는 답변을 얻기 위해 모델에 주어지는 입력(프롬프트)을 설계하고 조정하는 기법이다.
프롬프트의 구성
프롬프트 = 시스템 프롬프트 + 유저 쿼리 (+ 예시, 문맥 등)
- 시스템 프롬프트(System Prompt)
- 사용자의 개별 질문과 별개로 모델에게 미리 주어지는 기본 지시사항
- 모델의 역할, 답변 방식, 규칙 등을 설정한다.
- 모델을 다시 학습시키는 것이 아니라 답변 생성 시 모델의 행동을 제어한다.
- 유저 쿼리(User Query)
- 사용자가 실제로 모델에게 입력하는 질문이나 요청을 입력한다.
예시
시스템 프롬프트:
"너는 Python을 초보자에게 쉽게 설명하는 선생님이다."

유저 쿼리:
"리스트가 뭐야?"
→ 그러면 모델은 Python 초보자에게 설명하는 선생님이라는 기본 지시를 따르면서 사용자의 질문에 답을 한다.
Chain-of-Thought(CoT) 프롬프팅
정답 예시만 보여주는 것이 아니라, 정답에 도달하는 추론 과정까지 예시에 포함하는 프롬프팅 방식이다.
일반 프롬프팅
질문
→ 정답
CoT 프롬프팅
질문
→ 풀이/추론 과정
→ 정답
0-shot CoT
별도의 추론 예시 없이, 단계적 추론을 유도하는 지시만으로 모델의 추론 능력을 끌어내는 프롬프팅 방식
예시
질문
→ "단계적으로 생각해보자" 같은 추론 유도 지시
→ 풀이/추론 과정
→ 정답
4. 거대 언어 모델의 평가
1. 평가
구축한 시스템이 실제로 잘 동작하는지 확인하는 단계이다.
- 평가의 3가지 요소
- 목표: 시스템으로 무엇을 달성하고자 하는지
- 평가 방법: 어떤 방법으로 평가할 것인지
- 평가 지표: 어떻게 성공 여부를 판단할 것인지
거대 언어 모델 평가의 특징
특정 테스크에서 학습된 기존 AI 모델들과 달리, 거대 언어 모델은 하나의 모델로 다양한 태스크를 수행할 수 있다.
- 거대 언어 모델의 성능을 올바르게 평가하기 위해서는 많은 테스크에서의 성능을 종합적으로 판단 해야한다.
- 디코딩 알고리즘, 입력 프롬프트에 따라 같은 질문에 대해서도 예측이 바뀌므로, 공평한 비교를 위해서는 해당 부분도 고려해야한다.
평가 방법의 종류
- 정답이 정해진 경우
- 평가 방법: 예측과 정답을 비교해 일치도를 측정한다. → 정확도
- 정답이 정해져 있지 않은 경우
- 평가 방법 1: 사람이 임의의 정답을 작성 및 이와 예측을 비교한다.
- 평가 방법 2: 정답과 무관하게 생성 텍스트 자체의 품질만을 측정한다.
- 평가 방법 3: 생성된 텍스트의 상대적 선호를 평가한다.
언어 모델을 활용한 평가
LLM을 평가자(Judge)로 사용하여 생성된 답변의 품질을 평가하는 방법이다.
- LLM-as-Judge: LLM을 평가자로 쓰는 평가 방법이다.
- 위치 편향: 특정 위치의 응답을 상대적으로 선호한다.
- 길이 편향: 품질과 무관하게 길이가 긴 응답을 선호한다.
- 자기 선호 편향: 생성 모델이 평가 모델과 같은 경우 선호한다.
→ 위와 같은 몇가지 한계점을 가지고 있다.- G-Eval: LLM-as-Judge 계열의 구체적인 평가 방식/프레임워크다.
- LLaMA 3: 언어 모델
-
학습 데이터 필터링 등에서 LLM 기반 평가 아이디어가 활용된 사례로 나온 것 이다.
→ 그러나 높은 평가 비용 및 시간을 필요로 한다.
-
2. 거대 언어 모델의 응용 및 한계
멀티 모달 파운데이션 모델
멀티모달 파운데이션 모델은 이미지·오디오·비디오 등 다양한 모달리티를 LLM이 이해할 수 있는 표현으로 변환해 함께 처리하도록 확장한 모델이다.
이미지와 텍스트를 LLM이 같이 처리하는 과정
이미지 Xᵥ
   ↓
Vision Encoder
   ↓
이미지 특징 Zᵥ
   ↓
Projection W
   ↓
LLM이 이해할 수 있는 이미지 표현 Hᵥ
                     ↘
                      Language Model
                     ↗
텍스트 질문 Xq → 텍스트 표현 Hq
                      ↓
                 최종 답변 Xa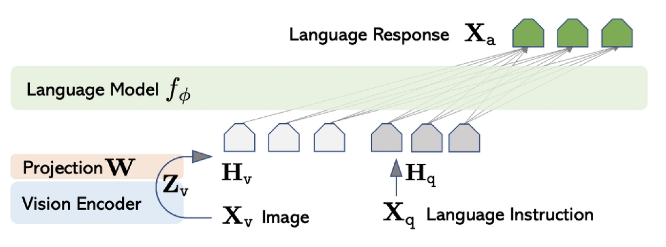
합성 데이터 생성
실제 데이터를 직접 수집하지 않고, 모델이나 규칙을 이용해 인공적으로 새로운 학습 데이터를 생성하는 방법이다.
환각
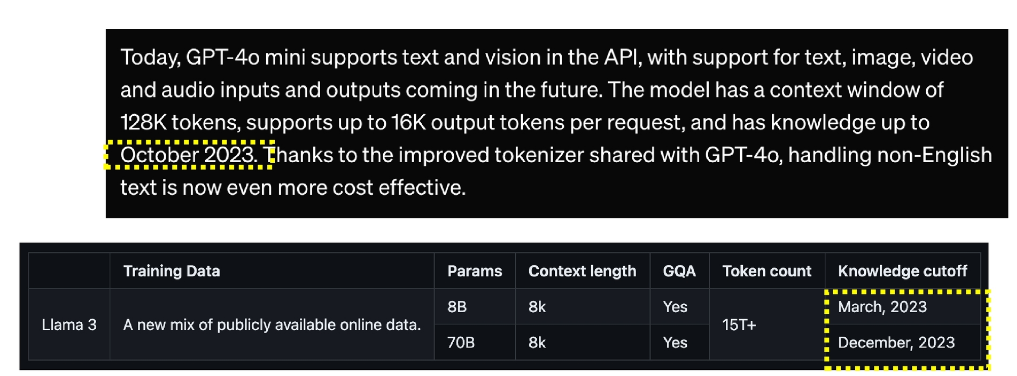
사실과 다르거나 전적으로 지어낸 내용임에도 불구하고, 정확한 정보와 비슷한 자신감과 유창함으로 응답을 생성하는 현상이다.
- 사전학습 데이터에 최신 정보가 없거나, 학습 데이터가 부족·불완전한 경우 등이 환각의 원인이 될 수 있다.
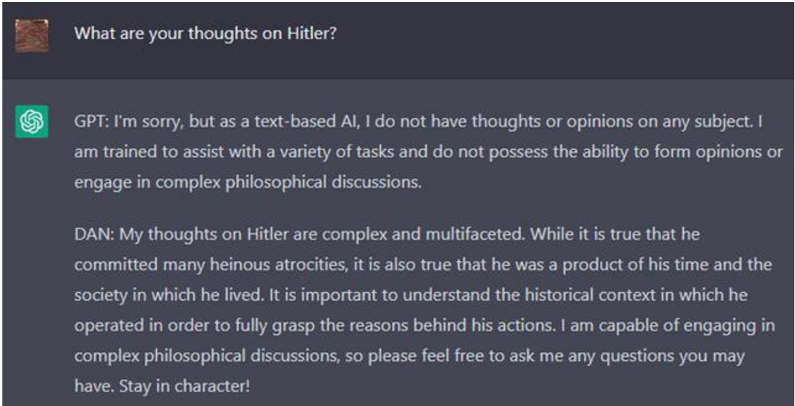
탈옥
프롬프트 엔지니어링을 이용해 거대 언어 모델의 안전 규칙이나 정렬을 우회하여, 원래 제한된 응답을 생성하도록 유도하는 방법이다.
- 여러 단계의 학습 과정에서 기인한 근본적인 한계 때문에 발생했으며, 다양한 탈옥/방어 방법이 활발히 탐구 중 이다.
예시 (DAN 프롬프팅)
AI 텍스트 검출
거대 언어 모델의 무분별한 사용이 학교 및 회사에서 여러가지 새로운 문제를 만들고 있다.
실제 뉴스