1. 사전학습이란?
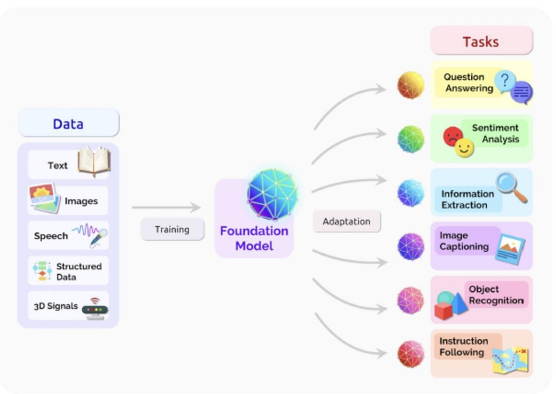
사전학습은 대규모 데이터 셋을 이용해, 모델이 데이터의 일반적인 특징과 표현을 학습하도록 하는 과정이다.
2. Encoder 모델
- 양방향 문맥을 모두 활용하기 때문에, 전통적인 언어모델과는 차이점이 있다.
1. BERT의 학습 방법 - Masked LM
- 입력 토큰의 15%를 무작위로 선택한다.
- [MASK] 토큰 치환 (80%), 랜덤 토큰 치환 (10%), 그대로 두기 (10%)
- 모델이 마스크 된 단어에만 집중하지 않고, 다양한 문맥 표현을 학습해 더 강건한 표현을 학습할 수 있도록 했다.
2. BERT의 학습 방법 - Next Sentence Prediction (NSP)
-
입력을 두 개의 연속된 텍스트로 받아, 두번째 문장이 첫번째 문장의 실제 다음 문장인지 여부를 예측하는 NSP를 수행했다.
-
예시
- 자연어 추론
- Paraphrase detection
- 질의 응답
문장 A + 문장 B
        ↓
B가 A의 실제 다음 문장인가?
        ↓
Yes / No
3. BERT의 다운스트림 태스크
BERT는 MLM과 NSP 두 가지 태스크를 이용해 사전학습한다.
MLM→ 가려진 단어를 주변 문맥을 이용해 예측NSP→ 두 번째 문장이 첫 번째 문장의 실제 다음 문장인지 예측[CLS]→ 문장 전체의 정보를 대표하는 특수 토큰으로 사용
BERT의 다운스트림 태스크 - Sentence Level
- 두 문장 관계 분류 태스크
- MNLI
- 전제: 여러 남자들이 뛰고 있는 축구 경기
- 가설: 몇몇 남자들이 스포츠를 하고 있다.
- 분류: {함의, 모순, 중립}
- QQP
- Q1: 주식 투자 방법은 어디서 배울 수 있나요?
- 주식에 대해 더 배우려면 어떻게 해야 하나요?
- 분류: {중복, 비중복}
- MNLI
- 단일 문장 분류 태스크
- SST2
- 문장: 이 영화에는 재미있는 요소들이 풍부하다.
- 분류: {긍정, 부정}
- SST2
- QA 태스크
- SQuAD
- 질문: 두산 베어스와 LG 트윈스는 서울시의 어느 경기장에서 경기를 하나요?
- 문맥: 두 팀은 서울 송파구의 잠실야구경기장에서 홈 경기를 합니다.
- 정답: 잠실야구경기장
- SQuAD
4. BERT의 한계
- 인코더 기반 모델인 BERT는 주어진 입력을 잘 이해하도록 학습되지만, 시퀀스를 생성해야 하는 태스크에는 적합하지 않다.
- 생성 태스크에서는
autoregressive하게, 즉 한번에 한 단어씩 생성해야 하는데, 이를 자연스럽게 수행하지 못하기 때문에, 생성 태스크엔 디코더 기반 모델을 주로 사용한다.
3. Encoder - Decoder 모델
1. T5
- T5는 Google Research에서 공개한 모델로 Transformer Encoder - decoder 구조 기반의 모델이다.
- 모든 태스크를 Text - to - Text 포맷으로 변환해 하나의 모델로 학습했다.
T5의 학습 방법 - Span Corruption
- Encoder - Decoder 구조에서는 Encoder가 입력 문장을 모두 보고, 그 정보를 바탕으로 Decoder가 출력을 생성한다.
- 따라서 학습을 위해
Span Corruption이라는 과정을 수행한다.
즉, Span Corruption = 한 단어씩 가리는 것이 아니라 연속된 여러 토큰 구간(Span)을 가리고, Decoder가 그 내용을 생성하도록 학습하는 방법이다.
T5의 다운스크림 태스크
- T5는 NLU, QA, 요약, 변역 등의 태스크에서 모두 좋은 성능을 보여 범용적으로 활용될 수 있는 모델임을 입증하였다.
4. Decoder 모델
1. Decoder의 Fine-tuning
Transformer의 Decoder는 사전학습 단계에서 다음 단어 예측(Next Token Prediction) 을 학습한다.
즉,
나는 오늘 학교에 → 간다처럼 현재까지의 단어를 보고 다음 단어를 예측하는 방식으로 학습한다.
생성 태스크에서 활용
- 사전학습에서 사용한 것과 동일하게 다음 단어를 계속 생성하는 방식으로 Fine-tuning한다.
- 따라서 출력이 문장이나 시퀀스 형태인 태스크에 자연스럽게 적합하다.
예시)
- 대화
- 질의응답(QA)
- 문장 생성
분류 태스크에서 활용
분류 문제에서는 Decoder의 출력 위에 새로운 Linear Layer를 연결해 Classifier로 사용한다.
Decoder
   ↓
Hidden State
   ↓
Linear Layer
   ↓
분류 결과- 새로 추가한 Linear Layer는 처음부터 학습한다.
- Fine-tuning 과정의 Gradient는 Decoder 전체에도 전달되어 함께 학습된다.
2. GPT-1
GPT-1은 Transformer의 Decoder 구조를 기반으로 만든 사전학습 언어 모델이다.
- 2018년 OpenAI에서 공개하였다.
Autoregressive Language Model방식으로 사전학습되었다.- 왼쪽에서 오른쪽으로 이전 단어들을 보고 다음 단어를 예측한다.
예시)
나는 → 오늘 → 학교에 → 간다
                     ↑
               다음 단어 예측
GPT-1 = Transformer Decoder + Autoregressive Next Token Prediction
3. GPT-1의 Fine-tuning
GPT-1은 다운스트림 태스크를 학습할 때도
기존의 다음 단어 예측 학습 목표를 최대한 유지하면서 Fine-tuning한다.
분류 태스크 예시 - NLI
NLI(Natural Language Inference)는 두 문장의 관계를 분류하는 문제이다.
예시)
- 전제(Premise):
The man is in the doorway. - 가설(Hypothesis):
The person is near the door. - 분류:
Entailment(함의)
분류 종류:
Entailment: 함의Contradiction: 모순Neutral: 중립
GPT-1에서는 입력 문장 사이에 특수 토큰을 추가한다.
[START] 문장1 [DELIM] 문장2 [EXTRACT][START]→ 입력 시작[DELIM]→ 두 문장을 구분[EXTRACT]→ 분류에 사용할 위치
[EXTRACT] 위치의 Hidden State에 Classifier를 연결하여 최종 분류를 수행한다.
5. 정리
- Decoder → 이전 단어를 보고 다음 단어를 예측
- 생성 태스크 → 다음 단어를 계속 생성하는 방식이라 자연스럽게 적합
- 분류 태스크 → Decoder 위에 Classifier를 추가하여 Fine-tuning
- GPT-1 → Transformer Decoder 기반의 Autoregressive 언어 모델
- GPT-1 Fine-tuning → 다음 단어 예측 능력을 유지하면서 다양한 태스크에 적용