1. SQL이란 무엇인가
개념
SQL은 관계형 데이터베이스에서 데이터를 다루기 위해 사용하는 언어다.
쉽게 말하면, 데이터베이스에게 무엇을 하고 싶은지 전달하는 방법이다.
데이터베이스 안에는 회원 정보, 주문 정보, 상품 정보처럼 여러 데이터가 들어 있다.
이때 데이터를 조회하거나, 새로 넣거나, 수정하거나, 삭제하거나, 권한을 관리할 때SQL을 사용한다.
즉,SQL은 프로그램 전체를 만드는 언어가 아니라,
데이터베이스 안의 데이터를 관리하기 위해 만들어진 언어라고 이해하면 된다.
핵심 특징
1) DDL
DDL은 데이터베이스의 구조를 정의하는 언어다.
쉽게 말하면 데이터를 담을 틀을 만드는 언어다.
대표 명령은 다음과 같다.
CREATE: 데이터베이스 객체 생성DROP: 데이터베이스 객체 삭제ALTER: 데이터베이스 객체 수정즉,
DDL은 아직 데이터 내용 자체를 다루기보다
테이블이나 구조를 만들고 바꾸는 단계에서 사용한다.
2) DML
DML은 실제 데이터를 다루는 언어다.
쉽게 말하면 이미 들어 있는 데이터를 조회하고 바꾸는 언어다.
대표 명령은 다음과 같다.
INSERT INTO: 데이터 삽입UPDATE ... SET: 데이터 수정DELETE FROM: 데이터 삭제SELECT ... FROM ... WHERE: 데이터 조회보통
SQL을 처음 배울 때 가장 많이 만나게 되는 것도 이DML이다.
우리가 흔히 떠올리는 조회, 검색, 수정 작업이 여기에 들어간다.
3) DCL
DCL은 권한과 제어를 다루는 언어다.
쉽게 말하면 누가 무엇을 할 수 있는지 정하는 언어다.
대표 명령은 다음과 같다.
GRANT: 권한 부여REVOKE: 권한 회수SET TRANSACTIONBEGINCOMMITROLLBACKSAVEPOINTLOCK즉,
DCL은 데이터 구조를 만드는 것도 아니고,
데이터 내용을 직접 바꾸는 것도 아니다.
그 작업을 누가, 어떤 방식으로 할 수 있는지를 제어하는 역할을 한다.
SQL을 쓸 때 알아둘 기본 규칙
SQL문장을 본격적으로 배우기 전에, 아주 기본적인 성질도 같이 알아두면 좋다.1) SQL은 보통 대소문자를 구분하지 않는다
예를 들어
select와SELECT는 같은 의미로 동작한다.
다만 완전히 아무 때나 같다고 생각하면 안 된다.
서버 환경이나 DBMS 종류에 따라 데이터베이스 이름이나 필드명에서 대소문자를 구분하기도 한다.
즉, 기본적으로는 대소문자에 크게 민감하지 않지만, 환경에 따라 달라질 수 있다는 점은 알고 있어야 한다.
2) SQL 명령은 세미콜론(;)으로 끝낸다
SQL 문장은 보통 마지막에 세미콜론
;을 붙여서 문장의 끝을 표시한다.
처음에는 빼먹기 쉬운데, 여러 문장을 연달아 작성할 때 특히 중요하다.
3) 문자열은 따옴표로 감싼다
문자 데이터는 보통 작은따옴표
' '로감싼다.
예를 들어 이름이James인 데이터를 찾고 싶다면, 문자열 값은 숫자처럼 그냥 쓰는 것이 아니라 따옴표 안에 넣어야 한다.
4) 주석도 사용할 수 있다
주석은 설명을 적어 두는 메모 같은 것이다.
주석 처리된 문장은 실행되지 않는다.
- 한 줄 주석 :
--- 여러 줄 주석 :
/* */즉, SQL도 단순히 명령만 쓰는 것이 아니라,
설명을 함께 적어 두면서 관리할 수 있다.
헷갈리기 쉬운 부분처음 보면
SELECT도 뭔가 구조를 보는 느낌이라DDL처럼 보일 수 있다.
하지만SELECT는 테이블 구조를 만드는 명령이 아니라, 이미 들어 있는 데이터를 조회하는 명령이므로DML에 속한다.
또SQL은 자바처럼 화면을 만들거나 프로그램 전체 흐름을 제어하는 언어가 아니다.
핵심은 하나다.
데이터베이스 안의 데이터를 다루는 데 특화된 언어라는 점이다.
2. 테이블 관계와 키 이해하기
개념관계형 데이터베이스는 모든 정보를 한 테이블에 몰아넣지 않는다.
서로 관련 있는 정보를 역할에 따라 나누어 저장하고, 필요할 때 연결해서 사용한다.
예를 들어 고객 정보와 구매 정보를 생각해 보면,
한 고객은 물건을 여러 번 살 수 있다.
그래서 고객 이름, 출생년도, 주소 같은 정보는고객 테이블에 모아 두고,
무엇을 얼마에 몇 개 샀는지는구매 테이블에 따로 저장하는 것이 훨씬 자연스럽다.
이때 기준이 되는 쪽이 부모 테이블,
그 기준을 참조하는 쪽이 자식 테이블이다.
즉, 고객 테이블이 부모가 되고 구매 테이블이 자식이 된다.
이 관계를1:N 관계라고 부른다.
뜻은 고객 1명에게 구매 내역 여러 건이 연결될 수 있다는 의미다.
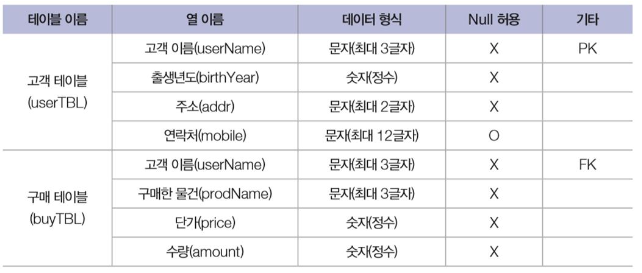
이 그림은 고객 테이블과 구매 테이블의 관계를 한눈에 보여준다.
왼쪽의 고객 테이블은 기준 정보가 있는 부모 테이블이고,
오른쪽의 구매 테이블은 그 기준을 참조하는 자식 테이블이다.
여기서 가장 먼저 봐야 할 것은userName이다.
- 고객 테이블의
userName은 각 고객을 구분하는 기준이다.- 구매 테이블의
userName은 이 구매가 누구의 구매인지 연결하는 값이다.즉, 같은 이름처럼 보여도 역할은 다르다.
- 부모 쪽
userName→ 자기 자신을 식별하는 값- 자식 쪽
userName→ 부모를 참조하는 값이 차이를 이해하면
PK와FK도 훨씬 쉽게 들어온다.
핵심 특징
1) 기본 키(PK)
PK는 각 행을 구분하는 기준이 되는 값이다.
쉽게 말하면 한 행에 붙어 있는 번호표다.
예를 들어 고객 테이블에 여러 명의 고객이 있을 때,
누가 누구인지 정확히 구분할 기준이 필요하다.
그 역할을 하는 것이PK다.
기본 키는 반드시 다음 조건을 만족해야 한다.
- 중복되면 안 된다.
- 비어 있으면 안 된다.
그래야 각 행을 정확하게 구분할 수 있다.
2) 외래 키(FK)
FK는 다른 테이블의 값을 참조하기 위한 키다.
쉽게 말하면 부모 테이블을 가리키는 연결표라고 보면 된다.
구매 테이블에는 “누가 샀는지”가 필요하다.
그렇다고 고객의 출생년도, 주소, 연락처를 구매할 때마다 계속 적어 넣으면 중복이 너무 많아진다.
그래서 구매 테이블에는 고객 테이블의PK값만 가져와서 저장한다.
이렇게 부모 테이블의 값을 참조하는 열이FK다.
3) 왜 굳이 테이블을 나누는가처음에는 “그냥 한 테이블에 다 넣으면 더 쉬운 것 아닌가?”라는 생각이 들 수 있다.
하지만 그렇게 하면 같은 고객 정보가 구매 내역마다 계속 반복된다.
예를 들어 한 고객이 물건을 세 번 샀다면
이름, 출생년도, 주소, 연락처 같은 정보도 세 번 반복해서 저장될 수 있다.
이렇게 되면 공간 낭비가 생기고,
정보가 바뀌었을 때 여러 곳을 다 수정해야 하고,
잘못 수정되면 데이터가 서로 달라질 수도 있다.
그래서 관계형 데이터베이스는
기준 정보는 부모 테이블에 한 번만 저장하고,
필요한 연결만 자식 테이블에서 참조하는 방식으로 설계한다.
4) 제약조건테이블 사이에 관계가 생기면 아무 값이나 넣을 수 없다.
그래서 데이터가 꼬이지 않게 막아 주는 규칙이 필요한데, 그게 제약조건이다.
중요한 규칙은 다음과 같다.
- 새 데이터를 넣을 때는 부모 테이블에 먼저 데이터가 있어야 한다.
FK가 들어 있는 컬럼에는 부모 테이블이 가진 값 중 하나가 들어가야 한다.- 부모의
PK데이터를 삭제할 때는 자식 테이블도 함께 정리하거나FK를NULL로 바꾸는 처리가 필요하다.즉, 관계형 데이터베이스는
연결만 해 두는 것이 아니라, 그 연결 규칙까지 지키면서 데이터를 관리하는 구조다.
헷갈리기 쉬운 부분
PK와FK는 이름이 비슷해서 처음에 가장 많이 헷갈린다.
PK는 내가 누구인지 보여주는 값FK는 내가 누구를 참조하는지 보여주는 값이렇게 기억하면 쉽다.
또 부모 / 자식이라는 표현 때문에
이름만 외우다 보면 나중에 헷갈릴 수 있다.
더 중요한 것은 역할이다.
- 부모 테이블: 기준 정보가 있는 쪽
- 자식 테이블: 그 기준을 참조하는 쪽
즉, 이 파트의 핵심은
테이블을 나누고, 기준은PK로 잡고, 연결은FK로 한다는 점이다.
3. MySQL이란 무엇인가
개념
MySQL은 관계형 데이터베이스 관리 시스템이다.
즉, 데이터를 테이블 형태로 저장하고,SQL을 이용해 그 데이터를 관리할 수 있게 해 주는 프로그램이다.
앞에서SQL이 데이터베이스에게 명령하는 언어라고 했다면,
MySQL은 그 명령을 실제로 받아서 처리하는 시스템이다.
정리하면 이렇게 된다.
SQL: 데이터베이스에게 명령하는 언어MySQL: 그 명령을 처리하는 데이터베이스 시스템즉, 둘은 같은 말이 아니라
언어와 시스템의 관계라고 보면 된다.
핵심 특징
1) 관계형 데이터베이스
MySQL은 관계형 데이터베이스다.
그래서 데이터를 표처럼 생긴 테이블에 저장하고,
테이블끼리 관계를 맺어서 데이터를 관리한다.
즉, 지금 배우고 있는PK,FK,JOIN같은 개념은
바로 이런 관계형 데이터베이스 구조에서 나오는 것이다.
2) NoSQL과의 아주 기본적인 차이데이터베이스는 전부 같은 방식으로 동작하지 않는다.
MySQL처럼 테이블과SQL중심으로 동작하는 관계형 데이터베이스도 있고,
NoSQL처럼 문서, 키-값, 그래프 같은 방식으로 데이터를 저장하는 시스템도 있다.
아주 단순하게 비교하면 이렇다.
MySQL같은 관계형 데이터베이스
→ 테이블 중심, 행과 열 구조가 분명함,SQL로 다룸
NoSQL
→ 테이블 구조에 꼭 맞추지 않아도 되는 경우가 많음, 데이터 형태가 더 유연함즉, 지금 배우는 내용은
테이블 구조와 관계를 분명하게 잡고 다루는 관계형 데이터베이스 쪽이라고 이해하면 된다.
3) MySQL Workbench
MySQL Workbench는MySQL을 더 쉽게 다루기 위한 도구다.
직접SQL을 입력하고 실행 결과를 보거나, 테이블 구조를 확인할 때 편하게 사용할 수 있다.
즉,
MySQL은 데이터베이스 시스템 자체MySQL Workbench는 그것을 다루기 쉽게 해 주는 도구이렇게 구분하면 된다.
헷갈리기 쉬운 부분처음에는
SQL,MySQL,MySQL Workbench가 다 비슷해 보여서 섞이기 쉽다.
SQL: 명령문MySQL: 데이터베이스 서버MySQL Workbench: 화면으로 쉽게 다루는 도구이 셋을 구분해 두면 뒤에서 실습할 때 훨씬 덜 헷갈린다.
마무리해서 이해하기
즉, 지금 배우는
SQL문법은 단순히 명령문 몇 개를 외우는 것이 아니다.
MySQL같은 관계형 데이터베이스 안에서 테이블을 어떻게 나누고, 어떻게 연결하고, 그 안의 데이터를 어떻게 다룰지를 배우는 과정이라고 보면 된다.
4. 설치하기
앞에서
SQL이 무엇인지, 테이블을 왜 나누는지, 그리고MySQL이 어떤 데이터베이스 시스템인지 먼저 정리했다.
이제는 실제로MySQL을 설치해서 뒤에서 배울SELECT,INSERT,JOIN같은 문법을 직접 실행해 볼 준비를 하면 된다.
설치는 글로 개념만 보는 것보다, 실제 설치 화면과 순서를 따라가면서 진행하는 편이 훨씬 이해하기 쉽다.
특히 아래 글은MySQL Community Server설치,MySQL Workbench설치, 그리고 설치가 제대로 되었는지 확인하는 흐름까지 함께 안내하고 있어서 맥 환경에서 따라가기 좋다.즉, 지금 단계에서는
MySQL의 개념만 알고 끝내는 것이 아니라,
직접 설치를 마친 뒤MySQL Workbench에서SQL을 실행해 보면서 이후 내용을 이어서 학습하면 된다.
5. 데이터베이스 모델링과 필수 용어
개념앞에서
SQL이 어떤 언어인지 먼저 정리했다면,
이제는 그SQL이 실제로 다루게 되는 데이터 저장 구조를 이해해야 한다.
데이터베이스를 공부할 때 처음 헷갈리는 이유는 문법보다도
테이블,열,행,DB,DBMS같은 용어가 한꺼번에 나오기 때문이다.
그래서 이 구간에서는 문법보다 먼저, 데이터가 어떤 틀 안에 저장되는지를 이해하는 것이 중요하다.
데이터베이스 모델링은 현실 세계의 정보를 데이터베이스 안에 어떻게 옮겨 담을지 결정하는 과정이다.
쉽게 말하면, 실제 세상에 있는 사람, 상품, 주문, 구매 같은 정보를
컴퓨터 안에서는 어떤 테이블로 나누고 어떤 형태로 저장할지 설계하는 단계라고 보면 된다.
예를 들어 쇼핑몰을 만든다고 하면
고객 정보, 상품 정보, 구매 정보가 모두 필요하다.
이걸 아무렇게나 저장하는 것이 아니라,
무엇을 하나의 테이블로 둘지, 어떤 항목을 열로 둘지, 어떤 값을 기준으로 관리할지를 먼저 정해야 한다.
이 과정을 거쳐야 나중에 조회도 쉽고, 수정도 안전하게 할 수 있다.
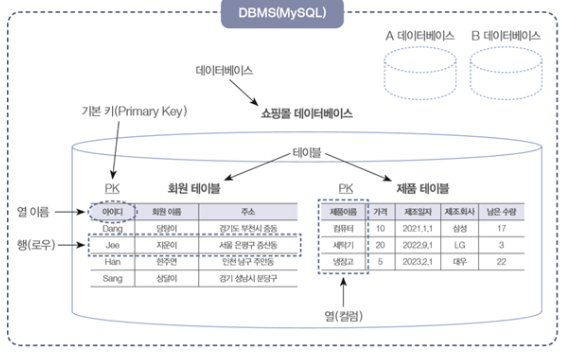
이 이미지는 지금 단계에서 알아야 할 용어들을 한눈에 보여주는 그림이다.
아직SELECT같은 문법으로 들어가기 전이기 때문에,
지금은 데이터를 담는 틀 자체를 먼저 익힌다는 느낌으로 보면 된다.
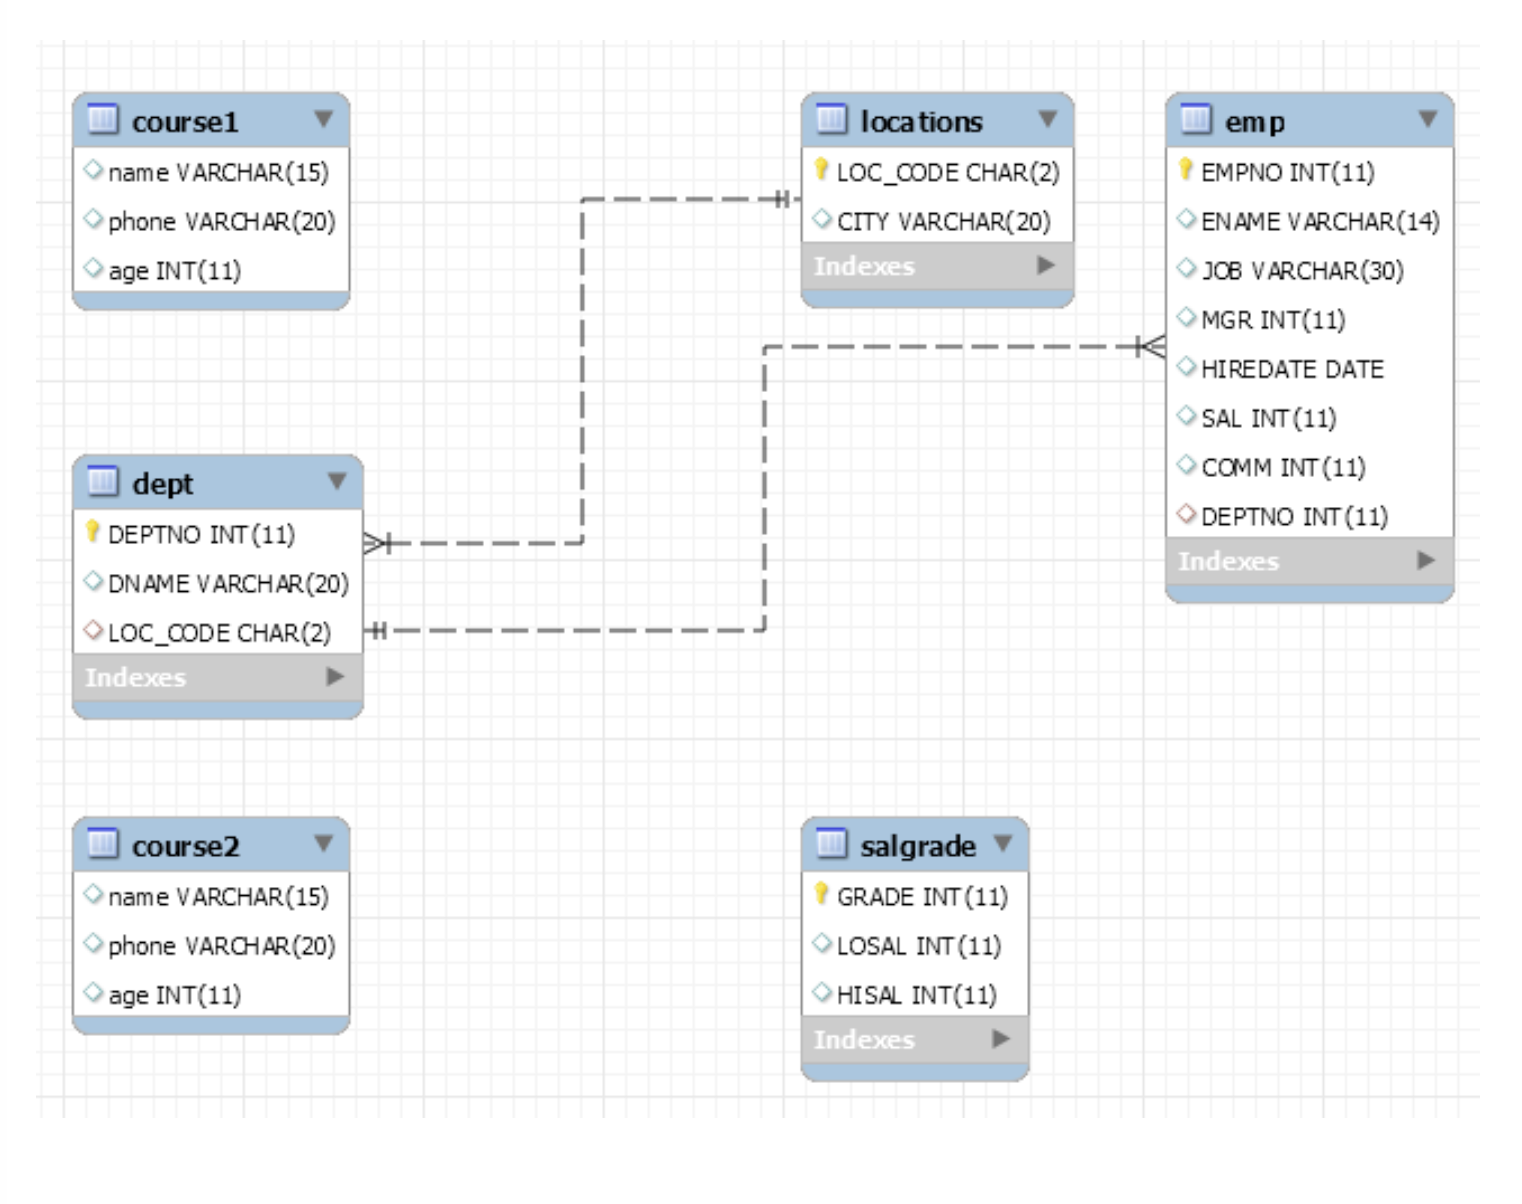
이 이미지는 데이터베이스 안의 테이블 구조와 관계를 보여주는 설계도다. 각 테이블이 어떤 데이터를 저장하는지, 그리고 어떤 키를 기준으로 서로 연결되는지를 한눈에 확인할 수 있다.
예를 들어emp는 직원 정보,dept는 부서 정보,locations는 지역 정보를 담고 있고, 이 관계를 따라가면 직원이 어느 부서에 속해 있는지, 그 부서가 어느 지역에 있는지까지 함께 조회할 수 있다.
즉, 이런 모델링 그림은 단순히 테이블 목록을 보는 용도가 아니라, 나중에JOIN으로 여러 테이블을 연결해 조회하거나, 데이터를 넣고 수정할 때 연결 규칙을 이해하는 기준이 된다.
핵심 특징
1) 데이터
데이터는 하나하나의 단편적인 정보다.
아직 정리되거나 분류되기 전의 값이라고 생각하면 쉽다.
예를 들어홍길동,서울,1998,010-1234-5678같은 값 하나하나는 데이터다.
각각은 의미가 있지만, 아직 어디에 어떤 용도로 저장되는지는 정리되지 않은 상태다.
2) 테이블
테이블은 데이터를 표 형태로 저장하기 위한 구조다.
엑셀 표처럼 가로와 세로가 있는 틀이라고 생각하면 이해하기 쉽다.
예를 들어 회원 정보를 저장하려면 회원 정보 테이블이 필요하고, 제품 정보를 저장하려면 제품 정보 테이블이 필요하다.
즉, 관련 있는 데이터끼리 하나의 표로 묶어 저장하는 것이 테이블이다.
3) 데이터베이스(DB)
데이터베이스는 테이블이 저장되는 저장소다.
쉽게 말하면 여러 테이블을 담아 두는 큰 공간이라고 보면 된다.
회원 테이블 하나만 있는 경우도 있지만, 실제로는 회원, 상품, 주문, 구매, 배송처럼 여러 테이블이 함께 들어간다.
이 테이블들을 한데 묶어 관리하는 저장소가DB다.
각 데이터베이스는 서로 다른 고유한 이름을 가질 수 있다.
4) DBMS
DBMS는DataBase Management System의 줄임말이다.
즉, 데이터베이스를 만들고, 저장하고, 수정하고, 관리하게 해 주는 시스템 또는 소프트웨어다.
앞에서 본MySQL이 바로 이런DBMS에 해당한다.
정리하면 이렇게 된다.
DB: 실제 테이블들이 저장되는 공간DBMS: 그 공간을 관리하는 프로그램이 둘은 비슷해 보여도 다르다.
DB는 저장된 대상이고,DBMS는 그것을 다루는 도구다.
5) 열
열은 테이블을 세로로 나눈 항목이다.
컬럼,필드라고도 부른다.
회원 테이블을 예로 들면 아이디, 회원 이름, 주소 같은 항목이 각각 하나의 열이 된다.
즉, “이 테이블에 어떤 종류의 데이터를 넣을 것인가”를 정해 놓은 자리가 열이다.
6) 열 이름
열 이름은 각 열을 구분하기 위한 이름이다.
쉽게 말하면 표의 제목 칸이라고 생각하면 된다.
예를 들어 회원 테이블이라면userId,name,addr같은 이름이 열 이름이 될 수 있다.
이 이름 덕분에 “이 칸에는 어떤 값이 들어가는지”를 구분할 수 있다.
열 이름은 같은 테이블 안에서 중복되면 안 된다.
그래야 어떤 데이터를 읽고 수정하는지 헷갈리지 않는다.
7) 데이터 형식
데이터 형식은 각 열에 어떤 종류의 값을 저장할지 정한 규칙이다.
쉽게 말하면 “이 칸에는 숫자를 넣을지, 문자를 넣을지, 날짜를 넣을지”를 미리 정해 두는 것이다.
예를 들어 출생년도는 숫자로 저장하는 것이 자연스럽고, 이름은 문자로 저장하는 것이 자연스럽다.
이렇게 열마다 알맞은 형식을 정해야 데이터가 더 정확하게 들어간다.
즉, 데이터 형식은 단순히 문법용 설정이 아니라
잘못된 값이 들어가지 않게 막아 주는 기본 장치이기도 하다.
8) 행
행은 실제 데이터가 들어 있는 가로 한 줄이다.
로우,레코드라고도 부른다.
예를 들어 회원 테이블에 회원이 4명 저장되어 있다면 그 테이블에는 4개의 행이 있는 것이다.
즉, 열이 “어떤 종류의 데이터를 넣을지 정한 틀”이라면,
행은 “실제로 저장된 한 건의 데이터”라고 보면 된다.
9) 기본 키(PK)
기본 키는 각 행을 구분하는 유일한 열이다.
핵심은 두 가지다.
- 중복되면 안 된다.
- 비어 있으면 안 된다.
그래야 여러 행 중에서 특정 행 하나를 정확하게 구분할 수 있다.
10) 외래 키(FK)
외래 키는 두 테이블의 관계를 맺어 주는 키다.
한 테이블이 다른 테이블의 값을 참조할 때
그 연결에 사용되는 열이FK다.
즉,PK가 “내 행을 구분하는 기준”이라면,
FK는 “다른 테이블과 연결하기 위한 기준”이다.
헷갈리기 쉬운 부분
1) DB와 DBMS처음에는
DB와DBMS를 같은 뜻처럼 받아들이기 쉽다.
하지만 둘은 다르다.
DB는 테이블이 저장된 공간DBMS는 그 공간을 관리하는 프로그램즉, 저장 대상과 관리 도구의 차이다.
2) 열과 행이것도 처음에 많이 헷갈린다.
열은 데이터의 종류를 정한 세로 항목행은 실제 데이터 한 건이 들어 있는 가로 줄
예를 들어 회원 테이블에서
- 이름, 주소, 연락처는 열
- 홍길동 한 명의 정보 전체는 행
이렇게 보면 쉽다.
3) 데이터와 테이블데이터는 값 자체이고,
테이블은 그 값을 담는 틀이다.
즉,
서울,1998,홍길동→ 데이터- 회원 정보 표 전체 → 테이블
이 차이를 이해하면 뒤에서
SELECT문을 배울 때
“테이블에서 데이터를 조회한다”는 말이 훨씬 자연스럽게 들어온다.
참고
여기까지는 아직
SQL문법을 본격적으로 쓰기 전 단계다.
지금은 데이터를 어떤 구조에 저장하는지, 그리고 그 구조를 설명하는 기본 용어가 무엇인지를 먼저 익히는 구간이라고 보면 된다.
즉, 이제부터 배우게 될 SELECT 문은
아무것도 없는 상태에서 갑자기 나오는 문법이 아니라,
방금 정리한 테이블, 열, 행, DB 같은 구조 안에서 데이터를 꺼내 오는 명령이라는 점을 먼저 잡아두면 된다.
6. SELECT로 데이터 조회하기
개념
SELECT문은 데이터베이스 안에 들어 있는 데이터를 조회할 때 사용하는 가장 기본적인 문법이다.
쉽게 말하면 테이블 안에서 내가 보고 싶은 데이터를 꺼내 오는 명령이다.
여기서 같이 봐야 하는 것이FROM이다.
SELECT가 무엇을 조회할지 정하는 부분이라면,FROM은 어느 테이블에서 가져올지 정하는 부분이다.
즉, 가장 기본 흐름은 아래처럼 이해하면 된다.
SELECT: 무엇을 볼지FROM: 어디에서 가져올지
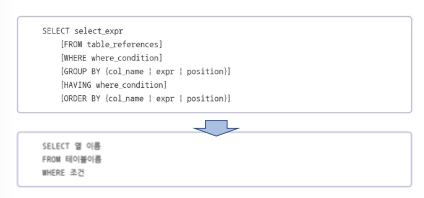
SELECT문의 전체 구조
SELECT문은 단순히SELECT와FROM만 있는 것이 아니다.
조회한 뒤에 조건을 붙일 수도 있고, 정렬할 수도 있고, 나중에는 그룹으로 묶어서 볼 수도 있다.
그래서 전체 구조를 먼저 한 번 보면 흐름이 더 잘 잡힌다.SELECT 추출하려는 컬럼 또는 식 리스트 [FROM 테이블명] [WHERE 행에 대한 조건식] [GROUP BY 그룹을 나누는데 있어서 기준이 되는 컬럼 또는 식] [HAVING 그룹에 대한 조건식] [ORDER BY 정렬의 기준이 되는 컬럼 또는 식]지금 단계에서는 이 구조를 전부 외울 필요는 없다.
다만SELECT문이 이런 큰 틀 안에서 움직인다는 것만 먼저 보면 된다.
SELECT: 조회할 대상FROM: 조회할 테이블WHERE: 조건GROUP BY: 같은 값끼리 묶기HAVING: 그룹에 조건 붙이기ORDER BY: 정렬하기이 파트에서는 우선
SELECT와FROM, 그리고 조회 결과를 다듬는DISTINCT,ALIAS까지만 먼저 보면 된다.
기본 문법
문법 역할 쉽게 말하면 SELECT조회할 데이터 선택 무엇을 볼지 정한다 FROM조회할 테이블 지정 어디에서 가져올지 정한다 DISTINCT중복 제거 같은 값은 한 번만 보여준다 ALIAS별칭 지정 결과 화면에 보일 이름을 바꾼다 지금 단계에서는 이 네 가지가
SELECT파트의 핵심이다.
SELECT와 FROM으로 기본 조회하기가장 먼저 볼 것은 테이블에서 데이터를 그대로 조회하는 방법이다.
전체 컬럼을 한 번에 볼 수도 있고,
필요한 컬럼만 골라서 볼 수도 있다.전체 조회는 테이블 안에 어떤 데이터가 들어 있는지 한 번에 확인할 때 유용하고,
컬럼 선택 조회는 필요한 정보만 간단히 보고 싶을 때 사용한다.
예제
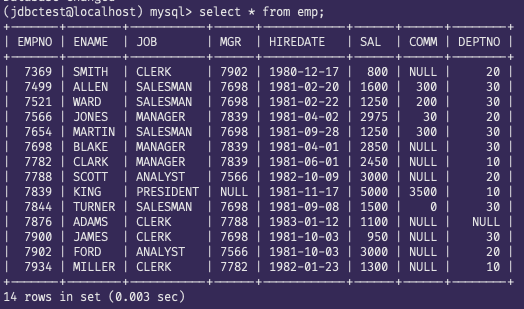
1. emp 테이블의 모든 컬럼 조회
select * from emp;
이 코드는
emp테이블의 모든 컬럼을 한 번에 조회하는 형태다.
여기서*는 전체 컬럼을 뜻한다.
즉, 테이블 안에 어떤 데이터가 들어 있는지 전체적으로 확인할 때 사용하는 가장 기본적인 조회 방식이다.
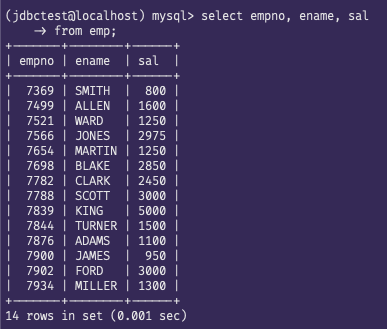
2. 필요한 컬럼만 골라서 조회
select empno, ename, sal
from emp;
이 코드는
emp테이블에서empno,ename,sal만 골라서 조회하는 형태다.
즉, 전체를 다 가져오는 것이 아니라 내가 필요한 컬럼만 선택해서 보는 방식이다.
실제로는 이런 식으로 필요한 정보만 골라서 조회하는 경우가 더 많다.
DISTINCT로 중복 없이 조회하기조회하다 보면 같은 값이 여러 번 반복되어 보일 때가 있다.
이럴 때 사용하는 것이DISTINCT다.
DISTINCT는 조회 결과에서 중복된 값을 한 번만 남겨서 보여주는 기능이다.
중요한 점은, 이 기능이 테이블 안의 원래 데이터를 바꾸는 것은 아니라는 점이다.
단지 조회 결과만 정리해서 보여주는 것이다.
예제
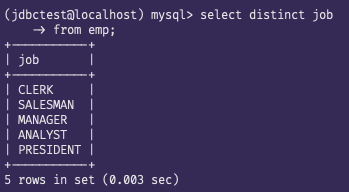
1. 직무를 중복 없이 조회
select distinct job
from emp;
이 코드는
job컬럼을 조회하되, 같은 직무가 여러 번 있어도 한 번만 보이게 만든다.
즉,DISTINCT는 데이터가 몇 행 있는지를 보는 것이 아니라,
어떤 종류의 값이 존재하는지를 확인할 때 유용하다.
2. 부서번호와 직무 조합을 중복 없이 조회
select distinct deptno, job
from emp;
이 코드는 컬럼이 두 개이기 때문에
deptno만 따로 보는 것이 아니라,
deptno와job을 묶은 결과 전체를 기준으로 중복을 제거한다.
그래서 부서번호가 같더라도 직무가 다르면 서로 다른 결과로 남는다.
이 부분이DISTINCT에서 가장 많이 헷갈리는 부분이다.
ALIAS로 컬럼 이름 바꾸기조회 결과를 보다 보면 원래 컬럼명이 그대로 보여서 읽기 불편할 때가 있다.
이럴 때 사용하는 것이ALIAS다.
ALIAS는 조회 결과에 임시 이름을 붙이는 기능이다.
즉, 테이블 안의 실제 컬럼명을 바꾸는 것이 아니라,
이번 조회 결과에서만 더 읽기 쉬운 이름으로 보여 주는 것이다.
또ALIAS는 원래 컬럼명뿐 아니라 계산 결과에도 붙일 수 있다.
그래서 단순히 “컬럼 이름 바꾸기”라고만 외우기보다,
조회 결과 제목을 보기 좋게 정리하는 기능으로 이해하는 편이 더 정확하다.
예제
1. 컬럼에 별칭 붙이기
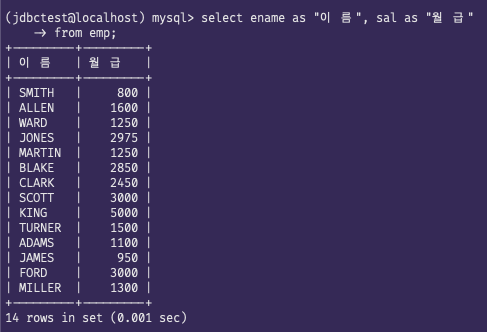
select ename as "이 름", sal as "월 급"
from emp;
이 코드는
ename과sal을 조회하지만,
결과 화면에서는 컬럼 제목이"이 름","월 급"으로 보이게 된다.
즉, 조회하는 데이터는 그대로 두고 결과에서 보이는 제목만 바꾸는 방식이다.
공백이 들어간 별칭은 따옴표로 묶어 주는 점도 같이 보면 된다.
2. 계산 결과에 별칭 붙이기
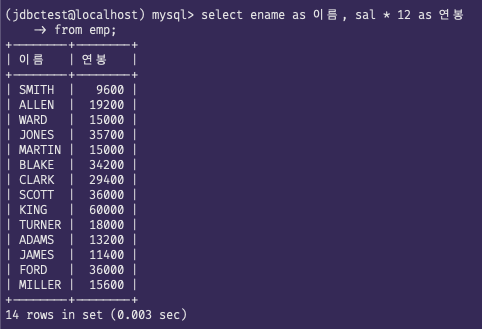
select ename as 이름, sal * 12 as 연봉
from emp;
이 코드는 직원의 이름과 함께 연봉을 계산해서 보여주는 예제다.
ename as 이름은ename컬럼을 조회하되, 결과 화면에서는이름이라는 제목으로 보이게 만든다.
sal * 12 as 연봉은 월급인sal에12를 곱해서 1년치 급여를 계산하고, 그 결과 컬럼에연봉이라는 이름을 붙인 것이다.
즉,ALIAS는 원래 컬럼명뿐 아니라 계산식 결과에도 붙일 수 있다는 점을 보여 주는 예제다.
헷갈리기 쉬운 부분
SELECT를 처음 배우면SELECT만 눈에 들어오고FROM은 뒤에 따라오는 요소처럼 느껴질 수 있다.
하지만 둘은 항상 같이 읽어야 한다.
SELECT: 무엇을 볼지FROM: 어디에서 가져올지또
DISTINCT는 원래 데이터를 지우는 기능이 아니라 조회 결과의 중복만 정리하는 기능이고,
ALIAS는 실제 컬럼명을 바꾸는 것이 아니라 결과 화면에서만 임시 이름을 붙이는 기능이라는 점도 구분해야 한다.
7. WHERE로 원하는 데이터 찾기
개념앞에서는
SELECT로 테이블 데이터를 그대로 조회했다면,
이제는 그중에서 내가 원하는 행만 골라서 보는 방법을 알아야 한다.
이 역할을 하는 것이WHERE절이다.
WHERE는 조회 결과에 조건을 붙여서, 필요한 데이터만 남기고 나머지는 제외하는 구문이다.
즉, 테이블 전체를 다 보는 것이 아니라 조건에 맞는 데이터만 찾고 싶을 때 사용한다.
예를 들어
- 이름이 특정 값인 직원만 보고 싶을 때
- 급여가 일정 범위 안에 있는 직원만 보고 싶을 때
- 특정 부서에 속한 직원만 보고 싶을 때
- 값이 비어 있는 데이터만 따로 보고 싶을 때
이런 경우에
WHERE를 사용한다.
WHERE문의 기본 구조
WHERE는 보통SELECT와FROM뒤에 붙는다.
형태는 아래처럼 이해하면 된다.SELECT 컬럼명 FROM 테이블명 WHERE 조건식;즉, 흐름은 이렇게 읽으면 된다.
SELECT: 무엇을 볼지FROM: 어디에서 가져올지WHERE: 어떤 조건에 맞는 것만 남길지지금부터는
WHERE절에서 자주 쓰는 조건들을 예제와 함께 하나씩 보면 된다.
같은 값을 찾을 때가장 먼저 익혀야 하는 것은 특정 값과 정확히 같은 데이터를 찾는 방법이다.
이때는=를 사용한다.
문자열은 작은따옴표로 감싸서 비교하고,
숫자는 그대로 비교한다.
즉, 이름이 특정 값인 직원이나 직무가 특정 값인 직원을 찾는 문제는
가장 먼저=비교를 떠올리면 된다.예제
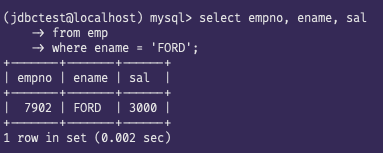
1. 이름이 FORD인 사원 찾기select empno, ename, sal from emp where ename = 'FORD';
이 코드는
emp테이블에서 이름이FORD인 행만 찾는 형태다.
where ename = 'FORD'는 이름이FORD와 정확히 같은 데이터만 남긴다는 뜻이다.
즉,WHERE뒤에는 이렇게 조건식이 들어가고, 그 조건이 참인 행만 결과에 남는다.
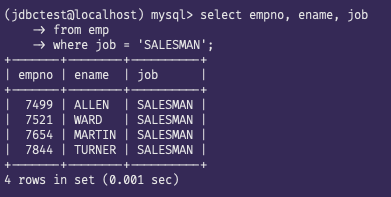
2. 직무가 SALESMAN인 사원 찾기select empno, ename, job from emp where job = 'SALESMAN';
이 코드는 직무가
SALESMAN인 사원만 조회하는 형태다.
이름 대신job컬럼으로 비교한다는 점만 다르고 원리는 같다.
즉,=는 어떤 컬럼의 값이 특정 값과 정확히 같은지 확인할 때 사용하는 가장 기본적인 조건식이다.
여러 값 중 하나를 찾을 때같은 컬럼을 여러 값과 비교해야 할 때가 있다.
예를 들어 사원번호가7499,7521,7654중 하나인 경우처럼,
후보값이 여러 개일 때다.
이럴 때는OR를 여러 번 써도 되고,
IN()을 사용해도 된다.예제
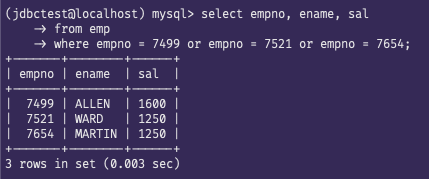
1. OR로 여러 사원번호 찾기select empno, ename, sal from emp where empno = 7499 or empno = 7521 or empno = 7654;
이 코드는 사원번호가
7499이거나7521이거나7654인 사원만 조회하는 형태다.
OR는 여러 조건 중 하나만 만족해도 되는 경우에 사용한다.
즉, 같은 컬럼을 여러 값과 하나씩 비교해서 연결한 방식이다.
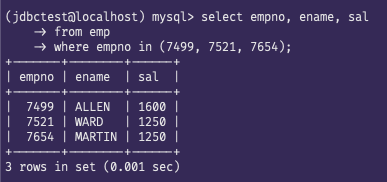
2. IN()으로 여러 사원번호 찾기select empno, ename, sal from emp where empno in (7499, 7521, 7654);
이 코드는 위와 같은 조건을 더 짧게 적은 형태다.
IN()은 같은 컬럼에 대해 여러 후보값 중 하나를 찾을 때 사용한다.
즉, 같은 컬럼을 여러 값과 비교해야 할 때는OR를 반복하는 대신IN()으로 묶어서 더 읽기 쉽게 표현할 수 있다.
범위를 찾을 때숫자나 날짜처럼 시작값과 끝값 사이를 찾고 싶을 때는 범위 조건을 사용한다.
이럴 때는 비교 연산자를 직접 써도 되고,BETWEEN ... AND를 써도 된다.
먼저 비교 연산자의 뜻부터 간단히 보면 이렇다.
>: 크다<: 작다>=: 크거나 같다<=: 작거나 같다즉, “이상”, “이하”, “사이” 같은 말이 나오면 범위 조건을 먼저 떠올리면 된다.
예제
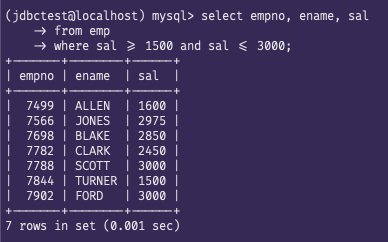
1. AND로 급여 범위 찾기select empno, ename, sal from emp where sal >= 1500 and sal <= 3000;
이 코드는 급여가
1500이상이면서3000이하인 사원만 조회하는 형태다.
범위의 시작과 끝을 직접 적고, 두 조건을 모두 만족해야 하므로AND를 사용한다.
즉,AND는 여러 조건을 동시에 만족해야 할 때 사용하는 연결 방식이다.
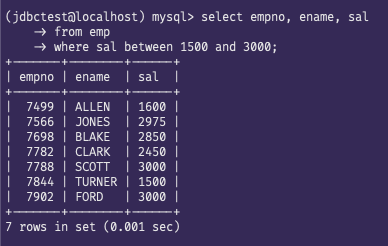
2. BETWEEN ... AND로 급여 범위 찾기select empno, ename, sal from emp where sal between 1500 and 3000;
이 코드는 위와 같은 범위를 더 짧게 표현한 형태다.
BETWEEN ... AND는 연속된 범위 조건을 한 번에 읽기 쉽게 적고 싶을 때 사용한다.
즉, 범위 조회에서는 비교 연산자를 직접 쓸 수도 있고,BETWEEN ... AND로 묶어서 쓸 수도 있다.
문자열의 모양으로 찾을 때조건 조회는 항상 정확히 같은 값만 찾는 것은 아니다.
문자열 안에 특정 글자가 들어 있는지,
어떤 글자로 시작하는지,
어떤 글자로 끝나는지를 기준으로 찾고 싶을 때도 있다.
이럴 때 사용하는 것이LIKE다.
LIKE는 문자열을 정확히 같은 값으로 비교하는 것이 아니라, 글자 모양이나 패턴으로 찾는 조건식이다.
LIKE를 사용할 때는 보통 아래 두 기호를 같이 쓴다.
%: 글자가 0개 이상 올 수 있음_: 정확히 한 글자
즉,
A%→A로 시작%A%→ 중간 어디든A포함%S→S로 끝남_A%→ 두 번째 글자가A이런 식으로 해석하면 된다.
예제
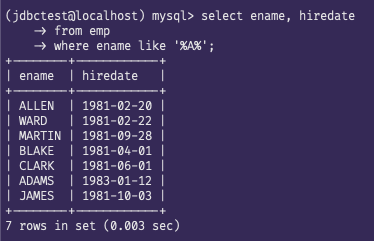
1. 이름에 A가 들어간 직원 찾기select ename, hiredate from emp where ename like '%A%';
이 코드는 이름 안에
A가 들어 있는 직원만 찾는 형태다.
%A%는 앞뒤에 어떤 글자가 오더라도 중간 어딘가에A가 있으면 된다는 뜻이다.
즉,LIKE는 문자열 전체가 아니라, 글자가 어떻게 들어 있는지를 기준으로 찾을 때 사용한다.
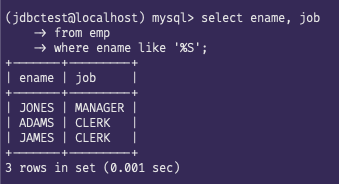
2. 이름이 S로 끝나는 직원 찾기select ename, job from emp where ename like '%S';
이 코드는 이름이
S로 끝나는 직원만 조회하는 형태다.
앞에는 어떤 글자가 와도 되고, 마지막 글자만S면 된다.
즉,%는 글자 수가 정해져 있지 않을 때 사용하는 와일드카드라고 보면 된다.
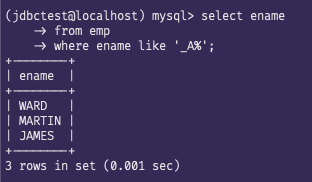
3. 이름의 두 번째 글자가 A인 직원 찾기select ename from emp where ename like '_A%';
이 코드는 첫 글자는 아무거나 와도 되고, 두 번째 글자가
A인 이름을 찾는 형태다.
여기서_는 정확히 한 글자를 뜻한다.
즉,LIKE는%와_를 함께 사용해서 문자열의 위치 조건까지 표현할 수 있다는 점이 중요하다.
여러 조건을 함께 묶을 때조건은 하나만 쓰는 것이 아니라,
두 개 이상을 함께 묶어서 더 정확하게 찾을 수도 있다.
이때 자주 쓰는 것이AND,OR,NOT이다.
AND: 둘 다 만족해야 한다.OR: 둘 중 하나만 만족해도 된다.NOT: 조건을 반대로 뒤집는다.
예제
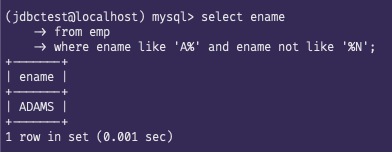
1. 첫 글자가 A이고 마지막 글자가 N이 아닌 사원 찾기select ename from emp where ename like 'A%' and ename not like '%N';
이 코드는 두 조건을 함께 사용한 형태다.
먼저ename like 'A%'로 이름의 첫 글자가A인 데이터만 남기고,
그다음ename not like '%N'으로 마지막 글자가N인 경우를 제외한다.
즉,AND는 조건을 더 좁히고,NOT은 특정 조건을 제외할 때 사용한다고 이해하면 된다.
값이 비어 있는 데이터를 찾을 때테이블을 조회하다 보면 값이 비어 있는 데이터를 따로 찾아야 할 때가 있다.
이럴 때 등장하는 것이NULL이다.
NULL은 숫자0도 아니고, 빈 문자열도 아니다.
즉, 값이 입력되지 않은 상태라고 보면 된다.
중요한 점은NULL은 일반 값처럼=로 비교하면 안 된다는 것이다.
NULL은 값 자체를 비교하는 것이 아니라, 값이 있느냐 없느냐를 따로 확인해야 한다.
그래서IS NULL,IS NOT NULL을 사용한다.예제
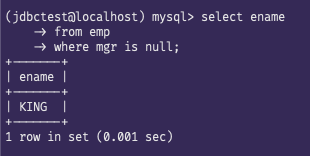
1. 매니저가 없는 직원 찾기select ename from emp where mgr is null;
이 코드는
mgr값이 비어 있는 직원만 조회하는 형태다.
즉, 매니저 정보가 없는 행만 찾는 것이다.
NULL은=가 아니라IS NULL로 확인해야 한다는 점이 핵심이다.
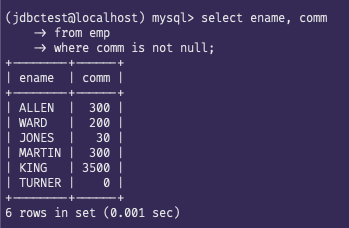
2. 커미션이 있는 직원 찾기select ename, comm from emp where comm is not null;
이 코드는
comm값이 실제로 들어 있는 직원만 조회하는 형태다.
즉, 커미션 정보가 비어 있지 않은 행만 찾는 것이다.
이처럼IS NOT NULL은 값이 없는 데이터를 찾는 반대 개념으로, 값이 들어 있는 데이터만 따로 보고 싶을 때 사용한다.
헷갈리기 쉬운 부분
WHERE절은 하나의 문법처럼 보이지만,
실제로는 안에 여러 종류의 조건식이 들어간다.
그래서 문제를 볼 때 먼저 지금 찾으려는 것이 어떤 종류의 조건인지부터 구분해야 한다.
- 정확히 같은 값 찾기 →
=- 여러 값 중 하나 찾기 →
IN(),OR- 범위 찾기 →
BETWEEN ... AND, 비교 연산자- 문자열 패턴 찾기 →
LIKE- 값이 비어 있는지 찾기 →
IS NULL,IS NOT NULL즉,
WHERE절은 문법 하나를 외우는 것이 아니라,
조건식의 종류를 구분해서 맞는 것을 골라 쓰는 파트라고 이해하면 된다.
8. ORDER BY로 원하는 순서대로 정렬하기
개념앞에서는
SELECT와WHERE를 이용해서
필요한 데이터를 조회하고 조건에 맞는 행만 골라봤다.
이제는 조회한 결과를 어떤 순서로 보여줄지 정하는 방법을 알아야 한다.
이 역할을 하는 것이ORDER BY절이다.
ORDER BY는 결과 자체를 바꾸는 구문이 아니다.
조건에 맞는 데이터를 찾은 뒤,
그 결과를 어떤 기준으로 정렬해서 보여줄지 정하는 구문이다.
예를 들어 직원 정보를 조회했을 때
급여가 낮은 사람부터 보고 싶을 수도 있고,
반대로 급여가 높은 사람부터 보고 싶을 수도 있다.
또는 입사일이 최근인 사람부터 보고 싶을 수도 있다.
이럴 때ORDER BY를 사용한다.
ORDER BY문의 기본 구조
ORDER BY는 보통 쿼리의 맨 뒤에 붙는다.
형태는 아래처럼 이해하면 된다.SELECT 컬럼명 FROM 테이블명 ORDER BY 정렬기준;즉, 흐름은 이렇게 읽으면 된다.
SELECT: 무엇을 볼지FROM: 어디에서 가져올지ORDER BY: 어떤 기준으로 순서를 정할지조건이 있는 경우에는
WHERE로 먼저 행을 걸러내고, 그다음ORDER BY로 남은 결과를 정렬한다.
즉, 먼저 데이터를 조회하고,
마지막에 어떤 컬럼 기준으로 순서를 다시 정렬할지 붙이는 방식이다.
작은 값부터 정렬할 때
ORDER BY는 기본적으로 오름차순 정렬이다.
숫자는 작은 값부터 큰 값 순서로,
날짜는 오래된 것부터 최근 것 순서로 정렬된다고 생각하면 된다.
이때는ASC를 따로 쓰지 않아도 된다.예제
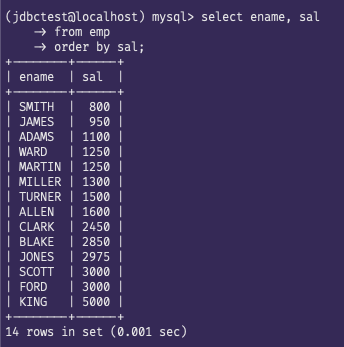
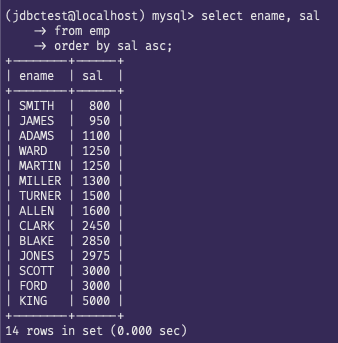
1. 급여가 낮은 순서대로 정렬하기select ename, sal from emp order by sal;
이 코드는 이름과 급여를 조회한 뒤,
급여가 낮은 사람부터 보이게 정렬하는 형태다.
여기서order by sal은 급여를 기준으로 오름차순 정렬하라는 뜻이다.
ASC를 쓰지 않았지만 기본이 오름차순이기 때문에 작은 값부터 큰 값 순서로 정렬된다.
2. ASC를 붙여서 오름차순 정렬하기select ename, sal from emp order by sal asc;
이 코드는 위와 같은 뜻을 조금 더 분명하게 적은 형태다.
즉,order by sal;과order by sal asc;는 같은 의미다.
처음 배우는 단계에서는ASC를 함께 적어 두면 정렬 방향을 더 분명하게 이해할 수 있다.
큰 값부터 정렬할 때반대로 큰 값부터 보고 싶다면
DESC를 붙이면 된다.
DESC는 내림차순 정렬을 뜻한다.
즉, 숫자는 큰 값부터 작은 값 순서로,
날짜는 최근 것부터 오래된 것 순서로 정렬된다.예제
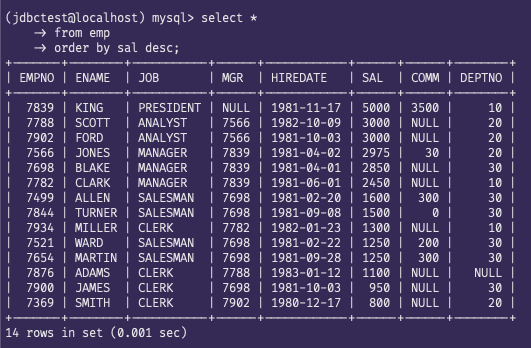
1. 급여가 많은 순으로 정렬하기select * from emp order by sal desc;
이 코드는
emp테이블의 모든 정보를 조회한 뒤,
급여가 높은 직원부터 먼저 보이게 정렬하는 형태다.
여기서desc가 핵심이다.
같은order by sal이라도desc를 붙이면 작은 값부터가 아니라 큰 값부터 정렬된다.
즉, 급여가 많은 순으로 출력하라는 문제를 보면 먼저order by sal desc를 떠올리면 된다.
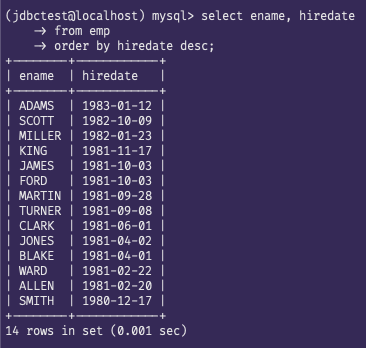
2. 최근 입사한 순으로 정렬하기select ename, hiredate from emp order by hiredate desc;
이 코드는 이름과 입사일을 조회한 뒤,
최근에 입사한 직원부터 먼저 보이게 정렬하는 형태다.
날짜도 숫자처럼 크고 작은 기준으로 비교할 수 있으므로,
최근 날짜를 먼저 보려면desc를 사용한다.
즉, “최근 순”이라는 말이 나오면 날짜 컬럼에desc를 붙이는 흐름으로 이해하면 된다.
조건을 먼저 걸고 정렬할 때정렬은 혼자 쓰는 것보다
WHERE와 함께 쓰는 경우가 많다.
이때는 먼저 조건에 맞는 데이터만 남기고,
그다음 남은 결과를 정렬한다.
즉, 역할이 이렇게 나뉜다.
WHERE: 어떤 행을 남길지ORDER BY: 남은 결과를 어떤 순서로 보여줄지
예제
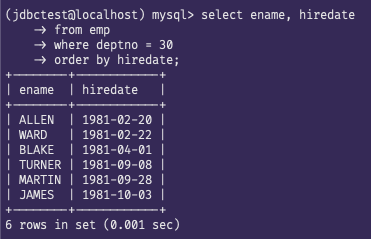
1. 30번 부서 직원을 오래 입사한 순으로 정렬하기select ename, hiredate from emp where deptno = 30 order by hiredate;
이 코드는 먼저
deptno = 30조건으로 30번 부서 직원만 남기고,
그다음 그 결과를 입사일 기준으로 정렬하는 형태다.
여기서는hiredate에asc를 생략했기 때문에 기본 오름차순이 적용된다.
즉, 오래전에 입사한 직원부터 먼저 보이게 정렬된다.
“30번 부서 직원 중 입사한지 오래된 순” 같은 문제는 이렇게WHERE와ORDER BY를 함께 써서 해결하면 된다.
정렬 기준을 여러 개 둘 때정렬 기준은 하나만 쓰는 것이 아니라,
여러 개를 함께 쓸 수도 있다.
이렇게 하면 먼저 첫 번째 기준으로 정렬하고,
첫 번째 기준이 같은 값끼리는 두 번째 기준으로 다시 정렬한다.예제
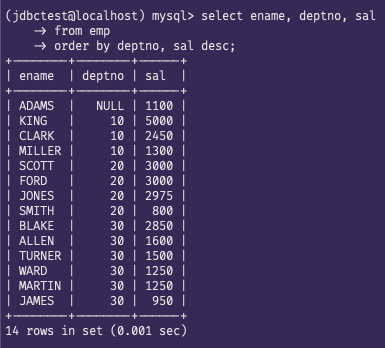
1. 부서번호 순으로 정렬하고, 같은 부서 안에서는 급여 높은 순으로 보기select ename, deptno, sal from emp order by deptno, sal desc;
이 코드는 먼저
deptno를 기준으로 정렬하고,
같은 부서번호 안에서는sal을 기준으로 다시 정렬하는 형태다.
즉, 정렬이 한 번만 일어나는 것이 아니라 순서대로 두 단계 적용되는 것이다.
그래서 이 예제는ORDER BY가 단순히 한 줄 정렬만 하는 게 아니라,
정렬 기준을 여러 단계로 줄 수도 있다는 점을 보여준다.
LIMIT으로 원하는 개수만 보기정렬을 하다 보면 전체를 다 보는 것이 아니라,
그중에서 앞쪽 일부만 보고 싶을 때도 많다.
예를 들어 급여가 높은 순으로 정렬한 뒤,
상위 1명이나 상위 3명만 보고 싶을 수 있다.
이럴 때 사용하는 것이LIMIT이다.
LIMIT은 조회 결과 중에서 몇 개의 행만 보여줄지 제한하는 구문이다.예제
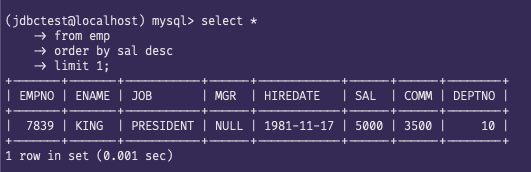
1. 급여를 가장 많이 받는 직원 한 명 보기select * from emp order by sal desc limit 1;
이 코드는 먼저 급여가 높은 순서대로 정렬한 뒤,
그중 맨 앞의 1행만 남기는 형태다.
즉, “급여를 제일 많이 받는 직원”을 찾을 때
정렬과limit 1을 함께 써서 가장 위에 오는 한 명만 보는 방식이다.
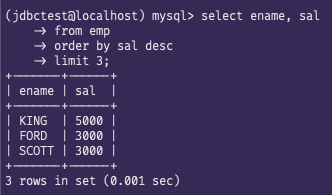
2. 급여가 높은 직원 상위 3명 보기select ename, sal from emp order by sal desc limit 3;
이 코드는 급여가 높은 순서대로 먼저 정렬하고,
그다음 위에서부터 3명만 보여주는 형태다.
여기서 중요한 점은LIMIT이 혼자 의미를 만드는 것이 아니라,
정렬과 함께 써야 비로소 “상위 몇 명”이라는 의미가 분명해진다는 것이다.
즉,LIMIT은 정렬된 결과에서 앞부분만 잘라서 보여주는 역할이라고 보면 된다.
헷갈리기 쉬운 부분
ORDER BY는 데이터를 수정하는 구문이 아니다.
테이블 안의 값이 바뀌는 것이 아니라,
출력되는 순서만 바뀐다.
또 정렬 방향도 구분해야 한다.
ASC: 오름차순DESC: 내림차순그리고
LIMIT은 정렬 없이 그냥 쓰면 단순히 앞의 몇 행만 보여주는 기능일 뿐이다.
반대로ORDER BY와 함께 쓰면, 정렬된 결과에서 상위 몇 개만 보여주는 의미가 된다.
즉,ORDER BY는 어떤 순서로 보여줄지,
LIMIT은 그중 몇 개만 보여줄지를 정하는 역할이라고 이해하면 된다.
9. MySQL 내장 함수로 값 가공하기
개념앞에서는
SELECT,WHERE,ORDER BY를 이용해서 데이터를 조회하고, 조건을 걸고, 정렬하는 방법을 봤다.
그런데 실제로 조회를 하다 보면 값을 그대로 보는 것만으로는 부족한 경우가 많다.
예를 들어
- 문자열을 소문자로 바꿔서 보고 싶을 때
- 이름의 일부만 잘라서 보고 싶을 때
- 숫자를 반올림하거나 버려서 보고 싶을 때
NULL값을 다른 값으로 바꿔서 계산하고 싶을 때- 날짜를 원하는 형식으로 바꿔서 출력하고 싶을 때
이럴 때 사용하는 것이
내장 함수다.
내장 함수는MySQL이 원래부터 제공하는 기능으로,
조회한 값을 가공해서 더 보기 좋게 만들거나 계산할 때 사용한다.
즉,내장 함수는 데이터를 새로 만드는 문법이 아니라,
조회한 값을 원하는 형태로 바꿔서 보여 주는 도구라고 이해하면 된다.
문자열을 가공할 때문자 관련 함수는 문자열을 소문자로 바꾸거나,
일부분만 잘라서 가져오거나,
문자 개수를 세거나,
여러 문자열을 이어 붙일 때 사용한다.
즉, 문자열을 그대로 두지 않고 원하는 모양으로 바꿔서 보여 줄 때 쓰는 함수들이다.
1. LOWER()
LOWER()는 영문자를 소문자로 바꾸는 함수다.
대문자로 저장된 값을 소문자로 바꿔 보고 싶을 때 사용한다.
예제
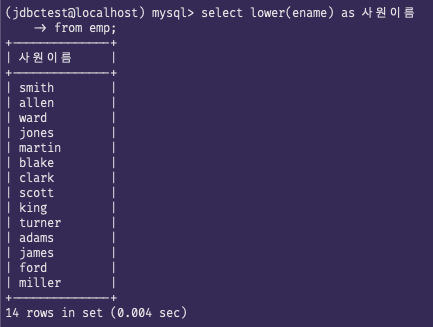
1. 사원 이름을 소문자로 출력하기select lower(ename) as 사원이름 from emp;
이 코드는
ename값을 그대로 보여 주는 것이 아니라,
lower(ename)을 사용해서 모두 소문자로 바꾼 뒤 출력하는 형태다.
즉,LOWER()는 문자열의 대소문자 모양을 바꾸고 싶을 때 사용하는 함수다.
2. SUBSTRING()
SUBSTRING()은 문자열의 일부분만 잘라서 가져오는 함수다.
즉, 문자열 전체가 아니라 원하는 위치만 뽑아서 보고 싶을 때 사용한다.
예제
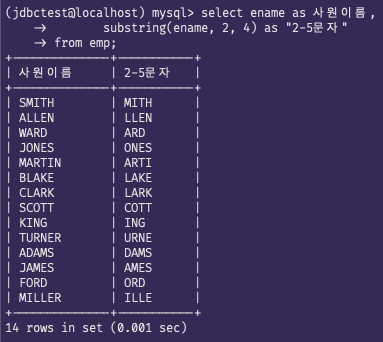
1. 이름의 두 번째 글자부터 네 글자 가져오기select ename as 사원이름, substring(ename, 2, 4) as "2-5문자" from emp;
이 코드는 이름 전체 대신 두 번째 글자부터 네 글자만 잘라서 보여 준다.
즉,SUBSTRING()은 문자열 안에서 필요한 위치만 뽑아 올 때 사용하는 함수다.
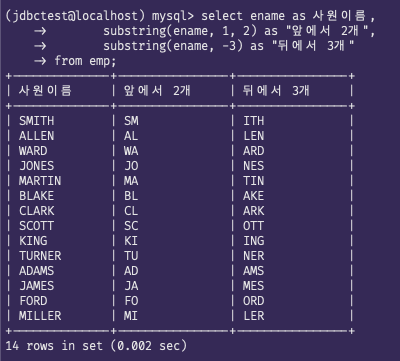
2. 이름의 앞 두 글자와 뒤 세 글자 가져오기select ename as 사원이름, substring(ename, 1, 2) as "앞에서 2개", substring(ename, -3) as "뒤에서 3개" from emp;
이 코드는 문자열의 앞부분과 뒷부분을 각각 잘라서 보여 준다.
여기서substring(ename, -3)처럼 음수를 쓰면 뒤쪽부터 위치를 셀 수 있다.
즉,SUBSTRING()은 문자열의 앞쪽뿐 아니라 뒤쪽 기준으로도 잘라 낼 수 있다는 점을 같이 보면 된다.
3. LENGTH()
LENGTH()는 문자열의 길이를 구하는 함수다.
즉, 문자열이 몇 글자인지 세고 싶을 때 사용한다.
예제
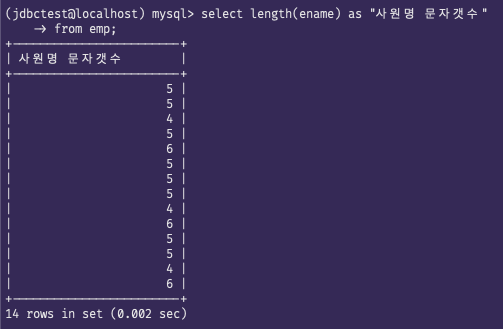
1. 사원 이름의 문자 개수 출력하기select length(ename) as "사원명 문자갯수" from emp;
이 코드는 각 직원 이름이 몇 글자인지를 숫자로 보여 준다.
즉,LENGTH()는 문자열의 길이나 개수를 확인하고 싶을 때 사용하는 함수다.
4. CONCAT()
CONCAT()은 문자열을 이어 붙이는 함수다.
즉, 여러 값을 하나의 문자열처럼 합쳐서 보여 주고 싶을 때 사용한다.
예제
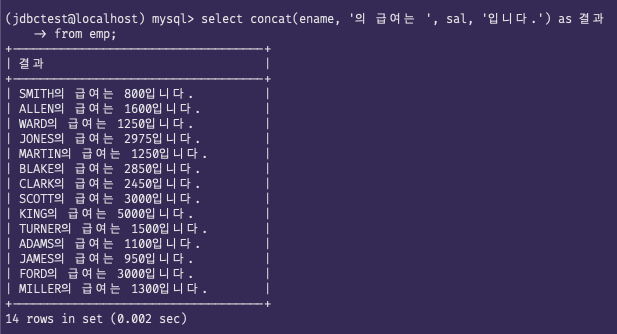
1. 이름과 문장을 이어 붙여 출력하기select concat(ename, '의 급여는 ', sal, '입니다.') as 결과 from emp;
이 코드는 이름과 급여를 따로 보여 주는 것이 아니라,
하나의 문장처럼 이어 붙여서 출력하는 형태다.
즉,CONCAT()은 여러 값이나 문자열 조각을 하나로 합칠 때 사용하는 함수다.
숫자를 가공할 때숫자 관련 함수는 계산 결과를 반올림하거나,
버리거나,
보기 좋은 숫자 형태로 바꿔서 보여 줄 때 사용한다.
즉, 숫자를 그대로 두지 않고 읽기 좋은 숫자 모양으로 정리할 때 사용하는 함수들이다.
1. ROUND()
ROUND()는 반올림 함수다.
지정한 자리에서 숫자를 반올림해서 보여 준다.
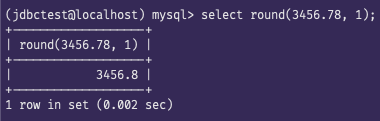
예제
1. 3456.78을 소수점 첫째 자리까지 반올림하기select round(3456.78, 1);
이 코드는3456.78을 소수점 첫째 자리까지 반올림해서 보여 주는 형태다.
즉,ROUND()는 계산 결과를 보기 좋은 숫자로 정리하고 싶을 때 사용하는 함수다.
2. TRUNCATE()
TRUNCATE()는 버림 함수다.
지정한 자리 아래를 그냥 잘라낸다.
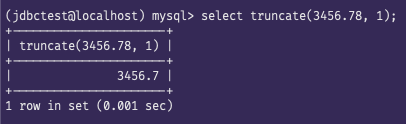
예제
1. 3456.78을 소수점 첫째 자리까지 버리기select truncate(3456.78, 1);
이 코드는
3456.78을 소수점 첫째 자리까지만 남기고 그 아래는 버리는 형태다.
즉,TRUNCATE()는 반올림 없이 특정 자리 아래를 버리고 싶을 때 사용하는 함수다.
3. FORMAT()
FORMAT()은 숫자를 보기 좋은 문자열 형태로 바꿔 주는 함수다.
대표적으로 천 단위 쉼표를 붙이거나, 소수점 자리수를 정해서 출력할 때 사용한다.
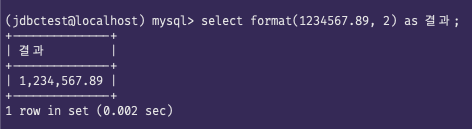
즉, 숫자를 다시 계산하는 함수라기보다 화면에 보이는 숫자 모양을 정리하는 함수라고 이해하면 된다.예제
1. 숫자에 천 단위 쉼표 붙이기select format(1234567.89, 2) as 결과;
이 코드는 숫자
1234567.89를 그대로 보여 주는 것이 아니라,
천 단위마다 쉼표를 넣고 소수점 둘째 자리까지 보이게 만든 형태다.
즉,FORMAT()은 숫자 계산용 함수라기보다 숫자 모양을 정리하는 함수라고 보면 된다.
값이 비어 있거나 조건에 따라 다르게 보여 줄 때조회하다 보면
NULL때문에 계산이 잘 안 되거나,
조건에 따라 다른 결과를 보여 주고 싶을 때가 있다.
이럴 때 자주 쓰는 것이IFNULL(),IF(),CASE다.
즉, 이 함수들은 값을 단순히 계산하는 것보다 상황에 맞게 바꿔서 보여 주는 역할에 가깝다.
1. IFNULL()
IFNULL()은 값이NULL이면 대신 다른 값을 넣어 주는 함수다.
즉, 비어 있는 값을 다른 값으로 바꿔서 계산하거나 출력하고 싶을 때 사용한다.
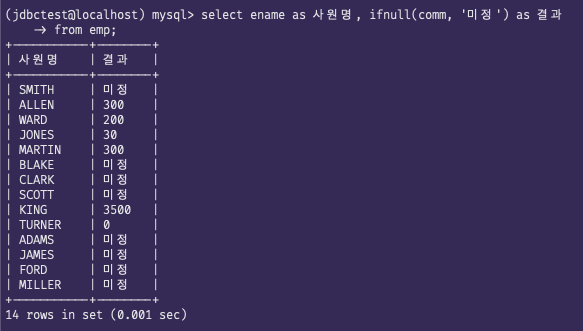
예제
1. 커미션이 없으면 미정으로 출력하기select ename as 사원명, ifnull(comm, '미정') as 결과 from emp;
이 코드는
comm값이 있으면 그대로 보여 주고,
NULL이면미정으로 바꿔서 출력하는 형태다.
즉,IFNULL()은 비어 있는 값을 다른 값으로 대신 보여 줄 때 사용하는 함수다.
2. IF()
IF()는 조건을 검사해서 참이면 한 값을, 거짓이면 다른 값을 반환하는 함수다.
즉, 결과를 두 갈래로 나눠서 보여 주고 싶을 때 사용한다.
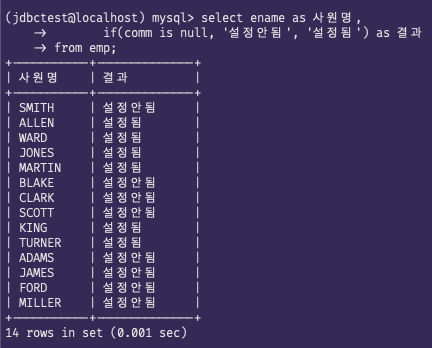
예제
1. 커미션 설정 여부를 설정됨 / 설정안됨으로 출력하기select ename as 사원명, if(comm is null, '설정안됨', '설정됨') as 결과 from emp;
이 코드는
comm값이NULL이면설정안됨,NULL이 아니면설정됨으로 보여 주는 형태다.
즉,IF()는 조건에 따라 두 가지 결과 중 하나를 선택할 때 사용하는 함수다.
3. CASE
CASE는 조건에 따라 결과를 여러 갈래로 나누는 함수다.
즉, 단순히 두 가지가 아니라 여러 구간이나 여러 경우를 나눠서 보여 주고 싶을 때 사용한다.
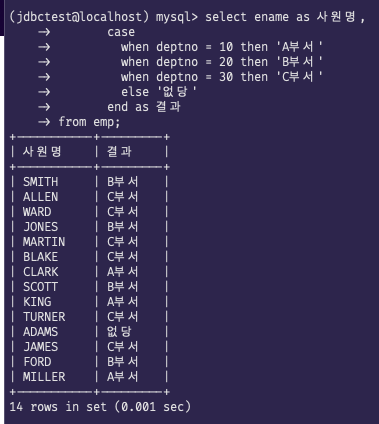
예제
1. 부서번호에 따라 부서명 바꾸기select ename as 사원명, case when deptno = 10 then 'A부서' when deptno = 20 then 'B부서' when deptno = 30 then 'C부서' else '없당' end as 결과 from emp;
이 코드는 부서번호에 따라 다른 이름을 붙이고,
부서번호가 없으면없당을 출력하는 형태다.
즉,CASE는 하나의 값을 기준으로 여러 경우를 나눠서 다른 결과를 보여 줄 때 사용하는 함수다.
날짜와 시간을 가공할 때날짜 관련 함수는 현재 날짜와 시간을 가져오거나,
원하는 모양으로 바꾸거나,
며칠 뒤처럼 날짜 계산을 할 때 사용한다.
즉, 날짜 함수는 현재 시점 확인 + 날짜 형식 바꾸기 + 날짜 계산 흐름으로 보면 이해하기 쉽다.
1. NOW()
NOW()는 현재 날짜와 시간을 반환하는 함수다.
즉, 지금 시각을 기준값으로 삼고 싶을 때 사용한다.
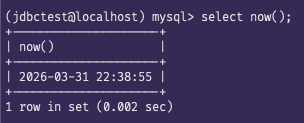
예제
1. 현재 날짜와 시간 출력하기select now();
이 코드는 실행한 시점의 현재 날짜와 시간을 보여 주는 형태다.
즉,NOW()는 현재 시점을 기준으로 확인하거나 계산할 때 사용하는 함수다.
2. DATE_ADD()
DATE_ADD()는 날짜에 일정 시간이나 날짜를 더하는 함수다.
즉, 며칠 뒤, 몇 달 뒤, 몇 년 뒤 같은 날짜를 계산할 때 사용한다.
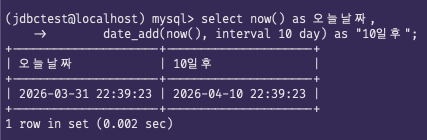
예제
1. 오늘 날짜에서 10일 더한 날짜 구하기select now() as 오늘날짜, date_add(now(), interval 10 day) as "10일후";
이 코드는 현재 날짜를 기준으로 10일 뒤 날짜를 계산해서 보여 준다.
즉,DATE_ADD()는 기준 날짜에 시간을 더해서 새로운 날짜를 만들 때 사용하는 함수다.
3. DATE_FORMAT()
DATE_FORMAT()은 날짜 데이터를 원하는 형식의 문자열로 바꿔서 출력하는 함수다.
즉, 날짜 값을 계산하는 함수가 아니라 보여 주는 모양을 바꾸는 함수라고 이해하면 된다.
자주 쓰는 형식 문자는 아래처럼 정리할 수 있다.
형식 문자 의미 예시 %Y연도 4자리 2026%y연도 2자리 26%m월 2자리 03%c월 3%d일 2자리 01,31%e일 1,31%H시 24시간 형식 09,18%h시 12시간 형식 09,06%i분 05,30%s초 07,45%W요일 이름 Monday%a요일 약어 Mon즉, 이런 형식 문자를 조합해서 날짜를 내가 보고 싶은 모양으로 바꿀 수 있다.
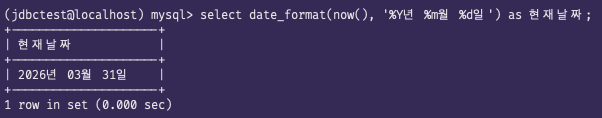
예제
1. 현재 날짜를 원하는 형식으로 출력하기select date_format(now(), '%Y년 %m월 %d일') as 현재날짜;
이 코드는 현재 날짜를 그대로 보여 주는 것이 아니라,
년,월,일이 들어간 형태로 바꿔서 출력하는 예제다.
즉,DATE_FORMAT()은 날짜 데이터를 보기 쉬운 형식으로 바꿔서 보여 줄 때 사용한다.
4. TIMESTAMPDIFF()
TIMESTAMPDIFF()는 두 날짜 사이의 차이를 원하는 단위로 구하는 함수다.
즉, 몇 개월 차이인지, 며칠 차이인지처럼 날짜 간격을 계산할 때 사용한다.
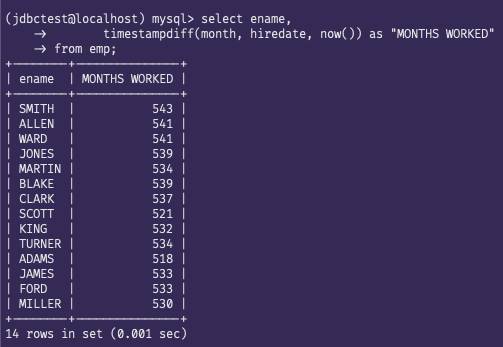
예제
1. 입사 후 몇 개월 일했는지 구하기select ename, timestampdiff(month, hiredate, now()) as "MONTHS WORKED" from emp;
이 코드는 입사일과 현재 날짜 사이 차이를 개월 수로 계산해서 보여 주는 형태다.
즉,TIMESTAMPDIFF()는 두 날짜 사이 차이를 원하는 단위로 계산할 때 사용하는 함수다.
헷갈리기 쉬운 부분내장 함수는 종류가 많아서 처음에는 전부 비슷해 보일 수 있다.
그래서 기능별로 묶어서 기억하는 것이 좋다.
- 문자열 가공 →
LOWER(),SUBSTRING(),LENGTH(),CONCAT()- 숫자 가공 →
ROUND(),TRUNCATE(),FORMAT()NULL/ 조건 처리 →IFNULL(),IF(),CASE- 날짜 처리 →
NOW(),DATE_ADD(),DATE_FORMAT(),TIMESTAMPDIFF()즉, 내장 함수는 이름만 외우는 것이 아니라
이 함수가 값을 어떻게 바꾸는지까지 같이 이해해야 한다.
10. SQL 실습 문제
문제 해석은 이렇게 한다응용 문제는 문장을 한 번에 보면 헷갈리기 쉽다.
그래서 바로 SQL을 쓰지 말고, 먼저 문제 문장을 짧게 끊어서 읽어야 한다.
보통은 아래 순서로 보면 된다.
- 무엇을 조회하라는지
- 값을 그대로 보여 주는지, 바꿔서 보여 주는지
- 조건이 있는지
- 정렬이 있는지
- 한 문법으로 끝나는지, 여러 문법을 이어야 하는지
즉, 문제를 보면
조회 → 가공 → 조건 → 정렬
이 순서로 읽는 습관을 들이면 된다.
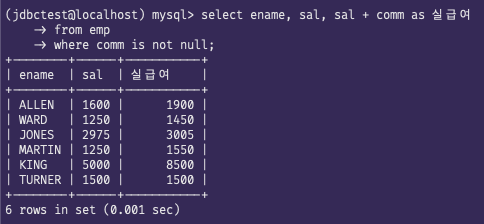
1. 사원테이블에서 사원이름, 급여를 뽑고, 급여과 커미션을 더한 값을 출력하는데 컬럼명을 '실급여'이라고 해서 출력하는 명령을 작성하시오. 단, 커미션이 정해지지 않은 사람제외이 문제는 문장을 끝까지 읽어야 한다.
사원이름, 급여를 뽑고
→ 먼저ename,sal을 조회해야 한다.
급여과 커미션을 더한 값을 출력
→sal + comm계산 결과도 같이 보여 줘야 한다.
컬럼명을 '실급여'이라고 해서 출력
→ 계산 결과에 별칭을 붙여야 한다.
단, 커미션이 정해지지 않은 사람제외
→ 여기서 끝까지 읽는 게 중요하다.
그냥 계산만 하면 끝나는 게 아니라,comm이 없는 행은 빼야 하므로 조건까지 같이 들어간다.
즉, 이 문제는
조회 + 계산 + 별칭 + 조건
이 네 가지가 같이 들어 있는 문제다.
정답 코드select ename, sal, sal + comm as 실급여 from emp where comm is not null;
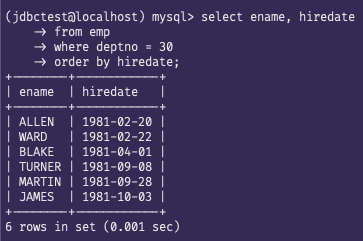
2. 사원 테이블에서 30번 부서에 근무하는 직원들의 이름과 입사년월일을 출력하는데 입사한지 오래된 순으로 출력하는 명령을 작성하시오.이 문제는 두 부분으로 나눠서 읽어야 한다.
30번 부서에 근무하는 직원들
→ 먼저 30번 부서 직원만 골라야 한다.
즉,WHERE조건이 들어간다.
이름과 입사년월일을 출력
→ 보여 줄 컬럼은ename,hiredate다.
입사한지 오래된 순으로 출력
→ 오래전에 입사한 사람부터 보여 줘야 한다.
즉, 입사일 기준 오름차순 정렬이 필요하다.
그래서 이 문제는
조건 + 필요한 컬럼 조회 + 정렬
문제다.
정답 코드select ename, hiredate from emp where deptno = 30 order by hiredate;
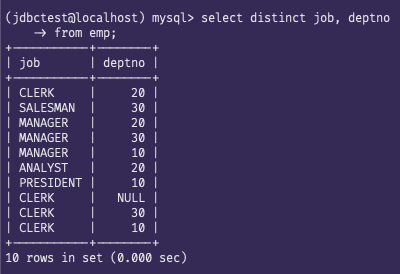
3. 직원들의 직무와 부서번호만 출력하는데 중복행은 한 행만 출력하는 명령을 작성하시오.이 문제는 짧아 보여도 해석을 정확히 해야 한다.
직무와 부서번호만 출력
→job,deptno를 가져오라는 뜻이다.
중복행은 한 행만 출력
→ 똑같은 결과가 여러 번 나오더라도 한 번만 남기라는 뜻이다.
여기서 중요한 건
job만 중복 제거하는 게 아니라,
job과deptno를 같이 본 결과 전체에서 중복된 행을 한 번만 남기는 것이다.
즉, 이 문제는
1. 먼저job,deptno를 조회하고
2. 그다음중복행이라는 말을 보고DISTINCT를 붙여야 한다
이렇게 읽으면 된다.
정답 코드select distinct job, deptno from emp;
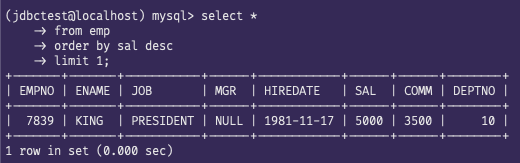
4. 급여를 제일 많이 받는 직원 정보를 출력하는 명령을 작성하시오.이 문제는 조건 문제처럼 보여도 사실은 정렬 문제다.
급여를 제일 많이 받는
→ 급여가 가장 큰 사람을 찾으라는 뜻이다.
이런 문제는 보통 이렇게 생각하면 된다.
1. 급여가 높은 순으로 정렬한다
2. 맨 위 한 행만 남긴다
즉, 이 문제는 정렬 + limit 문제다.
문장에서제일,가장,최상위같은 표현이 보이면ORDER BY ... DESC뒤에LIMIT 1까지 같이 떠올리면 된다.
정답 코드select * from emp order by sal desc limit 1;
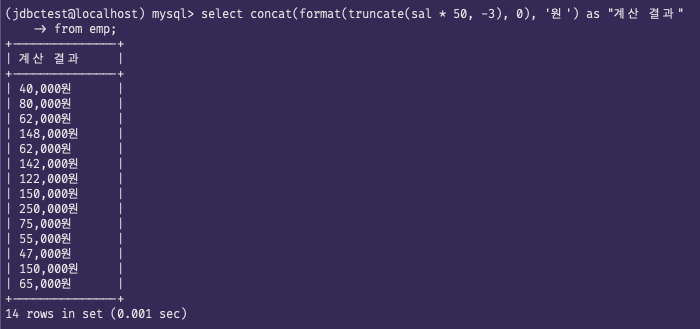
5. 월급에 50를 곱하고 백단위는 절삭하여 출력하는데 월급뒤에 '원'을 붙이고 천단위마다 ','를 붙여서 출력한다.이 문제는 문장을 끊어 읽는 연습이 딱 필요하다.
월급에 50를 곱하고
→ 먼저 계산
백단위는 절삭하여 출력
→ 버림 처리
월급뒤에 '원'을 붙이고
→ 문자열 붙이기
천단위마다 ','를 붙여서 출력
→ 숫자 형식 정리
즉, 이 문제는 한 함수 문제가 아니라
계산 + 절삭 + 숫자 형식 + 문자열 붙이기
가 한꺼번에 들어간 문제다.
이런 문제를 보면 함수 하나만 떠올릴 게 아니라,
“아, 이건 순서대로 처리해야 하는구나”
이걸 먼저 생각해야 한다.
실제로는
1.sal * 50으로 계산하고
2.TRUNCATE()로 절삭하고
3.FORMAT()으로 쉼표를 붙이고
4.CONCAT()으로원을 붙이면 된다
정답 코드select concat(format(truncate(sal * 50, -3), 0), '원') as "계산 결과" from emp;
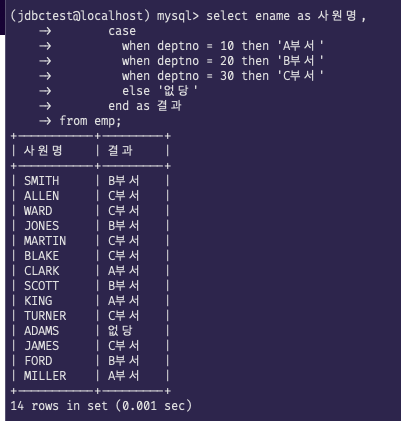
6. 직원 이름과 부서번호 그리고 부서번호에 따른 부서명을 출력하시오. 부서가 없는 직원은 '없당' 을 출력하시오. (부서명 : 10 이면 'A 부서', 20 이면 'B 부서', 30 이면 'C 부서')이 문제는 문장을 세 부분으로 나눠야 한다.
직원 이름과 부서번호
→ 기본 조회 컬럼이 있다.
부서번호에 따른 부서명을 출력
→ 값에 따라 다른 결과를 보여 줘야 한다.
부서가 없는 직원은 '없당' 을 출력
→ 경우가 하나 더 추가된다.
즉, 이 문제는 단순 조회가 아니라
하나의 값에 따라 결과를 여러 갈래로 나누는 문제다.
이럴 때는IF()처럼 두 갈래로 나누는 함수보다
CASE를 먼저 떠올리는 게 자연스럽다.
왜냐하면 경우가
- 10
- 20
- 30
- 그 외
이렇게 여러 개이기 때문이다.
정답 코드select ename as 사원명, case when deptno = 10 then 'A부서' when deptno = 20 then 'B부서' when deptno = 30 then 'C부서' else '없당' end as 결과 from emp;
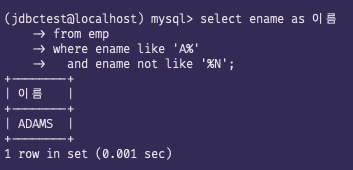
7. 사원테이블에서 이름의 첫글자가 A이고 마지막 글자가 N이 아닌 사원의 이름을 출력하시오.이 문제는 한 번에 보면 헷갈리기 쉬운데, 두 조각으로 나누면 쉽다.
이름의 첫글자가 A
→A로 시작해야 한다.
마지막 글자가 N이 아닌
→N으로 끝나는 것은 제외해야 한다.
즉, 이 문제는
- 문자열 패턴 조건 하나
- 제외 조건 하나
이 두 개가 같이 들어 있는 문제다.
그래서 이렇게 읽으면 된다.
1.A%로 시작 조건 만들기
2.%N끝 조건은NOT으로 제외하기
3. 둘 다 만족해야 하므로AND로 묶기
즉, 이 문제는LIKE + AND + NOT조합 문제다.
정답 코드select ename as 이름 from emp where ename like 'A%' and ename not like '%N';
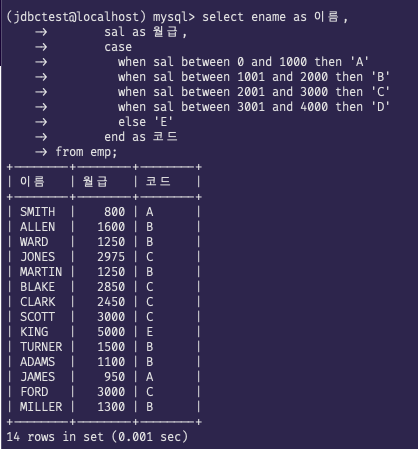
8. 다음과 같이 급여가 0~1000이면 'A', 1001~2000이면 'B', 2001~3000이면 'C', 3001~4000이면 'D', 4001이상이면 'E'를 '코드'라는 열에 출력한다.이 문제는 문장 길이가 길지만 핵심은 하나다.
~이면 A, ~이면 B, ~이면 C ...
→ 값을 구간별로 나눠서 다른 결과를 붙이라는 뜻이다.
즉, 이 문제는 조회 문제가 아니라
구간별 분기 문제다.
이런 문제를 보면 바로CASE를 떠올리면 된다.
왜냐하면 결과가 두 개가 아니라
여러 단계로 나뉘기 때문이다.
또 여기서 중요한 건
이건WHERE처럼 행을 거르는 문제가 아니라,
각 행을 보면서 코드 값을 붙이는 문제라는 점이다.
정답 코드select ename as 이름, sal as 월급, case when sal between 0 and 1000 then 'A' when sal between 1001 and 2000 then 'B' when sal between 2001 and 3000 then 'C' when sal between 3001 and 4000 then 'D' else 'E' end as 코드 from emp;
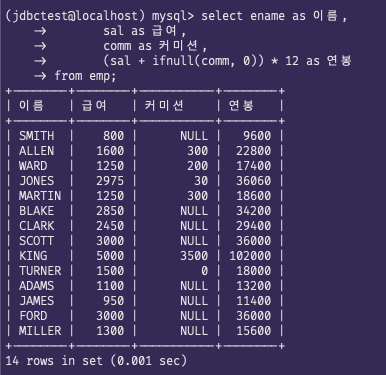
9. 직원의 이름, 급여, 커미션, 연봉을 조회하는 질의를 작성하시오. (단, 직원의 연봉은 (급여+커미션)*12 로 계산하는데 커미션이 정해지지 않은 직원은 0으로 계산한다.)이 문제는 계산식만 보면 쉬워 보이는데, 사실 핵심은 마지막 문장이다.
이름, 급여, 커미션, 연봉을 조회
→ 조회 컬럼이 있다.
연봉은 (급여+커미션)*12
→ 계산식이 있다.
커미션이 정해지지 않은 직원은 0으로 계산
→ 여기서NULL처리를 해야 한다.
즉, 이 문제는
조회 + 계산 + NULL 처리
문제다.
이런 문제를 보면
그냥(sal + comm) * 12를 쓰면 되는 게 아니라,
먼저comm이NULL이면0으로 바꿔야 한다는 걸 읽어야 한다.
그래서 이 문제는IFNULL()을 같이 떠올려야 한다.
정답 코드select ename as 이름, sal as 급여, comm as 커미션, (sal + ifnull(comm, 0)) * 12 as 연봉 from emp;
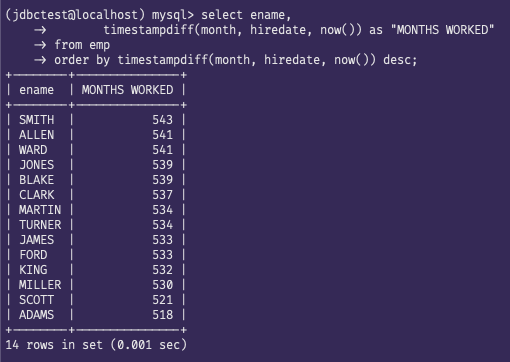
10. 모든 직원의 이름과 현재까지의 입사기간을 월단위로 조회하는 SQL 명령을 작성하시오. (이때, 입사기간에 해당하는 열별칭은 “MONTHS WORKED”로 하고, 입사기간이 가장 큰 직원순(입사한지 오래된 순)으로 정렬한다.)이 문제는 문장이 길어서 끊어 읽는 게 중요하다.
모든 직원의 이름
→ename조회
현재까지의 입사기간을 월단위로 조회
→ 입사일과 현재 날짜 차이를 월 단위로 계산해야 한다
열별칭은 MONTHS WORKED
→ 계산 결과에 별칭을 붙여야 한다
입사기간이 가장 큰 직원순
→ 계산 결과를 기준으로 정렬해야 한다
즉, 이 문제는
날짜 차이 계산 + 별칭 + 정렬
문제다.
여기서 중요한 건 계산만 하고 끝내면 안 된다는 점이다.
마지막에가장 큰 직원순까지 있으므로 정렬도 같이 들어가야 한다.
정답 코드select ename, timestampdiff(month, hiredate, now()) as "MONTHS WORKED" from emp order by timestampdiff(month, hiredate, now()) desc;
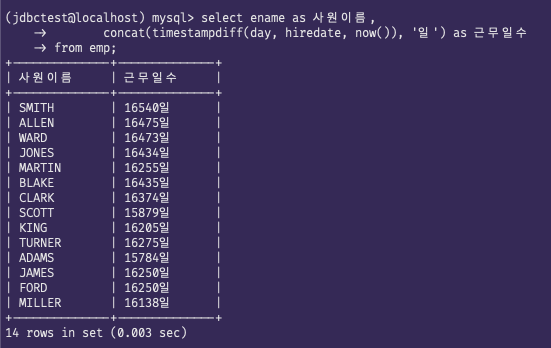
11. 사원테이블에서 사원이름과 사원들의 오늘 날짜까지의 근무일수를 구하는 SQL 명령을 작성하시오.
사원이름
→ename조회
오늘 날짜까지의 근무일수
→ 입사일부터 오늘까지의 차이를 일(day) 단위로 계산해야 한다
즉, 이 문제는 날짜 차이 계산 문제지만,
개월이 아니라 일수를 구해야 한다는 점이 핵심이다.
또 예상 결과를 보면16540일처럼일까지 붙어 있다.
그래서 계산만 하고 끝나는 게 아니라,
마지막에 문자열까지 붙여서 출력하는 흐름도 같이 읽어야 한다.
정답 코드select ename as 사원이름, concat(timestampdiff(day, hiredate, now()), '일') as 근무일수 from emp;