1. 서브쿼리로 조건에 필요한 값을 먼저 구하기
개념
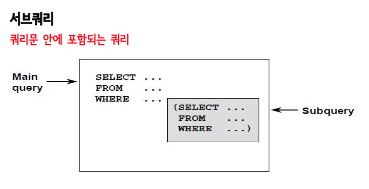
서브쿼리는 쿼리문 안에 들어가는 또 다른 쿼리다.
조건에 바로 쓸 수 없는 값을 먼저 조회해서, 그 결과를 바깥쪽 쿼리의 조건으로 사용하는 방식이라고 보면 된다.
즉,서브쿼리의 핵심은 문법보다 먼저 문제를 두 단계로 나눠서 보는 것이다.
예를 들어 바로 찾고 싶은 데이터가 있어도,
그 전에 먼저 알아내야 하는 값이 있을 수 있다.
그럴 때
1. 안쪽 쿼리에서 필요한 값을 먼저 구하고
2. 바깥쪽 쿼리에서 그 값을 조건으로 사용한다.
이 흐름으로 이해하면 된다.
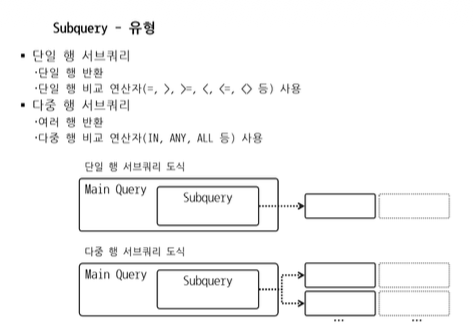
가장 먼저 구분할 것: 단일 행 서브쿼리 / 다중 행 서브쿼리
서브쿼리를 볼 때 제일 먼저 해야 하는 구분은 이것이다.
안쪽 쿼리 결과가 값 하나인가, 값 목록인가?
1) 단일 행 서브쿼리안쪽 쿼리 결과가 값 하나로 나오는 경우다.
이때는=,>,<,>=,<=,<>같은 일반 비교 연산자를 사용할 수 있다.
예를 들어 한 직원의 부서번호 하나, 전체 평균 급여 하나처럼
결과가 딱 하나로 정해지는 경우가 여기에 해당한다.
2) 다중 행 서브쿼리안쪽 쿼리 결과가 값 여러 개, 즉 값 목록으로 나오는 경우다.
이때는=하나로 비교하면 맞지 않고,IN,ANY,ALL같은 다중 행 비교 방식을 사용해야 한다.단일 행에서는 일반 비교 연산자를 쓰고,다중 행에서는IN,ANY,ALL등을 쓴다는 구분이 중요하다.
처음에는 아래 기준만 먼저 잡아도 충분하다.
- 결과가
하나면=를 먼저 떠올린다.- 결과가
여러 개면IN을 먼저 떠올린다.
ANY,ALL은 그다음에 붙는 비교 방식이라고 보면 된다.
기본 문법 모양가장 기본적인 모양은 아래처럼 생긴다.
select 컬럼명
from 테이블명
where 컬럼명 = (
    select 컬럼명
    from 테이블명
    where 조건
);
여기서 중요한 점은 세 가지다.
- 안쪽 쿼리는 보통 괄호
()안에 들어간다.- 안쪽 쿼리가 먼저 실행되어 값을 구한다.
- 바깥쪽 쿼리는 그 값을 조건으로 사용한다.
즉, 읽는 순서는
안쪽 쿼리 → 결과 확인 → 바깥쪽 쿼리 적용
이 순서로 보면 된다.
문제 해석할 때 먼저 볼 기준
서브쿼리문제를 볼 때는 아래 세 가지를 먼저 확인하면 된다.
1. 최종적으로 무엇을 구하려는가
2. 그 전에 먼저 알아내야 하는 값이 무엇인가
3. 그 값이 하나인가, 여러 개인가이 세 가지만 먼저 잡히면
왜=를 쓰는지, 왜IN을 쓰는지, 왜ANY,ALL이 나오는지가 훨씬 쉽게 보인다.
예제:
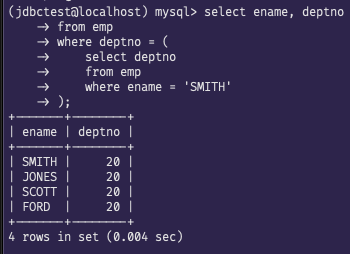
SMITH와 같은 부서에서 일하는 직원 찾기select ename, deptno from emp where deptno = ( select deptno from emp where ename = 'SMITH' );
문제 해석이 문제에서 최종적으로 보고 싶은 것은
SMITH와 같은 부서에 있는 직원들이다.
그런데 바로 조건을 쓸 수는 없다.
우리는 아직SMITH의 부서번호를 모르기 때문이다.
그래서 이 문제는 두 단계로 나눠서 봐야 한다.
1. 먼저SMITH의 부서번호를 구한다.
2. 그 부서번호와 같은 직원을 다시 찾는다.
이 두 단계를 한 문장 안에 넣은 것이서브쿼리다.
SMITH와 같은 부서 직원을 찾으려면 먼저SMITH가 근무하는 부서번호를 알아내야 한다는 식으로 해석하면 된다.
코드 흐름
- 안쪽 쿼리
→ename = 'SMITH'인 행을 찾는다.
→ 그 행의deptno를 꺼낸다.
- 바깥쪽 쿼리
→emp테이블에서
→ 방금 구한deptno와 같은 행을 찾는다.
여기서 봐야 할 포인트이 예제에서는 안쪽 결과가
SMITH의 부서번호 하나라고 보기 때문에
=를 사용할 수 있다.
즉, 이 예제는 단일 행 서브쿼리의 가장 기본적인 형태다.
예제:
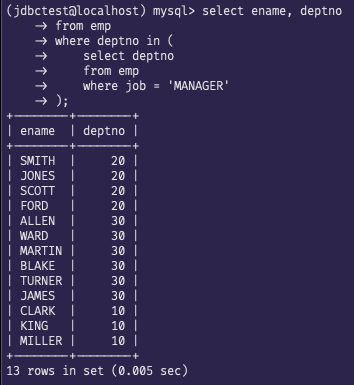
MANAGER가 있는 부서의 직원 찾기select ename, deptno from emp where deptno in ( select deptno from emp where job = 'MANAGER' );
문제 해석이번에는 최종적으로
MANAGER가 있는 부서에서 일하는 직원들을 찾으려는 문제다.
여기서 먼저 알아내야 하는 값은
MANAGER가 속한 부서번호들이다.
즉, 이 문제는 이렇게 나눌 수 있다.
1. 먼저MANAGER들의 부서번호를 구한다.
2. 그 부서번호들 중 하나에 속한 직원을 찾는다.이번에는 기준이 하나가 아니라 여러 개일 수 있다.
그래서 결과도 값 하나가 아니라 값 목록이 된다.
코드 흐름
- 안쪽 쿼리
→job = 'MANAGER'인 행들의deptno를 구한다.
- 바깥쪽 쿼리
→ 그 부서번호 목록 안에 포함되는 직원을 찾는다.
여기서 봐야 할 포인트안쪽 결과가 여러 개이므로
=가 아니라IN을 사용한다.
즉, 이 예제는
다중 행 서브쿼리에서는 왜IN이 필요한지를 보여주는 가장 기본적인 예제다.
예제:
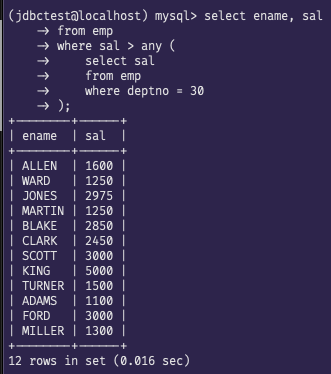
부서 30직원들의 급여와 비교하기select ename, sal from emp where sal > any ( select sal from emp where deptno = 30 );
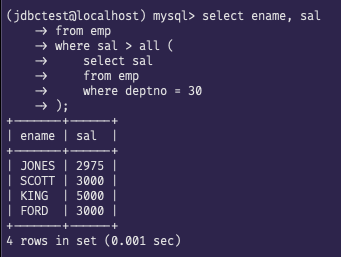
select ename, sal
from emp
where sal > all (
    select sal
    from emp
    where deptno = 30
);
문제 해석이번에는 안쪽 쿼리에서 구하는 값이 부서번호가 아니라
부서 30 직원들의 급여 목록이다.
즉, 먼저 해야 할 일은 이것이다.
1.부서 30직원들의 급여들을 구한다.
2. 그 급여들과 비교해서 조건에 맞는 직원을 찾는다.여기서 중요한 점은 급여가 한 개가 아니라 여러 개 나온다는 것이다.
그래서ANY,ALL같은 다중 행 비교 방식이 등장한다.ANY는 여러 결과 중 하나만 만족해도 되고,ALL은 여러 결과를 모두 만족해야 한다. 또= ANY(서브쿼리)는IN(서브쿼리)와 같은 뜻으로 볼 수 있다.
코드 흐름
- 안쪽 쿼리
→deptno = 30인 직원들의sal값을 전부 구한다.
- 바깥쪽 쿼리
→ 각 직원의sal을 그 급여 목록과 비교한다.
ANY는 어떻게 읽으면 되는가
sal > ANY(급여목록)은
그 급여들 중 하나보다만 커도 된다는 뜻이다.
쉽게 말하면
목록 안의 값들 중 하나만 이기면 된다는 뜻이다.
조금 더 쉽게 보면
가장 작은 값보다 크면 되는 느낌으로 이해하면 된다.
즉, 기준이 비교적 느슨하다.
ALL은 어떻게 읽으면 되는가
sal > ALL(급여목록)은
그 급여들을 모두 이겨야 한다는 뜻이다.
쉽게 말하면
목록 안의 값들을 전부 다 넘어서야 한다는 뜻이다.
조금 더 쉽게 보면
가장 큰 값보다도 커야 하는 느낌으로 이해하면 된다.
즉, 기준이 훨씬 엄격하다.
여기서 봐야 할 포인트이 예제는
ANY와ALL의 차이를 가장 분명하게 보여준다.
ANY
→ 여러 값 중 하나만 만족하면 됨
ALL
→ 여러 값을 모두 만족해야 함
초보자 입장에서는 이렇게 기억하면 된다.
ANY는 여러 개 중 하나만 넘으면 되고,ALL은 전부 다 넘어야 한다.
IN,ANY,ALL을 짧게 정리하면다중 행 서브쿼리에서 자주 보는 비교 방식은 아래처럼 정리할 수 있다.
IN
→ 여러 값 중 하나와 같으면 된다
= ANY
→IN과 같은 뜻으로 볼 수 있다
> ANY,< ANY
→ 여러 값 중 하나만 만족하면 된다
> ALL,< ALL
→ 여러 값을 모두 만족해야 한다여기서 차이는 이렇다.
IN은 여러 값 중 하나와 같은지를 보는 방식이고,
ANY,ALL은 여러 값과 비교하는 방식이다.
즉,IN은 목록 포함 여부,
ANY,ALL은 여러 값과의 비교 방식이라고 보면 된다.
헷갈리기 쉬운 부분첫째,
서브쿼리는 문법보다 먼저 문제 해석이 중요하다.
바로 쿼리를 읽으려고 하지 말고,
먼저 알아내야 하는 값이 무엇인지부터 찾아야 한다.
둘째, 안쪽 쿼리 결과가 하나인지 여러 개인지 꼭 확인해야 한다.
- 하나면
=를 먼저 떠올린다- 여러 개면
IN,ANY,ALL을 떠올린다
셋째, 안쪽 쿼리 결과가 여러 개인데
=를 쓰면 맞지 않는다.
그래서서브쿼리를 볼 때는 결과가 값 하나인지 값 목록인지부터 먼저 확인하는 습관이 중요하다.
넷째, 읽는 순서는
안쪽 쿼리 → 결과 확인 → 바깥쪽 쿼리 적용
이 순서다.
다섯째,= ANY(서브쿼리)는IN(서브쿼리)와 같은 뜻으로 볼 수 있다.
그래서 처음에는IN을 먼저 확실히 잡고,
그다음에ANY,ALL로 넓혀 가는 것이 이해하기 쉽다.
짧게 흐름으로 다시 보기
서브쿼리
→ 바로 조건을 만들 수 없는 문제를 만난다
→ 먼저 알아내야 하는 값을 찾는다
→ 안쪽 쿼리로 그 값을 구한다
→ 바깥쪽 쿼리에서 그 값을 조건으로 사용한다
즉,서브쿼리의 핵심은
문법 자체보다 문제를 두 단계로 나눠서 보는 해석에 있다.
서브쿼리 실습 문제
문제 해석은 이렇게 한다
서브쿼리문제는 보통 한 번에 풀리지 않는다.
문장을 읽다가 바로 조건을 쓸 수 없고, 먼저 알아내야 하는 값이 하나 더 있는 경우가 많다.
그래서서브쿼리문제는 항상 이렇게 읽으면 된다.
1. 최종적으로 무엇을 구하려는지 본다
2. 그 전에 먼저 알아내야 하는 값이 뭔지 찾는다
3. 그 값이 하나인지, 여러 개인지 본다
4. 하나면=, 여러 개면IN,ANY,ALL쪽을 떠올린다즉,
서브쿼리문제는
최종 목표를 먼저 보고 → 중간에 필요한 값을 찾는 연습이라고 생각하면 된다.
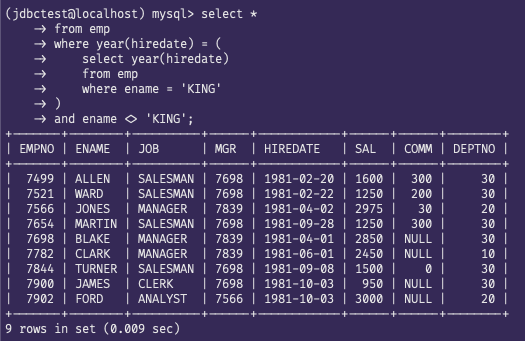
1. 'KING' 과 같은 해에 입사한 직원들의 모든 정보를 출력한다. (단, 'KING'의 정보는 제외한다.)이 문제는 먼저 최종 목표부터 보면 된다.
같은 해에 입사한 직원들의 모든 정보
→ 최종적으로 구하고 싶은 것은KING과 같은 해에 입사한 직원들이다.
그런데 여기서 바로 조건을 쓸 수는 없다.
우리는 아직KING이 몇 년에 입사했는지 모르기 때문이다.
즉, 이 문제는 두 단계다.
- 먼저
KING의 입사 연도를 구한다.- 그 연도와 같은 해에 입사한 직원들을 찾는다.
- 마지막에
KING본인은 제외한다.여기서 안쪽 쿼리 결과는
KING의 입사 연도 하나다.
그래서 단일 값으로 비교하는 흐름으로 보면 된다.
정답 코드select * from emp where year(hiredate) = ( select year(hiredate) from emp where ename = 'KING' ) and ename <> 'KING';
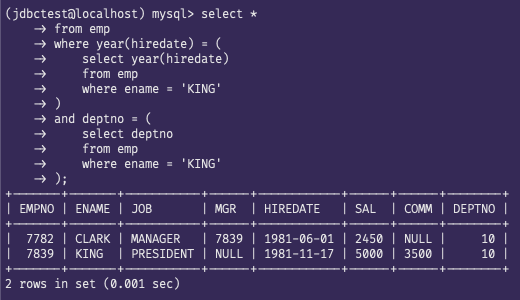
2. 'KING' 과 같은 해에 입사하고 같은 부서에서 일하는 직원들의 모든 정보를 출력한다. (단, 'KING'의 정보도 포함하여 출력한다.)이 문제는 1번보다 한 단계 더 붙는다.
같은 해에 입사하고
→ 입사 연도를 맞춰야 한다.
같은 부서에서 일하는
→ 부서번호도 맞춰야 한다.
즉, 이 문제는KING기준으로 연도 하나, 부서번호 하나를 먼저 알아내야 한다.
그리고 바깥쪽에서 그 두 조건을 동시에 만족하는 직원을 찾으면 된다.
이 문제를 보면
“아,KING에 대한 기준값이 두 개 필요하구나”
이렇게 먼저 읽으면 된다.
둘 다 값 하나씩이므로 일반 비교로 풀 수 있다.
정답 코드select * from emp where year(hiredate) = ( select year(hiredate) from emp where ename = 'KING' ) and deptno = ( select deptno from emp where ename = 'KING' );
3. 'BLAKE'와 같은 부서에 있는 직원들의 이름과 입사일을 뽑는데 'BLAKE'는 빼고 출력하는 SQL 명령을 작성하시오.이 문제는 비교적 전형적인
단일 행 서브쿼리문제다.
'BLAKE'와 같은 부서에 있는 직원들
→ 먼저BLAKE의 부서번호를 알아내야 한다.
이름과 입사일을 뽑는데
→ 최종 출력 컬럼은ename,hiredate다.
'BLAKE'는 빼고 출력
→ 마지막에 본인은 제외해야 한다.
즉, 이 문제는
1.BLAKE의deptno를 먼저 구하고
2. 그 부서번호와 같은 직원을 찾고
3.BLAKE만 빼는 문제다.안쪽 결과가 부서번호 하나니까
=비교를 떠올리면 된다.
정답 코드select ename, hiredate from emp where deptno = ( select deptno from emp where ename = 'BLAKE' ) and ename <> 'BLAKE';
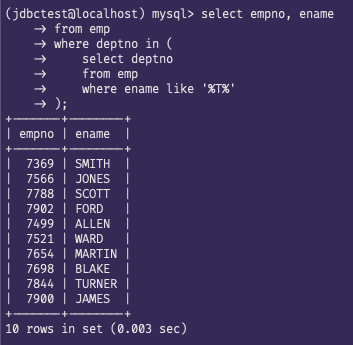
4. 이름에 'T'를 포함하고 있는 직원들과 같은 부서에서 근무하고 있는 직원의 직원번호와 이름을 출력하는 SQL 명령을 작성하시오.(출력 순서 무관)이 문제는 읽는 게 중요하다.
이름에 'T'를 포함하고 있는 직원들
→ 먼저LIKE '%T%'조건에 맞는 직원들을 찾는다.
같은 부서에서 근무하고 있는 직원
→ 그 직원들이 속한 부서번호들을 기준으로 다시 직원을 찾아야 한다.
즉, 여기서는 먼저 알아내야 하는 값이 부서번호 하나가 아니라 여러 개일 수 있다.
왜냐하면 이름에T가 들어간 직원이 여러 명일 수 있고, 그들이 여러 부서에 흩어져 있을 수 있기 때문이다.
그래서 이 문제는
1. 이름에T가 들어간 직원들의deptno를 구하고
2. 그 부서번호들 중 하나에 속한 직원을 찾는 구조다.이럴 때는 값 하나가 아니라 값 목록이 나오므로
IN을 떠올리면 된다.
정답 코드select empno, ename from emp where deptno in ( select deptno from emp where ename like '%T%' );
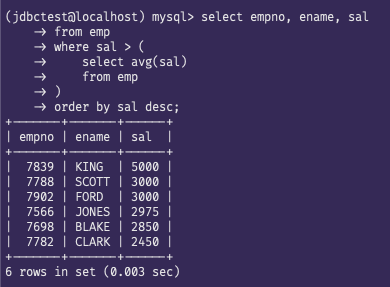
5. 평균급여보다 많은 급여를 받는 직원들의 직원번호, 이름, 월급을 출력하되, 월급이 높은 사람 순으로 출력한다.이 문제는
서브쿼리문제 중에서 제일 대표적인 형태다.
평균급여보다 많은 급여
→ 먼저 전체 평균 급여를 구해야 한다.
직원번호, 이름, 월급을 출력
→ 최종 조회 컬럼은empno,ename,sal이다.
월급이 높은 사람 순
→ 마지막에ORDER BY까지 들어가야 한다.
즉, 이 문제는
1. 평균 급여 하나를 먼저 구하고
2. 그 값보다 급여가 큰 직원을 찾고
3. 급여 내림차순으로 정렬하는 문제다.여기서 안쪽 쿼리 결과는 평균 급여 하나다.
그래서 일반 비교 연산자인>를 쓰면 된다.
정답 코드select empno, ename, sal from emp where sal > ( select avg(sal) from emp ) order by sal desc;
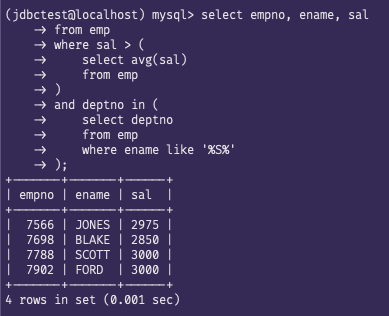
6 급여가 평균급여보다 많고,이름에 S자가 들어가는 직원과 동일한 부서에서 근무하는 모든 직원의 직원번호,이름 및 급여를 출력하는 SQL 명령을 작성하시오.(출력 순서 무관)이 문제는 조건이 두 겹이다.
급여가 평균급여보다 많고
→ 먼저 평균 급여를 구해야 한다.
이름에 S자가 들어가는 직원과 동일한 부서에서 근무하는
→ 또 한 번, 이름에S가 들어가는 직원들의 부서번호들을 알아내야 한다.
즉, 이 문제는
- 평균 급여 하나
- 부서번호 목록 여러 개
이 두 기준을 동시에 써야 한다.
그래서 이렇게 읽으면 된다.
1. 평균 급여보다 큰 직원이어야 한다
2. 동시에, 이름에S가 들어가는 직원이 속한 부서 중 하나에 속해야 한다즉, 이 문제는
단일 행 서브쿼리 하나 + 다중 행 서브쿼리 하나
가 같이 들어간 문제다.
정답 코드select empno, ename, sal from emp where sal > ( select avg(sal) from emp ) and deptno in ( select deptno from emp where ename like '%S%' );
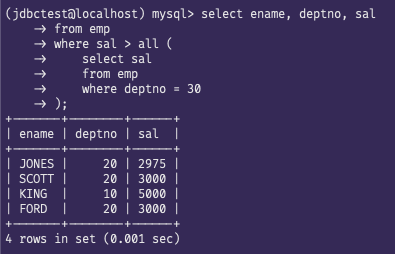
7. 30번 부서에 있는 직원들 중에서 가장 많은 월급을 받는 직원보다 많은 월급을 받는 직원들의 이름, 부서번호, 월급을 출력하는 SQL 명령을 작성하시오. (단, ALL 또는 ANY 연산자를 사용할 것)이 문제는
ANY,ALL연습용이다.
30번 부서에 있는 직원들 중에서 가장 많은 월급을 받는 직원보다 많은 월급
→ 먼저 30번 부서 직원들의 급여 목록을 구해야 한다.
그런데 문제에서 요구하는 건 결국
그 목록의 최대값보다 큰 급여다.
이 문제는 이렇게 읽으면 된다.
1. 30번 부서 직원들의 급여들을 먼저 구한다
2. 그 급여들보다 더 큰 사람을 찾는다여기서 안쪽 결과는 급여 여러 개다.
그래서>하나로는 안 되고,ALL이나ANY를 써야 한다.
특히 이 문제는
가장 많은 월급보다 많은
이라고 했으니까 30번 부서 급여 전부보다 커야 한다는 뜻이다.
즉,> ALL이 맞다.
정답 코드select ename, deptno, sal from emp where sal > all ( select sal from emp where deptno = 30 );
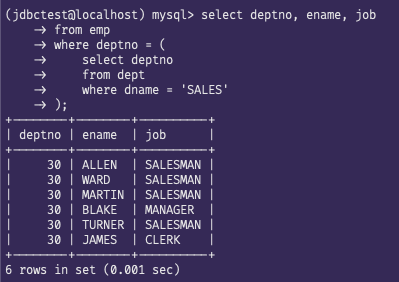
8. SALES 부서에서 일하는 직원들의 부서번호, 이름, 직업을 출력하는 SQL 명령을 작성하시오.이 문제는 먼저
SALES가 뭔지 읽어야 한다.
SALES 부서
→ 여기서 바로deptno = 30이라고 쓰는 게 아니라, 먼저dept테이블에서SALES의 부서번호를 찾아야 한다.
즉, 이 문제는
1.dept테이블에서SALES의deptno를 구하고
2. 그 부서번호와 같은emp행들을 찾는 구조다이 문제의 핵심은
문자열 부서명은dept에 있고, 직원 정보는emp에 있다는 걸 읽어내는 것이다.
그래서 안쪽에서 부서번호를 먼저 구해야 한다.
정답 코드select deptno, ename, job from emp where deptno = ( select deptno from dept where dname = 'SALES' );
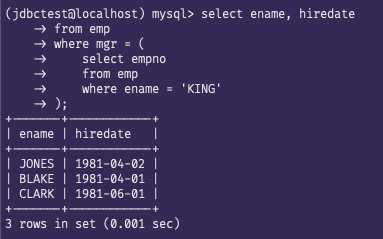
9. 'KING'에게 보고하는 모든 직원의 이름과 입사날짜를 출력하는 SQL 명령을 작성하시오. (KING에게 보고하는 직원이란 mgr이 KING의 사번인 직원을 의미함)이 문제는 설명문이 이미 힌트다.
KING에게 보고하는 직원
→ 뜻이 바로 뒤에 나온다.
mgr이 KING의 사번인 직원
즉, 먼저 해야 할 일은
1.KING의 사번을 구하는 것
2. 그 사번과mgr이 같은 직원을 찾는 것
이다.
이 문제를 풀 때는
“보고한다”를 추상적으로 생각하지 말고,
문제 안에 써 준 설명 그대로 읽으면 된다.
KING의empno를 먼저 구하고mgr = 그 empno인 직원을 찾는다이렇게 보면 된다.
정답 코드select ename, hiredate from emp where mgr = ( select empno from emp where ename = 'KING' );
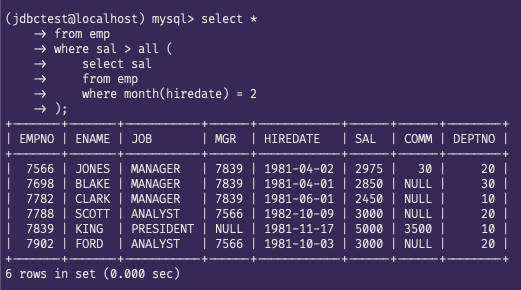
10. 2월에 입사한 직원들이 받는 최대 급여보다 많은 급여를 받는 직원들의 모든 정보를 출력한다. (문제해결시 집계함수를 사용하지 않고 해결한다.)이 문제는 문장을 꼭 나눠 읽어야 한다.
2월에 입사한 직원들
→ 먼저 2월 입사자들을 골라야 한다.
그들이 받는 최대 급여보다 많은 급여
→ 그 사람들의 급여 목록 중 가장 큰 값보다 커야 한다.
그런데 뒤에서
집계함수를 사용하지 않고 해결
→MAX()를 쓰지 말라는 뜻이다.
즉, 이 문제는
보통이라면MAX()를 떠올리기 쉬운데, 문제에서 그걸 막아 둔 것이다.
그래서 여기서는ALL을 떠올리면 된다.
왜냐하면
2월 입사자들의 급여 전부보다 커야 한다
는 말은 결국
> ALL(급여목록)과 같은 뜻이기 때문이다.
정답 코드select * from emp where sal > all ( select sal from emp where month(hiredate) = 2 );
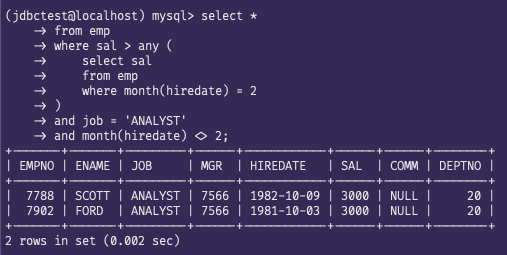
11. 2월에 입사한 직원들이 받는 최소 급여보다 많은 급여를 받는 직원들중에서 직무가 ANALYST 인 직원들의 모든 정보를 출력한다. (문제해결시 집계함수를 사용하지 않고 해결하며 2월 입사 직원은 제외한다.)이 문제는 10번보다 한 단계 더 많다.
2월에 입사한 직원들이 받는 최소 급여보다 많은 급여
→ 2월 입사자 급여 목록 중 가장 작은 값보다 커야 한다
직무가 ANALYST 인 직원들
→job = 'ANALYST'조건이 추가된다
2월 입사 직원은 제외
→ 마지막에 2월 입사자는 빼야 한다
여기서도MIN()을 쓰지 말라고 했으니
ANY를 떠올리면 된다.
왜냐하면
최소 급여보다 크다는 말은 결국
그 급여 목록 중 하나보다만 커도 되는 비교로 읽을 수 있기 때문이다.
즉,> ANY(급여목록)으로 보는 문제다.
정답 코드select * from emp where sal > any ( select sal from emp where month(hiredate) = 2 ) and job = 'ANALYST' and month(hiredate) <> 2;
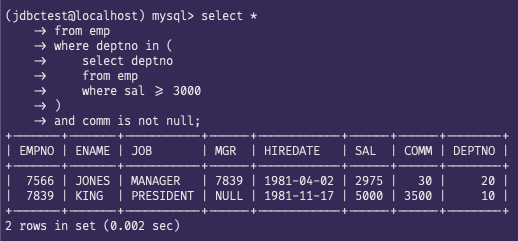
12. 급여가 3000이상인 직원들과 같은 부서에서 근무하며 커미션이 정해져 있는 직원들의 정보를 출력하는 SQL 명령을 작성하시오.이 문제도 두 부분으로 잘라 읽으면 된다.
급여가 3000이상인 직원들과 같은 부서에서 근무하며
→ 먼저 급여가 3000 이상인 직원들의 부서번호들을 알아내야 한다
커미션이 정해져 있는 직원들
→comm이NULL이 아닌 직원만 남겨야 한다
즉, 이 문제는
1. 급여 3000 이상 직원들의 부서번호 목록을 구하고
2. 그 부서 중 하나에 속하면서
3. 커미션이 있는 직원만 찾는 문제다여기서 안쪽 결과는 부서번호 여러 개일 수 있으므로
IN을 떠올리면 된다.
그리고 바깥쪽 조건으로comm is not null까지 같이 붙여야 한다.
정답 코드select * from emp where deptno in ( select deptno from emp where sal >= 3000 ) and comm is not null;
2. 데이터 그룹화와 집계 (GROUP BY & HAVING & 집계함수 & WITH ROLLUP)
개념앞에서는
SELECT,WHERE,ORDER BY로 행 하나하나를 보는 조회를 했다.
그런데 실제로는 행을 하나씩 보는 것만으로는 부족할 때가 많다.
예를 들어 이런 경우가 있다.
- 직원 전체 평균 급여를 보고 싶을 때
- 부서별 인원 수를 보고 싶을 때
- 직무별 평균 급여를 비교하고 싶을 때
이럴 때 필요한 것이 집계와 그룹화다.
집계는 여러 행을 모아서 하나의 계산 결과를 만드는 것이고,그룹화는 같은 값을 가진 행끼리 묶어서 따로 계산하는 것이다.GROUP BY는 지정한 컬럼 기준으로 행을 그룹으로 묶는 역할을 하고, 집계 함수와 함께 사용된다.HAVING은 집계 결과에 조건을 거는 역할이다.ROLLUP은 소계와 총계를 만들 때 사용한다.즉, 이 파트의 핵심은 이것이다.
여러 행을 그냥 나열해서 보는 것이 아니라, 묶고 계산해서 의미 있는 결과로 바꾸어 보는 것
집계 함수부터 먼저 이해하기
집계 함수는 여러 행의 값을 모아서 하나의 결과로 계산하는 함수다.
GROUP BY를 배우기 전에 먼저 이 감각부터 잡아야 한다.
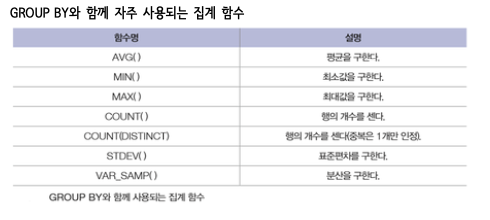
대표적으로 자주 보는 집계 함수는 아래와 같다.
COUNT(): 행 개수 세기SUM(): 합계 구하기AVG(): 평균 구하기MAX(): 최댓값 구하기MIN(): 최솟값 구하기
COUNT(*)는 특정 컬럼 값 하나를 보는 것이 아니라, 행 개수 자체를 세는 방식이라고 보면 된다.
그래서 나중에 GROUP BY와 함께 쓰면 각 그룹에 몇 행이 들어 있는지 세는 용도로 자주 사용한다.
이 함수들은 여러 행을 한 번에 계산해서 결과 하나를 만든다.
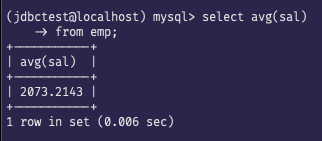
즉, 집계 함수는 “한 줄씩 꺼내 보는 조회”와는 성격이 다르다.예제: 전체 직원의 평균 급여 구하기
select avg(sal)
from emp;
이 쿼리는
emp테이블의 모든 직원 급여를 모아서
평균값 하나를 계산한다.AVG(sal)처럼 집계 함수를 사용하면 여러 행을 계산해서 하나의 결과를 얻을 수 있다.
여기서 중요한 점은
결과가 직원 수만큼 여러 줄 나오는 것이 아니라
평균값 하나만 나온다는 것이다.
즉, 아직은 그룹으로 나눈 것이 아니라
테이블 전체를 한 번에 계산한 상태다.
GROUP BY가 왜 필요한가집계 함수만 쓰면 테이블 전체를 한 번에 계산하게 된다.
그런데 실제로는 전체 평균만 보는 것보다
부서별, 직무별처럼 나눠서 보는 경우가 더 많다.
예를 들어 전체 직원 평균 급여 하나보다직무별 평균 급여를 보면 어떤 직무가 평균적으로 급여가 높은지 더 잘 보인다.
이때 사용하는 것이GROUP BY다.
GROUP BY는 특정 컬럼의 같은 값을 가진 행끼리 묶는다.
그리고 그 묶음마다 집계 함수를 따로 계산하게 만든다.
즉,GROUP BY는 행을 그룹으로 나누는 기준이라고 보면 된다.
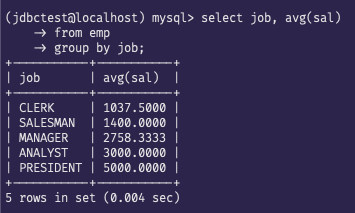
예제: 직무별 평균 급여 구하기
select job, avg(sal)
from emp
group by job;
문제에서 무엇을 보려는지이제는 전체 평균 급여 하나가 아니라
직무마다 평균 급여가 어떻게 다른지 보고 싶은 상황이다.
즉, 이 문제는 이렇게 읽으면 된다.
1. 먼저job이 같은 직원끼리 묶는다.
2. 그 묶음마다avg(sal)을 계산한다.
코드 흐름
GROUP BY job
→ 같은job값을 가진 행끼리 묶는다.
AVG(sal)
→ 각 그룹마다 평균 급여를 계산한다.
여기서 봐야 할 포인트이 쿼리는 직원 한 명씩 보여주는 조회가 아니다.
직무별로 묶은 결과 한 줄씩 보여주는 조회다.
즉,
- 원래 테이블의 행 개수만큼 나오는 것이 아니라
- 그룹 개수만큼 결과가 나온다
이 감각이 중요하다.
GROUP BY에서 꼭 지켜야 하는 규칙
GROUP BY를 사용할 때는SELECT절에 아무 컬럼이나 막 넣을 수 없다.
그룹화 기준으로 사용한 컬럼과 집계 함수만 써야 한다.
예를 들어 아래 쿼리는 의미가 맞지 않는다.select ename, max(sal), min(sal) from emp group by deptno;왜냐하면
deptno기준으로 묶었는데
ename은 그 그룹 안에 여러 개가 있을 수 있기 때문이다.
그래서 어떤 이름을 보여줘야 할지 애매해진다.
즉,GROUP BY를 쓸 때는
묶는 기준 컬럼과
그 그룹에 대해 계산한 집계 함수 결과만 같이 쓴다고 이해하면 된다.GROUP BY를 사용하는 경우에는 그룹핑 기준 컬럼 외 다른 컬럼이 오면 오류가 나거나 무의미한 결과가 되므로, 그룹 기준 컬럼과 집계 함수만 사용해야 한다.
WHERE와 HAVING의 차이처음 배우면
WHERE와HAVING이 가장 많이 헷갈린다.
둘 다 조건을 거는 역할처럼 보이기 때문이다.
하지만 기준이 다르다.
WHERE
→ 그룹으로 묶기 전의 행에 조건을 건다
HAVING
→ 그룹으로 묶은 뒤의 결과에 조건을 건다즉,
WHERE는 원본 행을 줄이는 조건이고,
HAVING은 집계가 끝난 결과를 다시 걸러내는 조건이다.HAVING은WHERE와 비슷하지만 집계 함수에 대해 조건을 제한하는 것이고,GROUP BY다음에 와야 한다.
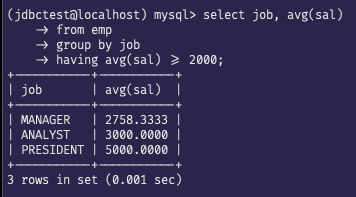
예제: 평균 급여가 높은 직무만 보기
select job, avg(sal)
from emp
group by job
having avg(sal) >= 2000;
문제에서 무엇을 보려는지이번에는 직무별 평균 급여를 다 보는 것이 아니라,
그중에서도 평균 급여가 높은 직무만 남기고 싶다는 뜻이다.
이 문제는 이렇게 읽으면 된다.
1. 먼저job기준으로 묶는다.
2. 각 직무의 평균 급여를 계산한다.
3. 그 평균 급여가2000이상인 그룹만 남긴다.
코드 흐름
GROUP BY job
→ 직무별로 묶는다.
AVG(sal)
→ 각 직무의 평균 급여를 구한다.
HAVING avg(sal) >= 2000
→ 계산이 끝난 평균값을 기준으로 그룹을 걸러낸다.
여기서 봐야 할 포인트이 조건은 원본 행의 급여 하나를 보는 것이 아니라
직무별 평균 급여를 보는 조건이다.
그래서WHERE가 아니라HAVING이 들어간다.
즉,HAVING은
그룹 결과에 조건을 거는 문장이라고 보면 된다.
WHERE는 언제 같이 쓰는가
WHERE와HAVING은 함께 쓸 수 있다.
둘은 비슷해 보여도 거르는 대상이 다르다.
WHERE는 그룹을 만들기 전의 행을 거른다.
HAVING은 그룹을 만든 뒤의 결과를 거른다.
예를 들어 부서번호가 없는 직원은 먼저 제외하고,
그다음 남은 직원들만 직무별, 부서별로 묶은 뒤
인원이 2명 이상인 그룹만 보고 싶을 수 있다.
이때 흐름은 아래처럼 된다.
1.WHERE로 먼저 원본 행을 줄인다.
2.GROUP BY로 묶는다.
3. 집계 함수를 계산한다.
4.HAVING으로 그룹 결과를 다시 줄인다.이 순서를 이해하면
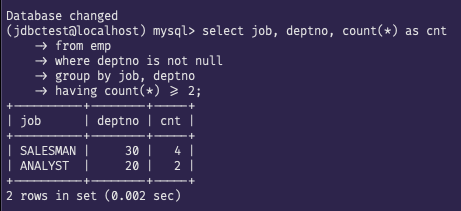
WHERE와HAVING이 덜 헷갈린다.예제: 부서가 정해진 직원만 묶고, 인원이 2명 이상인 그룹만 보기
select job, deptno, count(*) as cnt
from emp
where deptno is not null
group by job, deptno
having count(*) >= 2;
문제에서 무엇을 보려는지이 예제는 직원을 그냥 한 줄씩 보는 것이 아니라
직무별 + 부서별로 묶었을 때 인원이 몇 명인지 보려는 문제다.
그런데 부서번호가 없는 행은 애초에 비교 대상에서 빼고 싶다.
그래서 먼저WHERE deptno is not null로 원본 행을 정리한다.
그다음 남은 행들을job,deptno기준으로 묶고,
각 그룹의 인원 수를count(*)로 센다.
여기서 끝나는 것이 아니라,
그 결과 중에서도 인원이 2명 이상인 그룹만 남기기 위해
HAVING count(*) >= 2를 붙인다.
코드 흐름
WHERE deptno is not null
→ 부서번호가 없는 행을 먼저 제외한다.
GROUP BY job, deptno
→ 직무와 부서번호 조합 기준으로 그룹을 만든다.
COUNT(*)
→ 각 그룹에 몇 명이 있는지 센다.
HAVING count(*) >= 2
→ 그룹을 만든 뒤, 인원이 2명 이상인 그룹만 남긴다.
여기서 봐야 할 포인트
WHERE와HAVING의 차이는 언제 거르느냐에 있다.
WHERE
→ 묶기 전에 행을 거른다.
HAVING
→ 묶은 뒤에 그룹 결과를 거른다.즉, 이 예제는
부서가 없는 직원은 먼저 빼고(WHERE)
묶은 결과 중 인원이 적은 그룹은 나중에 뺀다(HAVING)
라는 흐름을 보여준다.
ROLLUP은 왜 쓰는가보통
GROUP BY를 하면 그룹별 결과만 나온다.
그런데 실제로는
- 그룹별 결과
- 각 단계의 소계
- 전체 총계
까지 같이 보고 싶은 경우가 많다.
이럴 때 사용하는 것이ROLLUP이다.
ROLLUP은GROUP BY결과에 소계와 총계를 추가해 주는 기능이다.
WITH ROLLUP을 붙이면 그룹별 결과만 끝나는 것이 아니라,
마지막에 합계 성격의 행이 더 붙는다.ROLLUP은 총합 또는 중간 합계가 필요할 때 사용하고,GROUP BY와 함께WITH ROLLUP을 붙여 쓴다.예제: 직무별 평균 급여와 전체 평균까지 함께 보기
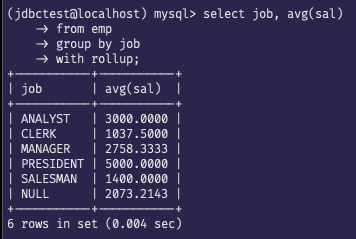
select job, avg(sal)
from emp
group by job
with rollup;
문제에서 무엇을 보려는지이번에는 직무별 평균 급여만 보는 것으로 끝나는 것이 아니라,
직무별 결과와 전체 결과를 같이 보고 싶은 상황이다.
즉, 이 문제는 이렇게 읽으면 된다.
1.job기준으로 묶어서 평균 급여를 구한다.
2. 그 결과에 전체 합계 성격의 행을 하나 더 붙인다.
코드 흐름
GROUP BY job
→ 직무별로 묶는다.
AVG(sal)
→ 각 직무의 평균 급여를 계산한다.
WITH ROLLUP
→ 마지막에 전체 결과를 추가한다.
여기서 봐야 할 포인트
ROLLUP은 원래 데이터를 바꾸는 것이 아니라
집계 결과를 더 넓게 보여주는 기능이다.
즉, 그룹별 결과만 보는 것이 아니라
그 결과를 한 단계 더 요약해서 보여준다고 이해하면 된다.
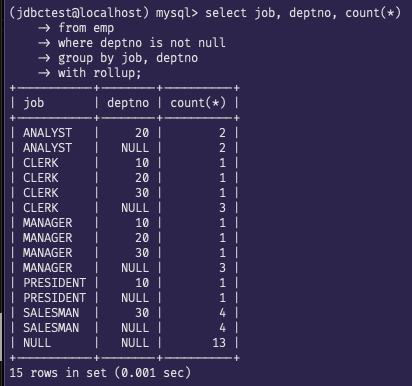
예제: 직무별, 부서별 인원 수와 소계, 총계 함께 보기
select job, deptno, count(*)
from emp
where deptno is not null
group by job, deptno
with rollup;
문제에서 무엇을 보려는지이 문제는 한 단계 더 복잡하다.
직무별·부서별 인원 수도 보고 싶고,
그보다 큰 단위인 직무별 소계, 그리고 전체 총계까지 같이 보고 싶다.
그래서 흐름은 이렇게 된다.
1. 먼저 부서가 있는 행만 남긴다.
2.job,deptno기준으로 묶는다.
3. 각 그룹의 인원 수를 센다.
4.ROLLUP으로 소계와 총계를 붙인다.
여기서 봐야 할 포인트
GROUP BY job, deptno WITH ROLLUP이면
결과가 단순히(job, deptno)수준에서 끝나지 않는다.
ROLLUP은 아래처럼 위로 올라가며 요약된 결과를 만든다.
(job, deptno)(job)전체즉, 컬럼이 여러 개일수록
ROLLUP은
가장 자세한 결과 → 중간 요약 → 전체 요약
이 흐름으로 붙는다고 이해하면 된다.
ROLLUP 원리
GROUP BY a WITH ROLLUP
(a)
()

GROUP BY a, b WITH ROLLUP
(a, b)
(a)
()

GROUP BY a, b, c WITH ROLLUP
(a, b, c)
(a, b)
(a)
()
ROLLUP원리는GROUP BY a, b WITH ROLLUP이면(a, b),(a),()순서로 요약이 추가되고, 컬럼이 더 많아지면 같은 방식으로 단계가 늘어난다.
헷갈리기 쉬운 부분첫째, 집계 함수는 여러 행을 계산해서 결과 하나를 만드는 함수다.
그래서 일반SELECT처럼 행 하나하나를 보여주는 조회와는 다르다.
둘째,GROUP BY를 쓰면 결과가 원본 행 수만큼 나오는 것이 아니라
그룹 개수만큼 나온다.
셋째,GROUP BY를 쓸 때는
그룹 기준 컬럼과 집계 함수만SELECT에 쓰는 쪽으로 이해해야 한다.
묶는 기준과 상관없는 컬럼을 넣으면 의미가 맞지 않거나 오류가 날 수 있다.
넷째,WHERE와HAVING은 기준이 다르다.
WHERE→ 그룹화 전의 행 조건HAVING→ 그룹화 후의 결과 조건
다섯째,
ROLLUP은 그룹별 결과를 없애는 것이 아니라
그 위에 소계와 총계 행을 더 붙이는 기능이다.
짧게 흐름으로 다시 보기
집계 함수
→ 여러 행을 계산해서 결과 하나 만들기
GROUP BY
→ 같은 값끼리 묶어서 그룹별 계산하기
HAVING
→ 계산이 끝난 그룹 결과에 조건 걸기
ROLLUP
→ 그룹 결과에 소계와 총계까지 함께 보기
즉, 이 파트의 핵심은
행을 그냥 나열해서 보는 것에서 끝나지 않고, 묶고 계산해서 의미 있는 결과로 바꿔 보는 것이다.
GROUP BY 실습 문제
문제 해석은 이렇게 한다
GROUP BY,HAVING,ROLLUP문제는 문장을 한 번에 보면 헷갈리기 쉽다.
그래서 바로 SQL을 쓰지 말고, 먼저 문제를 잘라서 읽어야 한다.
순서는 보통 이렇다.
1. 무엇을 기준으로 묶으라는지
2. 각 그룹마다 무엇을 계산하라는지
3. 묶기 전에 거를 조건인지, 묶은 뒤에 거를 조건인지
4. 정렬까지 필요한지
5. 출력 모양까지 바꿔야 하는지즉, 이런 문제는 보통
행을 먼저 걸러낼지 → 무엇으로 묶을지 → 무엇을 계산할지 → 계산 결과를 다시 걸러낼지 → 어떻게 정렬할지
이 순서로 읽으면 된다.
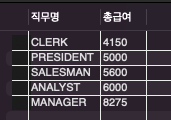
1. 각 직무별로 급여합을 출력하되 급여합이 낮은 순으로 출력한다.이 문제는 두 부분으로 나눠서 읽으면 된다.
각 직무별로
→job기준으로 묶으라는 뜻이다.
급여합을 출력
→ 각 그룹마다sum(sal)을 계산하라는 뜻이다.
급여합이 낮은 순으로 출력
→ 계산이 끝난 결과를 작은 값부터 정렬하라는 뜻이다.
즉, 이 문제는
직무별 그룹화 + 급여 합계 계산 + 정렬
문제다.
여기서는 아직 그룹 결과를 거르라는 말은 없으므로HAVING은 필요 없다.
핵심은job으로 묶고, 그 묶음마다sum(sal)을 구한 뒤, 그 합계를 기준으로 오름차순 정렬하는 것이다.
정답 코드select job as 직무명, sum(sal) as 총급여 from emp group by job order by sum(sal);
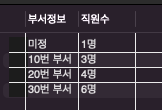
2. 각 부서에서 근무하는 직원들의 인원 명수를 알고싶다. 다음 형식으로 출력하는 SQL을 작성한다 .(순서무관)이 문제는 보기보다 요구가 여러 개다.
각 부서에서
→deptno기준으로 묶어야 한다.
직원들의 인원 명수
→ 각 그룹마다count(*)를 세야 한다.
그런데 출력 예시를 보면
10번 부서,20번 부서,30번 부서,미정
이렇게 보인다.
즉, 이 문제는 단순히 개수만 세는 게 아니라
부서번호를 보기 좋은 문자열로 바꿔서 보여 주는 것까지 들어 있다.
특히deptno가NULL인 행은미정으로 보여 줘야 하므로,
여기서는IFNULL()도 같이 떠올려야 한다.
즉, 이 문제는
부서별 그룹화 + 인원수 집계 + 출력 모양 가공
문제다.
정답 코드select if(deptno is null, '미정', concat(deptno, '번 부서')) as '부서정보', concat(count(*), '명') as '직원수' from emp group by deptno;
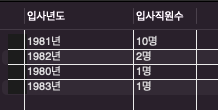
3. 년도별로 몇명이 입사했는지 알고싶다. 다음 형식으로 출력하는 SQL을 작성한다 . (많이 입사한 순으로 출력)이 문제는 먼저 입사일에서 연도를 꺼내야 한다.
년도별로
→hiredate전체로 묶는 게 아니라,연도만 뽑아서 그 기준으로 묶으라는 뜻이다.
몇명이 입사했는지
→ 각 연도 그룹마다count(*)를 세면 된다.
많이 입사한 순으로 출력
→ 계산이 끝난 인원 수를 기준으로 내림차순 정렬해야 한다.
즉, 이 문제는
날짜에서 연도 추출 + 연도별 그룹화 + 인원 수 집계 + 정렬
문제다.
이런 문제는 날짜 컬럼을 그대로GROUP BY하는 게 아니라,
먼저 문제에서 원하는 단위인 연도로 바꿔서 봐야 한다는 점이 핵심이다.
정답 코드select concat(year(hiredate), '년') as 입사년도, concat(count(*), '명') as 입사직원수 from emp group by year(hiredate) order by count(*) desc;
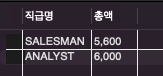
4. 직무별 급여 총액을 출력하되, 직무가 'MANAGER'인 직원들은 제외한다. 그리고 급여총액이 5000보다 큰 직급과 총급여만 출력한다.이 문제는
WHERE와HAVING을 구분해서 읽는 연습이다.
직무가 'MANAGER'인 직원들은 제외한다
→ 이건 그룹으로 묶기 전에 원본 행에서 빼야 한다.
즉,WHERE조건이다.
직무별 급여 총액을 출력
→ 남은 행들을job기준으로 묶고sum(sal)을 계산해야 한다.
급여총액이 5000보다 큰 직급과 총급여만 출력
→ 이건 계산이 끝난 뒤 그룹 결과를 다시 거르는 말이다.
즉,HAVING조건이다.
그래서 이 문제는
WHERE로 원본 행 먼저 걸러내기 + GROUP BY + SUM + HAVING으로 집계 결과 걸러내기
문제다.
이 문제를 제대로 읽으면
왜WHERE와HAVING이 둘 다 필요한지가 바로 보인다.
정답 코드select job as 직급명, format(sum(sal), 0) as 총액 from emp where job <> 'MANAGER' group by job having sum(sal) > 5000;
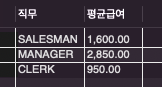
5. 30번 부서의 직무별 년봉의 평균을 검색한다. 연봉계산은 급여커미션(null이면 0으로 계산)이며 출력 양식은 소수점 이하 두 자리(반올림)까지 통일된 양식으로 출력한다.이 문제는 문장이 길고, 중간에 해석 포인트가 하나 있다.
30번 부서의
→ 먼저deptno = 30으로 원본 행을 걸러야 한다.
직무별
→ 그다음job기준으로 묶어야 한다.
년봉의 평균
→ 여기서 문제 문장만 보면 12를 곱해야 할 것 같지만,
예시 결과를 보면 실제로는(급여 + 커미션)의 평균을 구한 값이 나온다.
즉, 이 문제는 예시 기준으로 읽으면
급여 + 커미션(null이면 0)을 더한 값의 평균을 구하라는 뜻으로 보는 게 맞다.
커미션(null이면 0으로 계산)
→IFNULL()이 필요하다.
소수점 이하 두 자리(반올림)
→ROUND()나 형식 함수로 자리수를 맞춰야 한다.
즉, 이 문제는
WHERE + GROUP BY + NULL 처리 + 평균 계산 + 출력 형식 맞추기
문제다.
문제 문장을 그대로 믿고 바로 식을 쓰는 게 아니라,
반드시 예상 결과까지 같이 보고 해석해야 하는 대표 문제다.
정답 코드select job as 직무, format(avg(sal + ifnull(comm, 0)), 2) as 평균급여 from emp where deptno = 30 group by job;
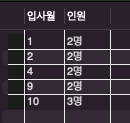
6. 월별 입사인원을 다음 형식으로 출력하는 SQL 을 작성한다 . 입사월별로 오름차순이며 입사인원이 2명 이상인 경우에만 출력한다.이 문제는 날짜를 월 단위로 잘라서 봐야 한다.
월별 입사인원
→hiredate에서 월만 꺼내고, 그 월 기준으로 묶어야 한다.
입사인원이 2명 이상인 경우에만 출력
→ 이건 원본 행 조건이 아니라, 월별로 묶어서 센 뒤의 결과를 거르는 말이다.
즉,HAVING조건이다.
입사월별로 오름차순
→ 마지막에 월 기준으로 정렬해야 한다.
즉, 이 문제는
월 추출 + 그룹화 + COUNT + HAVING + ORDER BY
문제다.
이 문제에서 핵심은2명 이상을WHERE로 쓰면 안 되고,
반드시 집계가 끝난 뒤의 결과 조건으로 읽어야 한다는 점이다.
정답 코드select month(hiredate) as 입사월, concat(count(*), '명') as 인원 from emp group by month(hiredate) having count(*) >= 2 order by month(hiredate);
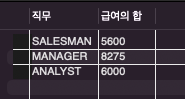
7. 직무별 급여의 합을 출력하는데 급여합이 5000을 초과하는 직무에 대해서만 출력한다.이 문제는 핵심이 간단하다.
직무별 급여의 합
→job기준으로 묶고sum(sal)을 구하라는 뜻이다.
급여합이 5000을 초과하는 직무에 대해서만 출력
→ 집계가 끝난 뒤 결과를 거르라는 뜻이다.
즉,HAVING문제다.
이 문제는 사실GROUP BY와HAVING의 가장 전형적인 형태다.
원본 행을 먼저 거르는 조건이 아니라,
그룹 결과의 합계를 기준으로 다시 거른다는 점이 핵심이다.
정답 코드select job as 직무, sum(sal) as "급여의 합" from emp group by job having sum(sal) > 5000;
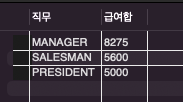
8. 1981년도에 입사한 직원들에 대해 직무별 급여합을 출력하는데 직무별 급여합이 3000을 초과하는 경우에 대해서 직무별 급여합이 높은순으로 출력한다.이 문제는 단계가 많아서 꼭 끊어 읽어야 한다.
1981년도에 입사한 직원들에 대해
→ 먼저1981년 입사자만 남겨야 한다.
이건 원본 행 조건이므로WHERE다.
직무별 급여합
→ 남은 행들을job기준으로 묶고sum(sal)을 구해야 한다.
직무별 급여합이 3000을 초과하는 경우
→ 이건 집계 결과를 다시 걸러내는 조건이므로HAVING이다.
직무별 급여합이 높은순으로 출력
→ 마지막에 합계 기준 내림차순 정렬이 필요하다.
즉, 이 문제는
WHERE + GROUP BY + HAVING + ORDER BY
가 모두 들어간 응용 문제다.
이런 문제를 잘 읽으려면
먼저 원본 행 조건인지,
아니면 집계 결과 조건인지를 구분하는 게 제일 중요하다.
정답 코드select job as 직무, sum(sal) as 급여합 from emp where year(hiredate) = 1981 group by job having sum(sal) > 3000 order by sum(sal) desc;