[논문리뷰] SSD
SSD는 RCNN 계열의 모델처럼 다양한 view를 활용하면서 YOLO처럼 통합된 network 구조를 가진
1-stage detector로서 높은 정확도와 빠른 속도를 갖는 모델입니다.
VGG16을 base network로 사용하고 보조 network(auxiliary network)를 추가한 구조를 가지고 있습니다.
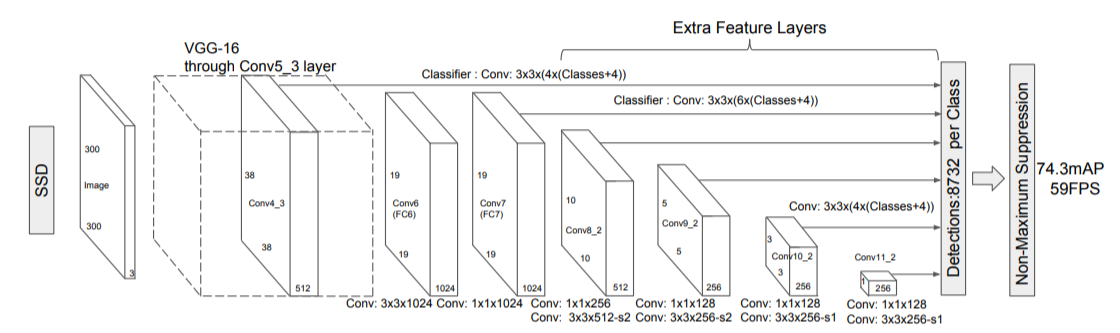
두 network를 연결하는 과정에서 fc layer를 conv layer로 대체하면서 detection 속도가 향상됩니다.
그리고 총 6개의 서로 다른 scale의 feature map을 예측에 사용합니다.
SSD 모델의 핵심적인 아이디어는 다양한 scale의 feature map을 사용한다는 점인데
구조에서의 특징을 보면 중간중간 피쳐맵을 만들어가면서 그 만들어진 피쳐맵에서 계속 Bounding Box를 뽑아냅니다.
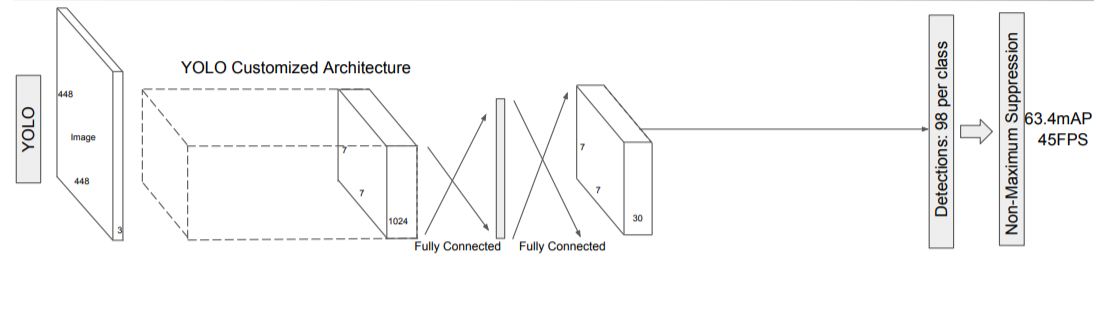
그리고 이같은 특징은 yolo v1과 비교해서 생각해볼 수 있는데 yolov1과 같은 경우 7x7(x30) 크기의 feature map만을 사용했습니다.
따라서 이처럼 단일한 scale의 feature map을 사용하므로써 다양한 크기의 객체를 포착하는 것이 어렵다는 단점이 있습니다.
그에 비해 SSD는 다양한 크기의 객체를 탐지하기 위해 feature map의 각 cell마다
서로 다른 scale과 aspect ratio(가로세로비)를 가진 Default box를 생성하여서 process를 진행하였습니다.
그리고 그림을 보면 알 수 있듯이 feature map의 scale이 작아질수록 default box의 scale은 커지므로
feature map의 크기가 작아질수록 더 큰 객체를 탐지할 수 있음을 의미합니다.
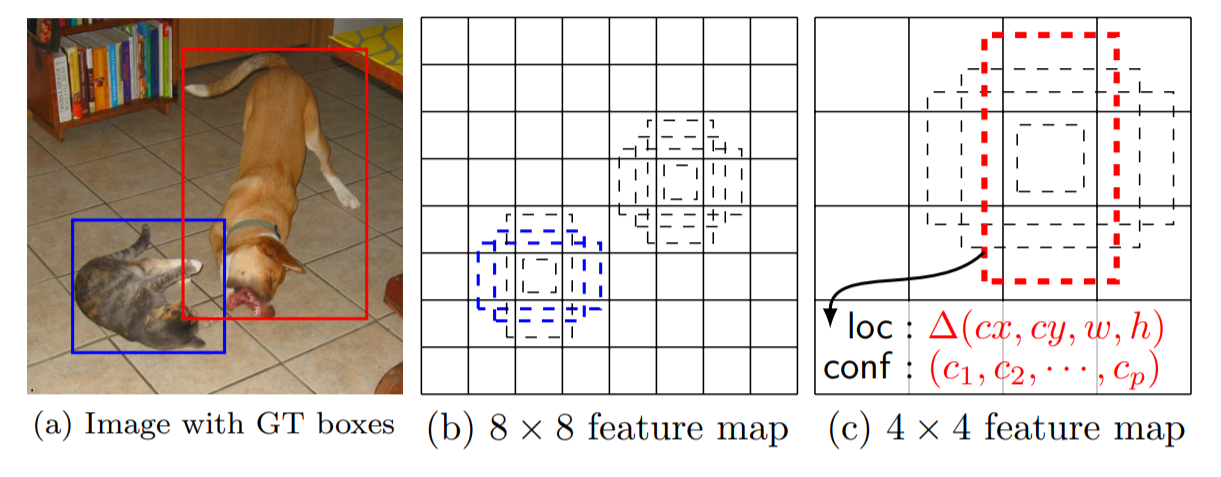
또한 각각의 feature map은 서로 다른 수의 default box를 적용합니다.
그리고 output feature map의 channel 수는 default box의 수를 k,예측하려는 class의 수를 c라고 할 때,output feature map의 channel의 수는
k(4+c)가 되도록 설계합니다. 이는 각 feature map의 cell이 k개의 default box를 생성하고 각 box마다 4개의 offset과 class score를 예측한다는 것을 의미합니다.
또한 학습이 진행될 때 default box의 학습 대상을 지정하기 위해
어떤 default box가 어떤 ground truth box와 대응하는지 결정해야 합니다.
이를 위해 default box와 ground truth box를 매칭하는 작업을 진행하는데 jaccard overlap을 0.5기준으로 positive와 negative로 label합니다.
그리고 이때 발생하는 클래스 불균형에 대해서는 False Positive sample을 학습 과정에서 추가하여 재학습하는 hard negative mining을 수행해서 해결합니다.
SSD의 training과정을 정리해서 설명하면
마지막 2개의 fc layer를 conv layer로 대체한 pre-trained된 VGG16 모델을 불러와 이후 최종 output feature map의 크기가 1x1이 되도록 하는 auxiliary network를 설계합니다.
이렇게 구성된 SSD network에 300x300크기의 이미지를 입력하면 이후 전체 network구간중 6개의 layer에서 각각 feature map을 추출합니다.
그리고 앞의 과정에서 얻은 서로 다른 scale의 feature map에 3x3 conv연산을 적용합니다. 이 과정에서 얻은 모든 feature map을 8732 x (21+4) (일정한)크기로 병합합니다.
그리고 이 과정을 통해 default box별로 bounding box offset 값과 class score를 파악할 수 있습니다. 그리고
위에서 얻은 feature map과 ground truth 정보를 활용하여 localization loss를 계산합니다.
hard negative mining 과정을 통해 얻은 hard negative sample과 positive sample을 사용하여 confidence loss를 계산합니다.
앞서 얻은 localization loss와 confidence loss를 더해 최종 loss를 구한 후 backward pass를 수행하여 network를 학습시킵니다.
loss function은 다음과 같습니다.
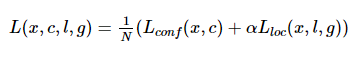
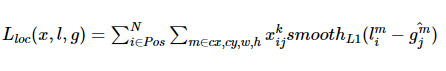
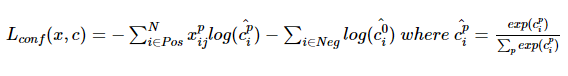
reference
https://herbwood.tistory.com/15
