[논문리뷰] YOLOv2
YOLOV2는 앞서 발표된 SSD모델에 비교할 수 있는데
SSD300 모델은 detection 속도가 빠르지만 정확도가 낮으며,
SSD512 모델은 정확도는 높지만 detection 속도가 느리다는 단점이 있습니다.
YOLO v2 모델은 다양한 아이디어를 도입하여 정확도와 속도 사이의 trade-off의 균형을 잘 맞춰 좋은 성능을 보였습니다.
논문의 제목을 보면 Better,Faster,Stronger로 각각 정확도를 올리기 위한 방법, detection 속도를 향상시키기 위한 방법,
더 많은 범위의 class를 예측하기 위한 방법으로 논문에서 나눠서 설명하고 있습니다.
각 파트별로 논문의 저자가 도입한 아이디어는.
Better
Batch Normalization, 모든 conv layer 뒤에 batch normalization을 추가하였습니다.이를 통해 mAP를 2%정도 향상시켰고,
High resolution classifier는 YOLO V1이 Darknet을 224x224 크기로 pre-train시키고 detection task 시에는 448x448 크기의 이미지를 입력시킨 것과 달리
YOLO v2 모델은 처음부터 Darknet을 448x448 크기로 pre-train시켜 네트워크가 상대적으로 높은 해상도의 이미지에 적응할 시간을 제공합니다.이와 같은 방법으로
mAP를 4%정도 향상시켰습니다.
Convolutional with anchor boxes는 YOLO v2에서는 anchor box를 도입하며, 이 과정에서 네트워크를 수정합니다.이를 통해 recall값을 올렸으며
따라서 실제 객체의 위치를 보다 잘 포착할 수 있게 된 것을 알 수 있습니다.
Dimension clusters는 k-means clustering을 통해 최적의 prior를 탐색하는 방법을 제시한 것을 의미합니다.
Direct location prediction은 YOLO와 anchor box를 함께 사용했을 때 문제점이 초기 iteration 시, 모델이 불안정하다는 것인데
이러한 문제를 해결하기 위해 YOLO의 방식을 사용하여 grid cell에 상대적인 위치 좌표를 예측하는 방법을 선택했습니다.
그리고 이렇게 예측하는 위치의 범위가 정해짐으로써 네트워크는 안정적으로 학습을 진행하는 것이 가능해졌습니다.
Fine-Grained Features는
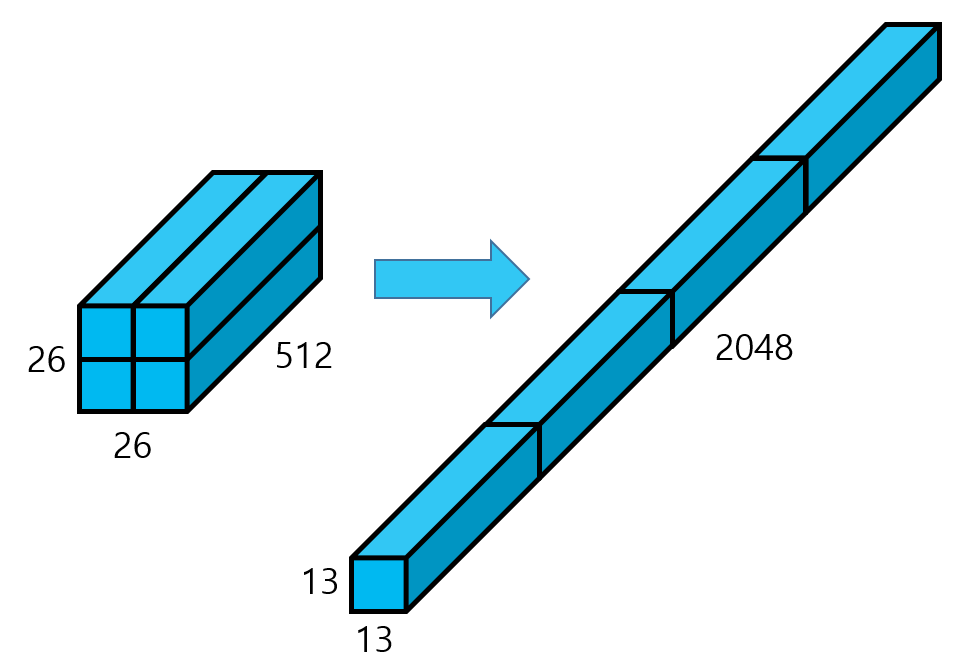
YOLO v2는 최종적으로 13x13 크기의 feature map 출력하는데 이때 feature map의 크기가 작은 경우 큰 객체는 비교적 잘 예측하나 작은 객체는 예측하기 어렵다는 문제가 있습니다.
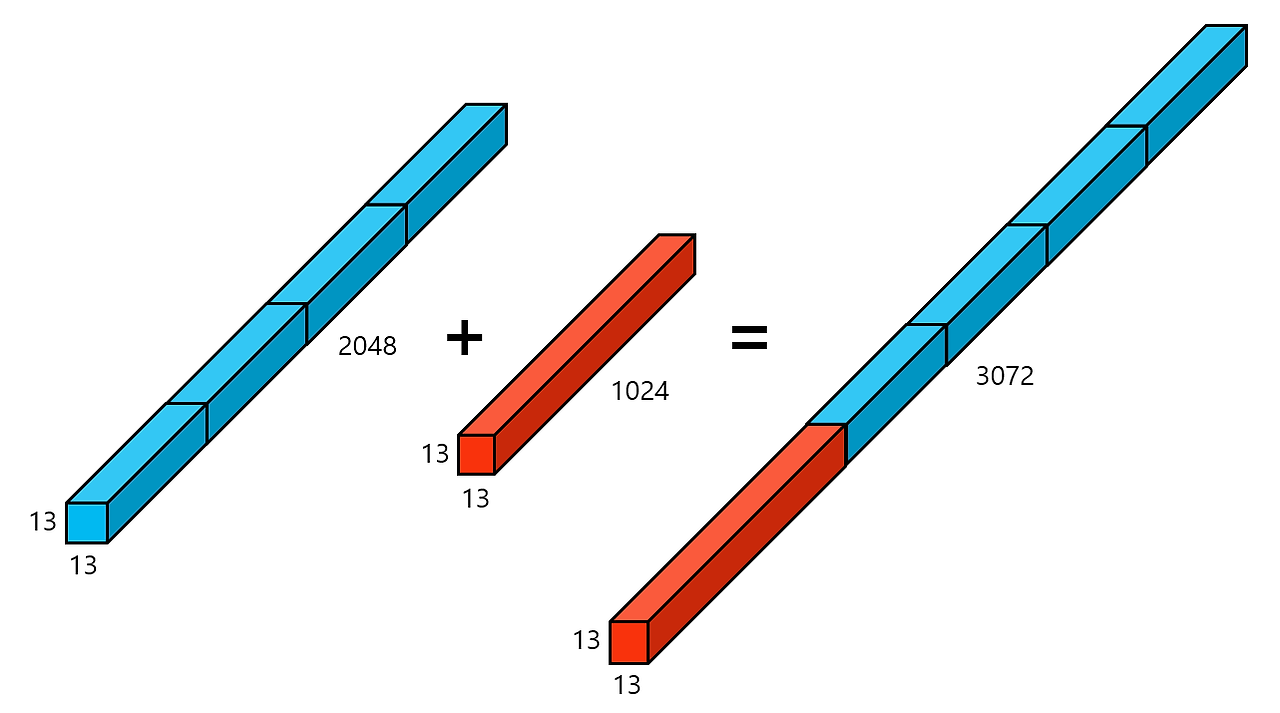
이를 해결하기 위해 마지막 pooling을 수행하기 전에 feature map을 추출하여 26x26(x512) 크기의 feature map을 얻습니다.
그 다음 위의 그림과 같이 feature map을 channel은 유지하면서 4개로 분할한 후 결합하여 13x13(x2048)크기의 feature map을 얻습니다.
따라서 보다 작은 객체에 대한 정보를 함축할 수 있도록 합니다.
Multi-Scale Training
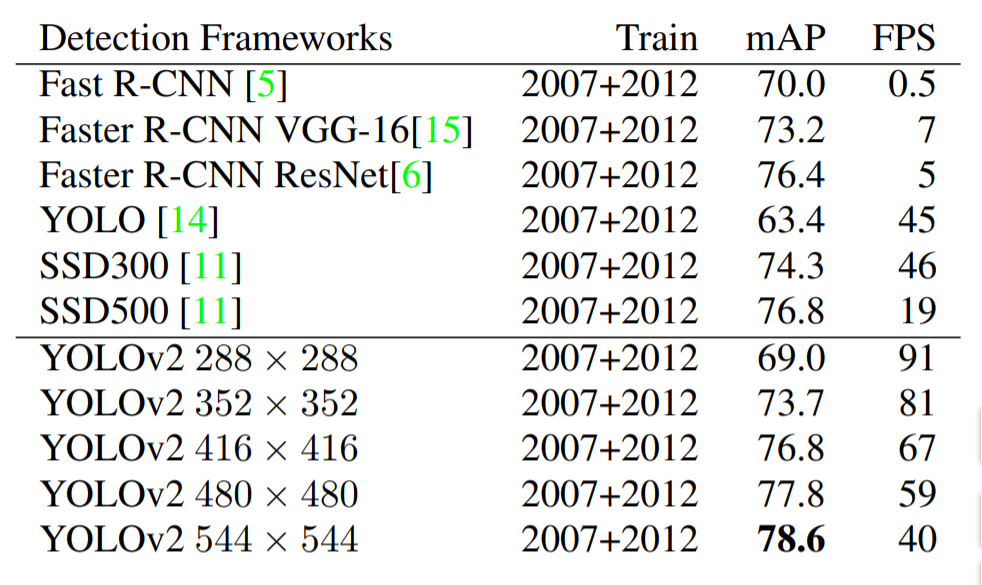
YOLO v2 모델을 보다 강건하게 만들기 위해 다양한 입력 이미지를 사용하여 네트워크를 학습시킵니다.
논문에서는 10 batch마다 입력 이미지의 크기를 랜덤하게 선택하여 학습하도록 설계했습니다.
이를 통해 네트워크는 다양한 크기의 이미지를 입력받을 수 있고, 속도와 정확도 사이의 trade-off를 제공합니다.
위의 표에서 확인할 수 있듯이 입력 이미지의 크기가 작은 경우 더 높은 FPS를 가지며, 입력 이미지의 크기가 큰 경우 더 높은 mAP 값을 가지게 됩니다.
Faster
YOLO v2는 Darknet-19라는 독자적인 classification 모델을 backbone network로 사용합니다.
그런데 YOLO v1 모델은 네트워크 마지막에 fc layer를 통해 예측을 수행했던것과 달리
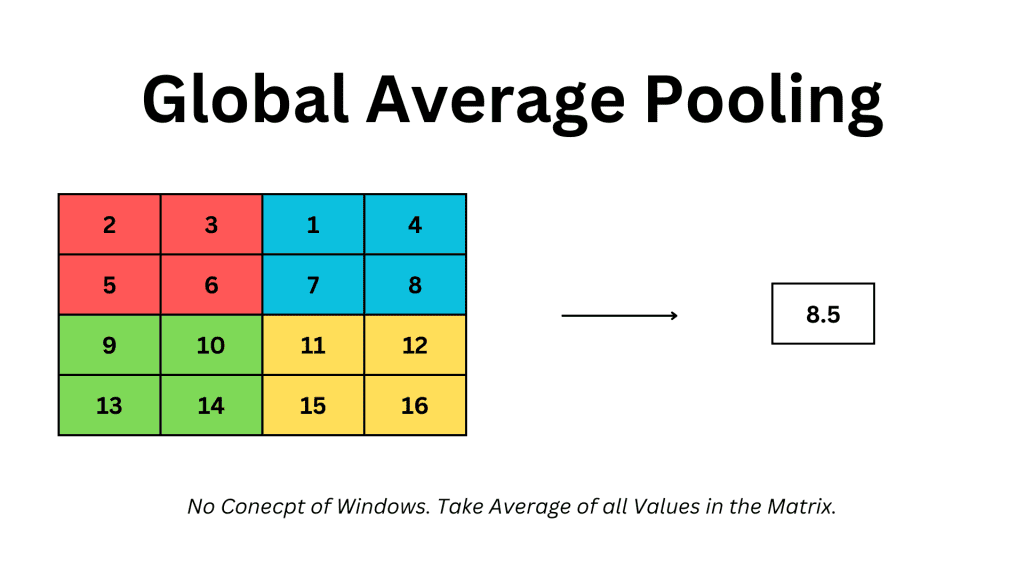
YOLO v2의 Darknet-19는 마지막 layer에 global average pooling을 사용하여 파라미터 수를 감소시키고, detection 속도를 향상시켰습니다.
Training for classification
Darknet-19는 class의 수가 1000개인 ImageNet 데이터셋을 통해 학습시킵니다.
Training for detection
Darknet-19를 detection task로 사용하기 위해 마지막 conv layer를 제거하고 3x3(x1024) conv layer로 대체하고, 이후 1x1 conv layer를 추가합니다.
Stronger
YOLO v2를 classification 데이터와 detection 데이터를 함께 사용하여 학습시킴으로써 보다 많은 class를 예측하는 YOLO 9000을 소개합니다.
따라서 학습시 classification 데이터와 detection 데이터를 섞어 학습시키는데,
detection 데이터셋은 일반적이고 범용적인 객체에 대한 정보를 가지고 있는 반면, classification 데이터셋은 보다 세부적인 객체에 대한 정보를 가지고 있습니다.
이러한 문제를 해결하기 위해 Hierarchical classification, 즉, ImageNet label로부터 Hierarchical tree인 WordTree를 구성하는 방법을 제안합니다.
이러한 트리에서 특정 범주에 속할 확률은 루트 노드로부터 해당 범주의 노드까지의 조건부 확률의 곱으로 표현할 수 있습니다.
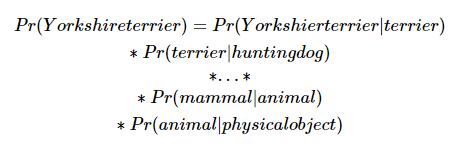
Dataset combination with WordTree는 ImageNet 데이터와 COCO 데이터를 합쳐 WordTree를 구성했다는 것이고,
Joint classification and detection
만약 네트워크가 classification 데이터셋의 이미지만을 보면 오직 classification loss에 대하여 backward pass를 수행합니다.
하지만 Joint training 방식을 통해 COCO 데이터셋을 활용하여 이미지 내에서 객체를 찾는 detection task와 ImageNet 데이터셋을 통해 보다 넓은 범주의 객체를 분류할 수 있도록 학습됩니다.
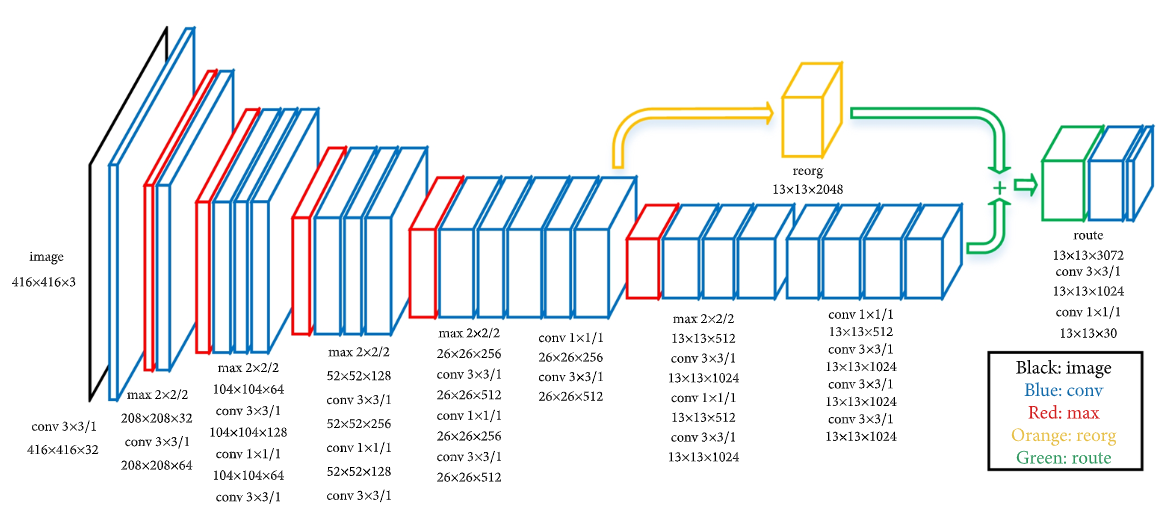
최종적으로 training에 대해서 정리하면 416x416 크기의 이미지를 Darknet-19에 입력하여 여러 conv layer를 거쳐 13x13x1024 크기의 feature map을 얻습니다.
그리고 앞서 말했듯이 마지막 pooling을 수행하기 전 에 feature map을 추출하여 26x26(x512) 크기의 feature map을 얻습니다.
그리고 이 26x26을 channel은 유지한 채로 feature map을 4개로 분할한 후 결합(concat)하여 13x13(x2048)크기의 feature map을 얻습니다.
그리고 각각의 13x13 feature map을 channel에 따라 결합하여서 그림과 같은 13x13크기의 feature map을 얻습니다.
그리고 3x3 conv와 1x1 conv 연산을 적용하여 최종적으로 13x13(x125) 크기의 feature map을 얻습니다.
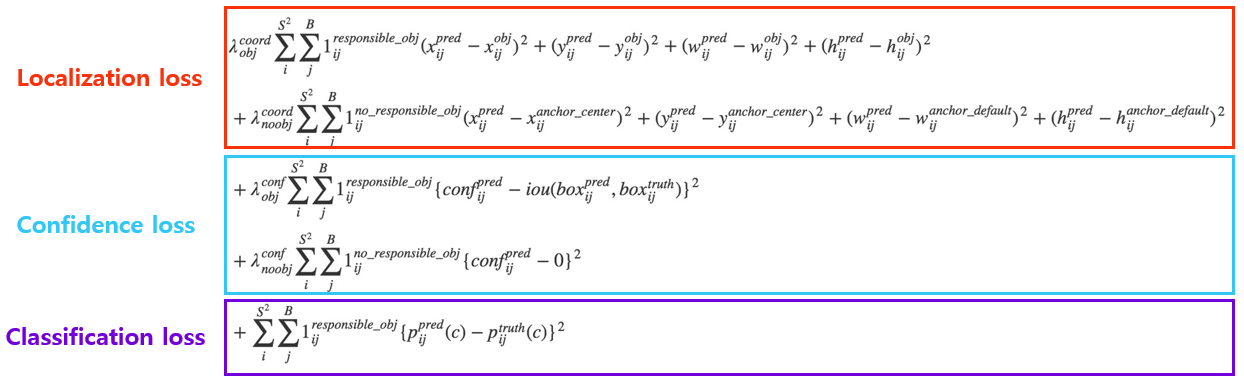
또한 v1과 같이 전체 loss가 SSE(Sum of Squared Error)입니다.
reference
https://herbwood.tistory.com/17
