23) Policy Gradients
--------------------preview-----------------------
우리는 정책의 성능을 평가하는 지표
의 그레디언트를 사용하여 점점 더 좋은 정책을 찾아나갈 것이다. 그럼, 가장 먼저 성능 지표 를 정의해야 한다. 이 성능 지표는 주어진 MDP의 설정에 따라 달라질 수 있다. 성능 지표가 달라지면, 그레디언트도 달라질 것이다. 그럼 우리는 성능 지표를 정의할 때마다 그레디언트를 해석적으로 (analytically, 직접 식을 전개하여 푸는 것을 의미) 계산을 해야 하는가? 정말 다행히도 policy gradient theorem은 다양한 성능 지표에 대해서 그레디언트들이 서로 비례한다는 것을 보였다.
Policy gradient theorem을 조금 더 쉽게 기술하기 위해 주어진 MDP가 finite state space, finite action space를 갖고 episodic이며,
라고 가정할 것이다. 하지만, continuous state space, continuous action space, infinite horizon에 대해서도 시그마 이지만 인테그랄
로 바꿔서 기술하면 된다. Episodic 환경에서 가장 자연스러운 정책 평가 지표는 에피소드 동안 받은 보상의 총합의 기댓값일 것이다. 즉, 초기 상태의 가치 함수이다.
Policy-Based Reinforcement Learning
RL은 application마다 잘 맞는게 다 다르다. 최근 거라고 다 맞는게 아니다. 매개변수를 사용하여 value 또는 action-value 함수를 근사화했습니다.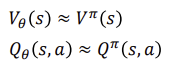
value functino으로 부터 policy가 발생되며 이때 우리는 입실론-greedy 방법을 채택합니다. 그리고 policy는 state에 따른 action을 하는 것을 의미하며 우리는 정책을 직접 매개변수화할 것입니다.
Value-Based RL and Policy-based RL
value Based: Learnt value function & Implicit policy(𝜀-greedy)
Policy Based: No Value Function & Learnt Policy
Actor-Critic: Learnt Value Function & Learnt Policy
위와 같이 설명 될 수 있습니다.
Advantages of Policy-Based RL
장점으로는 다음과 같은 것들이 있으며 단점으로는 다음과 같은 것들이 있습니다.
장점은
1)convergence 특성 즉, policy자체를 따라가서 더 convergence가 잘된다는 특징이있으며(estimate과정이 없어서 fast),
2)high-dimensional 혹은 continuous한 action spaces에서도 동작합니다.
3) stochastic policies를 배울 수 있다는 특징 또한 있습니다.
단점은
1)gradient를 따지기 때문에 local optimum에 빠질 가능성이 높다는 특징이 있으며,
2)policy,를 evaluating하는데 typically 하게 ineffeicient하고 high variance하다는 특징이 있다.
아래와 같이 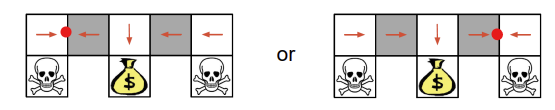
와 같은 Aliased Gridworld에서 회색 부분인 지역은 agent가 구별할 수 없습니다.
Aliased Gridworld Example
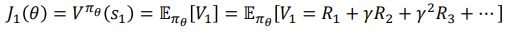
deterministic policy를 따르기 때문에 빨간색으로 칠한 부분이 stuck될 수 있습니다 따라서 목표에 도달하지 못하는 경우가 존재합니다.
따라서 optimal stochastic policy를 따라서 stuck되지 않도록 합니다. 이와 같은 방식을 따르면 좀 더 빠른 단계안에 goal에 도달합니다.
Policy Objective Functions
reward를 최대화 하는 것을 궁극적 목표로 합니다.
episodic environments에서는 우리는 start value를 사용합니다. 이때 start value는 state를 처음 시작할 때 value값을 의미하며 식은 다음과 같습니다. 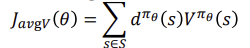
continuous environments에서는 average value를 사용합니다 episode가 아닌 경우 끝이 안난다는 특징이 있습니다.
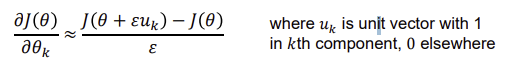
위의 식에서 각 parameter들이 뜻하는 바는 앞에서 부터 최종 얻게 되는 distribution d(s),𝜋는 probability ,R(s,a)는 reward입니다. 그리고 𝜋와 R(s,a)의 곱의 합이 expectation을 의미하고 이를 다시 모든 state에 대해 계산하는 과정을 거칩니다.
즉, Policy based reinforcement learning은 j를 극대화하는 𝜃을 찾는 최적화 문제입니다.
Policy Gradient
only gradient로 grobal optimum한 것이 되게 하기까지는 역부족 하므로 reward를 최대화 하는 local optimum을 찾은 뒤 global optimum하는 algorithm이 더 존재 합니다.
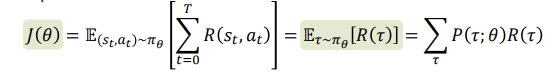
특정 dimension에 대해서 epsilon을 구해서 위식을 계산하는 과정을 거칩니다. 임의의 polices를 위한 작업들을 계산하며 이에 대한 것들은 주로 대부분 미분 가능합니다.
continuous space에서 policy-based의 방법이 더 유용할 것으로 기대하는 것은 당연합니다.
왜냐하면 유한개의 actions에서 value-based방법은 spaces가 늘어남에 따라 계산량도 늘어나고 , 그럼에 따라 curse of dimensionality가 발생하며 환경이 주어지지 않았을 떄 policy update에 의해 state distribution에 영향을 추정하는 것은 어렵습니다.
Analytic Gradients
최종목표는 return의 expectation이 최대가 되도록하는 것이며 아래 식을 설명하면 trajectory t의 rewards의 합의 expectation을 의미합니다.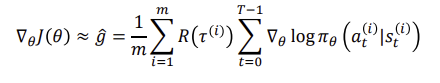
모든 식을 전개 후 정리하면 다음과 같은 최종식을 알 수 있습니다.
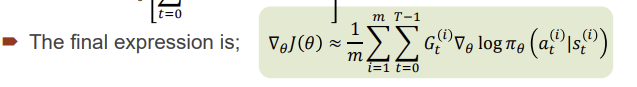
Temporal Structure of Rewards
식들을 전개 후 최종식을 정리하면 다음과 같습니다.
Monte-Carlo Policy Gradient (REINFORCE)
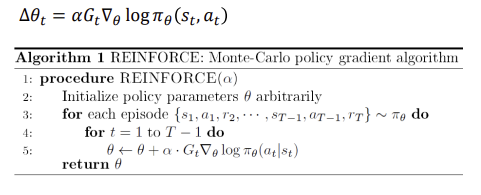
stochastic gradient ascent에 의해 parameters가 update되며 policy gradient theorem을 사용합니다. 또한 Q의 unbiased estimates로서 Gt를 return합니다.
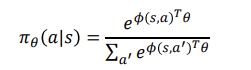
𝜋(a|s)는 미분가능하며 최종적으로 알게될 action인 것을 알 수 있습니다.
Softmax Policy
discrete action spaces에서 𝜋는 policy인데 이는 probability를 표현할 함수를 의미하며 이 공간에서 softmax function는 주로 policy를 parameterize 하는데 주로 쓰입니다.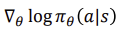
score function은 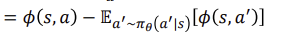
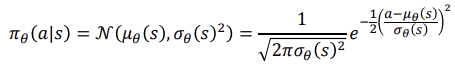
Gaussian Policy
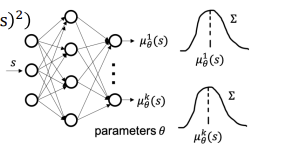
continuous action space에서 gaussian policy 는 흔한 선택입니다.
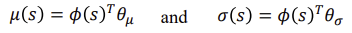
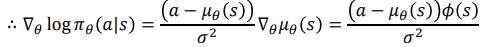
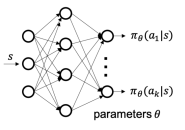
Action Selection
Discrete Action Space: Categorical Distribution
int형의 random함수들 중 고르는 것으로 softmax이후는 probability값을 선택합니다.
Continuous Action Space: Gaussian Distribution
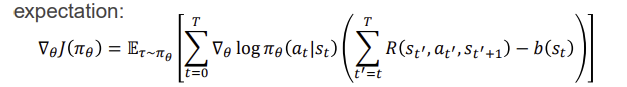
floating-point의 random함수중 고르는 것으로 dimension마다 항들 값이 나옵니다.
Exploration vs. Exploitation
샘플링 동작을 통해 탐색합니다 이러한 sampling은 random으로 값을 선택하는 것을 의미하며 액션 선택의 무작위성의 양은 초기 조건과 훈련 절차 모두에 따라 달라집니다.정책은 일반적으로 점진적으로 덜 무작위적이 됩니다.무작위성의 감소를 통해 local optimum에서 벗어날 확률이 적어진다는 문제점이 있으며 entropy bonus를 통해 local optimum에서 벗어나도록 entropy bonus를 더하는 해결책을 제시합니다.
Issues in REINFORCE Algorithm
매우 간단하지만, REPORENT 알고리즘은 실제로는 잘 작동하지 않습니다. 그 이유는 다음과 같습니다 :
returns인 R값의 분산이 매우 높아서,reward scaling에 민감한 것도 그러합니다. 또한 통계를 통해 확률을 만드는 작업이기 때문에 수렴을 위해 많은 에피소드가 필요합니다. 온라인 학습에서만 작동합니다. 에피소드여야합니다. 정책기울기를 근사하면 bias가 발생합니다.
Baselines in Policy Gradients
EGLP(Expected Grad-Log-Prob) 보조정리의 즉각적인 결과는 상태에만 의존하는 함수 b(s)에 대해 이는 베이스라인으로 볼 수 있으며 두 문제를 해결하기 위한 첫 번째 단순하지만 효과적인 아이디어는 수익률에서 표본 수익률의 평균을 빼는 것입니다.
식으로 정리하면 다음과 같습니다.

Vanilla Policy Gradient Algorithm
기본이 되는 방법으로 기준선의 가장 일반적인 선택은 정책 가치 함수 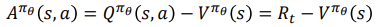
Reducing Variance: Actor-Critic Algorithm
Monte-Carlo policy gradient가 여전히 높은 분산을 가지고 있으므로 따라서 TD 를 대신 해서 적용합니다. Actor-critic algorithms maintain two sets of parameters
Critic 은 action-value function인 parameters w를 updates합니다.
Actor은 policy parameters 세타를 updates합니다.
actor-critic 알고리즘은 대략적인 정책 기울기를 따릅니다.
Advantage Action-Critic (A2C)
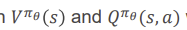
와 policy gradient 3개에 대해 estimate하는 것입니다.
A2C Algorithm
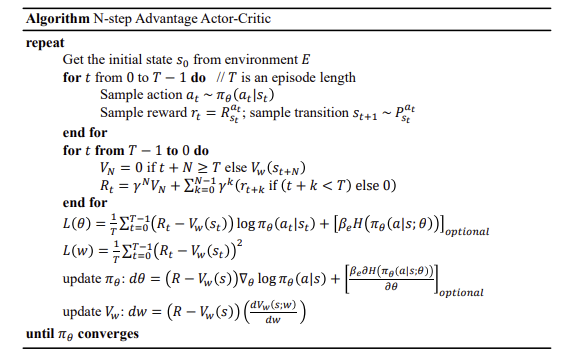
위의 psuedo-code TD는 biased가 높다는 특징과 MC는 variance가 크다는 특징이 있습니다. 따라서 n-step을 사용하여서 끝까지는 사용안하고 몇단계만 사용하는 것을 알 수 있습니다. A3C는 더 많이 쓸때 사용합니다.
Summary of Policy Gradient Algorithms
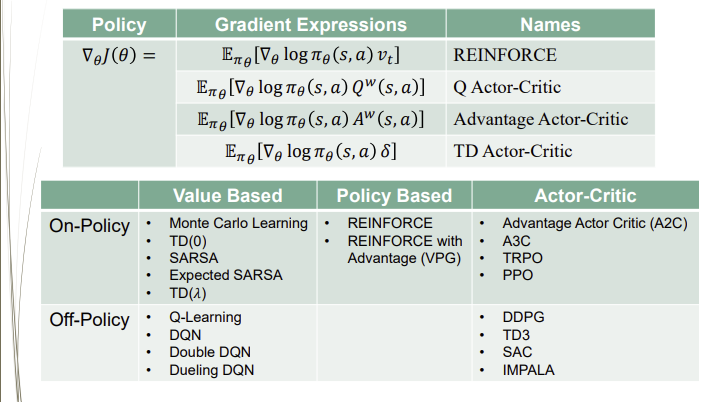
아래표를 통해서 policy의 gradient expressions의 각각 다른 표현들을 볼 수 있고, On-policy와 off-policy의 value based 와 policy based 와 actor-critic에 따라 분류되는 모델들을 알 수 있습니다.