느낀점
- 많이 사용하는 노이즈 캔슬링처럼 두 출력의 차이차를 이용하여 노이즈를 감쇄하는 방법을 Transformer에 적용한 점이 배울만한 점
- 간단한 생각을 쉽게 적용하였고 다양한 실험을 통해 그 효과를 입증하였음
- 집중해야하는 부분에 대해서 효과를 본다면 전반적인 내용을 통해 풀어야 하는 문제에 대한 성능에 대한 궁금증
Abstract
기존의 트랜스포머 연산을 통한 LLM은 가끔 의미 없는 문장에 너무 집중하는 경우가 있습니다.
본 논문에서는 핵심이 되는 맥락에 대한 집중을 강화하고 노이즈를 제거하는 DIFF Transformer를 제안합니다.
the differential attention mechanism은 2개의 개별적인 소프트맥스 attention map의 차이를 통해 attention score를 계산합니다.
해당 차이를 이용하여 노이즈를 제거하고 sparse attention patern을 찾습니다.
새로운 방식으로 모델을 학습한 DIFF Transformer는 모델 크기와 학습 토큰을 확장하는 다양한 설정에서 기존 Transformer보다 뛰어난 성능을 보였습니다.
DIFF Transformer는 긴 맥락 모델링, 주요 정보 검색, 환각 완화, 맥락 학습, 활성화 이상치 감소와 같은 응용 분야에서 눈에 띄는 이점을 제공합니다.
관련 없는 정보에 집중하지 않으므로 DIFF Transformer는 QnA, 텍스트 요약과 같은 테스크에서 환각을 완화할 수 있습니다.
Introduction
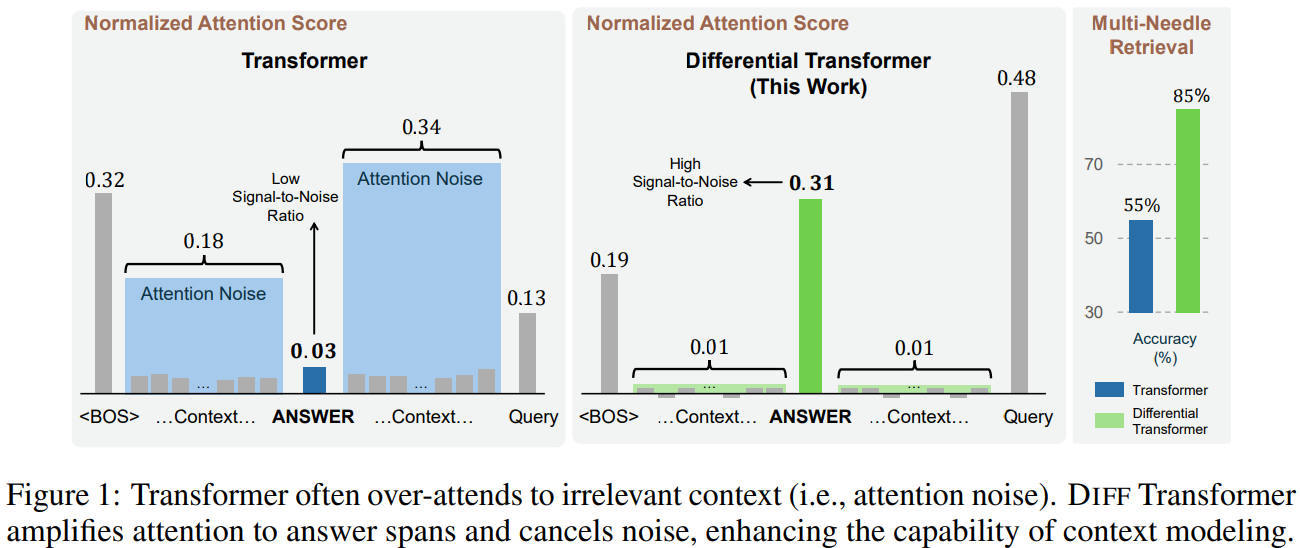
왼쪽의 도표인 일반적인 Transformer는 불필요한 정보에 과도하게 집중하여 주변 문맥에 더 많은 attention합니다. 신호대비 잡음비 비율이 낮은 것으로 확인됩니다.
가운데 도표에서는 DIFF Transformer는 필요한 정보에 높은 집중을 하는 것을 확인할 수 있습니다.
오른쪽 도표에서 실제 바늘 찾기 테스트(문서 더미 중간에 삽입된 답을 찾아내는 테스트)에서 높은 성능을 보이는 것을 확인했습니다.
디코더로 구성된 Transformer는 LLM의 표준 아키텍쳐입니다.
Transformer의 핵심인 어텐션 메커니즘은 소프트맥스 함수를 사용해 시퀀스 내 다양한 토큰의 중요도를 계산하고 가중합니다.
하지만 최근 연구들에 따르면 LLM은 문맥에서 중요한 정보를 정확하게 찾아내는 데 어려움을 겪고 있습니다.
그림 1의 왼쪽 그래프처럼 관련이 적은 문맥에 과도한 집중을 하는 것을 확인할 수 있습니다.
올바른 정답을 방해하는 이러한 점수는 attention noise로 부릅니다.
해당 문제를 해결하기 위한 DIFF Transformer를 제안합니다.
새로운 어텐션 메커니즘은 차별화된 노이즈 제거를 통해 어텐션 노이즈를 제거하는 것을 목표로 합니다.
쿼리와 키 벡터를 두 그룹으로 나누고 각각에 대해 두 개의 별도 소프트맥스 어텐션 맵을 계산합니다.
두 맵의 차이가 어텐션 점수가 됩니다.
어텐션 노이즈를 제거하여 모델이 중요한 정보만 집중할 수 있도록 합니다.
신호 차이를 이용하여 노이즈 상쇄하는 노이즈 캔슬링과 유사한 동작 방식입니다.
해당 컨셉을 이용하여 광범위한 실험을 수행했습니다.
많은 실험을 통해 제안한 방법론이 효과적이고 독창적인 아키텍쳐임을 입증합니다.
Differential Transformer
모델은 개의 diff transformer 층으로 쌓여 있습니다.
입력 시퀀스 이 주어졌을 때, 입력 임베딩을 로 묶습니다.
은 모델의 히든 차원을 나타냅니다.
출력은 로 표현됩니다.
입니다.
각 층은 두 개의 모듈로 구성는데 어텐션 모듈과 피드포워드 네트워크 모듈입니다.
기존의 transformer와 비교했을 때 차이점은 기존 소프트맥스 어텐션을 새로운 어텐션으로 대체한 것입니다.
Differential Attention
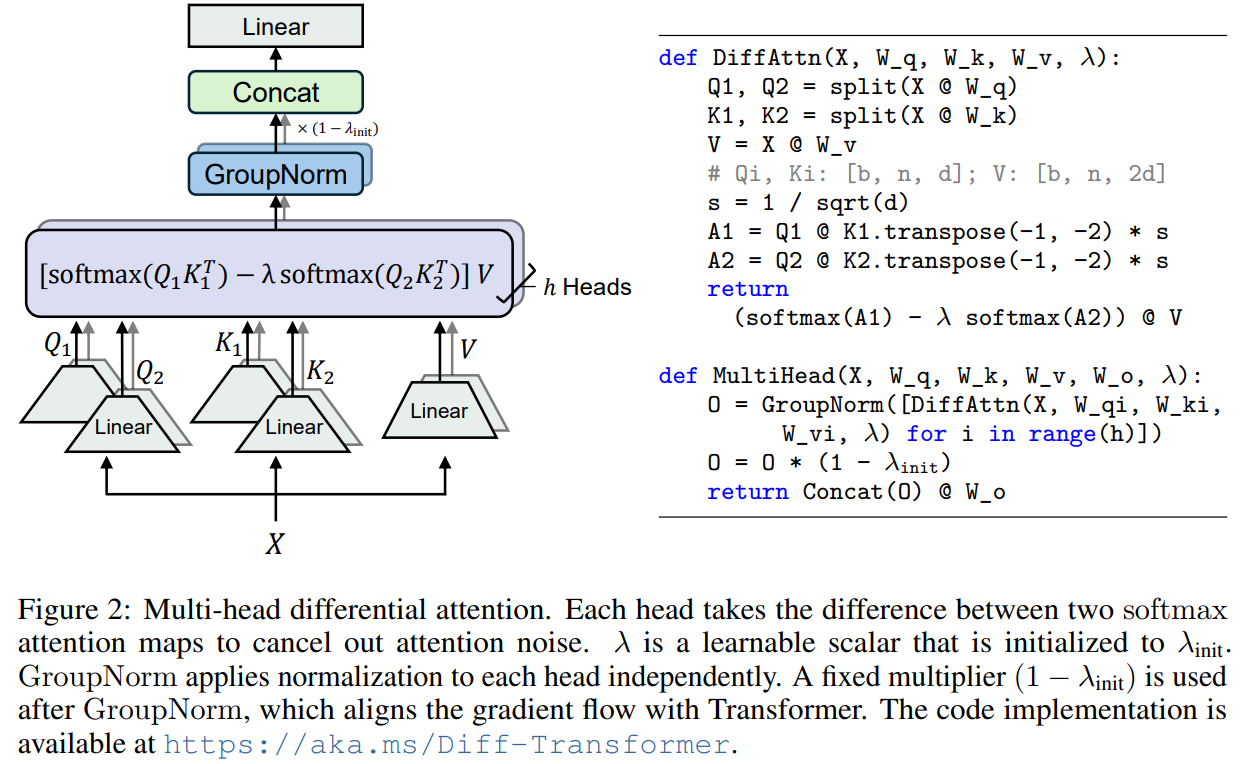
Differential Attention Mechanism을 설명하는 그림입니다.
여러 개의 헤드가 서로 다른 softmax attention map 간의 차이를 계산하여 attention noise를 상쇄시킵니다.
- 두 쿼리와 키를 이용하여
- λ는 학습 가능한 값으로 두 attention map의 차이를 조정하는데 사용
- 1 - 는 초기 람다 값을 조정하는 값
Input Projection: 입력 을 통해 쿼리, 키, 값 벡터를 각각 로 투영합니다.
아래의 조건을 만족합니다
각각의 행렬은 와 곱해져 쿼리, 키, 값 벡터를 생성합니다.
공식:
Diffrential attention operator:두 개의 소프트맥스 함수의 차이를 계산하여 노이즈를 제거합니다.
Re-parameterize the scalar λ: 동적 학습을 지원하기 위해 다음과 같이 람다의 파라미터는 조정됩니다.
여기서 는 학습 가능한 벡터이고, 는 초기화 상수입니다
가장 중요한 점은 두 소프트맥스의 차이를 이용하여 노이즈를 제거하는 점입니다.
해당 매커니즘은 다중 레이어 모델에서 성능이 robust하며 다양한 초기화 전략에서도 성능이 일관되게 나타납니다.
Multi-Head Differential Attention
각 attention head인 에 대해 서로 다른 프로젝션 행렬 를 사용합니다. 이 projection matrix는 입력 를 쿼리, 키 값 벡터로 변환합니다.
여기서 는 attention head의 개수를 나타내며 각 head마다 독립적인 projection이 수행됩니다.
정규화
각 헤드의 출력을 다음과 같이 계산합니다:
여기서 는 동일 레이어의 모든 헤드에서 공유되며, 이는 각 헤드에서 동일한 노이즈 제거 전략이 적용됨을 의미합니다.
정규화
각 헤드는 RMSNorm을 사용하여 정규화되며, 고정된 스케일러 를 곱해줍니다:
여기서 는 RMSNorm을 의미하며 각 헤드의 출력을 정규화하는 역할을 합니다.
최종 결합
각 헤드의 출력을 채널 차원에서 결합하여 최종 출력을 만듭니다:
여기서 는 학습 가능한 프로젝션 행렬로 결합된 헤드 출력을 최종적으로 변환하는 역할을 합니다.
Overall Architecture
총 L개의 레이어로 구성되어 있으며 각 레이어는 Multi-Head Differential Attention 모듈과 피드포워드 네트워크 모듈을 포함합니다.
Experiments
3B 크기의 DIFF Transformer 모델을 1T 토큰으로 학습시키고,다양한 다운스트림 작업에서 기존의 Transformer 모델과 비교합니다.
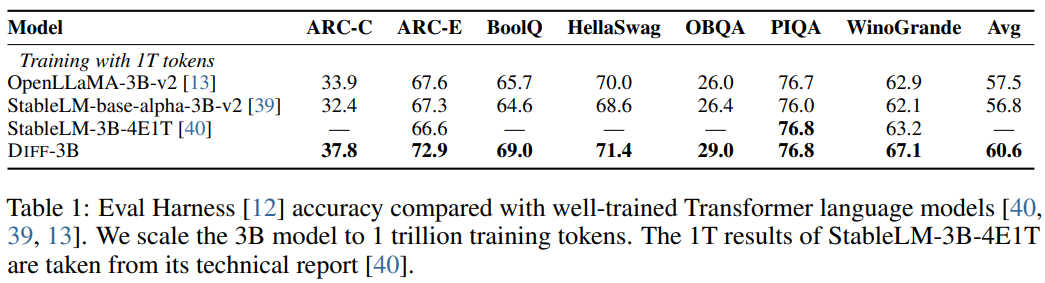
1T 토큰으로 동일한 학습을 진행하였을 때 벤치마트 성능에서 DIFF Transformer 모델이 가장 성능이 좋은 것을 확인할 수 있습니다.
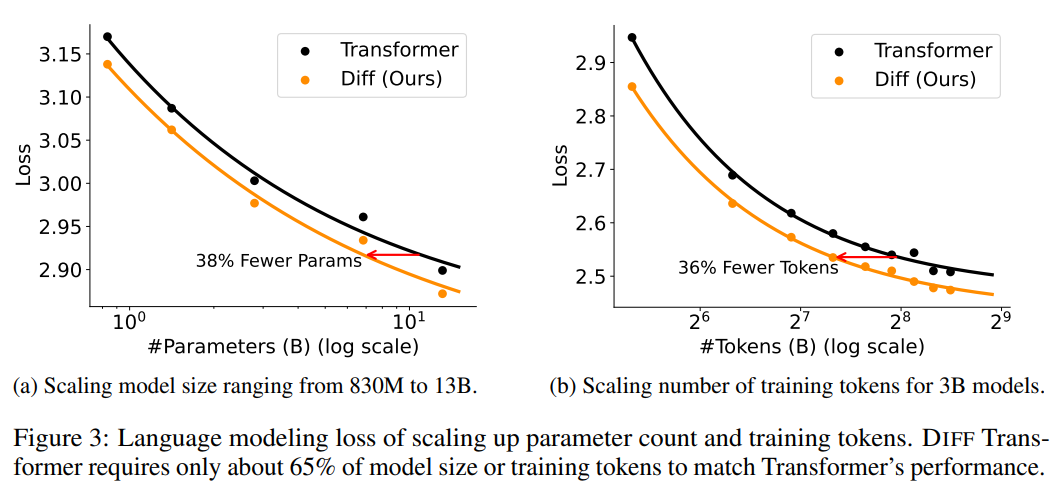
더 적은 파라미터, 토큰으로 학습이 더 빠르게 최적화 되는 것을 확인할 수 있습니다.
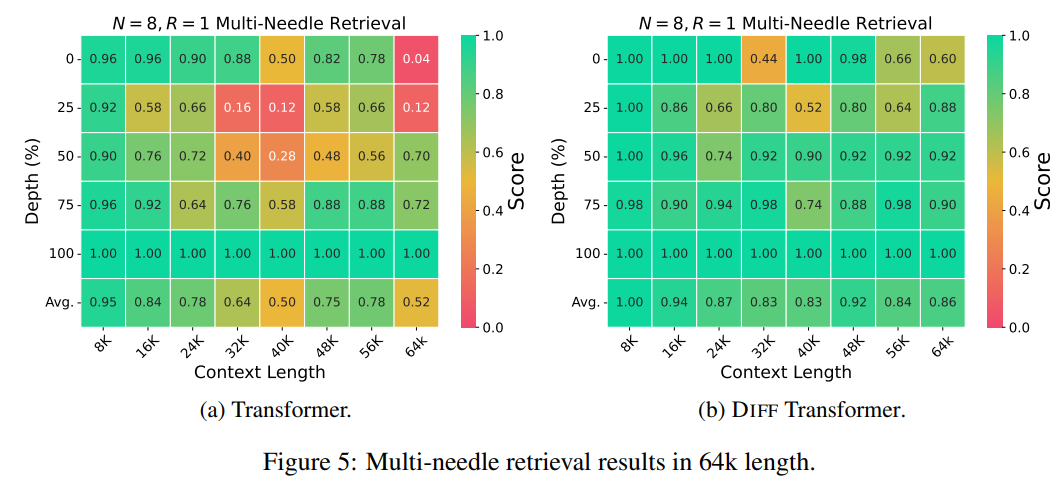
multi-needle 검색 task에서도 기존 테스크와 비교하여도 더 정확하게 원하는 정보를 검색하는 것을 확인할 수 있습니다.
Conclusion
Differential Transformer에 대한 소개하였습니다.
관련된 문맥에 대한 attention을 증폭시키면서 노이즈를 제거하는 역할을 제안하였습니다.
많은 실험 결과 DIFF Transformer는 기존 Transformer보다 높은 성능을 보여줍니다.
해당 결과는 attenstion noise를 줄이는 것이 중요함을 확인할 수 있습니다.