감상평
- 아키텍쳐는 사실 새로운 게 있지 않다.
- 데이터를 직접 모으고 공개하는 점에서 굉장히 많은 고민이 있었을 것으로 예상된다.
- 인간을 이용하여 고품질 데이터셋을 구하는 것은 굉장히 귀찮은 일
- 이러한 상황에서 최대한의 인간 검수 데이터를 음성을 이용하여 직접 수집한 점이 대단하다.
- VLM은 여전히 다양한 문제가 존재하고 인간은 항상 예상하지 못한 질문과 자신이 원하는 대답의 종류과 굉장히 다양하다
Abstract
가장 성능이 좋은 멀티모달들은 대부분 독점적으로 운영되고 있습니다.
성능이 좋은 오픈 소스 멀티모달은 대부분 독점적으로 운영되고 있는 VLM에서 생성된 합성 데이터에 크게 의존하하고 있습니다.
그 결과 성능 좋은 VLM을 처음부터 구축하는 방버에 대한 기본적인 지식을 놓치고 있습니다.
molo라는 새로운 VLM 패밀리를 소개하며 이는 오픈 소스 모델 중 가장 좋은 성능을 자랑합니다.
핵심 컨셉은 사람 평가자들이 음성 기반 설명을 수집하여 매우 세미한 이미지 캡션 데이터 셋을 구축했다는 것입니다.
추가로 다양한 사용자와 상호작용을 가능하기 위해 질의응답과 2D 포인팅 데이터를 포함한 다양한 데이터셋 믹스를 파인튜닝에 사용했습니다.
좋은 성능을 보이는 이유는 모델 아키텍처의 신중한 선택, 잘 조정된 학습 파이프라인, 새롭게 수집된 데이터셋 품질 때문입니다.
Introduction
LLM의 확장은 포괄적은 이미지 생성 및 복잡한 시각적 질문에 대한 정확한 답변과 같은 인상적인 멀티모달 기능을 제공하게 되었습니다.
하지만 VLM중 가장 성능이 뛰어난 모델들은 여점히 독점적이며 가중치, 데이터, 코드가 공개되지 않고 있습니다.
VLM의 발전을 위해 많은 연구가 오픈 소스 VLM을 재현하려는 노력을 기울여 왔습니다.
LLaVA는 오픈 소스로 모델을 공개했지만 최첨단 기술에서는 크게 뒤처지고 있습니다.
최근에는 고성능의 VLM이 공개되고 있지만 모든 데이터를 공개하지 않는 경향이 있습니다.
이는 학습 데이터가 독점적일 수 있으며, 데이터가 공개된 경우에도 독점 시스템이 생성한 합성 데이터를 사용하는 경향이 있습니다.
예를 들어 GPT-4V를 사용해 상세한 이미지 캡션을 대량으로 생성하는 ShareGPT4V와 같은 데이터셋을 사용하여 모델을 학습합니다.
이러한 방식을 사용하며 모델을 만드는 것은 사실 독점 VLM을 학습을 증류한 것에 불과하며, 성능 좋은 VLM을 처음부터 구축하는 방법에 대한 기초적인 지식은 여전히 부족한 상태입니다.
본 논문에 Molomo 패밀리를 소개하며 이는 최첨한 오픈 VLM으로 독점 VLM을 포함한 다른 VLM의 합성 데이터에 의존하지 않고 모델 가중치와 비전-언어 학습 데이터를 모두 공개했습니다.
독립적인 사전 학습된 off-the-shelf vision encoder와 언어 모델을 단순한 학습 파이프라인을 통해 달성되었으며 이를 통해 세밀하고 높은 품질의 밀도 높은 이미지 설명 데이터셋을 새롭게 수집하여 캡션을 생성하는 VLM을 공동 학습했습니다.
공동 학습 이우 표준 방식에 따라 supervised 학습을 통해 instuct를 따르는 모델을 만들었습니다.
다른 VLM과 달리 해당 방식은 다양한 부분을 frozen하는 여러 단계의 사전 학습을 피하고 더 많은 이미지-텍스트 데이터를 사용하는 방식을 배제했습니다.
우리의 접근 방식이 성공한 이유는 모델 아키텍처 세부 사항에 대한 신중한 선택, 잘 조정된 학습 파이프라인, 그리고 가장 중요한 요소인 PixMo(픽셀로 만든 Molmo)라고 이름 붙인 새로운 데이터셋의 품질 덕분입니다.
사람을 이용하여 좋은 캡션 데이터셋을 수집하는 것은 어려운 과제입니다.
이미지 설명을 요청하며 대부분 몇 가지 핵심적인 시각 요소만 언급하는 결과가 나옵니다.
최소 단어 수를 요구하면 평가자들이 데이터를 입력하는데 너무 오래 거리거나, 독점 VLM의 결과를 복사-붙여넣기 하는 경우가 발생해 증류된 결과를 피하려는 목적과 맞지 않습니다.
이러한 문제점을 해결하기 위해 평가자들에게 설명을 작성하는 대신에 60-90초 동안 음성으로 이미지에 대해 설명하도록 요청했습니다.
평가자들에게 모든 시각적 요소, 공간적 위치 및 관계에 대한 설명을 포함하여 자세히 묘사하도록 유도했습니다.
이러한 방식이 평가자들이 더 적은 시간 안에 더 상세한 설명을 제공함을 확인했으며 각 설명에 대한 오디오 기록을 수집 분석하여 VLM에 사용되지 않음을 확인했습니다.
Architecture
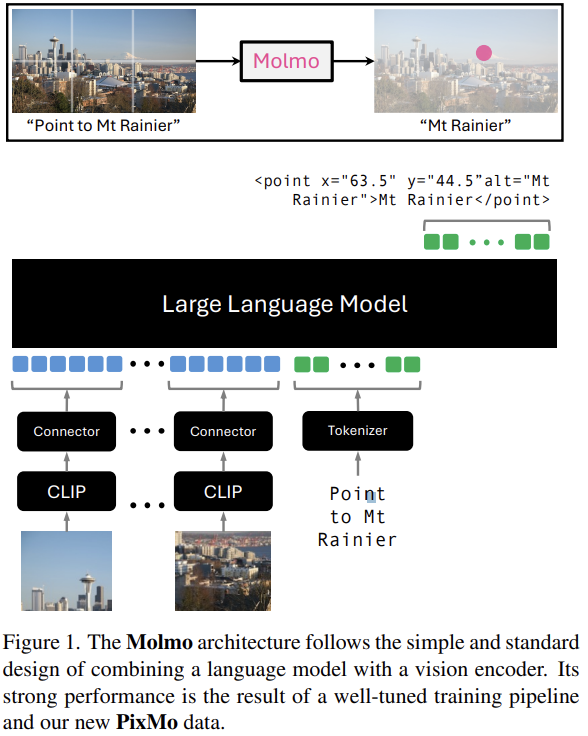
본 모델 아키텍쳐는 그림 1의 구조를 따릅니다.
LLM과 Vision encoder를 결합한 간단하고 표준 설계를 따릅니다.
총 4가지의 구성 요소로 이루어져 있습니다.
- 입력 이미지를 multi-scale 및 multi-crop 이미지 세트로 변환하는 모듈
- 해당 이미지들을 각각 독립적인 vision token으로 맵핑하는 ViT vision encoder
- vision token을 언어 모델의 입력 차원에 맞게 MLP를 사용해 projection하고 토큰 수를 줄이기 위해 pooling conect
- LLM
해당 구조를 이용하여 모델 패밀리를 구축합니다.
학습 데이터와 방법은 모든 모델에 동일하게 적용되며 vision encoder의 경우 공개된 모델인 OpenAI의 ViT-L/14 336px CLIP을 사용합니다.
LLM의 경우 다양한 모델을 선택지를 제공합니다.
OLMo-7B-1024, OLMoE-1B-7B, Qwen2 7B 등등
Data and Training
1단계: 캡션 생성
비전 인코더와 LLM을 무작위로 초기화한 커넥터와 결합한 후 캡션 생성 작업을 위해 모든 모델 파라미터를 학습합니다.
PixMo-Cap 학습 데이터를 다음과 같이 수집했습니다.
먼저 약 70개의 high-level topics(예: 도로 표지판, 밈, 음식, 그림, 웹사이트, 흐릿한 사진 등)를 기준으로 웹에서 이미지를 수집했습니다.
각 이미지에 대해 세 명의 평가자에게 최소 60초 동안 음성으로 이미지를 자세히 설명하도록 요청했습니다(수집 후반부에는 이 시간을 90초로 늘리고 한 명의 평가자만 사용했으며, 이는 효율성을 높이면서도 품질을 유지할 수 있었습니다).
평가자들에게는 설명 중 답해야 할 간단한 질문 목록이 제공되었습니다:
- 이미지를 처음 봤을 때의 인상은 무엇인가?
- 물체는 무엇이며, 그 개수는 몇 개인가?
- 텍스트는 무엇을 말하고 있는가?
- 물체들의 위치는 어디인가?
- 눈에 띄는 미세한 디테일은 무엇인가?
- 배경에는 무엇이 있는가?
- 스타일과 색상은 무엇인가?
평가자들의 음성은 오프더쉘프 음성-텍스트 변환 시스템으로 전사되었으며 전사된 텍스트는 언어 모델(LLM)을 사용해 텍스트 품질을 개선했습니다
원본 전사본을 요약하여 하나의 설명으로 만드는 작업도 언어 모델에게 맡겼습니다.
학습 과정에서 이러한 LLM으로 처리된 네 가지 이미지 설명을 모두 사용할 수 있을 때 활용하며, 이는 자연스러운 데이터 증강의 한 형태로 작동합니다.
총 712,000개의 고유한 이미지와 약 1.3M개의 캡션(증강 데이터 포함)을 학습했습니다.
Supervised fine-tuning.
캡션 생성을 위한 학습 후, 모든 모델 파라미터를 감독 학습 데이터 mixture
of supervised training data를 사용해 미세 조정했습니다.
mixture of supervised training data는 기존의 데이터셋과 새로운 PixMo 데이터셋을 포함합니다.
- PixMo-AskModelAnything: 실제 환경에서 사용자가 모델에게 할 수 있는 다양한 질문에 답변할 수 있도록 설계된 데이터입니다. 이미지를 선택한 후 그에 대해 질문을 작성한 평가자들이, 1단계 모델이 생성한 밀도 높은 캡션과 비VLM OCR 모델에서 얻은 텍스트 출력, 질문을 언어 모델에게 전달하면, LLM이 이미지를 보지 않은 상태에서 답변을 제공합니다. 답변이 부적절하면 평가자가 문제점을 지적하고 다시 수정 요청을 합니다. 이 데이터셋에는 162,000개의 질문-답변 쌍과 73,000개의 이미지가 포함되어 있습니다.
- PixMo-Points: 이 데이터는 (1) 텍스트로 설명된 대상을 가리킬 수 있고, (2) 카운팅할 수 있으며, (3) 질문에 답변할 때 시각적 설명으로 포인팅을 사용할 수 있도록 설계되었습니다. 평가자들은 이미지를 가리키며 설명을 작성하고, 이미지 내 모든 해당 항목을 가리켰습니다. 이 데이터는 총 2.3M의 질문-포인팅 쌍을 428,000개 이미지에서 수집했습니다.
- PixMo-CapQA: 이미지의 실제 캡션을 바탕으로 언어 모델이 질문을 생성하고 답변하도록 하여 추가적인 214,000개의 질문-답변 쌍을 165,000개 이미지에서 생성했습니다.
- PixMo-Docs: 255,000개의 텍스트 및 도표 중심 이미지를 대상으로 LLM이 코드를 생성하고, 이를 바탕으로 2.3M개의 질문-답변 쌍을 생성했습니다.
- PixMo-Clocks: 50종의 시계와 160,000개의 시계판 스타일을 포함한 합성 아날로그 시계 데이터셋으로, 약 826,000개의 예시를 수집했습니다.
- 학술 데이터셋: VQA v2 train, TextVQA train, OK-VQA train, ChartQA train, DocVQA train, InfographicVQA train, AI2D train, A-OKVQA train, AndroidControl train, ScienceQA train, TabMWP train, ST-VQA train, TallyQA train, DVQA train, FigureQA train, PlotQA train.
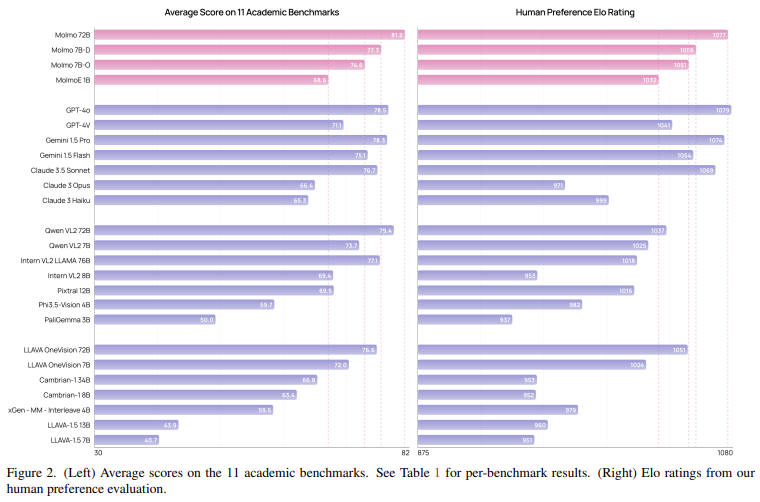
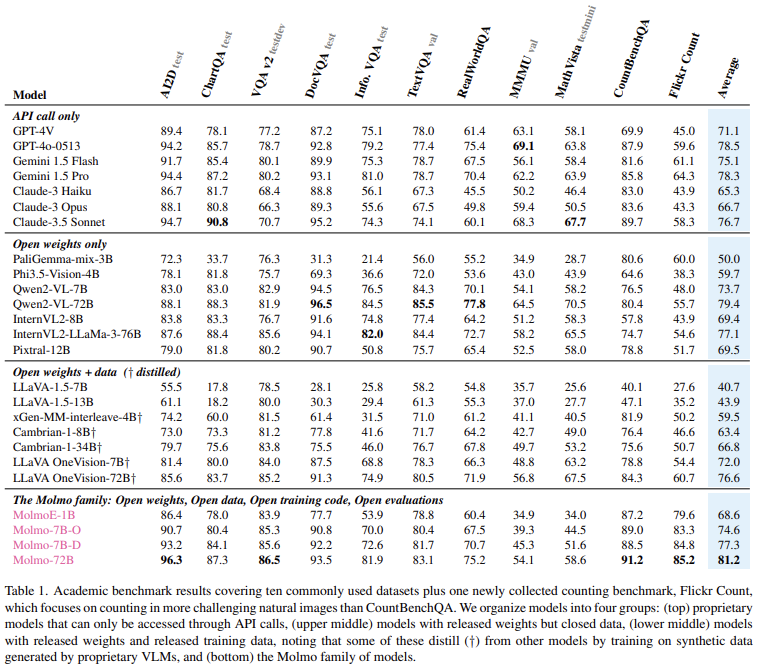
결과적으로는 우수한 성능을 보이는 것을 확인할 수 있습니다.