들어가면 실행방법 코드가 있다. 다운로드 받는 링크도 직접들어가보니 약 2.3기가 정도되는 data를 주고있는데 그냥 저대로 돌리면 다운로드 진행 상황을 모른채로 다운하고있는게 너무 답답해서 코드를 살짝 수정했다.
그냥 python 내부에있는 tqdm을 사용해 그냥 볼수있게 한거다.
import os
import numpy as np
from torch.utils.data import DataLoader
from requests import get
import zipfile
from tqdm import tqdm

url = "https://cirrus.universite-paris-saclay.fr/s/MwrixnSRYykEPNW/download"
download_dir = "/data/project/#########/AttOmics"


def download_file(url, save_path):
    with get(url, stream=True) as r:
        r.raise_for_status()
        file_size = int(r.headers.get('Content-Length', 0))
        progress_bar = tqdm(total=file_size, unit='B', unit_scale=True, desc=save_path)
        with open(save_path, "wb") as f:
            for chunk in r.iter_content(chunk_size=8192):
                f.write(chunk)
                progress_bar.update(len(chunk))
        progress_bar.close()


download_file(url, os.path.join(download_dir, "data.zip"))


with zipfile.ZipFile(os.path.join(download_dir, "data.zip"), "r") as zfile:
    zfile.extractall(download_dir)

print("File loaded")


X = np.load("AttOmics_DATA/rnaseq_train.npy")
print("x loaded")
Y = np.load("AttOmics_DATA/label_train.npy")
print("y loaded")

# create dataset
dataset = OmicsDataset(omics=X, label=Y)

# create dataloader
train_loader = DataLoader(dataset, batch_size=256, shuffle=True, drop_last=True)
print("train data loaded")
일단은 혹시몰라 그냥 크롬에다가 다운받는 것도 해놓은 상태인데 아래와 같이 다운로드 경과가 지나고 있다
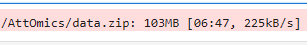
사이버 덕도 확인해보니 제대로 원하는 디렉토리에 다운받고있는게 확인되었다.

근데 이제서야 100MB이면 2GB 다운받는게 얼마나 걸릴지 가늠이 안간다... 일단 켜놓고 다른것들을 진행하면서 해봐야될듯 싶음
다운을 받고 gene_ontology_grouping 전략을 사용하는 방식으로 하려고 그랬지만 go_graph_annotation.json이라는 파일이 없다길래 코드를 확인해보았다.
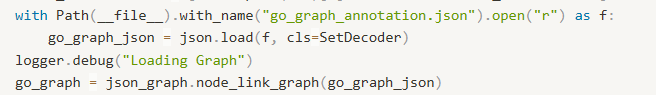
논문에서 올려준 사이트에는 관련 JSON이 하나도 없는데 이걸 어떻게 해야될지 몰라서 교수님에게 다시 상의했었고 slack에 언급해달라하셔서 메세지를 보내보았다.
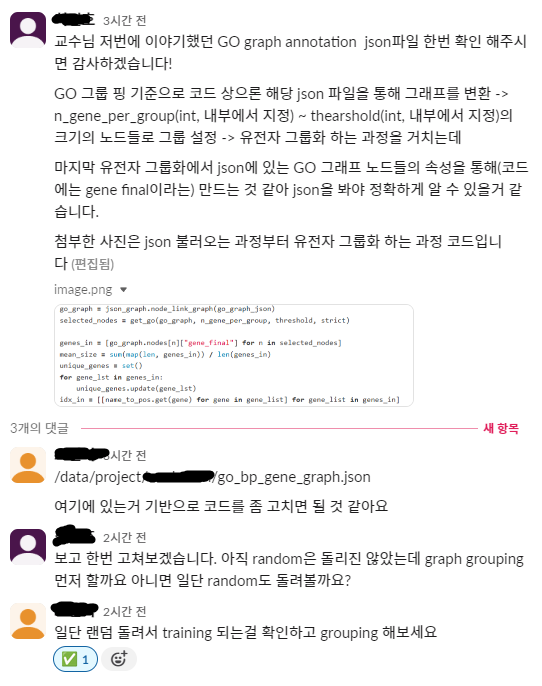
일단 다른학부연구생의 파일에 있는거 같다고 하셨고 전에 상의를 할때 일단 먼저 random으로 돌리는 방식을 적용해보기로했는데.....
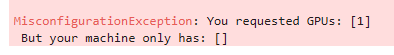
? 이런 오류가 뜨길래 뭔가 싶었다. 분명히 서버에서 nvidia-smi 명령어로는 제대로 뜨는데... 다시 torch로 확인해봤는데
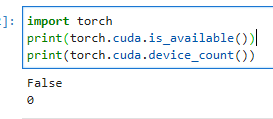
어라....... 왜 인식을 못하는 거지.....
인간입니다. 다만 컴공을 전공하고있는...