안녕하세요, 미니지식공간입니다.
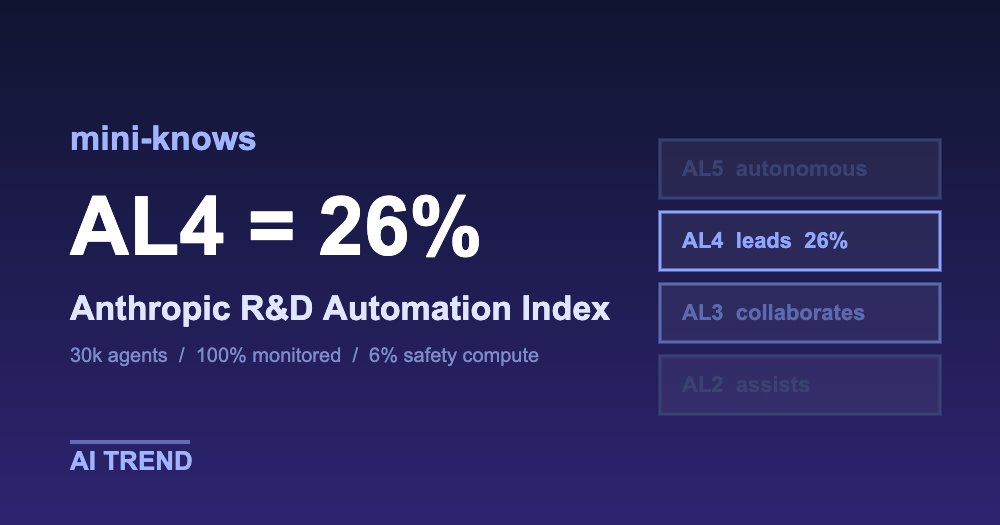
Anthropic R&D Automation Index가 2026년 9월 17일 공개되면서, Claude가 앤스로픽 사내 AI R&D 업무의 26%를 "주도(leads)"한다는 수치가 나왔다. 이번 글은 그 26%가 어떤 척도와 어떤 파이프라인에서 나온 값인지, 그리고 함께 공개된 에이전트 감독·컴퓨트 지표를 측정 구조 관점에서 정리한다.
TL;DR
- 앤스로픽이 2026-09-17 세 가지 지표를 공개했다: AI가 수행하는 AI R&D 비중, 에이전트 감독 수준, 컴퓨트 배분.
- 2026년 8월 기준 "AI 주도(AL4)" 26%, "AI 협업(AL3) 이상" 90% 초과, 완전 자율(AL5) 0.
- 감독 쪽 수치가 더 구체적이다. 동시 약 3만 에이전트, 행동 100% 모니터 통과, 10억 건 중 0.002% 차단.
- 전부 앤스로픽 자체 측정·자사 발표다. 판정도 앤스로픽 모델이 했고 독립 검증은 아직 없다.
1. 척도부터 보자 — Epoch AI의 AL0~AL5
이 인덱스의 핵심은 새로운 벤치마크가 아니라 자동화 수준(Automation Level, AL)이라는 6단계 서열 척도다. 앤스로픽은 Epoch AI가 제안한 척도를 그대로 채택했다고 밝혔다. 26%라는 숫자를 해석하려면 AL3과 AL4의 경계를 먼저 잡아야 한다.
아래는 발표문이 정의한 척도를 스니펫 형태로 정리한 것이다. 원문에는 API·SDK·엔드포인트가 전혀 없으므로 창작 코드 대신 문서의 정의와 파라미터를 그대로 옮겼다(출처: https://www.anthropic.com/institute/measuring-pace-of-ai-development).
# Automation Level scale (Epoch AI), as adopted in Anthropic disclosure
automation_levels:
  AL0: no AI involvement
  AL1: minimal AI involvement
  AL2: AI assists
  AL3: AI collaborates   # 사람의 밀착 지시 아래 큰 덩어리의 작업 수행
  AL4: AI leads          # 상위 수준 프롬프트 하나로 대부분을 end-to-end 처리, 사람은 감독
  AL5: AI is autonomous  # 사람이 루프에 전혀 없음 - 아직 도달한 영역 없음

snapshot:
  as_of: 2026-08
  share_at_AL4: 0.26
  share_at_or_above_AL3: ">0.90"
  share_at_AL5: 0
발표문이 든 예시가 경계를 잘 보여준다. 야간 데이터 파이프라인이 깨진 상황에서 AL3은 엔지니어가 로그를 들고 와 가설까지 제시한 뒤 Claude에게 작업을 맡기고, 새 문제가 나오면 Claude가 멈춰 사람의 판단을 기다리는 단계다. AL4는 실패 알림만 넘기면 Claude가 원인 추적·수정·테스트·재실행과 예상 밖 문제 처리까지 스스로 하고, 배포 직전에 사람을 태그하는 단계다. AL5는 사람이 문제를 알려주지도 않고 배포까지 맡기는 단계이며, 앤스로픽은 여기에 도달한 영역이 없다고 적었다.
2. 인덱스는 어떻게 만들어졌나
인덱스 구축에는 세 가지가 필요했다. 사내 AI R&D 업무의 전수 목록, 자동화 수준 판정 방법, 업무별 중요도 가중치다. 앤스로픽은 이 셋을 모두 Claude 에이전트와 자동 분류로 처리했다.
| 단계 | 방법 | 결과 |
|---|---|---|
| 업무 수집 | 2026년 7월 각 주마다 R&D 부서 인원의 20%를 무작위 표본, Claude 리서치 에이전트가 Slack·내부 문서로 주간 업무 정리 | 약 15,000개 세부 업무 |
| 구조화 | Claude가 업무를 계층 트리로 묶음. 이후 트리를 동결 | 542개 노드, 말단 378개 |
| 판정 | 노드별로 리서치 에이전트가 근거 수집 후 독립 Claude 저지가 AL0~AL5 부여. 해당 월 이전 근거만 열람 허용 | 노드별 AL 값 |
| 가중치 | 사람-시간을 중요도 대리 지표로 사용. 1인 1주 = 1, 그 주 맡은 업무 수로 균등 분할 | 노드별 가중치 |
| 검증 | 업무 영역 담당 직원이 근거를 모르는 상태로 별도 평가 | 모델-사람 완전 일치 59%, 사람-사람 35%, 1단계 이내 일치 97% |
사람-사람 완전 일치율이 35%밖에 안 된다는 대목이 눈에 띈다. 이 척도가 본질적으로 주관적이라는 뜻이며, 앤스로픽도 AI 협업이 끝나고 AI 주도가 시작되는 지점에 대한 이견은 실제로 남아 있다고 적었다. 모델 판정이 사람만큼은 일관됐다는 것이 이 검증의 주장이지, 판정이 정확하다는 증명은 아니다.
3. 감독 스택 — 온라인 모니터와 오프라인 모니터
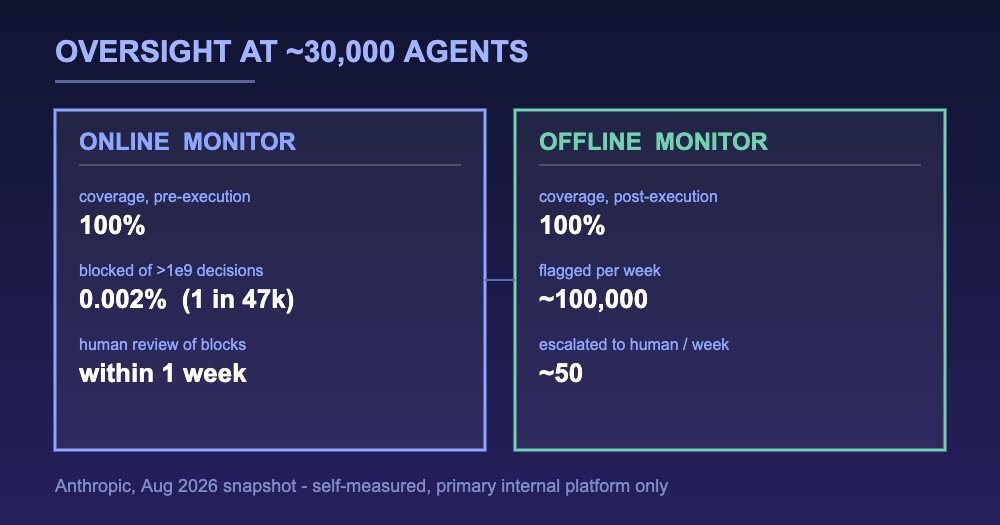
두 번째 지표는 에이전트 감독이다. 2026년 8월 기준 앤스로픽의 가장 많이 쓰이는 사내 플랫폼에는 동시에 약 30,000개의 에이전트가 연구·엔지니어링 작업을 하고 있었다. 감독 지표는 커버리지(모니터를 거치는 행동 비율), 검토 지연(행동과 검토 사이 시간), 에스컬레이션 비율(차단·플래그 비율) 세 가지로 정의됐다.
| 구분 | 온라인 모니터 | 오프라인 모니터 |
|---|---|---|
| 시점 | 실행 전 실시간 | 사후 기록 판독 |
| 목적 | 되돌릴 수 없는 즉각적 피해 차단(예: 모델 가중치 반출) | 서서히 드러나는 위험 탐지(예: 정렬 이상 징후) |
| 커버리지 | 행동의 100%가 실행 전 통과, 보통 수 초 이내 | 행동의 100%가 사후 수집 |
| 검토 지연 | 자동 검토는 실행 전, 차단 건에 대한 사람 검토는 1주 이내 | 주당 약 100,000건 플래그 후 분류기 필터, 최우선 약 50건/주가 사람 검토 |
| 에스컬레이션 | 2026년 8월 10억 건 이상 결정 중 0.002%(약 47,000건 중 1건) 차단 | 1,000건 중 1~2건 추가 검토 |
설계 쪽에서 참고할 만한 두 가지가 같이 공개됐다. 하나는 에이전트마다 개별 신원(identity)을 부여하고 그 에이전트가 만든 모든 데이터를 신원에 묶는 것이다. 신원이 모델에 종속되지 않아 모델을 교체해도 이력이 이어지고, 감사 시 행동을 에이전트 단위로 추적할 수 있다. 다른 하나는 에이전트 간 통신을 개별 대화가 아니라 공유·공개 메시징 시스템으로 돌리는 것이다. 모든 메시지가 발신 에이전트 신원에 묶이고 원본 참조를 링크하게 해서, 전언 게임처럼 정보가 변형되는 것을 막고 서로의 오류를 교정할 수 있게 했다.
4. 세 지표를 리포팅 스키마로 정리하면
앤스로픽은 다른 개발사도 오늘 당장 같은 값을 공개할 수 있다고 주장했다. 그 주장을 그대로 따라가면 공개해야 할 필드가 무엇인지 정리할 수 있다. 아래는 발표문이 정의한 지표·파라미터를 스키마 형태로 옮긴 것이며, 앤스로픽이 이런 스키마를 공식 배포한 것은 아니다.
# 발표문에 정의된 3개 지표를 리포팅 필드로 정리 (비공식 정리, 값은 Anthropic 공개 스냅숏)
ai_led_rd:
  scale: epoch_ai_automation_level   # AL0..AL5
  task_basket: frozen_tree           # 542 nodes / 378 leaves, frozen at 2026-07
  weighting: person_time_per_week
  judge: model_judge_with_human_spotcheck
  values:
    share_AL4_leads: 0.26
    share_AL3_or_above: ">0.90"
    share_AL5: 0

agent_oversight:
  scope: primary_internal_research_platform
  concurrent_agents: 30000
  online_monitor:
    coverage: 1.00                   # pre-execution
    human_review_sla: "<=7d for blocked actions"
    block_rate: 0.00002              # ~1 in 47,000 over >1e9 decisions (2026-08)
  offline_monitor:
    coverage: 1.00                   # post-execution ingest
    flagged_per_week: 100000
    escalated_to_human_per_week: 50
    flag_rate: "1-2 per 1000"

compute_allocation:
  window: 2026-07-13/2026-07-20
  safety_share_of_ai_rd_compute: 0.06
  safety_share_of_ai_driven_ai_rd_compute: 0.12
  note: conservative   # 안전·성능 동시 기여 작업은 안전으로 계상하지 않음
컴퓨트 지표에서 주의할 점이 하나 있다. 앤스로픽은 안전 연구가 원래 연산을 덜 쓰는 성격이라 컴퓨트가 안전 집중도의 불완전한 대리 지표라고 먼저 밝혔다. 게다가 안전 분류기를 더 효율적으로 만들면 안전 컴퓨트 비중은 오히려 떨어진다. 이 값은 절대 수치보다 같은 방법론으로 시점 간·회사 간 비교할 때 의미가 생긴다는 것이 회사 설명이다.
5. 측정을 신뢰하기 전 확인할 것
- 판정자 문제. 자사 모델로 자사 시스템을 평가한다. 저지 모델이 평가 대상 모델과 같은 종류의 오류를 낼 수 있다는 점을 앤스로픽도 명시했다.
- 바구니 동결. 트리가 2026년 7월 기준으로 고정돼 있어, 지수 상승은 그때 사람이 하던 일이 자동화되고 있다는 것만 말해준다. 앤스로픽은 2026년 1월 기준 트리로 교차 검증해 신규 업무 유형이 늘지 않았다고 밝혔지만, 주기적 재구축이 필요하다고 스스로 적었다.
- 라벨 신뢰도. 컴퓨트 분류에 쓰인 워크로드 태그 상당수가 자동 규칙이나 사용자 입력 기반 최선 추정값이며 검증된 값이 아니다.
- 단일 주 스냅숏. 컴퓨트 지표는 한 주 데이터라 추세를 말할 수 없다.
- 독립 검증 부재. 제3자 평가자 상주는 계획 단계다. 과거 METR이 오프라인 모니터링 플랫폼을 독립 레드팀한 사례는 있다.
자주 묻는 질문
Q. 26%면 Claude가 앤스로픽 연구의 4분의 1을 혼자 하는 건가?
아니다. AL4는 사람이 감독하되 상위 지시 하나로 대부분을 처리하는 단계이고, 배포 결정은 사람이 한다. 앤스로픽은 AL5(완전 자율)에 해당하는 측정 영역이 없다고 명시했다.
Q. 우리 회사도 같은 지표를 만들 수 있나?
개념적으로는 가능하다. 필요한 것은 업무 트리, AL 판정 기준, 사람-시간 가중치 세 가지이며 위 스키마가 그 필드 목록이다. 다만 앤스로픽도 공개 방법론과 제3자 검증이 없으면 랩 간 비교는 성립하지 않는다고 적었다.
Q. 에이전트 차단율 0.002%는 안전하다는 뜻인가?
그렇게 읽기는 어렵다. 앤스로픽은 개별 에이전트의 오작동이 드물더라도 수백만~수십억 규모에서는 드문 사건도 정기적으로 발생한다고 같은 글에서 밝혔다. 비율보다 절대 건수와 감독 커버리지를 같이 봐야 한다.
마무리
이번 공개의 값어치는 26%라는 헤드라인보다 무엇을 어떻게 재서 공개할 것인가의 형식이 처음 구체화된 데 있다. 척도·바구니·가중치·판정자를 명시했기 때문에 다음 공개분과 비교할 수 있고, 다른 랩이 따라온다면 대조도 가능해진다. 앤스로픽의 다른 투명성·표준화 시도로는 Claude 텍스트 워터마크 정리와 Model Hardware Standard 정리를 함께 보면 맥락이 이어진다.
출처
- Anthropic, "Measurements for understanding the pace of AI development inside frontier labs", 2026-09-17 — https://www.anthropic.com/institute/measuring-pace-of-ai-development
- AP (Durango Herald 게재), "Anthropic says its model Claude is helping to build the next version of itself", 2026-09-17 — https://www.durangoherald.com/articles/associated-press/anthropic-says-its-model-claude-is-helping-to-build-the-next-version-of-itself/
- Anthropic Newsroom — https://www.anthropic.com/news
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 본문의 모든 지표는 앤스로픽 자사 발표·자체 측정값이며 독립 검증된 값이 아닙니다.