안녕하세요, 미니지식공간입니다.
DeepSeek V4.1-Flash가 2026년 9월 10일 공개됐다. 모델 카드 부제가 "Pushing the Limits of KV Cache Compression"일 정도로 이번 릴리스의 축은 성능이 아니라 KV 캐시이고, 그 결과가 deepseek-flash라는 단일 모델명과 새 API 요금표로 그대로 내려왔다. 아키텍처가 단가를 어떻게 끌어내렸는지, 그리고 기존 코드에서 뭘 바꿔야 하는지를 공식 문서 기준으로 정리한다.
먼저 결론
- 40레이어를 20층 인코더 + 20층 디코더로 쪼갠 Causal Encoder-Decoder 구조로, 프리필 8B / 디코드 16B 활성 파라미터.
- 전역 KV 캐시 토큰당 890바이트 — V4-Flash의 약 1/4, V1의 약 1/437(자사 발표).
- API 모델명은
deepseek-flash하나. 2026-09-14 04:00 UTC부터deepseek-v4-pro요청도 여기로 라우팅된다.
1. 릴리스 개요
| 항목 | 값 |
|---|---|
| 공개일 | 2026-09-10 (DeepSeek 공식 릴리스 노트) |
| 모델 | DeepSeek-V4.1-Flash, 멀티모달 MoE |
| 백본 파라미터 | 552B (+ Engram 조건부 메모리 196B) |
| 활성 파라미터 | 프리필 8B / 디코드 16B |
| MoE 구성 | shared expert 1 + routed expert 384, 토큰당 routed 6개 활성 |
| 컨텍스트 / 최대 출력 | 1M 토큰 / 384K |
| 라이선스 | MIT (Hugging Face 가중치 공개) |
| API 모델명 | deepseek-flash |
사전학습은 멀티모달 45T 토큰 규모이고, 희소 어텐션을 64K 시퀀스 길이에서 처음부터 학습한 뒤 34T 토큰 지점에서 컨텍스트를 1M으로 확장했다. 사후학습은 SFT → RL → on-policy distillation 순서로, 알고리즘 변경 없이 에이전트 과제·환경의 대규모 자동 합성으로 데이터 파이프라인만 바꿨다는 것이 모델 카드 설명이다.
2. CED — 프리필을 절반으로 줄이는 방법
Causal Encoder-Decoder(CED)의 아이디어는 단순하다. 디코더 각 레이어가 자기 은닉 상태에서 전역 KV를 만드는 대신, 인코더의 마지막 은닉 상태에서 레이어별 투영 가중치로 뽑아 쓴다. 프롬프트 토큰은 인코더 20층까지만 통과하면 되므로 프리필 계산량이 사실상 절반이 된다. 입력이 압도적으로 긴 에이전트 워크로드에서 이 구조가 유리한 이유다.
문제는 슬라이딩 윈도우 어텐션(SWA)이다. SWA는 모든 레이어에서 돌아가므로 디코더 쪽 SWA 상태가 빈다. DeepSeek은 이를 Decoder SWA Bounded Replay로 처리한다. 최근 n_win개 토큰만 다시 흘려보내 SWA KV를 재구성하는 방식이고, 덕분에 SWA KV를 SSD에 영구 저장할 필요가 사라진다. 모델 카드 기준 이 조치로 영구 KV 캐시 크기가 V4-Flash의 약 1/8까지 내려갔다.
3. CSA2와 FP4 KV 캐시
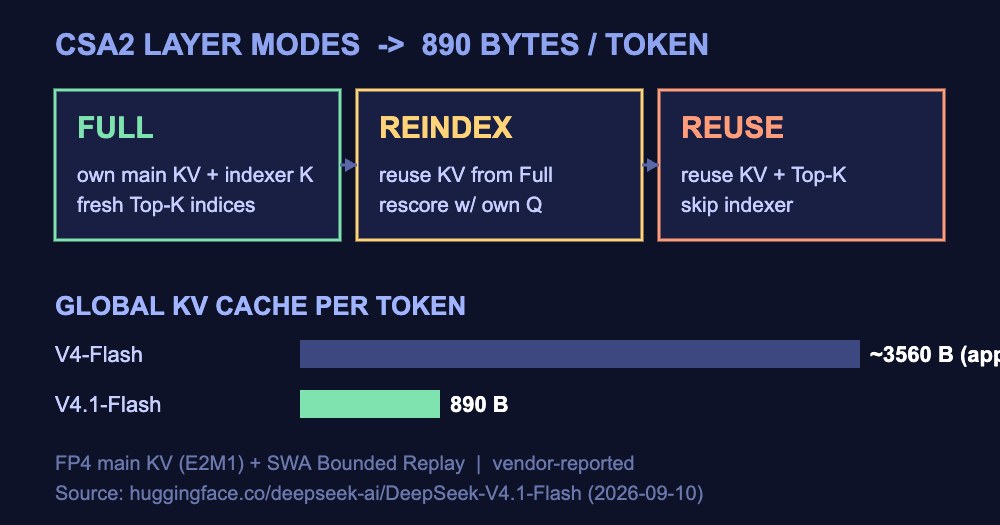
CSA2(Compressed Sparse Attention 2)는 레이어 축에서 캐시를 줄인다. 각 어텐션 레이어에 세 가지 정적 모드 중 하나를 배정한다.
- Full — 자기 main KV를 계산하고 indexer K를 뽑아 Top-K 인덱스를 새로 고른다.
- Reindex — 직전 Full 레이어의 main KV와 indexer K를 재사용하되, 자기 indexer Q로 다시 점수를 매긴다.
- Reuse — main KV와 최신 Top-K 인덱스를 모두 재사용하고 indexer 자체를 건너뛴다.
디코더에는 계층적 희소 인덱서(Hierarchical Sparse Indexer)가 추가로 붙는다. 첫 Full 모드 레이어가 후보 풀을 만들어 두면 이후 인덱싱 레이어는 그 안에서만 점수를 매기므로, 컨텍스트 길이와 무관하게 인덱서 비용의 상한이 잡힌다.
여기에 main KV를 FP4로 양자화한다. E2M1 포맷에 16채널마다 E4M3 스케일 하나를 두는 방식이고, 사후학습 단계의 양자화 인식 학습(QAT)으로 도입됐다. 이 조합의 결과가 토큰당 890바이트다.
4. 벤치마크를 읽을 때
아래는 모델 카드에 실린 값으로 전부 자사 발표다. 최대 추론 강도, temperature=1.0, top_p=0.95 조건이며 코드 에이전트 과제는 DeepSeek Harness Minimal 등 특정 스캐폴드 위에서 측정됐다. 순수 모델 점수가 아니라 "모델 + 하네스" 조합의 점수라는 점을 감안해야 한다.
| 벤치마크 | V4.1-Flash | V4-Flash | Opus-5.0 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 82.7 | 89.1 | 88.8 |
| DeepSWE v1.1 | 74.2 | 54.4 | 74.0 | 73.0 |
| Terminal-Bench 4.0 | 31.2 | 7.0 | 51.8 | 39.9 |
| AutomationBench | 54.8 | 37.7 | 50.3 | 45.8 |
| GPQA Diamond | 90.9 | 89.9 | 93.4 | 94.1 |
| Codeforces (Rating) | 3471 | 3289 | — | — |
흥미로운 부분은 스캐폴드별 편차다. 같은 모델로 DeepSWE v1.1을 돌렸을 때 mini-SWE 74.2, Claude Code 69.8, Codex 65.6, OpenCode 65.5로 8점 이상 벌어진다. 모델을 바꾸기 전에 하네스를 바꾸는 편이 나은 경우가 실제로 존재한다는 뜻이다.
5. API 마이그레이션
가장 중요한 변경은 모델명이다. 공식 문서 기준 deepseek-v4-flash와 deepseek-v4-flash-vision-exp는 은퇴했고, 호환을 위해 계속 받아들여지되 요청은 V4.1-Flash가 처리하고 Flash 단가로 과금된다. deepseek-v4-pro는 2026-09-14 04:00 UTC(베이징 12:00)부터 V4.1-Flash로 라우팅되며, V4.1-Pro 출시 전까지 이 상태가 유지된다.
기본 호출은 OpenAI 호환 포맷 그대로다. 아래는 공식 문서 Your First API Call의 cURL 예제에서 모델명만 deepseek-flash로 바꾼 것이다.
출처: https://api-docs.deepseek.com/
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -d '{
        "model": "deepseek-flash",
        "messages": [
          {"role": "system", "content": "You are a helpful assistant."},
          {"role": "user", "content": "Hello!"}
        ],
        "thinking": {"type": "enabled"},
        "reasoning_effort": "high",
        "stream": false
      }'
thinking 모드는 기본 활성이고 기본 강도는 high다. OpenAI SDK로 Chat Completions를 쓸 때 thinking 파라미터는 extra_body로 넘겨야 한다. 아래는 공식 Thinking Mode 가이드의 예제다.
출처: https://api-docs.deepseek.com/guides/thinking_mode
from openai import OpenAI
client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")

messages = [{"role": "user", "content": "9.11 and 9.8, which is greater?"}]
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=messages,
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}},
)

reasoning_content = response.choices[0].message.reasoning_content
content = response.choices[0].message.content
추론 강도는 OpenAI 포맷에서 reasoning_effort로 low / high / max를 받는다. 공식 문서의 매핑 표에 따르면 minimal·low는 low로, medium·high·xhigh는 high로, max·ultra는 max로 접힌다. 한편 모델 카드에는 1~100의 연속 추론 강도를 지원한다고 적혀 있는데, 공개 API에서는 이 세 단계로 노출되는 것으로 보인다. 연속 값을 직접 넣는 경로는 확인 필요다.
주의할 점이 하나 더 있다. thinking 모드에서는 temperature, presence_penalty, frequency_penalty가 무시된다. 에러가 나지 않고 조용히 무시되므로, 이 값들로 출력 다양성을 제어하던 코드는 동작이 달라진다. top_p는 thinking 모드에서 하한이 0.95이고, 비-thinking 모드에서는 1.0으로 고정된다.
도구 호출을 쓴다면 reasoning_content 처리 규칙이 갈린다. tools 파라미터가 있는 요청에서는 이전 턴의 reasoning_content를 전부 되돌려 보내야 하고, 누락하면 API가 400을 돌려준다. tools가 없으면 되돌려 보낼 필요가 없고 보내도 무시된다.
# tools 사용 시: assistant 메시지를 통째로 append 해야 reasoning_content가 함께 전달된다
messages.append(response.choices[0].message)
자체 호스팅 경로도 열려 있다. 허깅페이스 모델 카드에 vLLM / SGLang / Transformers 예시가 함께 실려 있고, 권장 샘플링 값은 temperature=1.0, top_p=0.95 또는 1.0, max_tokens ≥ 256K다.
출처: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
pip install vllm
vllm serve "deepseek-ai/DeepSeek-V4.1-Flash"
6. 과금 설계에서 놓치기 쉬운 것
공식 가격 페이지(2026-09-10 확인) 기준 100만 토큰당 단가는 아래와 같다. 새 요금은 2026-09-10 04:00 UTC부터 적용됐다.
| 구분 | deepseek-flash (오프피크/피크) | deepseek-v4-pro (오프피크/피크) |
|---|---|---|
| 입력 · 캐시 히트 | $0.003 / $0.006 | $0.022 / $0.044 |
| 입력 · 캐시 미스 | $0.15 / $0.3 | $0.66 / $1.32 |
| 출력 | $0.6 / $1.2 | $1.98 / $3.96 |
| 동시 요청 한도 | 2,500 | 500 |
설계할 때 걸리는 지점은 세 가지다. 첫째, 피크 시간이 UTC 월~금 01:00~04:00, 06:00~10:00이라 한국시간으로는 평일 10~13시, 15~19시가 그대로 피크다. 국내 업무시간 트래픽은 기본적으로 피크 단가로 잡아야 한다. 둘째, 캐시 히트와 미스의 단가 차이가 50배라 프리픽스 재사용률이 사실상 비용을 결정한다. 시스템 프롬프트와 공통 컨텍스트를 요청 앞쪽에 고정하는 정도의 설계만으로도 차이가 크다. 셋째, thinking 모드가 기본 활성이고 기본 강도가 high라, 별도 설정 없이 쓰면 사고 토큰이 계속 붙는다. 단순 분류·추출 작업은 {"thinking": {"type": "disabled"}}로 끄거나 low로 낮추는 편이 낫다.
자주 묻는 질문
Q. deepseek-v4-pro를 계속 호출하면 어떻게 되나?
2026-09-14 04:00 UTC부터 요청이 V4.1-Flash로 라우팅되고 Flash 단가로 청구된다. 호출은 실패하지 않지만 응답을 만드는 모델이 실제로 바뀌므로, 출력 포맷이나 도구 호출 동작에 의존하는 코드는 전환 전에 회귀 테스트를 돌려 두는 것이 안전하다.
Q. reasoning_effort를 1~100 숫자로 넣을 수 있나?
모델 카드에는 1~100 연속 제어가 언급돼 있지만, 공개 API 문서는 low / high / max 세 단계와 그 매핑만 명시한다. 숫자 값을 그대로 받는지는 공식 문서에 없어 확인 필요다. 현재는 문자열 세 단계를 쓰는 것이 안전하다.
Q. KV 캐시가 줄면 내 요금도 그만큼 줄어드나?
직접 연동되지는 않는다. 캐시 압축은 DeepSeek 쪽 서빙 비용을 줄이는 요인이고, 그중 일부가 이번 단가 인하로 반영된 것이다. 사용자 입장에서 체감 비용을 좌우하는 건 캐시 히트율, 피크·오프피크 시간대, thinking 토큰 소비량 쪽이다.
마무리
이번 릴리스는 "더 큰 모델"이 아니라 "같은 품질을 더 싸게 서빙하는 구조"에 가깝다. CED로 프리필을 반으로 줄이고, CSA2와 FP4로 캐시를 4분의 1로 압축한 결과가 단가와 모델 라인업 단순화로 이어졌다. 실무에서는 9월 14일 라우팅 전환 전에 모델명 점검과 회귀 테스트를 끝내 두면 된다. 사고 토큰과 단가의 관계는 Gemini 3.8 Flash thinking level과 토큰 비용 체크리스트에서, 캐시 읽기 단가가 에이전트 비용을 좌우하는 구조는 Claude Fable 5.1 캐시 리드 $0.25 인하에서 다뤘으니 함께 보면 맥락이 잡힌다.
출처
- DeepSeek 공식 릴리스 노트(2026-09-10): https://api-docs.deepseek.com/news/news260910
- DeepSeek 공식 가격 페이지(2026-09-10 확인): https://api-docs.deepseek.com/quick_start/pricing
- DeepSeek API 문서 — Your First API Call: https://api-docs.deepseek.com/
- DeepSeek API 문서 — Thinking Mode: https://api-docs.deepseek.com/guides/thinking_mode
- DeepSeek-V4.1-Flash 모델 카드(Hugging Face): https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
- MarkTechPost(2026-09-10): https://www.marktechpost.com/2026/09/10/deepseek-ai-released-deepseek-v4-1-flash-with-1m-context-fp4-kv-cache-and-cross-layer-attention-reuse/
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 본문의 벤치마크·KV 캐시 절감 수치는 모두 DeepSeek 자사 발표 기준입니다.