안녕하세요, 미니지식공간입니다.
gemini-3.8-flash가 2026년 9월 2일 stable로 등록됐다. Gemini 3.8 Flash 가격은 100만 토큰당 입력 $0.75 · 출력 $3.75로 3.7 Flash와 같지만, 모델 ID만 바꿔 배포하면 예상과 다른 청구서를 받을 수 있다. 공식 문서 기준으로 무엇이 같고 무엇이 달라졌는지 정리한다.
결론부터
- 단가는 동결이다. 다만 구글이 직접 "3.8 Flash는 더 열심히 일한다(works harder)"고 밝혔고, 사고 토큰은 출력 토큰과 합산 과금된다. 단가 동결 ≠ 비용 동결이다.
thinking_level은 3.7 Flash와 동일하게low/medium/high만 지원한다.minimal은 지정 시 오류를 반환한다. 3.6 Flash에서 바로 올라온다면 여기서 깨진다.- 도입가 만료일은 2026년 12월 31일이다. 2027년 1월 1일부터 $1.50 / $7.50으로 두 배가 된다.
1. 스펙 — 공식 모델 문서 기준
Gemini API 공식 모델 문서(하단 기준 2026-09-02 UTC 갱신) 값을 그대로 옮기면 다음과 같다.
| 항목 | 값 |
|---|---|
| 모델 ID | gemini-3.8-flash (stable) |
| 입력 토큰 한도 | 1,048,576 |
| 출력 토큰 한도 | 65,536 |
| 입력 타입 | 텍스트 · 이미지 · 비디오 · 오디오 · PDF |
| 출력 타입 | 텍스트 |
| Thinking | 지원 (low, medium, high) — minimal 미지원, 오류 반환 |
| 캐싱 / 코드 실행 / 함수 호출 | 지원 |
| 구조화 출력 / 검색 그라운딩 / URL 컨텍스트 / 파일 검색 | 지원 |
| Google Maps 그라운딩 | 지원 |
| 컴퓨터 사용(Computer use) | 지원 (프리뷰) |
| 이미지 생성 / 오디오 생성 / Live API | 미지원 |
| Batch / Flex / Priority 추론 | 지원 |
| 최신 갱신 | 2026년 9월 |
Live API와 이미지 생성이 빠져 있다는 점은 3.7 Flash와 같다. 음성 대화나 이미지 출력이 필요하면 여전히 별도 모델을 붙여야 한다.
2. thinking_level — 3.6 Flash에서 올라온다면 여기서 막힌다
공식 thinking 문서(2026-09-04 갱신)의 지원 표를 보면 모델별 차이가 뚜렷하다.
| 모델 | 기본값 | 지원 수준 |
|---|---|---|
gemini-3.8-flash | medium | low, medium, high |
gemini-3.7-flash | medium | low, medium, high |
gemini-3.6-flash | medium | minimal, low, medium, high |
gemini-3.5-flash-lite | minimal | minimal, low, medium, high |
3.7 → 3.8 전환은 이 축에서는 무손실이다. 반면 3.6 Flash나 3.5 Flash-Lite에서 thinking_level: "minimal"을 쓰고 있었다면, 모델 ID만 교체한 배포는 런타임 오류로 떨어진다. 모델 문서에 "minimal is not supported and returns an error"라고 명시돼 있다.
기본 호출은 다음과 같다. 아래 세 스니펫은 모두 공식 thinking 문서의 예제를 그대로 인용한 것이다(문서 원문에 gemini-3.8-flash로 기재돼 있다).
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Explain the concept of Occam's Razor and provide a simple, everyday example."
)
print(interaction.output_text)
effort를 낮추려면 generation_config.thinking_level을 지정한다.
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Provide a list of 3 famous physicists and their key contributions",
    generation_config={
        "thinking_level": "low"
    }
)
print(interaction.output_text)
REST로는 이렇다.
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-3.8-flash",
    "input": "Provide a list of 3 famous physicists and their key contributions",
    "generation_config": {
      "thinking_level": "low"
    }
  }'
출처: Gemini thinking — Gemini API 공식 문서 (2026-09-04 갱신)
3. 과금의 실제 축은 사고 토큰이다
공식 thinking 문서의 Pricing 절은 이렇게 규정한다. thinking이 켜져 있으면 응답 가격은 출력 토큰과 사고 토큰의 합이다. 그리고 모델은 품질을 위해 전체 사고를 생성하고 요약만 반환하는데, 과금은 요약이 아니라 생성된 전체 사고 토큰 기준이다.
따라서 전환 전 측정해야 할 값은 응답 길이가 아니라 total_thought_tokens다.
print("Thoughts tokens:", interaction.usage.total_thought_tokens)
print("Output tokens:", interaction.usage.total_output_tokens)
스트리밍을 쓰면 interaction.completed 이벤트의 usage 객체에서 같은 값을 받을 수 있다. 문서에 실린 예시 응답에는 {"total_tokens":530,"total_input_tokens":62,"total_output_tokens":171,"total_thought_tokens":297} 형태로 나온다. 이 예시만 봐도 사고 토큰이 출력 토큰보다 많다.
여기에 구글의 설명이 겹친다. 공식 블로그는 3.8 Flash가 복잡한 작업에서 추가 추론 단계를 실행하고 도구를 반복 호출하며, "때때로 더 많은 토큰을 사용할 수 있고 특히 높은 effort 수준에서 그렇다"고 적었다. 성능 향상의 대가가 토큰이라는 뜻이다.
4. 제3자 측정 — 얼마나 장황한가
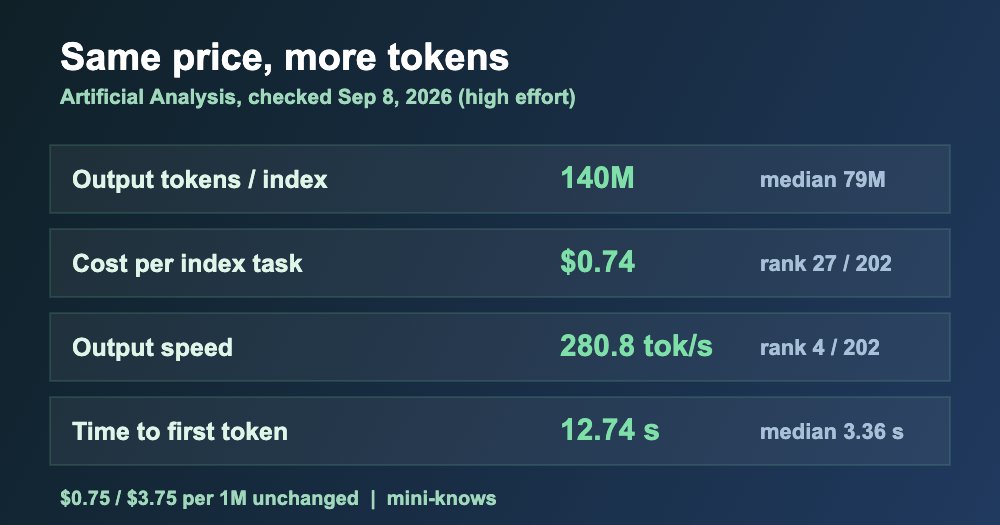
독립 평가 기관 Artificial Analysis의 모델 페이지(2026년 9월 8일 확인)에서 3.8 Flash(high effort) 수치는 다음과 같다. 구글 자사 발표가 아닌 제3자 측정이라는 점에서 참고 가치가 있다.
| 지표 | 값 | 비교군 |
|---|---|---|
| Intelligence Index (v4.2) | 47 | 202개 모델 중 28위 |
| 출력 속도 | 280.8 tok/s | 4위 |
| 인덱스 과제 1건당 비용 | $0.74 | 27위 |
| 인덱스 수행 총 출력 토큰 | 140M | 중앙값 79M |
| Time to first token | 12.74s | 중앙값 3.36s |
| 블렌디드 단가 (7:2:1) | $0.58 / 1M | — |
| 캐시 할인율 | 90% | — |
주목할 줄은 두 개다. 하나는 총 출력 토큰 140M으로, 비교군 중앙값의 약 1.8배다. Artificial Analysis도 이 모델을 "very verbose"로 분류했다. 다른 하나는 TTFT 12.74초로, 중앙값 3.36초보다 눈에 띄게 길다. 초당 토큰 수는 최상위권인데 첫 토큰까지가 느린 전형적인 추론 모델 특성이다. 사용자 대면 스트리밍 UI라면 이 지연을 UX 설계에 반영해야 한다.
한 가지 상충 사항이 있다. 일부 3자 집계 사이트는 3.8 Flash의 Intelligence Index를 59로 표기한다. 위 값은 Artificial Analysis 공식 페이지의 v4.2 기준 수치이며, 인덱스 버전과 effort 설정에 따라 달라진다. 어느 쪽이 최신 기준인지는 확인이 필요하며, 인용할 때 버전을 함께 밝히는 편이 안전하다.
5. 벤치마크 — 어느 축에서 이득이 났나
아래는 전부 구글이 발표한 수치이며 독립 검증 결과가 아니다.
| 벤치마크 | 3.8 Flash | 3.7 Flash | 차이 |
|---|---|---|---|
| Terminal-Bench 2.1 | 90.8% | 81.6% | +9.2%p |
| τ³-bench Banking | 38.1% | 30.9% | +7.2%p |
| SWE-Atlas | 51.9% | 48.0% | +3.9%p |
| CharXiv | 86.2% | 84.5% | +1.7%p |
| SWE-Bench Pro | 61.6% | 60.4% | +1.2%p |
| Humanity’s Last Exam | 45.4% | 45.7% | -0.3%p |
이득은 터미널·도구 사용 축에 몰려 있고, 일반 추론은 사실상 제자리이거나 소폭 하락이다. 구글 공식 블로그는 별도로 HLE-Verified 54.9%를 제시했는데, 위 표의 HLE와는 다른 평가 세트다.
구글은 DeepSWE v1.1에서 3.8 Flash가 훨씬 큰 프런티어 모델 대부분을 앞선다고 밝혔으나, 블로그 본문에 정확한 수치는 표기하지 않았다.
6. 전환 전 체크리스트
thinking_level에minimal을 쓰는 코드 경로가 있는지 전수 확인한다. 3.8 Flash에서는 오류다.- 동일 프롬프트 세트로 3.7과 3.8을 각각 돌려
total_thought_tokens와total_output_tokens를 비교한다. 단가가 아니라 과제당 비용으로 판단한다. - 워크로드를 effort별로 분리한다. 분류·추출처럼 여유가 있는 작업은
low, 장기 코딩 과제만high로 둔다. - 스트리밍 UI라면 TTFT를 실측한다. Artificial Analysis 측정값은 12.74초다.
- 캐시 전략을 점검한다. 같은 페이지 기준 캐시 할인율이 90%이므로, 긴 시스템 프롬프트가 반복되는 구조라면 캐싱 적용 여부가 비용을 좌우한다.
- 2026년 12월 31일 도입가 만료를 예산 계획에 반영한다.
- 스테이트리스 모드로 대화를 관리한다면
thought블록을 받은 그대로 전부 재전송해야 한다. 서명이 들어 있어 임의로 제거·수정하면 추론 연속성이 깨진다.
직전 세대 이야기는 Gemini 3.7 Flash 정리 글에 thinking_level에서 minimal이 빠진 배경과 함께 정리해 두었다.
7. 관전 포인트
Cyber 변형은 별도 트랙이다. gemini-3.8-flash-cyber는 일반 API에 열려 있지 않고, 신뢰할 수 있는 방어자에게만 우선 접근을 주는 Fairwind 프로그램을 통해서만 제공된다. 구글이 공개한 수치는 CWE-Bench pass@1 47.2%(선두 프런티어 모델 47.8%), 20개 언어 내부 벤치마크 성공률 70% 이상, 크롬 보안팀 기준 정확한 패치 2.6배 등이다. 전부 구글·파트너사 발표이며 독립 재현 전이다.
그리고 출시 주기다. 구글 스스로 "6주 만의 세 번째 Flash 릴리스"라고 표현했다. 모델 ID를 코드에 하드코딩하기보다 설정으로 빼두는 편이 유리한 환경이다.
자주 묻는 질문
Q. 기존 API 코드를 수정해야 하나?
thinking_level: "minimal"을 쓰지 않았다면 대부분 모델 ID 교체만으로 동작한다. 3.6 Flash나 3.5 Flash-Lite에서 올라오는 경우에만 minimal 제거가 필요하다.
Q. Gemini 3.8 Flash 가격이 3.7 Flash보다 비싼가?
단가는 같다. 둘 다 100만 토큰당 입력 $0.75 · 출력 $3.75이며 2026년 12월 31일까지 적용된다. 다만 3.8 Flash가 토큰을 더 쓰는 경향이 있으므로 과제당 실제 비용은 달라질 수 있다.
Q. 3.7 Flash는 언제까지 쓸 수 있나?
구글은 공식 블로그에서 3.7 Flash가 효율 우선 워크로드를 위해 완전히 지원된다고 밝혔다. 별도 종료 일정은 공개되지 않았다(확인 필요).
마무리
이번 릴리스에서 바뀐 건 가격표가 아니라 토큰 소비 프로파일이다. 벤치마크 표를 근거로 전환을 결정하기보다, 자사 프롬프트 세트로 total_thought_tokens를 측정한 뒤 과제당 비용으로 판단하는 편이 정확하다.
출처
- Google 공식 블로그, Introducing Gemini 3.8 Flash and 3.8 Flash Cyber (2026-09-02) — https://blog.google/innovation-and-ai/models-and-research/gemini-models/3-8-flash-and-3-8-flash-cyber/
- Gemini API 공식 문서, Gemini 3.8 Flash (2026-09-02 갱신) — https://ai.google.dev/gemini-api/docs/models/gemini-3.8-flash
- Gemini API 공식 문서, Gemini thinking (2026-09-04 갱신) — https://ai.google.dev/gemini-api/docs/thinking
- Artificial Analysis, Gemini 3.8 Flash (high) (2026-09-08 확인) — https://artificialanalysis.ai/models/gemini-3-8-flash
- DataCamp, Gemini 3.8 Flash and 3.8 Flash Cyber: Features, Benchmarks, and Pricing (2026-09-02) — https://www.datacamp.com/blog/gemini-3-8-flash-cyber
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 본문의 성능·보안 수치는 별도 표기가 없는 한 구글 및 파트너사의 자사 발표 기준이며 독립 검증 결과가 아닙니다.