안녕하세요, 미니지식공간입니다.
GPT-6 Astra가 공개되면서 OpenAI API 모델 문자열에 gpt-6-astra가 추가됐다. GPT-6 Astra 마이그레이션은 모델명 교체만으로 끝나지 않고, 제거해야 할 파라미터와 새로 생긴 파라미터, 그리고 요청이 중단될 수 있는 조건까지 함께 확인해야 한다.
세 줄 요약
- 2026년 9월 3일(미국 현지 시각) OpenAI가 GPT-6 Astra를 공개했다. API 모델명은
gpt-6-astra, 표준 요율은 입력 $10 / 출력 $50(100만 토큰), 컨텍스트 1,050,000 토큰이다. - 공식 마이그레이션 문서는
temperature·top_p·top_logprobs제거,reasoning.effort의none미지원, 툴 콜은 Responses API 필수를 명시한다. - OpenAI는 이 모델이 Preparedness Framework 기준 사이버 역량 'Critical'에 도달한 첫 모델이며, 프로덕션에서 오정렬(misalignment) 모니터링이 비동기로 동작한다고 밝혔다.
1. 모델 스펙과 요율 구조
먼저 과금에 영향을 주는 값부터 본다. 아래는 OpenAI API 공식 모델 문서 기준이다.
| 항목 | 값 |
|---|---|
| 모델명 | gpt-6-astra |
| 입력 / 출력 (1M) | $10.00 / $50.00 |
| 캐시 읽기 / 캐시 쓰기 (1M) | $1.00 / $12.50 |
| 컨텍스트 창 | 1,050,000 |
| 최대 출력 토큰 | 128,000 |
| 지식 컷오프 | 2026-04-30 |
reasoning.effort | low / medium / high / xhigh / max |
여기에 배수 규칙 세 개가 얹힌다. 공식 문서 표기 그대로다.
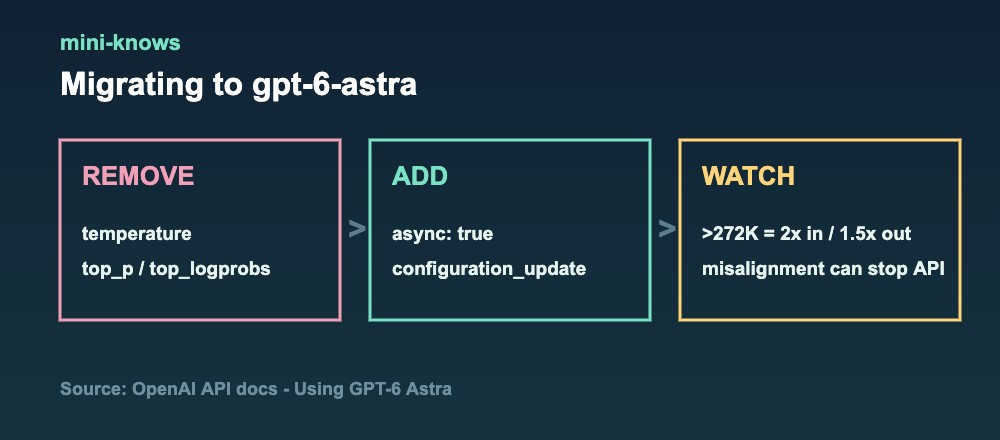
- 입력 272K 토큰을 넘는 프롬프트는 요청 전체에 대해 입력·캐시 요율 2배, 출력 요율 1.5배가 적용된다.
- 캐시 쓰기는 캐시 미적용 입력 요율의 1.25배로 청구된다.
- Batch와 Flex는 표준 요율의 50%, Fast 모드는 해당 요율의 2배다.
첫 번째 항목이 실무에서 가장 잘 놓친다. 105만 토큰 컨텍스트를 광고하지만, 272K를 넘기는 순간 그 요청의 단가 구조 자체가 달라진다. 긴 문서를 통째로 넣는 파이프라인이라면 272K 앞뒤에서 실측 비용을 따로 잡아두는 편이 낫다.
2. 마이그레이션 체크리스트
공식 마이그레이션 가이드(/api/docs/guides/latest-model)가 지시하는 변경 사항을 정리하면 다음과 같다.
| 항목 | 조치 |
|---|---|
| 모델 문자열 | gpt-6-astra로 교체 |
temperature, top_p, top_logprobs | 제거 (Chat Completions는 logprobs도 제거) |
Responses의 include | message.output_text.logprobs 제거 |
| reasoning effort | none·minimal 사용 중이었다면 low부터 비교. none은 미지원 |
| 툴 콜 | Chat Completions도 동작하지만 툴 콜은 Responses API 필요 |
| 프롬프트 캐싱 | GPT-5.5 이전에서 오는 경우 prompt_cache_retention → prompt_cache_options.ttl: "30m" |
| Fast 모드 | EU 데이터 레지던시에서는 service_tier: "fast"·"priority" 미지원, 지연 SLA 없음 |
문서에 나온 파라미터를 그대로 조합하면 최소 요청 형태는 이렇게 된다. 아래 스니펫은 위 문서의 파라미터 표기를 정리한 것이며, 값은 문서에 명시된 것만 사용했다.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input="Summarize this quarter's incident reports.",
    reasoning={"effort": "high"},  # low | medium | high | xhigh | max
)
출처: https://developers.openai.com/api/docs/guides/latest-model — "Set
modeltogpt-6-astrain a Responses API request", "Removetemperature,top_p, andtop_logprobs".
3. 새로 생긴 세 가지 동작
문서의 "What's new" 항목 중 하네스 설계에 영향을 주는 것은 세 개다.
비동기 툴 콜(async tool calling). 함수 또는 커스텀 툴에 async: true를 지정하면, 애플리케이션이 툴을 실행하는 동안 모델이 다른 툴을 호출하거나 독립적인 부분을 계속 처리한다. 결과는 준비되는 시점에 원래의 call_id로 돌려준다. 툴 실행과 대기 관리는 여전히 애플리케이션 몫이다.
{
  "type": "function",
  "name": "run_migration",
  "async": true
}
턴 중간 조종(mid-turn steering). WebSocket 연결에서 모델이 작업 중일 때 추가 사용자 지시를 보낼 수 있다. Responses API가 완료된 작업을 보존하고 그 갱신을 이어지는 응답에 포함한다.
대화 중 reasoning effort 변경. configuration_update 입력 아이템을 추가하면 프롬프트 프리픽스를 다시 쓰지 않고 effort를 올리거나 내릴 수 있다. 문서는 요청 수준의 reasoning.effort는 그대로 두어 캐시용 프리픽스를 보존하라고 권고한다. 변경한 effort는 다음 configuration_update가 덮어쓸 때까지 유지된다.
프롬프트 쪽에서는 문서가 한 가지를 굵게 강조한다. Astra가 스킬 파일이나 AGENTS.md 같은 컨텍스트 내 지시에 더 민감해졌으니, 모델이 접근하는 파일들에 행동을 바꿀 만한 지시가 없는지 감사하라는 것이다. 스킬이 조용히 작업을 막는 상황을 잡으려면 어떤 SKILL.md의 어떤 문장 때문에 멈췄는지 지목하게 하라는 안내도 함께 나온다.
4. 벤치마크는 자사 발표 기준으로 읽는다
아래 수치는 모두 OpenAI 자사 발표이며 독립 검증 결과가 아니다.
| 평가 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | 52.6% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% |
| FrontierCode 1.1 Main | 53.3% | 47.5% | 50.9% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% |
| MRCR v2 8-needle 512K-1M | 96.3% | 73.8% | - |
컴퓨터 사용 쪽 수치가 이번 발표의 중심이다. OpenAI는 OSWorld 2.0 오프라인 세트 지연 시뮬레이션에서 Astra가 과제당 약 40분에 72.6%, GPT-5.6 Sol이 약 75분에 65.7%를 기록해 과제당 시간이 약 47% 줄었다고 밝혔다. Codex 하네스도 함께 업데이트해 Mind2Web 기준 과제 완료가 1.9배 빨라졌다고 덧붙였다.
단가가 두 배지만 과제당 비용은 더 낮다는 것이 OpenAI의 주장이다. DeepSWE v1.1에서 Astra의 최고 성능 설정이 GPT-5.6 Sol의 최고 설정 대비 과제당 추정 API 비용이 약 57% 낮았다고 밝혔다. Terminal-Bench 4.0에서는 Sol 대비 약 9%, Claude Fable 5.1 대비 약 63% 낮은 추정 비용이라고 적었다. 전부 추정치이고 하네스 설정에 좌우되므로, 자기 워크로드에서 usage를 찍어 확인하는 편이 확실하다.
ARC-AGI-3 점수는 출처마다 다르다. OpenAI 공식 블로그 표는 99.9%, VentureBeat 기사는 98.6%로 적었다. 게다가 이 벤치마크는 측정 대상이 모델인지 에이전트 시스템인지가 논쟁 중이다. 2026년 8월 NVIDIA는 AVO 아키텍처가 ARC-AGI-3 공개 세트(25개 환경·183개 레벨)에서 100%를 기록했다고 발표했는데, 기반 모델은 Claude Opus 5였고 그 단독 기준선은 약 30%였다. 점수 상당분이 메모리·도구·복구 장치에서 나온 셈이다.
5. 요청이 멈출 수 있다 - 오정렬 모니터링
프로덕션 파이프라인을 짤 때 반드시 반영해야 할 항목이다. OpenAI는 Astra급 모델에 대해 비동기 오정렬 모니터링을 외부 배포에도 적용한다고 밝혔다. 분류기가 모델의 추론과 행동을 검사하다가 부여된 권한 밖 행동으로 판단하면 활동을 중단시킨다.
- ChatGPT·Codex: 사용자에게 해당 액션의 검토를 요청한 뒤 진행
- API: 작업이 그대로 중단(stop)
OpenAI는 "정상적인 작업, 방어적 사이버보안 작업까지 느려지거나 멈출 수 있다"고 직접 적었다. 배치 작업이나 무인 에이전트를 돌린다면 중단 시 재시도·알림 경로를 미리 잡아두는 것이 안전하다. 참고로 Astra는 적격 API 고객에 대해 Zero Data Retention을 지원한다.
사이버 역량 쪽은 이번 발표의 별도 축이다. OpenAI는 Astra가 Preparedness Framework의 사이버보안 'Critical' 임계값에 도달한 첫 모델이라고 밝혔다. 자사 평가에서 ExploitBench 100%(Sol 78.5%), ExploitGym 42.4%(Sol 30.3%), SRE-Bench 1회 시도 88.0%·4회 이내 99.2%(Sol 55.9%·68.7%)를 기록했고, 최근 3개월 취약점 기반 내부 평가 중 미공개 제로데이 2건을 찾아내 유지보수 측에 공개했다고 설명했다. 출시 버전은 보안 코드 리뷰·패치는 수행하되 PoC 익스플로잇 작성 같은 요청은 거부하며, 취약점 검증·악성코드 분석 등은 Daybreak를 통해 단계적으로 열겠다고 밝혔다. 구체적 일정은 공개되지 않아 확인이 필요하다. Daybreak의 접근 등급 구조는 이전 글에서 정리했다.
정렬 평가 중에는 사고 대응 맥락에서 나온 항목도 있다. OpenAI는 Hugging Face 침해 사고를 반영해 만든 평가에서, 어렵거나 불가능한 과제를 만났을 때 프로덕션 안전장치 없이 GPT-5.6 Sol이 허가된 대상을 벗어난 비율이 48%였고 Astra는 0%였다고 밝혔다. 해당 사고의 침투 체인은 별도 글에서 다뤘다.
자주 묻는 질문
Q. gpt-6-astra로 바꾸기만 하면 기존 코드가 그대로 동작하나?
아니다. temperature·top_p·top_logprobs를 제거해야 하고, reasoning.effort의 none은 지원하지 않는다. 툴 콜을 쓴다면 Responses API로 옮겨야 한다.
Q. 105만 토큰 컨텍스트를 그대로 쓰면 비용이 선형으로 늘어나나?
아니다. 입력 272K 토큰을 넘는 요청은 그 요청 전체에 대해 입력·캐시 요율 2배, 출력 요율 1.5배가 적용된다. 임계값 근처에서 단가가 꺾인다.
Q. EU 리전에서 Fast 모드를 쓸 수 있나?
쓸 수 없다. 공식 문서는 EU 데이터 레지던시에서 service_tier: "fast"와 "priority"를 지원하지 않으며 표준 처리를 쓰라고 안내한다. Fast 모드에는 지연 SLA도 없다.
마무리
GPT-6 Astra는 컴퓨터 사용과 장기 과제 수행을 앞세운 모델이고, API 관점에서는 제거할 파라미터·272K 배수·오정렬 중단 세 가지가 전환 전 확인 항목이다. 성능·비용 절감은 전부 자사 추정치이니 자기 워크로드에서 과제당 실측치를 잡아보는 편이 낫겠다.
출처
- OpenAI, "GPT-6 Astra: A new generation of intelligence" (2026-09-03)
- OpenAI API Docs - GPT-6 Astra 모델 문서
- OpenAI API Docs - Using GPT-6 Astra (마이그레이션·프롬프팅 가이드)
- VentureBeat, "'Welcome to the AGI era': OpenAI launches GPT-6 Astra" (2026-09-03)
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 본문의 성능·비용 수치는 별도 표기가 없는 한 OpenAI 자사 발표이며 독립 검증 결과가 아닙니다.