안녕하세요, 미니지식공간입니다.
gemini-3.8-flash-tts와 gemini-3.8-flash-lite-tts가 2026년 9월 23일 공개되면서 Gemini TTS(Text-to-Speech·텍스트를 음성으로 바꾸는 기술)의 호출 방식과 요금 구조가 함께 바뀌었다. 이 글은 공식 문서에 실린 파라미터와 코드를 기준으로 무엇을 어떻게 바꿔 호출해야 하는지, 오디오 출력 토큰 요금을 어떻게 계산해야 하는지를 정리한다.
1. 릴리스가 건드린 지점
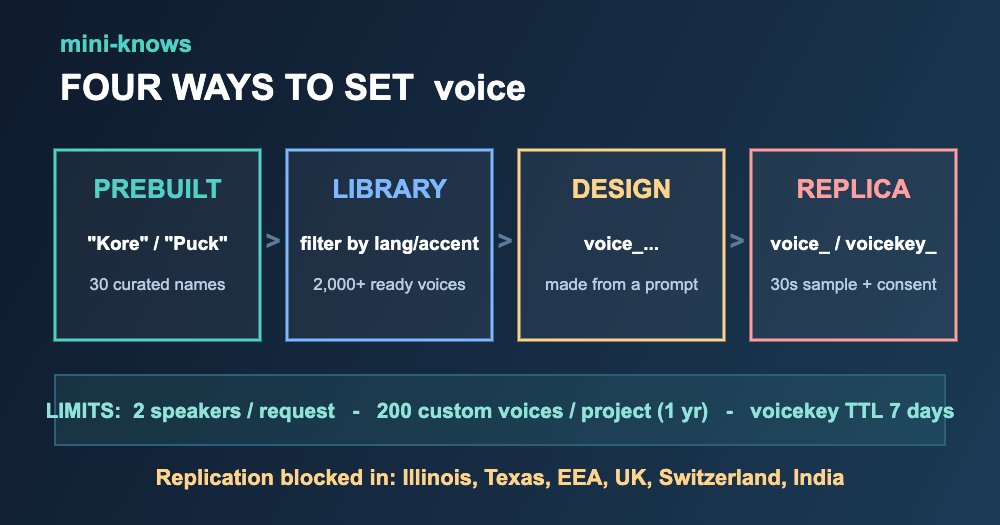
구글 발표문은 이번 변화를 "30개 음성에서 무한한 음성 라이브러리로"라고 표현했다. 코드 관점에서 이 문장은 음성 지정 방식이 하나에서 셋으로 늘어났다는 뜻이다. 기존처럼 미리 준비된 음성 이름을 문자열로 넣는 경로가 남아 있고, 여기에 프롬프트로 설계한 음성 ID와 30초 샘플로 복제한 음성 ID가 추가됐다.
모델은 두 개로 갈렸다. gemini-3.8-flash-tts는 음향 충실도를 최대로 가져가는 쪽이고, gemini-3.8-flash-lite-tts는 빠르고 비용 효율적인 쪽이다. 두 모델 모두 발표 당일부터 Google AI Studio와 Gemini API에서 호출할 수 있다. 입력은 텍스트 전용, 출력은 오디오 전용이라는 제약이 공식 문서에 명시돼 있어 멀티모달 입력은 이 모델의 몫이 아니다.
2. 최소 호출 코드
공식 문서(Speech generation)에 실린 Python 예제다. interactions.create에 response_format을 오디오로 지정하고 generation_config.speech_config에 음성을 넣는 구조다.
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Have a wonderful day!",
            "annotations": [{
                "type": "speech_metadata",
                "style": "cheerful and friendly",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [{"voice": "Kore"}]
    },
)

with open("out.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
눈여겨볼 곳은 annotations의 speech_metadata.style이다. 연기 지시를 프롬프트 본문에 섞지 않고 턴 단위 메타데이터로 분리한다. 같은 호출을 REST로 옮기면 아래와 같다. 엔드포인트가 /v1beta/interactions이며 인증은 x-goog-api-key 헤더를 쓴다.
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{"type": "user_input", "content": [{
      "type": "text", "text": "Have a wonderful day!",
      "annotations": [{"type": "speech_metadata", "style": "cheerful"}]
    }]}],
    "response_format": {"type": "audio"},
    "generation_config": {"speech_config": [{"voice": "Kore"}]}
  }'
3. 음성을 지정하는 네 가지 경로
공식 문서가 구분하는 voice 값의 종류는 아래와 같다. 어느 경로를 쓰든 필드 이름은 voice 하나로 통일돼 있어, 프로토타입에서 프로덕션으로 넘어갈 때 호출 구조를 다시 짤 필요가 없다.
| 경로 | 지정 값 | 특징 |
|---|---|---|
| 기본 제공 음성 | Kore, Puck, Charon 등 30종 | 기존 코드 그대로 동작 |
| 확장 음성 라이브러리 | 필터(언어·지역·억양·성별·피치·페르소나·맥락) | 기성 음성 2,000종 이상 |
| 보이스 디자인 | voice_... ID | 자연어 프롬프트로 생성 |
| 음성 복제 | voice_... 또는 voicekey_... | 30초 샘플 + 동의 녹음 필요 |
voicekey_로 시작하는 스테이트리스 키는 TTL이 7일이다. 프로젝트에 저장하는 커스텀 음성은 200개까지이고 보관 기간은 1년이다. 복제 음성을 사용자별로 대량 생성하는 설계라면 이 두 한도를 먼저 계산해야 한다.
4. 2화자 대화 구성
여러 화자를 쓰려면 speech_config를 배열에서 객체로 바꾸고 mode를 대화형으로 지정한다. 대본 쪽에서는 speech_metadata.speaker로 어느 화자의 발화인지 표시한다.
"speech_config": {
  "mode": "conversational",
  "speakers": [
    {"speaker": "Joe", "voice": "Puck"},
    {"speaker": "Jane", "voice": "Kore"}
  ]
}
요청당 화자는 최대 2명이다. 3인 이상 좌담을 만들려면 화자 조합을 나눠 여러 번 호출한 뒤 후처리로 합치는 구조가 필요하다. 비언어 신호는 대본에 인라인 태그로 넣는다. 공식 문서가 예시로 든 태그는 <cough>, <sigh>, <short pause>이며, 발표문에는 웃음·한숨·숨 들이킴 같은 표현과 맞장구(backchanneling)가 언급됐다.
5. 출력 포맷과 샘플레이트
오디오를 그대로 스트리밍으로 넘길지, 파일로 저장할지에 따라 포맷이 갈린다. 공식 문서 기준 값은 아래와 같다.
| 모드 | MIME | 스펙 |
|---|---|---|
| 단건(기본) | audio/wav | RIFF 헤더 포함, 24kHz 모노 16-bit PCM |
| 스트리밍 | audio/l16 | 헤더 없는 raw PCM, 24kHz 모노 16-bit |
| 전화망 | audio/mulaw / audio/alaw | G.711 8-bit |
sample_rate는 24000, 16000, 8000 중에서 고를 수 있다. 전화 연동이라면 8kHz mu-law로 내려받아 리샘플링 단계를 없애는 쪽이 파이프라인이 짧다. 스트리밍에서 audio/l16을 쓸 때는 헤더가 없으므로 플레이어 쪽에 샘플레이트·채널·비트뎁스를 직접 알려줘야 한다.
6. 요금은 오디오 출력 토큰이 결정한다
공식 가격 페이지 기준 단가다. 무료 티어는 두 모델 모두 입력·출력 무과금이며, 유료 티어 단가에 적용 기한이 붙어 있다.
| 모델 | 구분 | 2026-12-31까지 | 2027-01-01부터 |
|---|---|---|---|
gemini-3.8-flash-tts | 입력(텍스트) | $0.50 / 1M | $1.00 / 1M |
gemini-3.8-flash-tts | 출력(오디오) | $9.00 / 1M | $18.00 / 1M |
gemini-3.8-flash-lite-tts | 입력(텍스트) | $0.50 / 1M | $1.00 / 1M |
gemini-3.8-flash-lite-tts | 출력(오디오) | $6.00 / 1M | $12.00 / 1M |
네 칸 모두 정확히 2배가 된다. 그리고 Flash TTS는 출력 단가가 입력 단가의 18배다. 대본을 줄여 절감할 수 있는 폭보다, 어떤 모델로 렌더링하느냐와 몇 번 다시 렌더링하느냐가 청구서를 좌우한다. 같은 대본을 Flash-Lite로 돌리면 출력 단가가 1/3 줄어들므로, 초안 렌더링은 Flash-Lite로 돌리고 최종본만 Flash TTS로 뽑는 2단 구성이 비용상 유리하다.
오디오 1초가 몇 토큰으로 환산되는지는 공식 가격 페이지·문서에 명시돼 있지 않아 확인 필요다. 단가만으로 월 비용을 추정하려면 실제 대본으로 한 번 호출해 응답의 사용량 필드를 측정한 뒤 곱하는 방법이 정확하다.
7. 제한 사항 체크리스트
- 요청당 화자 최대 2명
- 프로젝트당 커스텀 음성 200개, 보관 1년
- 스테이트리스 voice key TTL 7일
- 입력 텍스트 전용 / 출력 오디오 전용
- 음성 복제는 30초 참조 녹음 + 목소리 주인의 구두 동의 녹음 필수, 시스템이 동일 화자인지 대조
- 음성 복제 미제공 지역: 미국 일리노이주·텍사스주, 유럽경제지역(EEA), 영국, 스위스, 인도
- 생성 오디오 전량 SynthID 워터마크, 복제 음성에는 C2PA 콘텐츠 자격증명 추가
지역 제한은 코드가 아니라 배포 설계 문제다. 글로벌 서비스라면 복제 기능을 지역별로 분기하고, 제한 지역에는 프롬프트 기반 보이스 디자인으로 대체하는 경로를 준비해 두는 편이 낫다. 보이스 디자인은 발표문의 제한 목록에 포함돼 있지 않다.
8. 벤치마크와 언어 수는 이렇게 읽는다
발표문이 제시한 수치는 Hume AI 보이스 디자인 벤치마크 71.4점으로 Flash TTS 1위, 종합 품질 지수에서 두 모델이 각각 1·2위다. Voice Arena 블라인드 선호도에서 일본어·힌디어·멕시코 스페인어 상위권이라는 설명도 있다. 측정 기관은 외부지만 측정 조건과 버전은 구글 발표문에 실린 자사 발표 기준 수치이므로, 자체 대본으로 재측정하는 단계를 건너뛰기는 어렵다.
언어 개수는 출처 간 표기가 어긋난다. 발표문은 두 모델을 합쳐 "100개 이상의 언어·방언"으로 적었고, Gemini API 문서는 Flash TTS 130개 이상 / Flash-Lite 100개 이상으로 구분해 적었다. 특정 언어 지원 여부가 요구사항이라면 API 문서 쪽을 기준으로 삼는 것이 안전하다.
9. 마이그레이션 체크리스트
기존 Gemini TTS 코드에서 옮겨 온다면 순서는 아래와 같다.
- 모델 문자열을
gemini-3.8-flash-tts또는gemini-3.8-flash-lite-tts로 교체 - 기존 30종 음성 이름은 그대로 유지 가능 — 음성 교체 없이 먼저 회귀 테스트
- 출력 포맷·샘플레이트를 현재 파이프라인에 맞춰
response_format에 명시 - 연기 지시를 프롬프트 본문에서
speech_metadata.style로 분리 - 2화자 콘텐츠는
speech_config를 객체 +mode: conversational로 전환 - 초안/최종 2단 렌더링으로 나눠 출력 토큰 비용 측정
- 2027년 1월 1일 단가를 기준으로 예산 재산정
실시간 양방향 음성 대화는 이 모델의 영역이 아니다. 입력이 텍스트 전용이므로 사용자 발화를 받아 응답하는 구조는 같은 Gemini 3.8 계열의 Live 모델을 써야 한다. 두 계열의 프로토콜 차이는 gemini-3.8-live-extended-thinking 적용 정리에 코드와 함께 정리해 두었으니 선택 전에 비교해 보면 좋다.
자주 묻는 질문
Q. gemini-3.8-flash-tts는 무료로 쓸 수 있나?
공식 가격 페이지에 무료 티어가 있고, 두 모델 모두 입력·출력이 무과금으로 표기돼 있다. 다만 무료 티어에는 사용량 제한이 적용되므로 프로덕션 트래픽을 그대로 올리는 용도로는 맞지 않는다.
Q. 기존 API 코드 수정이 필요한가?
모델 문자열 교체가 기본이고, 기존 30종 음성 이름은 그대로 지정할 수 있다. 확장 음성 라이브러리나 보이스 디자인·복제 음성을 쓰려면 voice 값을 필터나 voice_ / voicekey_ ID로 바꿔야 한다. 2화자 대화를 쓸 때만 speech_config 형태가 배열에서 객체로 달라진다.
Q. 3명 이상이 대화하는 오디오를 한 번에 만들 수 있나?
공식 문서 기준 요청당 화자는 최대 2명이다. 3인 이상이 필요하면 화자 쌍을 나눠 여러 번 호출하고 후처리로 이어 붙이는 방식이 필요하다.
마무리
정리하면 호출 구조는 model 문자열과 speech_config만 맞추면 되는 수준이고, 실제 판단이 필요한 쪽은 비용과 제한입니다. 출력 오디오 단가가 입력의 18배이고 2027년 1월 1일에 두 배로 오르므로, 초안·최종을 나눈 2단 렌더링과 사용량 실측을 먼저 해 두시길 권합니다.
출처
- Google 공식 블로그, "Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS" (2026-09-23): https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-text-to-speech/
- Gemini API 공식 문서, Speech generation (코드·파라미터·한도 원문): https://ai.google.dev/gemini-api/docs/speech-generation
- Gemini Developer API 공식 가격 페이지: https://ai.google.dev/gemini-api/docs/pricing
- The Next Web (2026-09-23): https://thenextweb.com/news/gemini-tts-3-8-flash-voice-design-cloning
- AI News: https://www.artificialintelligence-news.com/news/google-gemini-3-8-flash-tts-voice-models/
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 요금과 지역 제공 범위는 변경될 수 있습니다.