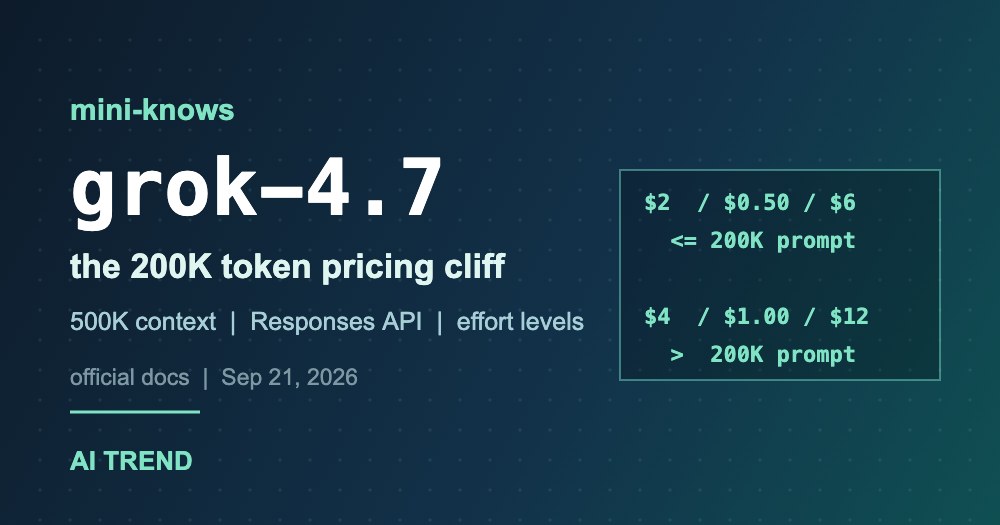
안녕하세요, 미니지식공간입니다. 이번 글은 2026년 9월 21일 공개된 grok-4.7을 공식 문서 기준으로 뜯어봅니다. 핵심은 Grok 4.7 가격의 200K 토큰 경계와 500K 컨텍스트, 그리고 네 단계로 나뉜 reasoning effort 설정이다.
TL;DR
grok-4.7, 2026-09-21 공개. 컨텍스트 500,000 토큰, 텍스트·이미지 입력 / 텍스트 출력.- 요금은 프롬프트 200K 토큰을 경계로 $2 / $0.50 / $6 → $4 / $1 / $12 (100만 토큰당 입력/캐시 입력/출력).
- Responses API에서
include에 넣지 않아도reasoning.encrypted_content가 항상 반환된다.
1. 릴리스 개요
| 항목 | 값 |
|---|---|
| 모델 ID | grok-4.7 |
| 공개일 | 2026-09-21 |
| 컨텍스트 창 | 500,000 토큰 |
| 모달리티 | 텍스트·이미지 입력 / 텍스트 출력 |
| 출력 길이 제한 | 별도 상한 없음 (릴리스 노트) |
| 지식 컷오프 | 2026년 5월 (공식 문서) |
| reasoning effort | low / medium / high(기본) / xhigh |
| 지원 API | Responses API, Chat Completions |
| 내장 툴 | function calling, web search, X search, code execution |
| 엔드포인트 | https://api.x.ai/v1 (US 리전 엔드포인트 제공) |
공식 발표는 Grok 4.6 대비 더 큰 베이스 모델과 더 긴 강화학습을 언급하지만 파라미터 수는 공개하지 않았다. 지식 컷오프는 공식 문서가 2026년 5월로 적고 있고 일부 집계 사이트는 6월로 표기해 상충한다. 이 항목은 확인 필요로 둔다.
2. 요금 구조: 200K 토큰이 분기점
릴리스 노트가 명시한 요율은 아래와 같다. 200K를 넘는 순간 세 항목이 전부 정확히 두 배가 된다.
| 프롬프트 구간 | 입력 | 캐시 입력 | 출력 |
|---|---|---|---|
| ≤ 200K 토큰 | $2.00 | $0.50 | $6.00 |
| > 200K 토큰 | $4.00 | $1.00 | $12.00 |
100만 토큰당 단가. 출처: docs.x.ai/developers/release-notes
표시 단가는 Grok 4.6과 동일하다는 것이 매체 분석의 설명이다. 즉 이번 릴리스는 인하가 아니라 동결이다. 다만 컨텍스트가 500K로 늘었기 때문에 실효 비용은 프롬프트 길이 분포에 전적으로 달려 있다. 긴 저장소를 통째로 넣는 에이전트라면 평균 단가가 표시가의 두 배에 수렴할 수 있으므로, 토큰 길이 히스토그램을 먼저 찍어 보는 편이 빠르다.
캐시와 관련해 문서는 prompt_cache_key를 지정해야 캐시 적중이 안정적이라고 권고하고, 장시간 에이전트 워크플로우에는 컨텍스트 압축(context compaction)을 최적화 수단으로 제시한다. 캐시 입력 단가가 기본 입력의 4분의 1이므로, 시스템 프롬프트와 도구 정의가 큰 구성일수록 효과가 크다.
3. 호출 방법
공식 퀵스타트가 제시하는 Responses API 호출 예제는 다음과 같다. OpenAI 클라이언트에 base_url만 바꿔 끼우는 구조다.
from openai import OpenAI

client = OpenAI(
    api_key="<YOUR_XAI_API_KEY_HERE>",
    base_url="https://api.x.ai/v1",
)

response = client.responses.create(
    model="grok-4.7",
    input="Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}",
)

print(response.output_text)
같은 호출의 cURL 형태다.
curl https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.7",
    "input": "Fix this function and explain the bug: function median(a){a.sort();return a[a.length/2]}"
  }'
출처: docs.x.ai/developers/quickstart
추론 강도와 캐시 키는 문서가 값과 이름을 명시하고 있으므로, 문서 기재 항목만 그대로 정리하면 아래와 같다. 공식 예제 코드가 아닌 문서 파라미터 요약이다.
model              = "grok-4.7"
reasoning effort   = low | medium | high (default) | xhigh
prompt_cache_key   = 캐시 적중 안정화를 위해 지정 권고
APIs               = Responses API, Chat Completions
tools              = function calling, web search, X search, code execution
주의               = Responses API에서 grok-4.7은 include에 지정하지 않아도
                     reasoning.encrypted_content 를 항상 반환한다
출처: docs.x.ai/developers/grok-4-7, docs.x.ai/developers/release-notes
마지막 항목이 실무에서 걸리기 쉬운 지점이다. 응답 스키마를 엄격하게 검증하거나 로그를 그대로 적재하는 파이프라인이라면, 암호화된 추론 블록이 항상 따라붙는다는 전제로 파서와 저장 용량을 다시 봐야 한다.
4. 벤치마크 (전부 xAI 자사 발표)
아래 수치는 모두 xAI가 공식 발표에 실은 값이며 독립 검증 결과가 아니다.
| 벤치마크 | Grok 4.7 | Grok 4.6 |
|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% |
| Terminal-Bench 4.0 | 38.0% | 20.3% |
| DeepSWE v1.1 (high) | 71.0% | 65.2% |
| HealthBench Professional | 56.7% | 48.5% |
| EEBench | 64.0% | 미공개 |
| LatchBio 바이오안전 | 62.4% | 미공개 |
| HackerBench v0.3 위험 프롬프트 통과율 | 3.3% | 미공개 |
상승 폭이 가장 큰 항목은 Terminal-Bench 4.0으로 20.3% → 38.0%다. 반면 매체 분석은 코딩 계열 두 지표에서 Claude Fable 5.1이 여전히 앞선다고 지적한다. 벤치마크 점수는 effort 설정과 하네스 구성에 따라 크게 흔들리므로, 자체 과제 세트로 재현하기 전에는 전환 근거로 삼지 않는 편이 안전하다.
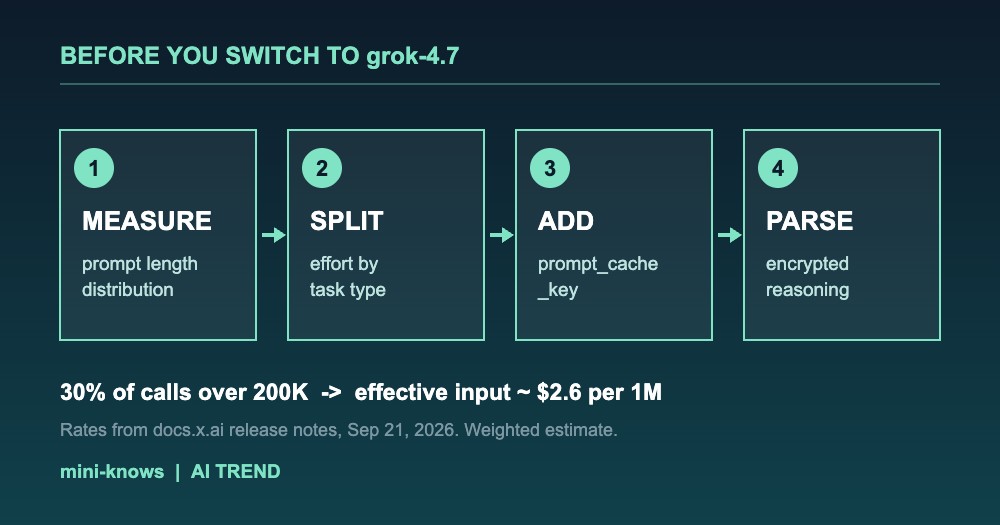
5. 전환 전 점검 5가지
- 프롬프트 길이 분포부터 측정한다. 200K 초과 호출 비율이 실효 단가를 결정한다. 초과 비율이 30%만 돼도 평균 입력 단가는 $2.6 수준으로 올라간다(단순 가중 계산).
- effort를 과제 유형별로 나눈다. 기본값이
high이므로 분류·추출 작업까지 기본값으로 돌리면 출력 토큰이 불필요하게 늘어난다. prompt_cache_key를 붙인다. 캐시 입력이 기본 입력의 4분의 1이므로 시스템 프롬프트가 큰 구성일수록 회수 효과가 크다.reasoning.encrypted_content상시 반환을 전제로 파서를 점검한다. 응답 크기와 로그 적재량이 함께 늘어난다.- 라우터별 실효 단가를 결제 내역으로 대조한다. 한 매체는 2026-09-22 기준 OpenRouter에서 $1.60 / $4.80로 공식가보다 약 20% 낮았다고 전했으나 단일 출처이므로 확인 필요다.
자주 묻는 질문
Q. grok-4.7은 무료로 쓸 수 있나?
API는 유료다. 공식 문서 기준 100만 토큰당 입력 $2 / 출력 $6이며, 200K 토큰을 넘는 프롬프트는 두 배 요율이 적용된다. 무료 제공 구간은 문서에 기재돼 있지 않다.
Q. 기존 코드에서 모델 문자열만 바꾸면 되나?
Responses API와 Chat Completions를 모두 지원하므로 엔드포인트 변경은 필요 없다. 다만 Responses API에서 reasoning.encrypted_content가 항상 반환되는 변경이 있어, 응답 스키마를 엄격히 검증하는 코드라면 수정이 필요할 수 있다.
Q. Grok 4.7 Fast는 어디서 쓰나?
공개 API에서는 제공되지 않는다. 공식 문서는 Cursor와 Grok Build에서만 쓸 수 있다고 적고 있으며, 속도는 약 두 배, 토큰 단가도 약 두 배로 안내된다.
마무리
grok-4.7은 단가를 동결한 채 컨텍스트와 발표 성능을 올린 릴리스다. 그래서 도입 판단의 핵심 변수는 벤치마크가 아니라 프롬프트 길이 분포가 된다. 같은 주에 나온 경쟁 모델의 단가 구조는 GPT-6 Sol·Luna vs Claude Opus 5.5 API 단가 비교 글에 정리해 두었으니 함께 보시면 비교가 쉽습니다. 읽어주셔서 감사합니다.
출처
- SpaceXAI Docs — Grok 4.7
- SpaceXAI Docs — Release Notes
- SpaceXAI Docs — Models & Pricing
- SpaceXAI Docs — Quickstart
- x.ai — Grok 4.7 공식 발표
- Digital Applied — Grok 4.7 Costs the Same as 4.6
본 글은 공개 자료를 바탕으로 정리했으며, 세부 내용·수치는 원 출처·공식 문서와 대조 확인을 권장합니다. 본문의 성능 수치는 모두 xAI 자사 발표이며 독립 검증된 값이 아닙니다.