multi-oom까지 클리어했다.
syn-write는 오락가락하는 상태이지만, 그런대로 만족하고 있다.
사실 만족 못한다. 단지 눈만 돌리고 있다.
프로젝트 3을 시작해야하니 어쩔 수 없다.
핀토스 프로젝트3 주간에 들어오자 다들 지친 기색이 역력하다.
나도 헛소리하면서 이 칙칙한 분위기를 뒤집고 싶은데 요즘 너무 헛소리를 자주했더니 헛소리샘이 바닥나버렸다.
이 상황을 타개할 수 있는 헛소리가 떠오르지 않는다..
본격적으로 코드를 분석하기 전에 Gitbook 내용 유튜브 영상 및 키워드들을 정리하고 가려고 한다.
VM
가상메모리에 대한 개념을 참고하고 싶다면
https://velog.io/@mogiyoon/Krafton-Jungle-Sixth#6-주소의-번역
여기를 참고하자.
Gitbook
Gitbook
book을 보니 떠오르는게 있다.
현재 정글 슬랙 방에서 내 프로필 사진은
얘다. 얘로 바꿀 때 직위도 exec ve로 바꿨다.
execve를 어떻게 발음할까 고민하면서 버 버 거리던게 입버릇이 됐다.
근데 얘로 바꿀 때 나와 친한 동기도 프로필 사진을 바꿨다.
얘로 바꿨다. 얘 이름은 너무 어렵다. 그리고 직위도 book으로 바꿨는데
이 캐릭터가 동네북 취급을 받기 때문이다.
Introduction
Source Files
vm 폴더에서 프로젝트를 진행한다.
수많은 template 코드가 있고, 주어진 template 코드를 잘 따라서 해야한다. 바꾸지 말라고 표시되어 있는 것은 절대 바꾸지 않도록 하자.
incluede/vm/vm.h, vm/vm.c
가상 메모리에 대한 일반적인 인터페이스를 제공한다. 헤더 파일에는 vm의 다른 타입에 대한 설명이 있다. 그리고 이 타입들은 내가 가상 메모리 시스템을 구현할 때 지원해야하는 타입들이다. 또한 supplementary page table 역시 구현해야한다. supplementary는 어떻게 해석해야할지 모르겠다. 보충? 페이지 테이블인가
include/vm/uninit.h, vm/uninit.c
초기화되지 않은 가상 페이지(타입: vm_uninit)에 대한 동작들을 제공한다. 모든 페이지는 처음에 초기화되지 않도록 설계되어있고, 이후 익명 페이지나 file-backed 페이지로 전환된다.
include/vm/anon.h, vm/anon.c
익명 페이지에 대한 동작들을 제공한다.(타입: vm_anon)
include/vm/file.h, vm/file.c
file-back 페이지에 대한 동작들을 제공한다.(타입: vm_file)
include/vm/inspect.h, vm/inspect.c
건들지 말래
include/devices/block.h, devices/block.c
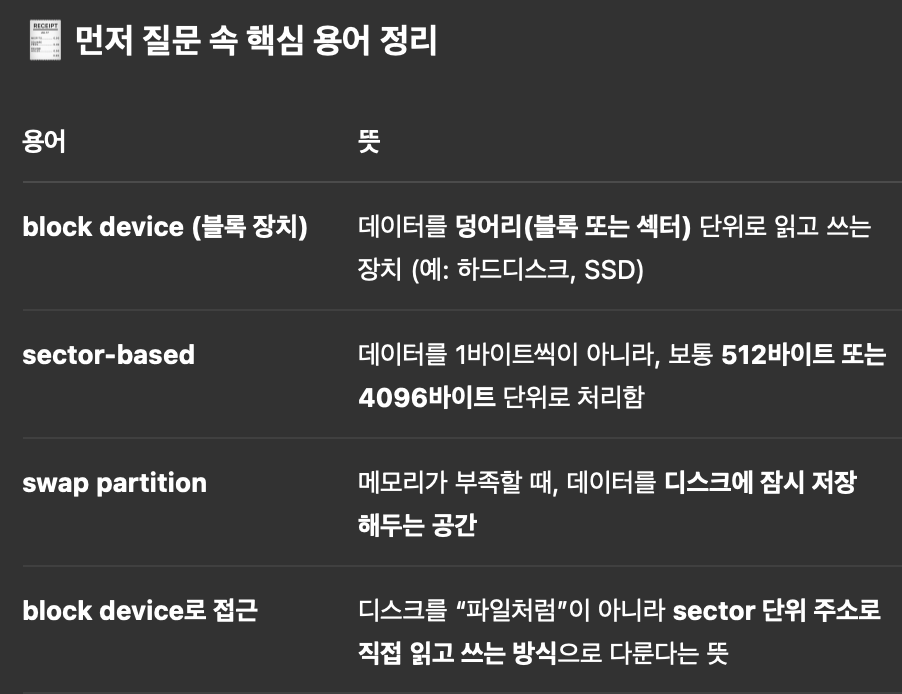
block device에 섹터-based 읽기와 쓰기를 제공한다.
이게 뭔말이여?
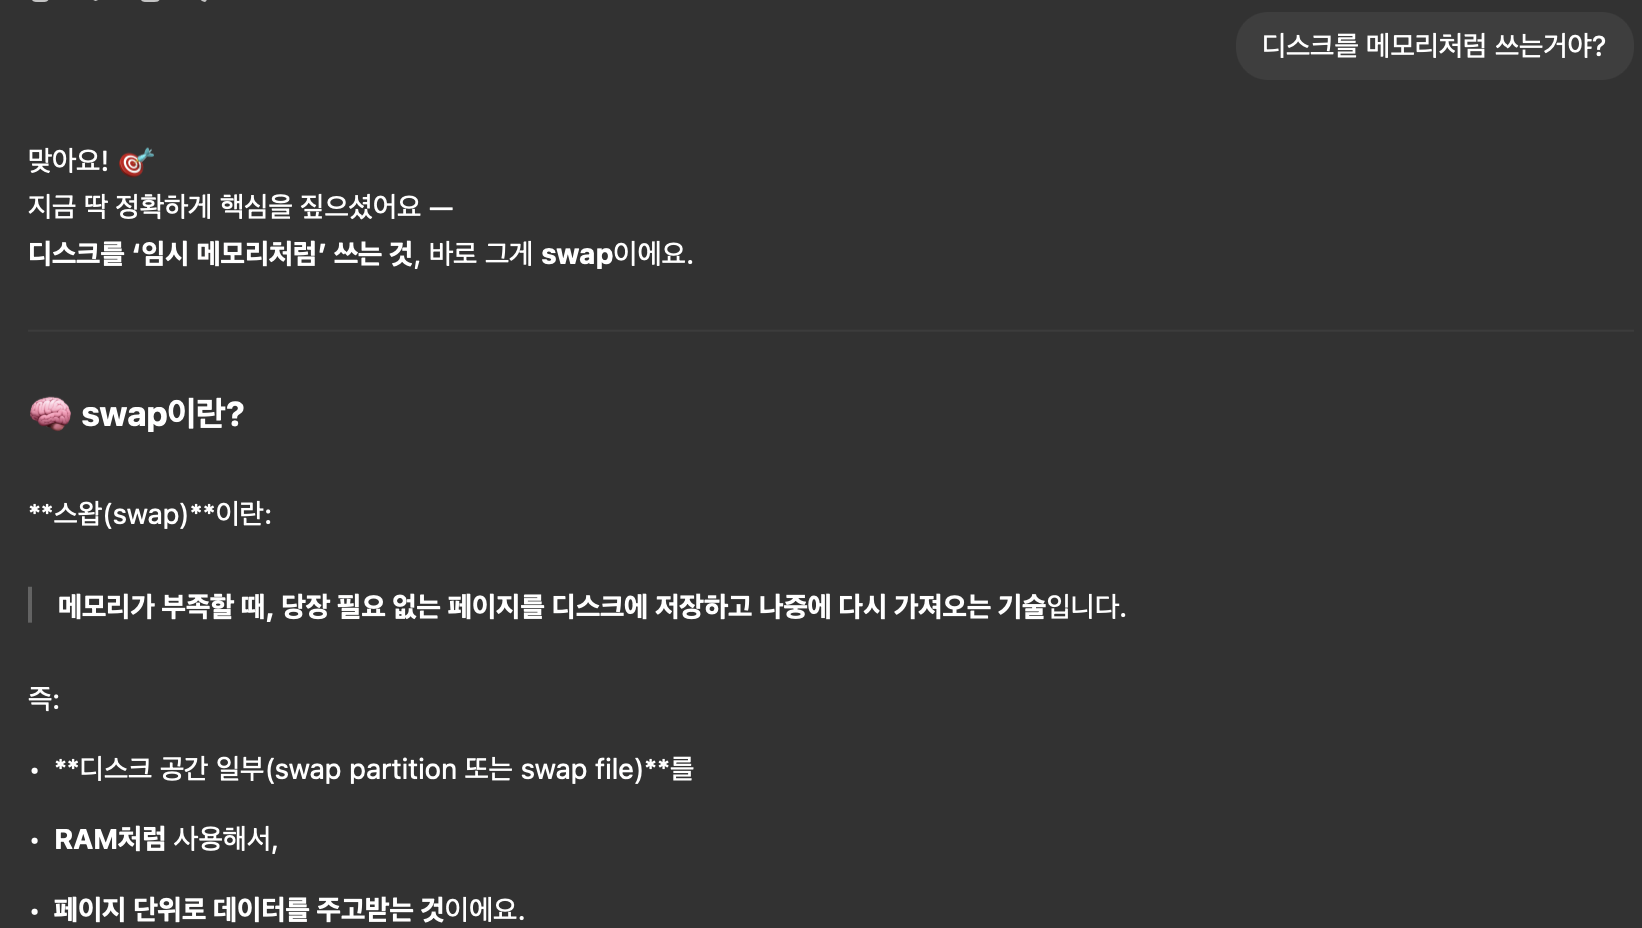
아무튼 이걸 가지고 block device로서 swap partition에 접근할 수 있다고 한다.
물어보자.
Pages
가상 페이지라고도 불리는 페이지는 4096바이트의 길이의 연속적인 지역이다. 반드지 페이지 정렬되어있어야 한다. 페이지의 가상 시작 주소가 페이지 사이즈로 나누어 떨어져야한다. 64비트의 마지막 12비트는 페이지 offset의 가상 주소이다. 상위 비트들은 페이지 테이블에 대한 인덱스로 쓰인다. 64비트 시스템에서는 4레벨 페이지 테이블을 쓰기 때문에 상위 비트들은 다양하게 쓰인다.
커널 페이지는 전역적으로 쓰이기 때문에 어떤 프로세스나 스레드에서도 동일한 위치이지만, 유저 프로세스는 자신의 페이지만 접근할 수 있다.
Frames
physical frame이나 page frame이라고도 불리는 프레임은 물리 메모리의 연속적인 지역이다. 페이지와 비슷하게 프레임 역시 페이지 사이즈이며, 페이지 정렬되어 있다. 64비트 물리 주소는 프레임 넘버와 프레임 offset으로 나누어져있다.
x86-64는 물리 주소 메모리에 직접적으로 접근하는 것을 제공하지 않는다. pintos는 커널 가상 주소를 물리 메모리에 매핑하는 방식으로 우회한다. 커널 가상 주소의 첫 페이지는 물리 메모리의 첫 프레임에 매핑된다. 물리 메모리의 프레임은 커널을 통해 접근할 수 있다. 핀토스는 물리 주소와 커널 가상 주소 간 전환할 수 있는 함수를 제공한다.
Page Tables
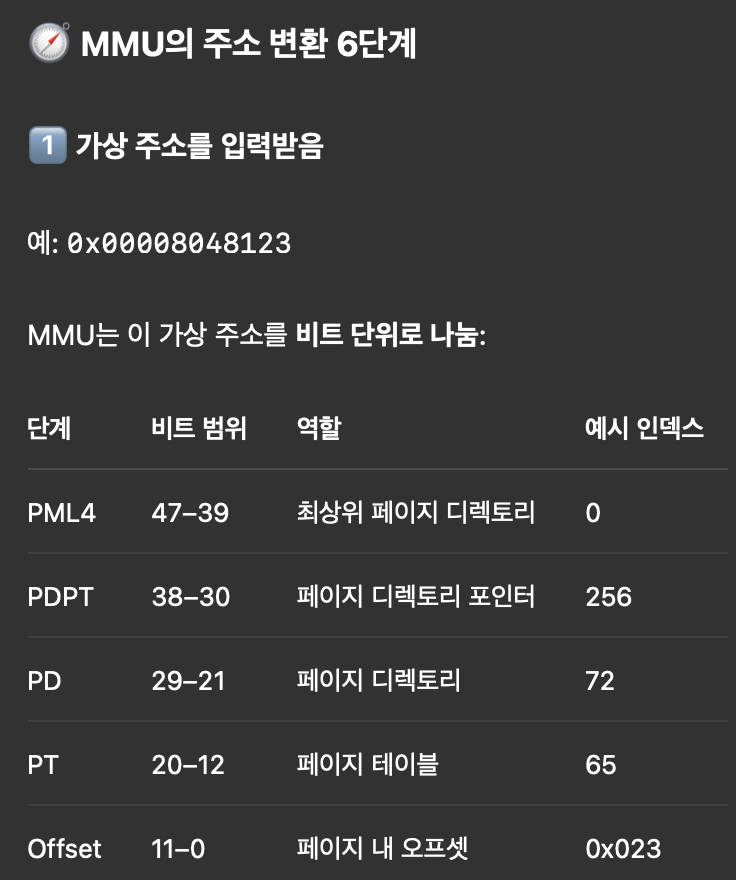
페이지 테이블은 CPU가 가상 주소를 물리 주소로 바꾸기 위해 쓰는 자료 구조이다. 즉, 페이지에서 프레임으로 translate한다. 페이지 테이블 포맷은 x86-64 아키텍처를 따른다. pintos는 threads/mmu.c에서 페이지 테이블을 관리하는 코드를 제공한다.
Swap Slots
swap slot은 swap partition안의 디스크 영역의 페이지 사이즈 공간이다. 슬롯 배치를 결정하는 하드웨어적 제한이 프레임보다는 더 유연하다. 이때 꼭 페이지 정렬을 해야한다.
Need data structure
Supplemental page table
페이지 폴트를 다룰 수 있게 만든다.
Frame table
물리 프레임의 eviction 정책의 효과적인 구현을 가능하게 한다.
Swap table
swap slot의 사용을 추적한다.
위 세 가지 자료구조는 따로 구현하는 것보다 전체적 혹은 부분적으로 resource와 관련된 것끼리 합쳐서 하나의 데이터 구조로 구현하는 것이 편하다.
각 데이터 구조에 어떤 정보가 필요한지, 데이터 구조의 범위는 어떻게 될지 정해야한다.
설계를 간단하게 하기 위해 non-pageable memory에 저장할 수 있다.
Choice of implementation
핀토스는 bitmap 데이터 구조를 활용한다. 각각의 비트는 true나 false가 될 수 있으며, 자원들의 사용을 추적하는데 사용된다. 핀토스는 특정 사이즈로 고정돼 있는데 확장시킬 수 있다.
pintos는 해시테이블 데이터 구조를 사용하기도 하며, 핀토스 해시 테이블은 테이블 사이즈의 넓은 범위의 삽입과 삭제를 효과적으로 지원한다.
더 복잡한 데이터 구조는 더 좋은 장점과 수행능력이 있을 수는 있지만, 구현하기에 쓸데없이 복잡하다.
Managing the supplemental page table
실제 페이지 테이블은 하드웨어에서 관리한다. 하지만 lazy loading, file-backed page, mmap, stack growth 같은 기능은 지원하지 못한다. 따라서 해당 가상 주소 공간의 논리적인 의미를 SPT를 통해 기억한다.
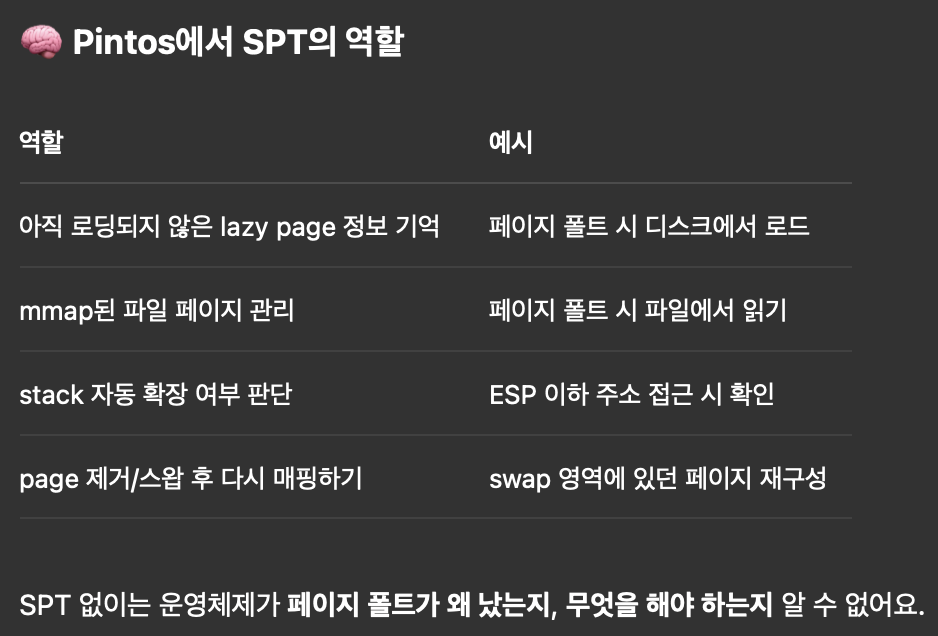
하지만 주소 변환에는 관여하지 않고, 이는 MMU가 담당한다.
Organization of supplemental page table
supplemental 페이지 테이블을 조직하는 두 가지 방법이 있다. 하나는 segment이고 하나는 page이다. 여기서 segment는 연속적인 페이지 그룹이다.
선택적으로 기존 페이지 테이블(pml4)를 활용하여 SPT 기능을 겸하도록 구현할 수 있다. 이는 mmu.c를 수정해야하고 고급 수준 구현자에게 추천한다.
Handling page fault
프로젝트 2에서 페이지 폴트는 버그였지만, 프로젝트 3에서는 파일이나 swap slot에서 가져와야하는 페이지를 가리킨다. exception.c의 page_fault()에서 vm.c의 vm_try_handle_fault()를 통해 구현자의 페이지 폴트 핸들러를 호출한다.
페이지 폴트 핸들러는 다음과 같은 일을 할 수 있어야 한다.
-
supplemental page table에서 fault된 페이지를 찾는다. 메모리 참조가 될 경우 SPT entry를 이용하면 어떤 데이터를 넣어야하는지 찾을 수 있다. 만약 share를 구현한다면 페이지 테이블이 아닌 페이지 프레임에 이미 데이터가 있을 수도 있다. SPT가 접근하려고 했던 주소에 데이터가 있다고 기대하지 못하거나, 페이지가 커널 가상 메모리에 있거나, read-only 페이지에 쓰려고 하는 접근이라면 접근이 타당하지 않게된다. invalid한 접근은 프로세스를 종료한다.
-
페이지를 저장하기 위한 프레임을 얻는다. 만약 sharing을 구현했다면 필요한 데이터는 이미 프레임안에 있을 수 있다.그 경우 프레임에서 찾을 수 있다.
-
파일 시스템이나 swap에서 읽은 데이터를 프레임으로 가지고 오거나 프레임을 0으로 초기화한다. 만약 sharing이 구현됐다면 이 단계는 중요하지 않다.
-
faulting 가상 주소를 위한 페이지 테이블 엔트리가 물리 페이지를 가리키도록 해라.
(이 아래부터는 GPT를 활용한 해석이다... 시간이 얼마남지 않아서 힘을 빌렸다.)
Managing the frame entry
프레임 테이블은 각 프레임마다 하나의 엔트리를 가지고 있다.
각 엔트리에는 해당 프레임을 현재 점유하고 있는 페이지의 포인터(있는 경우)와 그 외에 구현자가 선택한 추가적인 정보가 담긴다.
프레임 테이블은 빈 프레임이 없을 때 어떤 페이지를 제거할지 선택함으로써 Pintos가 페이지 교체 정책을 효율적으로 구현할 수 있도록 해준다.
사용자 페이지에 사용되는 프레임은 palloc_get_page(PAL_USER)를 호출하여 “user pool”에서 할당받아야 한다.
“kernel pool”에서 할당되지 않도록 PAL_USER를 반드시 사용해야 하며, 이를 어기면 일부 테스트 케이스가 예기치 않게 실패할 수 있다.
프레임 테이블 구현 과정에서 palloc.c를 수정하더라도, 두 메모리 풀의 구분은 반드시 유지되어야 한다.
페이지를 제거하는 과정은 대략 다음 단계로 이루어진다.
1. 페이지 교체 알고리즘을 사용하여 제거할 프레임을 선택한다.
2. 해당 프레임을 참조하고 있는 모든 페이지 테이블에서 그 참조를 제거한다. 공유 기능을 구현하지 않았다면, 하나의 페이지만이 해당 프레임을 참조하고 있어야 한다.
3. 필요한 경우 페이지의 내용을 파일 시스템이나 스왑에 저장한다. 프레임이 비워지면, 다른 페이지를 저장하는 데 사용할 수 있다.
Accessed and Dirty Bits
x86-64 하드웨어는 페이지 교체 알고리즘을 구현하는 데 도움이 되는 기능을 제공하는데, 이는 각 페이지에 해당하는 페이지 테이블 엔트리(PTE)에 있는 두 개의 비트를 통해 이루어진다.
CPU는 어떤 페이지에 대해 읽기나 쓰기 동작이 발생하면 해당 PTE의 accessed 비트를 1로 설정하고, 쓰기 동작이 발생하면 dirty 비트를 1로 설정한다.
CPU는 이 비트들을 0으로 초기화하지 않으며 이를 초기화하는 것은 운영체제의 역할이다.
동일한 프레임을 참조하는 두 개 이상의 페이지, 즉 alias가 존재할 수 있다는 점에 유의해야 한다.
alias된 프레임에 접근이 이루어질 경우, accessed와 dirty 비트는 접근에 사용된 페이지의 PTE에만 갱신되고, 다른 alias된 페이지들의 비트는 갱신되지 않는다.
Pintos에서는 모든 사용자 가상 페이지가 그에 대응하는 커널 가상 페이지와 alias 관계를 가진다. 따라서 이러한 alias를 반드시 관리해줘야 한다.
예를 들어, 코드에서 사용자 주소와 커널 주소 모두에 대해 accessed와 dirty 비트를 확인하고 갱신할 수 있다.
혹은 커널이 사용자 데이터를 접근할 때 사용자 가상 주소만을 사용함으로써 이 문제를 회피할 수도 있다.
이 외의 alias는 공유를 구현한 경우나 코드에 버그가 있는 경우에만 발생해야 한다.
Managing the Swap Table
스왑 테이블은 사용 중인 스왑 슬롯과 비어 있는 스왑 슬롯을 추적한다.
이 테이블은 페이지를 프레임에서 스왑 파티션으로 쫓아낼 때
사용되지 않은 스왑 슬롯을 선택할 수 있어야 한다.
또한 페이지가 다시 메모리로 불러와지거나 해당 페이지를 가졌던 프로세스가 종료될 때
스왑 슬롯을 해제할 수 있어야 한다.
vm/build 디렉터리에서 다음 명령어를 사용하면 swap.dsk라는 이름의 디스크를 만들 수 있다:
pintos-mkdisk swap.dsk -- n
이 명령은 nMB 크기의 스왑 파티션을 생성하며, 그 후 Pintos를 실행할 때 swap.dsk는 자동으로 추가 디스크로 붙는다.
또는 --swap-size=n 옵션을 사용해 일회용 nMB 크기의 임시 스왑 디스크를 만들 수도 있다.
스왑 슬롯은 지연 할당(lazy allocation) 방식으로 관리되어야 한다.
즉, 스왑 슬롯은 페이지를 실제로 쫓아내는 순간에만 할당되어야 한다.
실행 파일에서 데이터를 읽어오는 시점에 스왑에 미리 저장해두는 방식은 lazy 방식이 아니다.
특정 페이지를 위해 미리 스왑 슬롯을 예약해두는 것도 허용되지 않는다.
프레임으로 다시 데이터를 불러오면, 해당 스왑 슬롯은 즉시 해제되어야 한다.
Managing Memory Mapped Files
파일 시스템은 주로 read와 write 시스템 콜을 통해 접근된다.
보조적인 인터페이스로는 mmap 시스템 콜을 사용해 파일을 가상 페이지에 “매핑”하는 방식이 있다.
이 방식에서는 프로그램이 파일 데이터를 메모리 명령어를 통해 직접 접근할 수 있다.
예를 들어, 파일 foo가 0x1000 바이트(4KB, 즉 한 페이지) 크기라고 하자.
만약 foo가 주소 0x5000에서 시작하는 메모리에 매핑되었다면,
0x5000부터 0x5fff까지의 메모리 접근은 foo의 각 바이트에 해당하는 데이터를 접근하는 것이 된다.
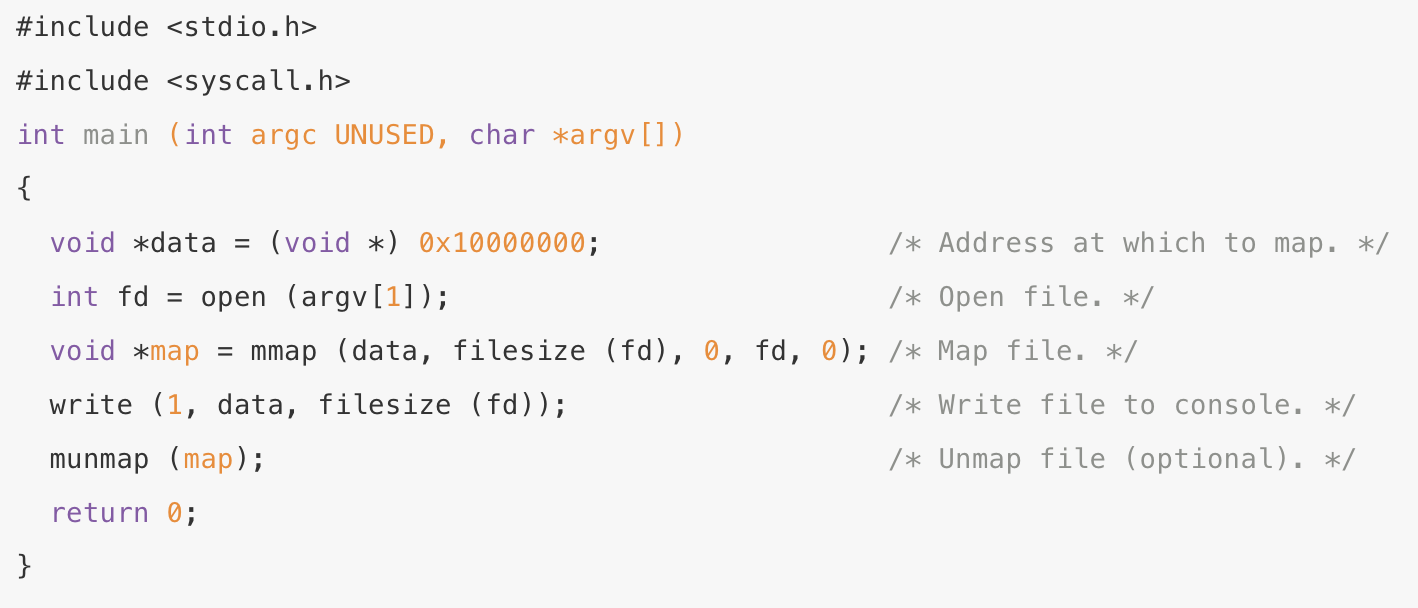
아래는 mmap을 사용하여 파일 내용을 콘솔에 출력하는 프로그램이다.
이 프로그램은 명령줄 인자로 전달된 파일을 열고,
가상 주소 0x10000000에 매핑한 뒤, 해당 매핑된 데이터를 콘솔(fd 1)로 출력하고, 마지막에 파일을 언매핑한다.
메모리 매핑된 파일이 사용하는 메모리 영역을 추적할 수 있어야 한다.
이 기능은 매핑된 영역에서 페이지 폴트가 발생했을 때 이를 적절히 처리하기 위해 필요하다.
또한 매핑된 파일이 프로세스 내의 다른 메모리 구간과 겹치지 않도록 하기 위해서도 반드시 필요하다.
Memory Management
가상 메모리 시스템을 지원하기 위해서는 가상 페이지와 물리 프레임을 효과적으로 관리해야 한다.
이는 어떤 가상 메모리나 물리 메모리 영역이 어떤 용도로, 누가 사용하는지 등을 추적할 수 있어야 한다는 뜻이다.
먼저 서플리멘탈 페이지 테이블(supplemental page table, SPT) 을 다룬 뒤,
그 다음으로 물리 프레임을 관리하게 된다.
이해를 돕기 위해,
문서에서는 “page”는 가상 페이지(virtual page),
“frame”은 물리 페이지(physical page) 를 의미하는 용어로 사용한다.
Page Structure and Operations
struct page
include/vm/vm.h에 정의된 struct page는 가상 메모리 상의 페이지 하나를 나타내는 구조체다.
이 구조체는 해당 페이지에 대해 운영체제가 알아야 할 모든 정보를 담는다.
템플릿에서는 다음과 같이 정의되어 있다:
struct page {
  const struct page_operations *operations;
  void *va;              /* 사용자 가상 주소 */
  struct frame *frame;   /* 이 페이지가 매핑된 물리 프레임 */

  union {
    struct uninit_page uninit;
    struct anon_page anon;
    struct file_page file;
#ifdef EFILESYS
    struct page_cache page_cache;
#endif
  };
};
이 구조체는 세 가지 주요 필드를 가진다:
• operations: 페이지의 동작을 정의한 함수 포인터 집합 (아래에서 설명됨)
• va: 이 페이지의 사용자 가상 주소
• frame: 이 페이지가 매핑된 물리 프레임에 대한 역참조 포인터
그리고 마지막에는 union 필드가 있다.
union은 여러 개의 멤버 중 오직 하나만을 저장할 수 있는 특수한 자료형이다.
즉, 하나의 struct page는 한 번에 uninit_page, anon_page, file_page, 또는 page_cache 중 하나로만 사용된다.
예를 들어 어떤 페이지가 anonymous page라면, 해당 구조체는 struct anon_page anon 멤버를 활성화하고, 그 안에 익명 페이지에 대한 필요한 정보들이 들어 있게 된다.
솔직히 얘가 왜 필요할까? 혹은 얘가 있으면 PTE가 왜 필요할까? 라는 생각이 절로든다.
그래서 GPT한테 물어보면, 아 맞다 그래서 그랬지 다시 생각이 난다.
마치 뭔가를 하려고 일어났는데, 까먹고 다시 앉으니까 다시 할 게 생각이 나는 기분이다.
sturct page와 PTE의 역할을 확실하게 잡고가면 문제없다.
struct page의 역할
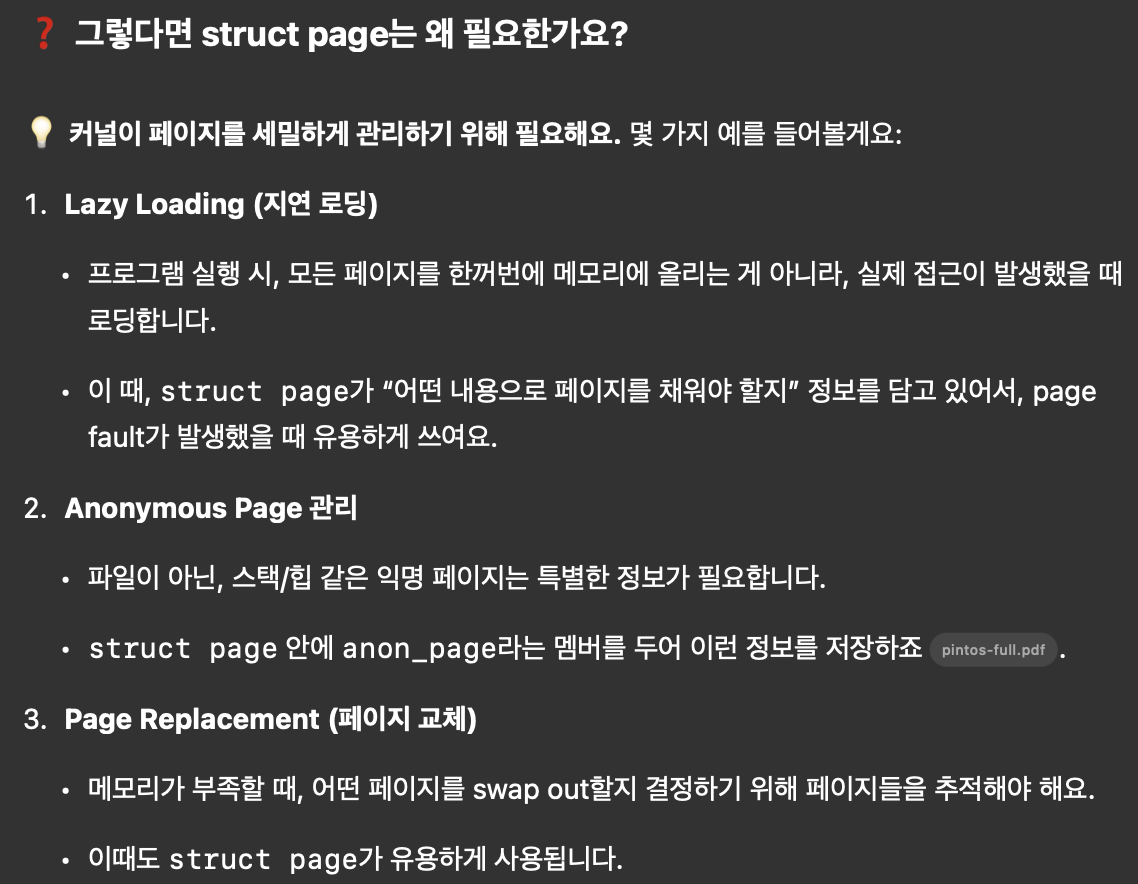
메모리 낭비라고 생각했다.
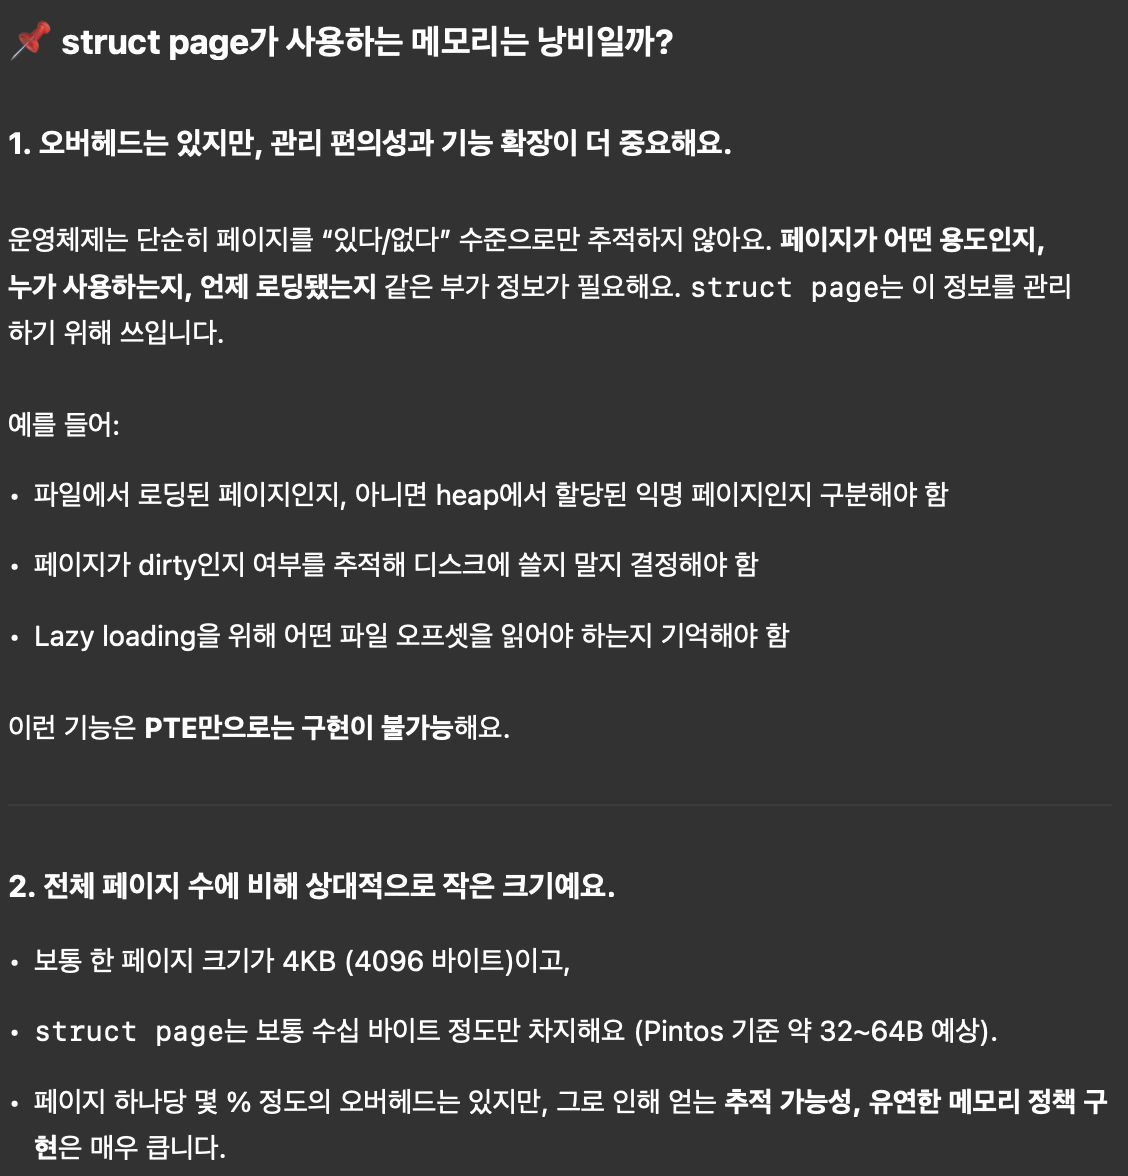
조목조목 따지니 할 말이 없다.
그래도 프로세스가 많아지면 오버헤드가 커지는 거 아니냐고 물어봤다.
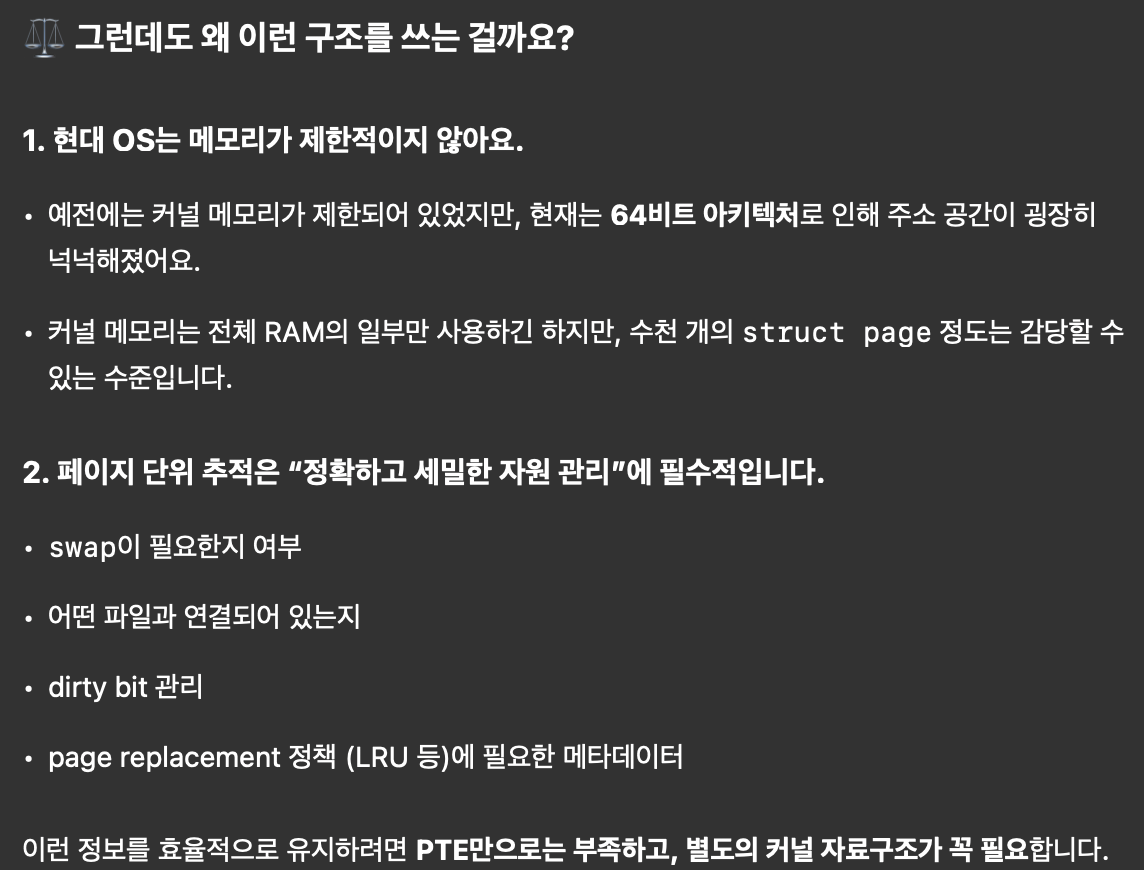
그래 내가 미안..
그리고 추가적으로
다시 되짚어보는 PTE의 역할
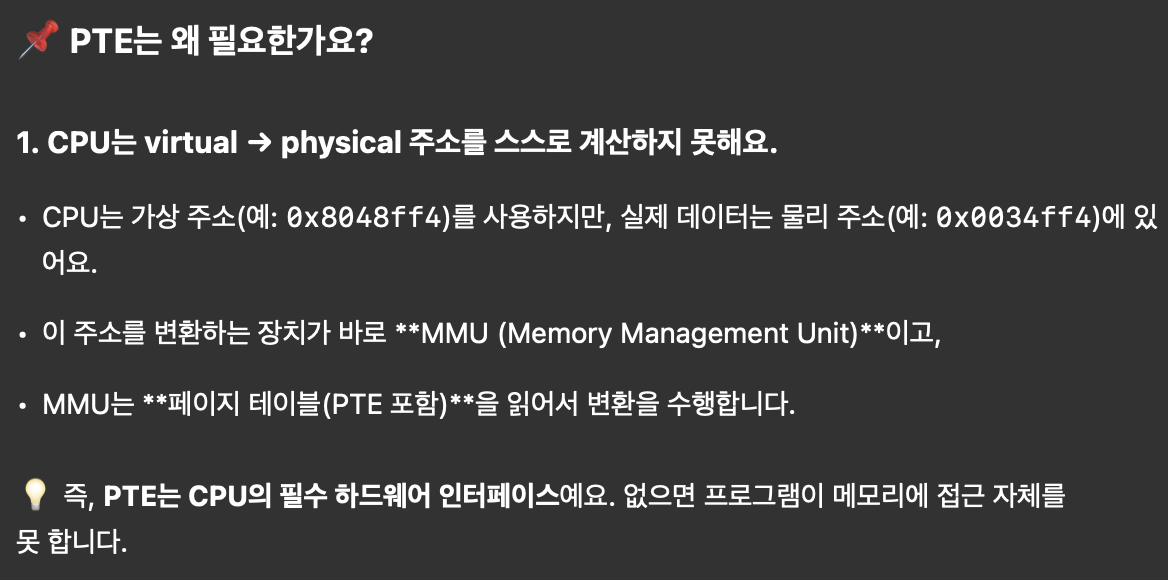
그리고 이어지는
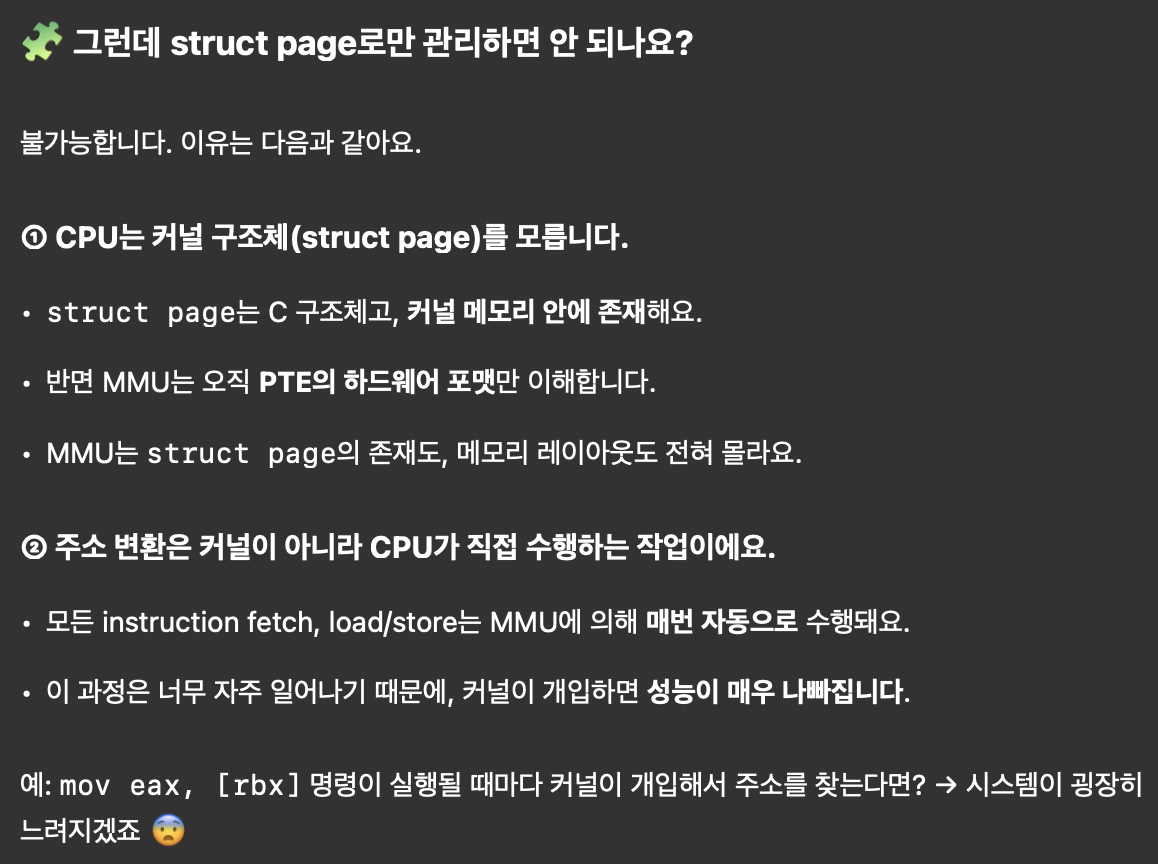
말.
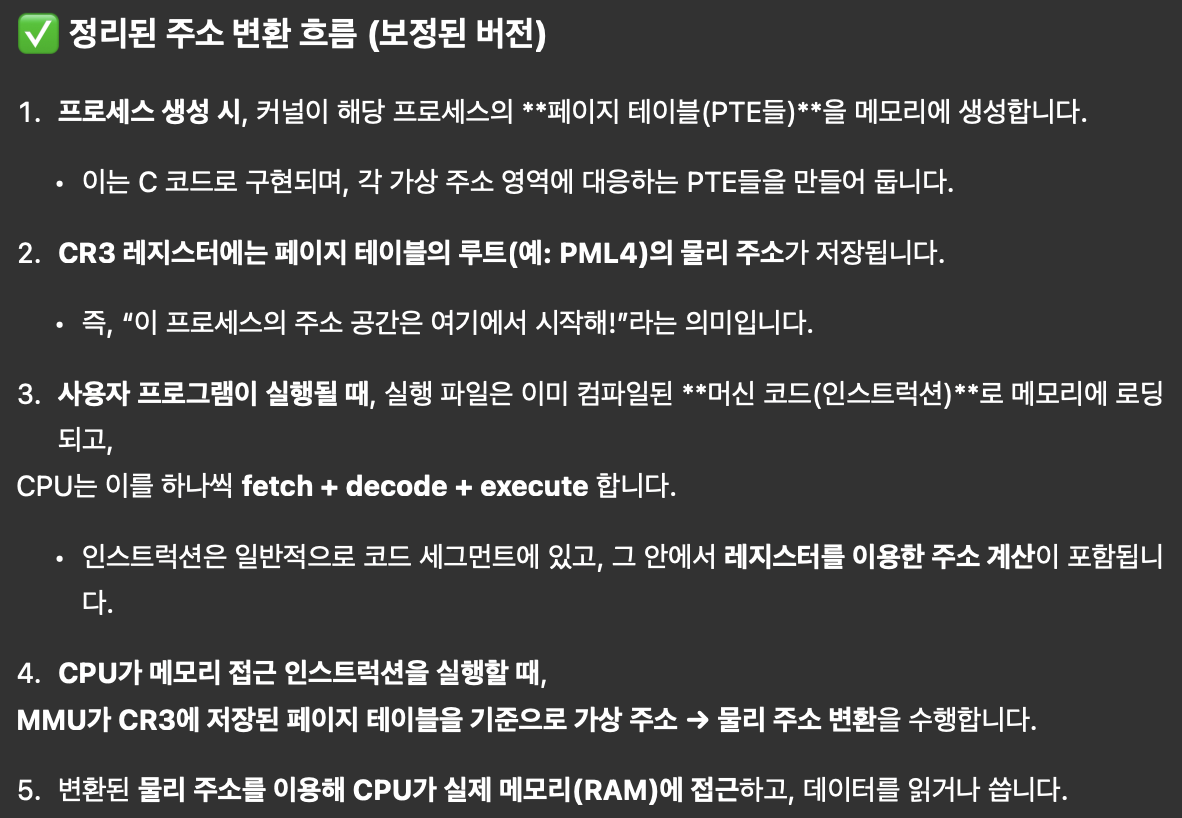
그리고 최종적으로 정리했다.
Page Operations
앞서 설명한 것처럼, 그리고 include/vm/vm.h에 정의된 것처럼, 페이지는 VM_UNINIT, VM_ANON, 또는 VM_FILE의 세 가지 타입 중 하나가 될 수 있다.
페이지에 대해 수행할 수 있는 동작은 여러 가지가 있는데, 예를 들어 swap in, swap out, destroy 같은 작업이 있다.
이러한 작업들은 페이지의 타입에 따라 수행 방식이 서로 다르다.
예를 들어, VM_ANON 페이지를 제거할 때와 VM_FILE 페이지를 제거할 때는 서로 다른 destroy 함수가 호출되어야 한다.
이런 차이를 처리하는 한 가지 방법은 switch-case문을 사용하는 것이다.
하지만 이 프로젝트에서는 객체지향 프로그래밍의 상속 개념을 도입해 이를 해결한다.
물론 C 언어에는 클래스나 상속이라는 개념이 존재하지 않지만,
실제 운영체제(Linux 등)에서 사용하는 방식처럼 함수 포인터를 통해 이를 구현한다.
함수 포인터는 메모리 내의 함수(실행 가능한 코드)를 가리키는 포인터로,
지금까지 배운 다른 포인터들과 마찬가지로 작동한다.
함수 포인터의 장점은 런타임 시점의 값에 따라 어떤 함수를 호출할지를 정할 수 있다는 점이다.
따라서 코드 상에서는 단순히 destroy(page)를 호출하는 것만으로,
컴파일러가 페이지 타입에 따라 올바른 destroy 함수를 찾아 호출해 준다.
include/vm/vm.h에는 이를 위한 함수 포인터 테이블 구조체인 struct page_operations가 정의되어 있다.
이 구조체는 세 개의 함수 포인터를 포함하는 함수 테이블이라고 생각하면 된다.
struct page_operations {
  bool (*swap_in) (struct page *, void *);
  bool (*swap_out) (struct page *);
  void (*destroy) (struct page *);
  enum vm_type type;
};
이제 page_operations 구조체가 실제로 어디서 사용되는지 살펴보자.
include/vm/vm.h에 정의된 struct page를 보면, 그 안에 operations라는 필드가 있는 것을 확인할 수 있다.
이 필드는 각 페이지 타입에 따라 해당되는 함수 포인터 테이블을 가리킨다.
vm/file.c로 가보면, 함수 프로토타입들 위에 file_ops라는 이름의 page_operations 구조체가 선언되어 있다.
이 구조체는 file-backed 페이지를 위한 함수 포인터 테이블이며,
그 안의 .destroy 필드는 file_backed_destroy 함수로 설정되어 있다.
이 함수는 파일 페이지를 제거하는 함수이며, 같은 파일(vm/file.c) 안에 정의되어 있다.
이제 이 file_backed_destroy 함수가 함수 포인터를 통해 어떻게 호출되는지 이해해보자.
예를 들어, vm/vm.c 안의 vm_dealloc_page(page) 함수가 호출된다고 가정하자.
그리고 이 페이지가 VM_FILE 타입의 file-backed 페이지라고 하자.
이 함수 내부에서는 destroy(page)를 호출하게 되는데,
이 destroy(page)는 사실상 include/vm/vm.h에 매크로로 정의되어 있다:
#define destroy(page) if ((page)->operations->destroy) (page)->operations->destroy (page)이 설명은, destroy 함수를 호출하는 것이 실제로는 (page)->operations->destroy(page)를 호출하는 것임을 알려준다.
즉, 페이지 구조체 안에 있는 operations 포인터로부터 destroy 함수를 가져와 호출하는 것이다.
이 페이지가 VM_FILE 타입이기 때문에, .destroy 필드는 file_backed_destroy를 가리키고 있다.
그 결과, 파일 기반 페이지에 해당하는 제거 동작이 수행된다.
 ... 무서운 녀석...
Implement Supplemental Page Table
이 시점에서 Pintos는 가상 메모리와 물리 메모리 사이의 매핑을 관리하기 위해 페이지 테이블(pml4) 을 사용하고 있다. 하지만 이것만으로는 충분하지 않다.
앞서 설명했듯이, 페이지 폴트 처리나 자원 관리를 제대로 수행하려면, 각 페이지에 대한 추가 정보를 저장할 수 있는 서플리멘탈 페이지 테이블(supplemental page table, SPT) 이 필요하다.
따라서 프로젝트 3의 첫 번째 과제로 서플리멘탈 페이지 테이블을 위한 기본 기능을 구현할 것을 권장한다.
vm/vm.c 파일에 supplemental page table 관리 함수를 구현해야 한다.
먼저, Pintos에서 supplemental page table을 어떤 구조로 설계할지 결정해야 한다.
그 구조를 설계한 다음, 해당 구조에 맞춰 아래의 세 가지 함수를 구현해야 한다.
void supplemental_page_table_init (struct supplemental_page_table *spt);서플리멘탈 페이지 테이블을 초기화하는 함수이다.
이 테이블에 어떤 자료구조를 사용할지는 구현자가 자유롭게 선택할 수 있다.
(예: 해시 테이블, 트리, 리스트 등)
이 함수는 다음 두 시점에 호출된다:
• 새로운 프로세스가 시작될 때 (userprog/process.c의 initd 함수 내부)
• 프로세스가 fork될 때 (userprog/process.c의 __do_fork 함수 내부)
즉, 프로세스 단위로 SPT가 생성되어야 하며,
각 프로세스는 자신만의 서플리멘탈 페이지 테이블을 갖는다.
struct page *spt_find_page (struct supplemental_page_table *spt, void *va);주어진 서플리멘탈 페이지 테이블에서 특정 가상 주소 va에 대응하는 struct page를 찾는 함수이다.
탐색에 실패하면 NULL을 반환해야 한다.
bool spt_insert_page (struct supplemental_page_table *spt, struct page *page);주어진 서플리멘탈 페이지 테이블에 struct page를 삽입한다.
이 함수는 해당 가상 주소가 이미 주어진 서플리멘탈 페이지 테이블에 존재하지 않는지를 확인해야 한다.
Frame Management
이제부터는 모든 페이지가 단순히 생성 시점의 메타데이터만을 담고 있는 것이 아니다.
따라서 물리 메모리를 관리하기 위해서는 다른 방식이 필요하다.
include/vm/vm.h 파일에는 물리 메모리(프레임) 를 나타내는 struct frame이 정의되어 있다.
현재 이 구조체는 다음과 같은 형태를 가지고 있다:
/* The representation of "frame" */
struct frame {
  void *kva;
  struct page *page;
};
이 구조체는 현재 두 개의 필드만 가지고 있다.
kva는 커널 가상 주소를 나타내며, page는 해당 프레임에 매핑된 페이지 구조체이다.
프레임 관리 인터페이스를 구현하는 과정에서 구현자는 필요한 만큼 필드를 추가할 수 있다.
vm/vm.c 파일에 다음 세 개의 함수를 구현해야 한다:
• vm_get_frame
• vm_claim_page
• vm_do_claim_page
static struct frame *vm_get_frame (void);palloc_get_page를 호출하여 user pool에서 새로운 물리 페이지를 가져온다.
user pool에서 페이지를 성공적으로 가져온 경우, 프레임도 할당하고 멤버들을 초기화한 뒤 반환한다.
vm_get_frame을 구현한 이후에는 모든 사용자 공간 페이지 할당(PALLOC_USER)은 이 함수를 통해 이루어져야 한다.
할당 실패 시 스왑 아웃 처리는 지금은 구현할 필요 없으며 그런 경우는 일단 PANIC(“todo”)로 표시해두면 된다.
...
아침드라마 뚝딱이다.
bool vm_do_claim_page (struct page *page);페이지를 할당한다는 것은 물리 프레임을 할당한다는 뜻이다.
우선 vm_get_frame을 호출하여 프레임을 확보해야 하며, 이 부분은 템플릿에 이미 구현되어 있다.
그 다음에는 MMU를 설정해야 한다. 다시 말해 페이지 테이블에 가상 주소에서 물리 주소로의 매핑을 추가해야 한다.
반환값은 이 작업이 성공했는지를 나타내야 한다.
bool vm_claim_page (void *va);va에 해당하는 페이지를 할당(claim)한다.
우선 페이지를 가져온 다음, 그 페이지를 가지고 vm_do_claim_page를 호출해야 한다.
Anonymous page
이 프로젝트의 이 부분에서는 디스크 기반이 아닌 메모리 기반의 페이지, 즉 anonymous page를 구현하게 된다.
anonymous mapping은 파일이나 장치를 기반으로 하지 않는다.
이 매핑은 이름이 붙은 파일 소스가 없기 때문에 anonymous(익명)라고 불리며,
파일 기반 페이지와 달리 어떤 파일도 참조하지 않는다.
anonymous 페이지는 실행 중인 프로그램에서 스택이나 힙과 같은 영역에 사용된다.
include/vm/anon.h에는 anonymous 페이지를 표현하는 구조체인 struct anon_page가 정의되어 있으며, 현재는 비어 있지만 구현 과정에서 익명 페이지의 상태나 필요한 정보를 저장할 필드를 추가할 수 있다.
또한 include/vm/page.h에 정의된 struct page도 참고하라.
이 구조체는 모든 종류의 페이지에 대한 공통 정보를 포함한다.
anonymous 페이지의 경우, 해당 구조체 내부에 struct anon_page anon이 포함되어 있다.
Page Initialization with Lazy Loading
지연 로딩(lazy loading)은 메모리의 로딩을 실제로 필요할 때까지 미루는 설계 방식이다.
페이지가 할당되었다는 것은 해당 페이지에 대한 page 구조체는 존재하지만 아직 물리 프레임이 없고, 실제 데이터도 로드되지 않은 상태를 의미한다.
이 데이터는 해당 페이지에 접근할 때, 즉 페이지 폴트가 발생하는 시점에 로드된다.
세 가지 페이지 타입이 존재하므로 각각에 대한 초기화 루틴도 다르다.
이후 섹션에서 자세히 설명되지만 여기서는 초기화 흐름을 상위 수준에서 간략히 소개한다.
먼저 커널이 새로운 페이지 요청을 받으면 vm_alloc_page_with_initializer가 호출된다.
이 함수는 새로운 page 구조체를 할당하고 페이지 타입에 따라 적절한 initializer를 설정한 후, 사용자 프로그램에 제어를 다시 넘긴다.
사용자 프로그램이 실행되다가 아직 로드되지 않은 페이지에 접근하게 되면 페이지 폴트가 발생한다.
그 처리 과정에서 uninit_initialize가 호출되어 앞서 설정한 initializer가 실행된다.
이때 anonymous 페이지의 경우 anon_initializer가, file-backed 페이지의 경우 file_backed_initializer가 사용된다.
페이지는 다음과 같은 생애 주기를 가진다.
initialize → page fault → lazy-load → swap-in → swap-out → … → destroy
각 단계에서 수행해야 할 작업은 페이지 타입(VM_TYPE)에 따라 다르며, 위 설명은 초기화 단계에 해당하는 예시이다.
이 프로젝트에서는 각 페이지 타입에 대해 이러한 상태 전이 과정을 구현하게 된다.
Lazy Loading for Executable
지연 로딩(lazy loading)에서는 프로세스가 실행을 시작할 때, 즉시 필요한 메모리 영역만 메인 메모리에 적재된다.
이는 실행 시점에 전체 바이너리 이미지를 한꺼번에 메모리에 올리는 eager loading보다 오버헤드를 줄일 수 있다.
이러한 lazy loading을 지원하기 위해, include/vm/vm.h에 VM_UNINIT이라는 페이지 타입이 도입되었다.
모든 페이지는 처음에 VM_UNINIT 타입으로 생성된다.
그리고 초기화되지 않은 페이지를 위한 구조체인 struct uninit_page는 include/vm/uninit.h에 정의되어 있다.
초기화되지 않은 페이지를 생성, 초기화, 제거하는 함수들은 vm/uninit.c에 있으며,
이 함수들은 이후에 직접 구현해야 한다.
페이지 폴트가 발생하면 userprog/exception.c의 page_fault 핸들러가 제어를 넘겨주는 대상은 vm/vm.c의 vm_try_handle_fault이다.
이 함수는 먼저 해당 페이지 폴트가 유효한 접근인지 검사한다.
여기서 유효하다는 것은 접근 자체는 유효하지만 아직 데이터가 없는 경우를 의미한다.
만약 유효하지 않은(bogus) 페이지 폴트라면 해당 페이지에 데이터를 적재한 뒤 사용자 프로그램으로 제어를 돌려준다.
유효하지 않은 페이지 폴트의 예시는 다음 세 가지이다:
lazy-loaded 페이지, 스왑된 페이지, 쓰기 방지된 페이지(Copy-on-Write).
지금은 이 중 첫 번째인 lazy-loaded 페이지만 고려한다.
lazy loading에 의한 페이지 폴트라면 커널은 vm_alloc_page_with_initializer에서 미리 설정해둔 initializer 중 하나를 호출하여 세그먼트를 지연 로드하게 된다.
이때 호출되는 함수는 userprog/process.c에 구현할 lazy_load_segment이다.
vm_alloc_page_with_initializer() 함수를 구현하라.
전달받은 vm_type에 따라 알맞은 initializer를 선택한 후, 이를 가지고 uninit_new를 호출해야 한다.
bool vm_alloc_page_with_initializer (enum vm_type type, void *va,
        bool writable, vm_initializer *init, void *aux);
주어진 타입에 따라 초기화되지 않은(uninitialized) 페이지를 생성한다.
uninit 페이지의 swap_in 핸들러는 페이지 타입에 맞게 페이지를 자동으로 초기화하고,
제공된 AUX 값을 인자로 하여 INIT 함수를 호출한다.
struct page를 생성한 뒤에는,
해당 페이지를 프로세스의 supplemental page table(SPT) 에 삽입해야 한다.
이때 vm.h에 정의된 VM_TYPE 매크로를 활용하면 편리하다.
페이지 폴트 핸들러는 호출 체인을 따라가면서 결국 swap_in을 호출하게 되는데,
이때 최종적으로 uninit_initialize에 도달한다.
이 함수의 전체 구현은 제공되며,
다만 네 구현 방식에 따라 uninit_initialize를 수정해야 할 수도 있다.
static bool uninit_initialize (struct page *page, void *kva);첫 번째 페이지 폴트가 발생했을 때 페이지를 초기화한다.
템플릿 코드는 먼저 vm_initializer와 aux를 가져온 다음,
설정된 page_initializer를 함수 포인터를 통해 호출한다.
이 함수는 구현 방식에 따라 수정이 필요할 수 있다.
또한, 필요에 따라 vm/anon.c에 있는 vm_anon_init과 anon_initializer 함수도 자신의 설계에 맞게 수정할 수 있다.
void vm_anon_init (void);anonymous 페이지 서브시스템을 초기화하는 함수이다.
이 함수에서는 anonymous 페이지와 관련된 모든 설정 작업을 수행할 수 있다.
bool anon_initializer (struct page *page,enum vm_type type, void *kva);이 함수는 먼저 page->operations에 anonymous 페이지에 대한 핸들러들을 설정한다.
또한 필요하다면 현재 비어 있는 anon_page 구조체에 정보를 추가하고 갱신해야 한다.
이 함수는 anonymous 페이지(VM_ANON)의 initializer로 사용된다.
userprog/process.c 파일에서 load_segment와 lazy_load_segment를 구현해야 한다.
이 함수들은 실행 파일로부터 세그먼트를 로드하는 기능을 담당한다.
여기서 중요한 점은, 이들 페이지는 모두 지연 로딩되어야 하며,
실제로는 커널이 해당 주소에 대한 페이지 폴트를 가로챌 때 로드가 발생해야 한다는 점이다.
이를 위해 프로그램 로더의 핵심인 load_segment 함수 내부 루프를 수정해야 한다.
루프를 한 번 돌 때마다 vm_alloc_page_with_initializer를 호출하여 지연 로드될 페이지 객체를 만들어야 한다.
그리고 페이지 폴트가 발생하면, 그 시점에 해당 세그먼트가 파일로부터 실제로 로드된다.
static bool load_segment (struct file *file, off_t ofs, uint8_t *upage,
        uint32_t read_bytes, uint32_t zero_bytes, bool writable);
현재 코드는 루프 안에서 파일에서 읽어야 할 바이트 수와 0으로 채워야 할 바이트 수를 계산한다.
그 다음 vm_alloc_page_with_initializer를 호출하여 대기 중인 객체를 생성한다.
이때 초기화 함수에 넘길 aux 인자를 적절히 설정해야 한다.
이를 위해 바이너리를 로드하는 데 필요한 정보를 담을 구조체를 하나 만들어 사용하는 것이 좋다.
static bool lazy_load_segment (struct page *page, void *aux);load_segment에서 vm_alloc_page_with_initializer의 네 번째 인자로 lazy_load_segment가 전달된다는 것을 눈치챘을 것이다.
이 함수는 실행 파일의 페이지를 위한 초기화 함수이며,
페이지 폴트가 발생했을 때 호출된다.
lazy_load_segment는 struct page와 aux를 인자로 받는다.
여기서 aux는 load_segment에서 설정한 정보이다.
이 정보를 이용해 어떤 파일에서 세그먼트를 읽어야 하는지 찾고,
해당 세그먼트를 메모리에 읽어들이는 작업을 수행해야 한다.
userprog/process.c의 setup_stack 함수를 새로운 메모리 관리 시스템에 맞게 조정해야 한다.
첫 번째 스택 페이지는 지연 로딩할 필요가 없다.
즉, 페이지 폴트가 발생할 때까지 기다리지 않고, 프로그램이 로드되는 시점에 즉시 할당하고 초기화하면 된다.
이때 커맨드라인 인자를 포함하여 페이지를 구성할 수 있다.
스택임을 식별할 수 있는 방법도 함께 제공해야 한다.
이를 위해 vm/vm.h에 정의된 vm_type의 보조 마커(auxiliary marker) 들을 사용할 수 있다.
예를 들어 VM_MARKER_0을 사용해 해당 페이지가 스택이라는 것을 표시할 수 있다.
마지막으로, vm_try_handle_fault 함수를 수정하여
페이지 폴트가 발생한 주소에 해당하는 페이지 구조체를 찾아야 한다.
이를 위해 서플리멘탈 페이지 테이블에서 spt_find_page를 통해 검색해야 한다.
모든 요구사항을 구현한 뒤에는 fork를 제외한 프로젝트 2의 모든 테스트가 통과해야 한다.
Supplemental Page Table - Revisit
이제 서플리멘탈 페이지 테이블 인터페이스로 다시 돌아가,
복사(copy)와 정리(clean up) 작업을 지원하는 함수를 구현해야 한다.
이러한 작업은 프로세스를 생성할 때(특히 자식 프로세스를 생성할 때)
또는 프로세스를 종료할 때 필요하다.
이 시점에서 SPT를 다시 다루는 이유는,
앞에서 구현한 초기화 관련 함수들을 이 과정에서 재사용할 수 있기 때문이기도 하다.
vm/vm.c 파일에 다음 두 함수를 구현해야 한다:
• supplemental_page_table_copy
• supplemental_page_table_kill
bool supplemental_page_table_copy (struct supplemental_page_table *dst,
    struct supplemental_page_table *src);
src의 서플리멘탈 페이지 테이블을 dst로 복사한다.
이 함수는 자식 프로세스가 부모의 실행 컨텍스트를 상속받아야 할 때(fork 시)에 사용된다.
src의 서플리멘탈 페이지 테이블에 있는 각 페이지를 순회하면서,
해당 항목을 dst의 서플리멘탈 페이지 테이블에 정확히 복사해야 한다.
이 작업을 위해 uninit 페이지를 할당하고, 즉시 claim해야 한다.
void supplemental_page_table_kill (struct supplemental_page_table *spt);Page Cleanup
m/uninit.c에 uninit_destroy를, vm/anon.c에 anon_destroy를 구현하라.
이 함수들은 초기화되지 않은(uninit) 페이지에 대해 destroy 연산이 호출될 때 사용되는 핸들러다.
uninit 페이지는 실행 도중 다른 타입의 페이지로 변환(transmute)되긴 하지만,
프로세스가 종료될 때까지 초기화되지 않고 남아 있는 경우도 있을 수 있기 때문에,
이러한 경우를 대비해 destroy 핸들러를 구현해야 한다.
static void uninit_destroy (struct page *page);page 구조체가 가지고 있던 자원을 해제하는 함수이다.
페이지의 vm 타입을 확인한 뒤, 그에 따라 적절히 처리해야 한다.
현재는 anonymous 페이지만 처리하면 된다.
나중에 이 함수를 다시 수정하여 file-backed 페이지의 정리 작업도 추가하게 될 것이다.
static void anon_destroy (struct page *page);anonymous 페이지가 가지고 있던 자원을 해제하는 함수이다.
page 구조체 자체를 직접 해제할 필요는 없다.
구조체의 해제는 호출자(caller)가 수행한다.
이제 프로젝트 2의 모든 테스트가 통과되어야 한다.
복붙하면서 느끼는 점인데 내 글을 먹이고 그다음 해석을 시키니
뭔가 굉장이 내가 쓴 글이랑 비슷한 거 같다.
무섭다 무서워~
Stack Growth
프로젝트 2에서는 스택이 USER_STACK부터 시작하는 단일 페이지였고,
프로그램의 실행은 이 크기로 제한되었다.
하지만 이제는 스택이 현재 크기를 넘어 확장되면, 필요에 따라 추가적인 페이지를 할당해야 한다.
이때는 단순히 모든 접근에 대해 할당하는 것이 아니라,
해당 접근이 실제로 스택 접근처럼 보일 때만 새로운 페이지를 할당해야 한다.
따라서 스택 접근을 다른 메모리 접근과 구분할 수 있는 휴리스틱(heuristic)을 고안해야 한다.
한 가지 주의할 점은,
사용자 프로그램이 스택 포인터보다 아래쪽 주소에 쓰기를 시도하는 경우,
일반적인 운영체제에서는 이러한 접근이 유효할 수 있다.
예를 들어, 신호(signal)를 전달하기 위해 커널이 스택에 데이터를 저장해야 할 수도 있기 때문이다.
하지만 x86-64의 PUSH 명령어는 스택 포인터를 조정하기 전에 접근 권한을 먼저 검사한다.
따라서 스택 포인터보다 8바이트 아래 주소에서 페이지 폴트가 발생할 수 있다.
이 점을 고려하여 스택인지 여부를 판별하는 로직을 작성해야 한다.
현재 사용자 프로그램의 스택 포인터 값을 가져올 수 있어야 한다.
시스템 콜이나 사용자 프로그램에 의해 발생한 페이지 폴트 내에서는 syscall_handler() 또는 page_fault()에 전달되는 struct intr_frame의 rsp 멤버를 통해
현재 사용자 스택 포인터 값을 얻을 수 있다.
하지만 페이지 폴트를 통해 잘못된 메모리 접근을 감지하는 방식을 사용할 경우,
한 가지 추가적인 상황을 처리해야 한다.
즉, 커널에서 페이지 폴트가 발생하는 경우이다.
이 경우에는 CPU가 유저 모드에서 커널 모드로 전환될 때만 스택 포인터를 저장하기 때문에,
page_fault()에 전달된 struct intr_frame의 rsp 값은 유저 스택 포인터가 아니라 정의되지 않은 값이 된다.
따라서 이러한 경우를 처리하기 위해
유저 → 커널 모드로 처음 전환될 때의 rsp 값을 struct thread에 저장해두는 방식을 사용하는 등의 별도 조치가 필요하다.
스택 확장 기능을 구현하라.
이를 위해 먼저 vm/vm.c의 vm_try_handle_fault에서 스택 확장을 식별하도록 수정해야 한다.
스택 확장으로 확인되면, vm_stack_growth를 호출하여 스택을 확장해야 한다.
vm/vm.c에 vm_stack_growth 함수도 직접 구현해야 한다.
bool vm_try_handle_fault (struct intr_frame *f, void *addr,
    bool user, bool write, bool not_present);
이 함수는 userprog/exception.c의 page_fault 함수 내에서 페이지 폴트 예외를 처리하는 도중에 호출된다.
이 함수에서는 해당 페이지 폴트가 스택 확장(stack growth)에 의해 처리될 수 있는 유효한 경우인지 확인해야 한다.
만약 그 페이지 폴트가 스택 확장을 통해 처리 가능한 경우라고 판단되면,
fault가 발생한 주소를 인자로 하여 vm_stack_growth를 호출해야 한다.
void vm_stack_growth (void *addr);스택 크기를 늘려서 addr이 더 이상 페이지 폴트를 일으키지 않도록 해야 한다.
이를 위해 하나 이상의 anonymous 페이지를 할당한다.
할당을 처리할 때는 반드시 addr을 PGSIZE 단위로 내림(round down) 하여 정렬해야 한다.
대부분의 운영체제는 스택 크기에 절대적인 제한을 둔다.
일부 운영체제는 이 제한을 사용자가 조정할 수 있도록 허용하기도 하는데,
예를 들어 많은 유닉스 시스템에서는 ulimit 명령어를 통해 조정할 수 있다.
GNU/Linux 시스템에서는 기본적으로 8MB로 설정되어 있는 경우가 많다.
이 프로젝트에서는 스택 크기를 최대 1MB로 제한해야 한다.
이제 모든 stack-growth 관련 테스트 케이스가 통과되어야 한다.
Memory Mapped Files
이 섹션에서는 메모리 매핑된 페이지(memory-mapped pages) 를 구현하게 된다.
anonymous 페이지와 달리, 메모리 매핑 페이지는 파일 기반(file-backed) 매핑이다.
즉, 페이지의 내용은 실제 파일의 데이터와 동기화된 상태를 유지한다.
페이지 폴트가 발생하면, 즉시 물리 프레임이 할당되고
파일에서 해당 내용을 메모리로 복사하여 페이지를 채운다.
메모리 매핑된 페이지가 언매핑되거나 스왑 아웃될 때는,
그동안 메모리에서 변경된 내용이 있으면 해당 변경 사항이 원래 파일에 반영된다.
mmap and munmap System Call
메모리 매핑 파일을 위한 두 가지 시스템 콜인 mmap과 munmap을 구현해야 한다.
가상 메모리 시스템은 mmap으로 매핑된 영역의 페이지들을 지연 로딩(lazy loading) 해야 하며,
매핑된 파일 자체를 백업 저장소(backing store) 로 사용해야 한다.
이를 위해 vm/file.c에 정의된 do_mmap과 do_munmap 함수를 구현하고,
시스템 콜 mmap과 munmap에서는 이 함수들을 활용해야 한다.
void *mmap (void *addr, size_t length, int writable, int fd, off_t offset);파일 디스크립터 fd로 열린 파일의 offset 바이트부터 length 바이트를
addr부터 시작하는 프로세스의 가상 주소 공간에 매핑한다.
파일 전체는 addr을 시작으로 연속된 가상 페이지들에 걸쳐 매핑된다.
파일의 길이가 PGSIZE의 배수가 아닐 경우,
마지막 페이지의 일부 바이트는 파일의 끝을 넘어서게 된다.
이러한 바이트들은 페이지 폴트가 발생했을 때 0으로 채워야 하며
디스크에 다시 쓸 때는 버려져야 한다.
매핑에 성공하면, 이 함수는 파일이 매핑된 가상 주소(addr) 를 반환해야 한다.
실패한 경우에는, 파일을 매핑할 수 없는 주소인 NULL을 반환해야 한다.
mmap 호출은 다음과 같은 경우에 실패할 수 있다:
- 파일 디스크립터 fd로 열린 파일의 길이가 0바이트인 경우
- addr이 페이지 정렬되지 않은 경우
- 매핑하려는 페이지 범위가 이미 매핑된 다른 영역과 겹치는 경우
(예: 스택, 실행 시 로드된 페이지 등)
리눅스에서는 addr이 NULL이면 커널이 적절한 주소를 찾아 매핑하지만,
이 프로젝트에서는 단순화를 위해 지정된 addr에 매핑을 시도하는 방식만 지원한다.
따라서 addr이 0인 경우에는 실패해야 한다.
이는 Pintos 코드가 가상 페이지 0번이 매핑되지 않았다고 가정하기 때문이다.
또한 length가 0인 경우에도 mmap은 실패해야 한다.
콘솔 입출력을 나타내는 파일 디스크립터 역시 매핑할 수 없으므로, 이 경우도 실패 처리해야 한다.
메모리 매핑 페이지 역시 anonymous 페이지와 마찬가지로 지연 할당(lazy allocation) 방식으로 관리해야 한다.
이를 위해 vm_alloc_page_with_initializer 또는 vm_alloc_page를 사용하여 페이지 객체를 생성할 수 있다.
void munmap (void *addr);지정된 주소 범위 addr에 대한 매핑을 해제(unmap) 한다.
이 주소는 반드시 같은 프로세스에서 이전에 mmap을 통해 반환받았고,
아직 munmap되지 않은 가상 주소여야 한다.
프로세스가 exit 또는 다른 방식으로 종료되면, 모든 매핑은 암시적으로 해제된다.
매핑이 해제될 때 그것이 명시적인 munmap 호출이든 암시적인 종료이든 관계없이
프로세스가 해당 페이지에 쓴 내용은 파일에 기록되어야 한다.
수정되지 않은 페이지는 기록되지 않아야 한다.
그 후 해당 페이지들은 프로세스의 가상 페이지 목록에서 제거된다.
파일을 닫거나 삭제해도, 이미 존재하는 매핑은 해제되지 않는다.
매핑은 생성된 이후 munmap이 호출되거나 프로세스가 종료될 때까지 유효하며
이는 유닉스의 동작 방식과 동일하다.
각 매핑마다 독립적인 파일 참조를 갖기 위해 file_reopen 함수를 사용해야 한다.
두 개 이상의 프로세스가 동일한 파일을 매핑하더라도
서로 일관된 데이터를 볼 필요는 없다.
유닉스는 동일한 물리 페이지를 공유하는 방식으로 이를 처리하며,
mmap 시스템 콜에는 공유 여부(공유 vs. 복사-온-쓰기)를 지정하는 인자도 있다.
필요하다면 vm/vm.c의 vm_file_init과 vm_file_initializer를 구현 방식에 맞게 수정해도 된다.
void vm_file_init (void);파일 기반 페이지 서브시스템을 초기화하는 함수이다.
이 함수에서는 파일 기반 페이지와 관련된 설정 작업을 자유롭게 수행할 수 있다.
bool file_backed_initializer (struct page *page, enum vm_type type, void *kva);파일 기반 페이지를 초기화하는 함수이다.
이 함수는 먼저 page->operations에 파일 기반 페이지용 핸들러들을 설정한다.
또한 해당 페이지가 어떤 파일을 기반으로 하고 있는지 등의 정보를 page 구조체에 기록해야 할 수 있다.
static void file_backed_destroy (struct page *page);파일 기반 페이지를 제거하는 함수로 이때 연결된 파일을 닫아야 한다.
만약 페이지의 내용이 dirty 상태라면 파일에 변경된 내용을 반드시 다시 기록(write-back) 해야 한다.
page 구조체 자체를 이 함수에서 해제할 필요는 없다.
file_backed_destroy를 호출한 상위 함수가 구조체 해제를 담당해야 한다.
Swap In/Out
메모리 스와핑(swap)은 물리 메모리의 사용 효율을 극대화하기 위한 메모리 회수 기법이다.
메인 메모리의 프레임들이 모두 할당되어 더 이상 사용자 프로그램의 메모리 요청을 처리할 수 없게 되면, 운영체제는 현재 사용되지 않고 있는 메모리 프레임들을 디스크로 스왑 아웃함으로써 메모리 자원을 확보한다.
이러한 스와핑 작업은 운영체제에 의해 자동으로 수행된다.
시스템이 메모리를 모두 소진한 상태에서 메모리 할당 요청이 들어오면,
운영체제는 교체할 페이지 하나를 선택해 디스크(스왑 영역)에 저장하고 그 프레임을 다른 프로세스에 사용 가능하도록 비운다.
이후 해당 프로세스가 스왑된 페이지에 다시 접근하면, 운영체제는 해당 내용을 디스크에서 다시 메모리로 가져와 복원한다.
스왑 대상으로 선택된 페이지는 anonymous 페이지일 수도 있고 file-backed 페이지일 수도 있다.
이 섹션에서는 이 두 경우를 각각 처리하게 된다.
모든 스왑 동작은 직접 호출되지 않고, 함수 포인터 형태로 호출된다.
이 함수 포인터들은 struct page_operations 안의 멤버로 존재하며,
각 페이지 타입의 initializer가 이 함수 포인터를 등록한다.
Anonymous Page
vm/anon.c에 있는 vm_anon_init과 anon_initializer를 수정해야 한다.
anonymous 페이지는 고유한 backing 파일이 없기 때문에 이 페이지들을 스왑하기 위해서는 임시 저장소로 제공되는 swap 디스크를 사용해야 한다.
anonymous 페이지가 메모리에서 쫓겨날 경우, 해당 페이지의 데이터를 swap 디스크에 저장하고, 다시 접근할 때는 swap 디스크에서 데이터를 불러와 복원해야 한다.
따라서 anonymous 페이지의 스왑 동작을 구현하기 위해
swap 디스크를 사용하는 코드를 anon_initializer나 이후 스왑 관련 함수에 작성해야 한다.
void vm_anon_init (void);이 함수에서는 swap 디스크를 설정해야 한다.
또한 swap 디스크에서 사용 중인 영역과 비어 있는 영역을 관리할 자료구조가 필요하다.
swap 영역은 PGSIZE(4096바이트) 단위로 관리된다.
bool anon_initializer (struct page *page, enum vm_type type, void *kva);이 함수는 anonymous 페이지의 초기화 함수이다.
스왑을 지원하려면 anon_page에 정보를 추가해야 한다.
이제 vm/anon.c에 anon_swap_out과 anon_swap_in을 구현해야 한다.
스왑 인은 스왑 아웃된 후에만 가능하므로
먼저 anon_swap_out을 구현하는 것이 좋다.
페이지의 데이터를 swap 디스크로 옮기고
다시 메모리로 안전하게 가져와야 한다.
static bool anon_swap_in (struct page *page, void *kva);anonymous 페이지를 스왑 디스크에서 메모리로 불러오는 작업이다.
데이터가 저장된 위치는 페이지가 스왑 아웃될 때
page 구조체에 저장해 두었어야 한다.
스왑 인이 끝나면 스왑 테이블을 갱신해야 한다.
static bool anon_swap_out (struct page *page);anonymous 페이지를 메모리에서 스왑 디스크로 내보내는 작업이다.
먼저 스왑 테이블에서 빈 슬롯을 찾아 페이지의 데이터를 그 슬롯에 복사한다.
데이터가 저장된 위치는 page 구조체에 기록해야 한다.
빈 슬롯이 없다면 커널을 panic 시켜도 된다.
 가스라이팅도 살짝 하는 것 같다.
File-Mapped Page
파일 기반 페이지의 내용은 파일에서 오므로, 매핑된 파일을 backing store로 사용해야 한다.
즉, 파일 기반 페이지를 스왑 아웃할 때는 해당 파일로 내용을 다시 써야 한다.
vm/file.c에 file_backed_swap_in과 file_backed_swap_out을 구현하라.
필요하다면 file_backed_init과 file_initializer도 너의 설계에 맞게 수정해도 된다.
static bool file_backed_swap_in (struct page *page, void *kva);파일에서 내용을 읽어와 kva에 해당하는 페이지를 스왑 인한다.
이때는 파일 시스템과의 동기화가 필요하다.
static bool file_backed_swap_out (struct page *page);페이지의 내용을 파일에 다시 써서 스왑 아웃한다.
먼저 페이지가 dirty한지 확인하고, 그렇지 않다면 파일을 수정할 필요는 없다.
스왑 아웃 후에는 페이지의 dirty 비트를 끄는 것을 잊지 말아야 한다.
COW
Lecture
vm = supplemental_page_table
vm_entry = supplemental_page (struct page)
Implement Virtual Address
- Enable Demand paging/Swapping
- Enable Stack growth
- Dynamic page allocation for page fault on stack
- Implement Memory mapped file
- Implement mmap() and munmap()
- For a physical page differentiate file_backed page and anonymous page
- Enable Accessing User Memory
page in VM
- text: part of file
- Data: part of file
- BSS: in memory
- Heap: in memory
- mmap() ed region: part of file
page fault in Pintos
static void
page_fault (struct intr_frame *f) {
	bool not_present;  /* True: not-present page, false: writing r/o page. */
	bool write;        /* True: access was write, false: access was read. */
	bool user;         /* True: access by user, false: access by kernel. */
	void *fault_addr;  /* Fault address. */

	/* Obtain faulting address, the virtual address that was
	   accessed to cause the fault.  It may point to code or to
	   data.  It is not necessarily the address of the instruction
	   that caused the fault (that's f->rip). */

	fault_addr = (void *) rcr2();

	/* Turn interrupts back on (they were only off so that we could
	   be assured of reading CR2 before it changed). */
	intr_enable ();


	/* Determine cause. */
	not_present = (f->error_code & PF_P) == 0;
	write = (f->error_code & PF_W) != 0;
	user = (f->error_code & PF_U) != 0;

#ifdef VM
	/* For project 3 and later. */
	if (vm_try_handle_fault (f, fault_addr, user, write, not_present))
		return;
#endif

	/* Count page faults. */
	page_fault_cnt++;

	/* If the fault is true fault, show info and exit. */
	exit(-1);
	printf ("Page fault at %p: %s error %s page in %s context.\n",
			fault_addr,
			not_present ? "not present" : "rights violation",
			write ? "writing" : "reading",
			user ? "user" : "kernel");
	kill (f);
}
강의에서는 kill을 수정하라고 한 것 같긴한데
ifdef VM문이 있어서 괜찮을 것 같다.
Supposed to implement
32비트 핀토스 기준이므로 다를 수도 있음
- virtual page number(VPN)
- read/write permission
- type of virtual page
- a page of ELF executable file ( unwritable, unmodifiable )
- a page of general file
- a page of swap area ( page is anonymous )
- reference to the file object and offset
- amount of data in the page
(generally 4kb, but last page of file is not page size ) - location in the swap area
- in-memory flag(is it in memory?)
vm_entry
vm_entry는 구조체이다.
page table로의 진입점같은데 확실하지는 않다.
thread 구조체에 pagedir이 있고 vm이 있다.
vm은 매직 영역 아래에 위치한다.
vm은 hash table 자료구조를 가지는데, vm 안의 bucket은 vm_entry(vme)를 가리키고 있고
vm_entry는 링크드 리스트처럼 연결되어 있다.
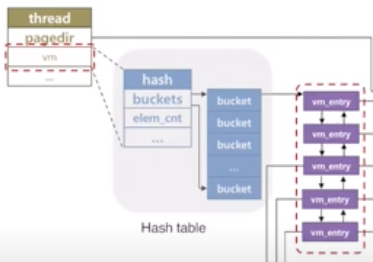
해당 함수를 파일에서 못 찾았는데
뭔가 느낌이 supplementary page table이랑 비슷하다.
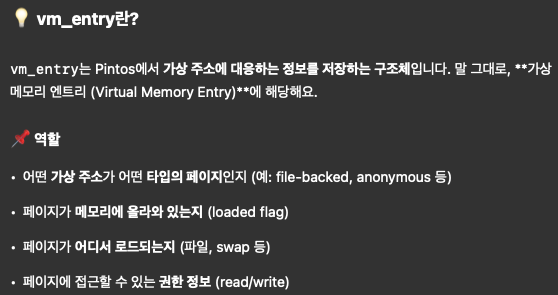 이고
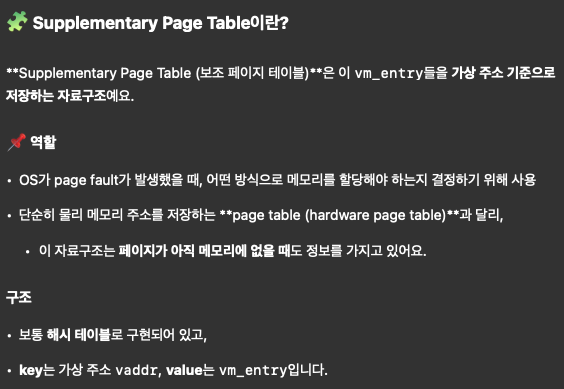 라고 하는걸 보니
사진에서 스레드의 vm에 해당하는 게 얘가 아닐까 싶다.
그리고 vm_entry에 해당하는 것은 page같다.
start_process
hash table을 초기화하기 위해 start_process(void* file_name)를 수정해야한다. 해당 함수도 주어진 파일에서는 찾을 수 없는데 매개 변수를 void* file name으로 받으니 이와 유사한 함수를 찾아야할 것 같다.
해당 함수에서는 vm_entries의 set인 해시 테이블을 초기화하고
인터럽트 프레임 초기화 및 실행파일을 적재한다.
그리고 내가 봤을 때 가장 유사한 함수는 initd 같다.
static void
initd (void *f_name) {
#ifdef VM
	supplemental_page_table_init (&thread_current ()->spt);
#endif

	process_init ();

	if (process_exec (f_name) < 0) {
		PANIC("Fail to launch initd\n");
	}

	NOT_REACHED ();
}
ifdef 안에도 supplemental page table 초기화가 있는 걸보니 맞는 것 같다.
interrupt frame init이랑 load executable은 process_exec에서 해준다.
process_exit
할당했던 해시테이블을 당연히 deallocate 해줘야한다.
Pintos with VM
VM을 사용하지 않았던 pintos를 original pintos라고 하면 original pintos와 vm pintos 사이에는 다음과 같은 차이점이 있다.
original pintos
모든 elf 이미지를 읽고 물리 메모리에 할당함.
- load_segment()를 사용하여 data와 code segment를 읽음
- setup_stack을 사용하여 물리 메모리에 스택을 할당함.
vm pintos
- 페이지 테이블을 할당할 때, 모든 entry는 invalid하다. (아직 매핑되지 않았다.)
- 물리 메모리를 할당하는 대신 각 페이지를 위한 vm_entry를 할당한다.
- load_sement를 수정해야 한다.
- 가상 주소 공간과 관련된 구조체를 초기화하는 함수를 추가한다.
- 다음을 제거해야 한다.
- 가상 주소 공간에 바이너리 파일을 적재하는 것
(페이지 할당, 데이터 적재, 페이지 테이블 세팅)
- 가상 주소 공간에 바이너리 파일을 적재하는 것
- 다음을 추가해야 한다.
- vm_entry 구조체 할당 (malloc을 사용한다.)
- 필드값 초기화 (offset, size, zero padding...)
- vm_entry를 해시테이블에 삽입
- 다음을 제거해야 한다.
- 가상 주소 공간과 관련된 구조체를 초기화하는 함수를 추가한다.
modify stack initialization
original
- single 페이지를 할당함
- 페이지 테이블을 세팅
- 스택 포인터 세팅
Add
- 4kb 스택의 vm_entry 생성
- vm_entry 필드값 초기화
- 해시테이블에 삽입
design: demand paging
- access to memory and page_fault
- vm_entry check find_vme()
- memory allocation handle_mm_fault()
- disk->memory data load load_file()
- set up page table install_page
TODO
manage the page fault
- page fault가 발생하면 주소의 permission과 validation을 확인하고 에러가 발생하면 segmentation fault를 발생시켜 종료한다.
- kill과 관련된 코드를 삭제한다. (exit(-1)부터 kill(f)까지)
- fault 주소의 validation을 확인한다.
- 새로운 페이지의 fault 핸들러를 정의하고 호출한다.
handle_mm_fault(struct vm_entry* vme)
implement page fault handler
- page fault가 발생하면 물리 메모리를 할당한다.
- 디스크에서 물리 메모리로 파일을 load한다.
load_file(void* kaddr, struct vm_entry* vme)을 사용한다.
- 물리 메모리에 적재한 뒤에 연관된 PTE를 업데이트 한다.
install_page(void* upage, void* kpage, bool writable)을 사용한다.
load the file to physical memory
- 물리메모리가 할당되면, 디스크에서 물리 메모리로 file page를 적재한다.
load_file (void* kaddr, struct vm_entry* vme)- 디스크에서 물리 메모리로 페이지를 적재하는 함수
- vme의 file, offset으로 kaddr에 페이지를 적재할 수 있게 구현해야 함.
- file_read_at과 file_read, file_seek을 활용해야 함
- 4kb 페이지를 다 채우지 못할 경우 0으로 남은 공간을 채움.
- 성공하면 true 반환
modify makefile.build
?
# No virtural memory code yet아래에
#vm_SRC = vm/file.c
vm_SRC = vm/page.c
라고 돼 있음
make.tests에 timeout = 60은 짧을 수 있음. 따라서 120으로 바꾸는 것이 테스트에 좋음.
Paging/Swapping
todo (swapping)
- victim 페이지를 swap space에 저장함.
- demand paging을 통해 메모리에 다시 적재됨.
hardware support
- 메모리 공간에 쓰여지면 하드웨어가 page table의 dirty bit을 1로 설정함.
- 페이지가 참조될 때마다 하드웨어가 accessed bit을 1로 설정함
- dirty bit가 1로 설정된 페이지가 victim으로 설정되면 disk에 변경된 파일을 저장해야함.
- 하드웨어는 accessed bit을 0으로 설정하지 않음.
physical page frame?
이게 아직은 뭘 의미하는지 모르겠다. frame을 위한 데이터 구조를 만들어야하나 싶다.
경로는 pintos/src/vm/page.h이긴하다.
gpt 말로는 struct page가 이거라고 한다.
유저 페이지를 포함하는 물리 페이지를 대표하는 데이터 구조?
- 페이지의 물리적 주소
- 물리 페이지가 매핑된 가상 페이지 객체로의 역참조
- 물리 페이지가 포함된 스레드로의 역참조
- lru: field for list ??
(데이터 구조는 doubly linked list, hash table 사용해도 되는 듯?)- 전역 변수
- 페이지 목록들을 리스트로 가지고 있음.
swap out
- Select victim page
- If necessary, write to disk
- Nullify entry
Managing swap partition
- swap partition은 swap slot(4kb) 단위로 관리됨.
- 디스크 영역이지만 메모리처럼 행동함.
- swap partition을 유지하기 위해 OS는 swap bitmap이라는 자료구조를 사용함.
(메모리에서 전역 변수임) - bitmap은 free slot을 찾기위해 사용됨.
| swap bitmap(memory) | 0 | 1 | 1 | 1 | 0 | 1 | 0 | 1 |
|---|---|---|---|---|---|---|---|---|
| swap partition(disk) | Free | Used | Used | Used | Free | Used | Free | Used |
- system crash가 발생하면 bitmap 데이터는 날아가고, 영역을 사용하고 있는지 혹은 free인지 모르게 됨.
- 작은 swap 영역을 사용한다면 swap bitmap을 first fit으로 탐색함.
funtions offered by pintos
- swap partition은 핀토스에서 block device*로 제공됨
* block device: 고정된 크기(512 bytes~ 4KB)의 블록 단위로 I/O를 처리하는 장치Implementation
- LRU
- struct page의 리스트
- 유저 프로세스에 할당된 물리 페이지의 리스트
- 리스트에서 물리 페이지 프레임 할당과 해제
- swapping을 위한 페이지 폴트 핸들러 수정
- before: 페이지 폴트 발생시 물리 페이지 할당, 할당한 페이지가 없으면 종료
- after: 페이지 폴트 발생시 LRU 리스트로부터 물리 페이지 할당, 할당한 페이지가 없으면 페이지에서 swap
- handle_mm_fault()에서 switch case문 사용해서 page type에 따라 코드 구현하기
- VM_BIN: load_file
- VM_ANON: (swap in code)
Growing stack
- 기존 pintos 스택 사이즈는 4KB로 고정
- 스택을 확장 가능하게 만들기
- 프로세스가 스택 바깥의 주소에 접근할 때 expanding stack에 의해 다뤄질 수 있으면 스택 확장
(access address < stack pointer -32) expand stack
- 프로세스가 스택 바깥의 주소에 접근할 때 expanding stack에 의해 다뤄질 수 있으면 스택 확장
- 스택의 maximum size는 8MB
Memory mapped file
mmap (int fd, void* addr)
- 파일 사이즈에 맞는 페이지 수만큼 vm_entry 생성
- virtual page pool(hash table)로 삽입
- demand paging
- load file data into memory by demand paging
- mmaped된 페이지는 파일 내의 원래 위치로 swap out됨
- 4KB 단위로 페이지를 할당하며, 파일 사이즈 때문에 남는 공간은 0으로 채워짐
(ex. 10KB 파일 => 4KB 페이지 3개, 마지막 페이지의 2KB는 0으로 채워짐) - mapping_id를 반환함. 프로세스에서 매핑된 파일을 식별하기 위한 유일한 id임.
- fail인 경우
- 파일 사이즈가 0
- 주소가 페이지 정렬되어있지 않은 경우
- 주소가 이미 사용하고 있는 경우
- 주소가 0인 경우
- 표준 입출력은 매핑되지 않음
munmap (mapid_t mapid)
mmap_list에서 이전에 unmap되지 않은 매핑을 unmap함
그 외
- 프로세스가 종료되면 프로세스의 모든 매핑은 암시적으로 unmap 해야됨.
- 매핑이 언맵될 때, 페이지들은 파일에 다시 써야함.
- munmap을 하면 페이지는 프로세스 가상 페이지 리스트에서 제거됨
- 매핑이 만들어지면, 파일이 닫히거나 삭제되는 것과는 관련없이 unmap될 때까지는 유효함.
- 둘 이상의 프로세스가 같은 파일을 매핑하면 동시에 같은 뷰를 볼 필요는 없음. ㅌㅌ
struct mmap_file
- 매핑된 파일의 정보를 저장하는 데이터 구조
- 매핑 아이디
- 매핑된 파일 객체
- 매핑 파일 리스트 element
- vm_entry 리스트
handle_mm_fault
- vm_entry 타입이 VM_FILE일 경우 데이터를 load함
process_exit
- 프로세스가 종료될 때 매핑 리스트와 관련된 모든 vm_entry를 해제함.
thread
- mmap_list 구조 추가
Pinning page
- 시스템 콜이 호출되는 동안 접근한 페이지의 evicting을 막음
- 각 물리 페이지에 대해 pinning flag를 정의함.
- 모든 시스템 콜마다
- 가상 페이지를 찾고 관련된 물리 페이지를 pin함
- 시스템 콜이 리턴한 이후, 시스템 콜 핸들러가 리턴하기 전에 페이지를 unpin함
- swapping handler는 pin된 페이지를 선택하면 안됨.
Keyword
Virtual memory
- 가상 메모리는 각 프로세스에게 독립적이고 연속적인 메모리 공간을 제공하는 추상화이다
- 이를 통해 프로세스는 마치 자신만이 메모리를 사용하는 것처럼 동작하며, 실제 물리 메모리와는 분리되어 있다.
주소 공간
- 가상 주소(Virtual Address): 프로세스가 사용하는 주소로, 운영체제가 이를 물리 주소로 변환
- 물리 주소(Physical Address): 실제 메모리의 주소로, 하드웨어가 접근하는 주소
- CPU는 가상 주소를 생성하고, MMU(Memory Management Unit)가 이를 물리 주소로 변환
VM의 목표
- 투명성 (transparency) : OS는 실행 중인 프로그램이 전용 물리 메모리를 소유한 것처럼 보이게 한다
- 효율성 (efficiency) : 실행 시간, 메모리 공간의 효율성
- 보호 (protection) : OS는 프로세스를 다른 프로세스로 부터 보호하며 OS 본인을 프로세스로부터 보호한다
- 보호 성질을 이용하여 프로세스를 서로 고립(isolate)시킨다. 각 프로세스는 독립적으로 실행된다
Page table
Why Paging?
- 문제 : VM의 Segmentation (Base + Bound)방식은 연속된 물리 메모리를 요구 → 외부 단편화 발생
- 해결책 : 주소 공간을 고정 크기의 페이지로 나누어 비연속적인 물리 메모리 할당
- 페이징은 내부 단편화는 있지만, 외부 단편화를 제거한다
- 내부 단편화 : 파티션의 크기가 프로세스의 크기보다 커서 메모리가 남지만, 다른 프로세스가 사용할 수 없는 상태
- 외부 단편화 : 남아있는 메모리의 크기가 실행하고자 하는 프로세스보다 크지만, 연속적이지 않은 공간에 존재하여 실행하지 못하는 현상
페이지
- 가상 주소 공간을 고정된 크기의 블록으로 나눈 단위
- 일반적으로 한 페이지의 크기는 4KB. 시스템에 따라 다름
- 페이지는 사용자의 논리적 주소 단위이다
페이지 프레임
- 물리 메모리를 동일한 크기의 블록으로 나눈 단위
- 가상 페이지가 실제 할당될 수 있는 실제 메모리 슬롯
정리 : 페이지는 책의 페이지 번호, 프레임은 실제 책장을 꽂는 선반의 칸
페이지 테이블의 역할
- 각 프로세스는 자신만의 페이지 테이블을 갖는다
- 페이지 테이블은 가상 페이지 번호 (VPN)을 물리 페이지 번호(PPN)로 매핑한다
- VPN → PPN 변환은 페이지 테이블이라는 배열 또는 계층적 구조를 통해 이루어진다
- 주소를 어떻게 변환하는가?
- CPU는 프로그램의 가상 주소(VA)를 생성
- VA를 VPN과 offset으로 나눈다
- 페이지 테이블을 참조하여 VPN에 해당하는 PPN을 가져온다
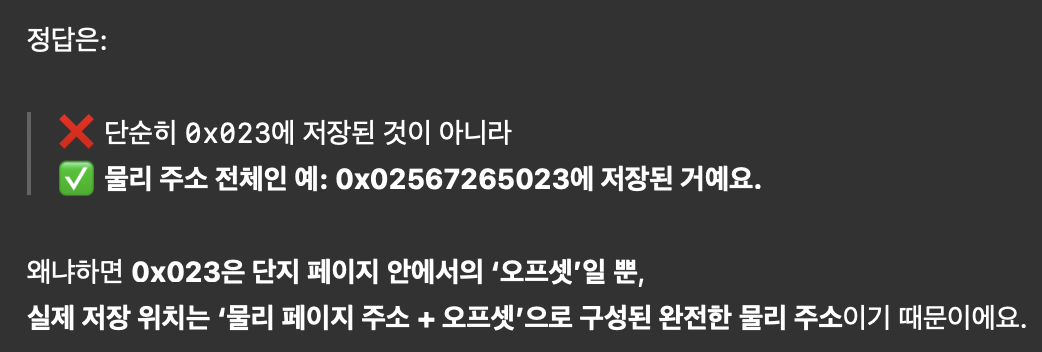
- 최종 물리 주소 = PPN * PageSize + offset
페이지 테이블 항목 (Page Table Entry)
하나의 PTE는 다음과 같은 컨트롤 비트를 포함한다.
| 비트 이름 | 설명 | Pintos 관련성 |
|---|---|---|
| Valid bit | 해당 페이지 매핑이 유효한가? | 유효하지 않으면 page fault 발생 |
| Protection bits | 읽기/쓰기/실행 권한 | page_fault() 처리에 이용 |
| Present bit | 물리 메모리에 있는가? (아니면 스왑 중?) | Lazy loading, swap 여부 판단 |
| Reference bit (Accessed) | 최근 접근 여부 | 페이지 교체 알고리즘 (LRU 등) |
| Dirty bit | 해당 페이지에 쓰기가 있었는가 | 스왑 아웃 시 디스크에 반영 여부 결정 |
→ PintOS에서 페이지 권한 설정은 pagedir_set_page, pml4_set_page에서 이루어지며, 이때 위 비트들을 설정한다
→ page_fault 핸들러는 present, valid 비트를 기반으로 동작한다
Translation lookaside buffer
등장 배경
- 주소 변환을 위해 매번 페이지 테이블을 접근하면 느리다!
- 이 접근은 메모리에서 이루어지므로, 캐시 미스가 날 경우 실제 성능이 떨어진다
- TLB로 해결하고자 한다
TLB란?
- 하드웨어 캐시로 최근에 변환된 가상주소 → 물리주소 매핑 정보를 저장한다
- CPU내에 존재하며, 주소 변환의 속도를 높인다
주소 변환 흐름
- CPU가 가상 주소를 생성
- TLB에서 해당 VPN → PPN 매핑을 시도 (TLB hit)
- 없으면 TLB miss → 페이지 테이블 접근 → 변환 후 TLB에 저장
TLB의 단점
- 크기가 작다
- 프로세스가 바뀌면 페이지 테이블이 바뀐다 → 이 때 TLB flush를 수행해야 한다
- TLB miss 발생 시 OS 개입 필요 → page fault 처리 또는 페이지 로딩
Page fault
페이지 폴트는 실행 중인 프로그램이 가상 메모리 주소에 접근 하려고 할때 발생하는 일종의 예외 또는 트랩
페이지 폴트가 발생하는 상황
페이지가 물리 메모리에 없을때 (Not Present)
프로그램이 접근하려는 가상 페이지에 해당하는 실제 데이터가 현재 물리 메모리의 어떤 프레임에도 올라와 있지 않은 경우 = 지연로딩, 페이지 스왑 아웃, 잘못된 주소 접근
접근 권한 위반 (Protection Violation)
페이지가 물리 메모리에는 있지만, 허용되지 않은 방식으로 접근하려고 할 때
예) 읽기 전용으로 표시된 페이지에 쓰려고 할 때
CPU의 MMU가 가상 주소를 물리주소로 변환하는 과정에서 이런 문제를 감지하면 프로그램을 잠시 멈추고 커널에게 알리는것
Lazy loading
= 지연 로딩
프로그램이 시작될 때 모든 필요한 페이지를 한꺼번에 메모리에 올리지 않는다. 대신 실제로 해당 페이지에 접근하려고 할 때 (요구가 있을때) 디스크에서 메모리로 내용을 가져온다. 이 첫 번째 접근 시 페이지 폴트가 발생한다
Page replacement policy
= 페이지 교체 정책
새로운 페이지를 물리 메모리에 올려야 하는데, 현재 사용 가능한 빈 물리 프레임이 하나도 없을때, 기존에 물리 프레임을 차지하고 있던 페이지들 중에서 어떤 페이지를 물리 메모리에서 제거할지 결정하는 것
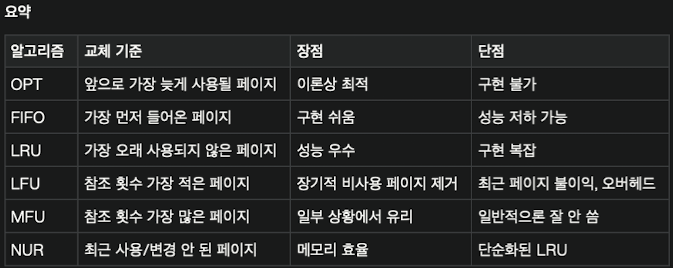
주요 페이지 교체 알고리즘
-
OPT (Optimal, 최적 교체)
• 앞으로 가장 오랫동안 사용되지 않을 페이지를 교체한다.
• 이론적으로 페이지 폴트 발생률이 가장 낮지만, 실제로 미래의 접근 패턴을 알 수 없으므로 구현이 불가능하다. -
FIFO (First-In, First-Out, 선입선출)
• 물리 메모리에 가장 먼저 들어온 페이지를 가장 먼저 내보낸다.
• 구현이 매우 쉽지만, 단순히 오래 있었다는 이유만으로 중요도를 반영하지 못해 성능이 떨어질 수 있다. -
LRU (Least Recently Used, 최근에 가장 적게 사용된 페이지 교체)
• 가장 오랫동안 사용되지 않은 페이지를 교체한다.
• 지역성(Locality) 원칙에 기반하여, 최근에 사용된 페이지는 앞으로도 사용할 가능성이 높다는 가정에서 출발한다.
• 구현이 FIFO보다 복잡하지만, 실제 운영체제에서 많이 사용된다. -
LFU (Least Frequently Used, 가장 적게 사용된 페이지 교체)
• 참조 횟수가 가장 적은 페이지를 교체한다.
• 장기적으로 거의 사용되지 않는 페이지를 내보내는 방식이지만, 최근에 들어온 페이지가 참조 횟수가 적어 바로 교체되는 등 단점이 있다. -
MFU (Most Frequently Used, 가장 많이 사용된 페이지 교체)
• 참조 횟수가 가장 많은 페이지를 교체한다.
• 가장 많이 사용된 페이지는 앞으로 덜 사용될 것이라는 가정에 기반한다. -
NUR (Not Used Recently, 최근에 사용되지 않은 페이지 교체)
• 최근에 사용되지 않은 페이지, 변경되지 않은 페이지를 우선적으로 교체 대상으로 삼는다.
• 접근(참조) 비트와 변경 비트를 활용한다.
페이지 교체 정책의 중요성
• 적절한 페이지 교체 정책을 선택하지 않으면, 불필요하게 자주 페이지 폴트가 발생해 시스템 성능이 저하될 수 있다.
• 실제 운영체제에서는 LRU나 그 변형, NUR 등 현실적으로 구현 가능한 정책이 주로 사용된다
Anonymous page
Anonymous Page(익명 페이지)는 운영체제에서 특정 파일이나 외부 데이터 소스에 매핑되지 않은 메모리 페이지를 의미한다. 즉, 파일과 연결되어 있지 않은 순수한 메모리 공간으로, 주로 프로세스의 힙(heap)이나 스택(stack) 영역에 동적으로 할당된다.
예를 들어, malloc 같은 함수로 메모리를 할당할 때 이 공간이 사용된다. 익명 페이지는 파일에 기반하지 않으므로, 데이터의 원본이 없고, 프로그램 실행 중에 생성되어 사용된다. 시스템이 메모리 부족 시 이 페이지들은 스왑 공간으로 이동될 수 있으며, 시스템 종료 시 데이터는 사라진다.
Swap disk
Swap Disk(스왑 디스크)는 물리 메모리(RAM)가 부족할 때 운영체제가 디스크의 일부를 가상 메모리로 사용하는 공간이다.
스왑은 비활성화된(자주 사용되지 않는) 메모리 페이지를 디스크로 옮겨, 활성 메모리에 여유 공간을 확보하는 역할을 한다. 리눅스 등에서는 스왑 파티션(디스크의 고정 영역)이나 스왑 파일(파일 시스템 내의 파일)로 구현할 수 있다. 스왑 공간은 시스템의 안정성과 성능 유지에 중요한 역할을 하며, 필요시 데이터를 다시 메모리로 불러온다
File-backed page
File-backed Page(파일 백드 페이지)는 메모리 페이지가 특정 파일과 연관되어 있는 경우를 말한다. 즉, 파일의 내용이 메모리에 로딩되어 있는 상태로, 주로 프로그램 코드, 데이터, 동적 라이브러리 등이 해당된다.
파일 매핑 기술을 통해 파일의 일부 또는 전체가 메모리로 매핑되며, 읽기 전용 또는 쓰기 가능한 형태로 존재할 수 있다. 만약 파일 백드 페이지에서 쓰기 연산이 발생하면, 변경된 내용은 파일 시스템을 통해 디스크에 반영된다
Direct memory access
Direct Memory Access(DMA, 직접 메모리 접근)는 하드디스크, 그래픽 카드 등 주변장치가 CPU의 개입 없이 직접 메모리(RAM)나 저장장치에 데이터를 전송할 수 있게 하는 기능이다.
기존의 방식(Programmed I/O)에서는 모든 데이터 전송에 CPU가 관여했으나, DMA를 사용하면 CPU의 부하를 줄이고 데이터 전송 속도를 높일 수 있다. 단, CPU가 데이터 전송의 유효성을 직접 확인하지 않으므로, DMA 컨트롤러가 데이터 무결성이나 접근 권한을 관리해야 한다.