오늘 배운 것
Maria DB - JOIN
Maria DB - SubQuery
Quiz 풀기
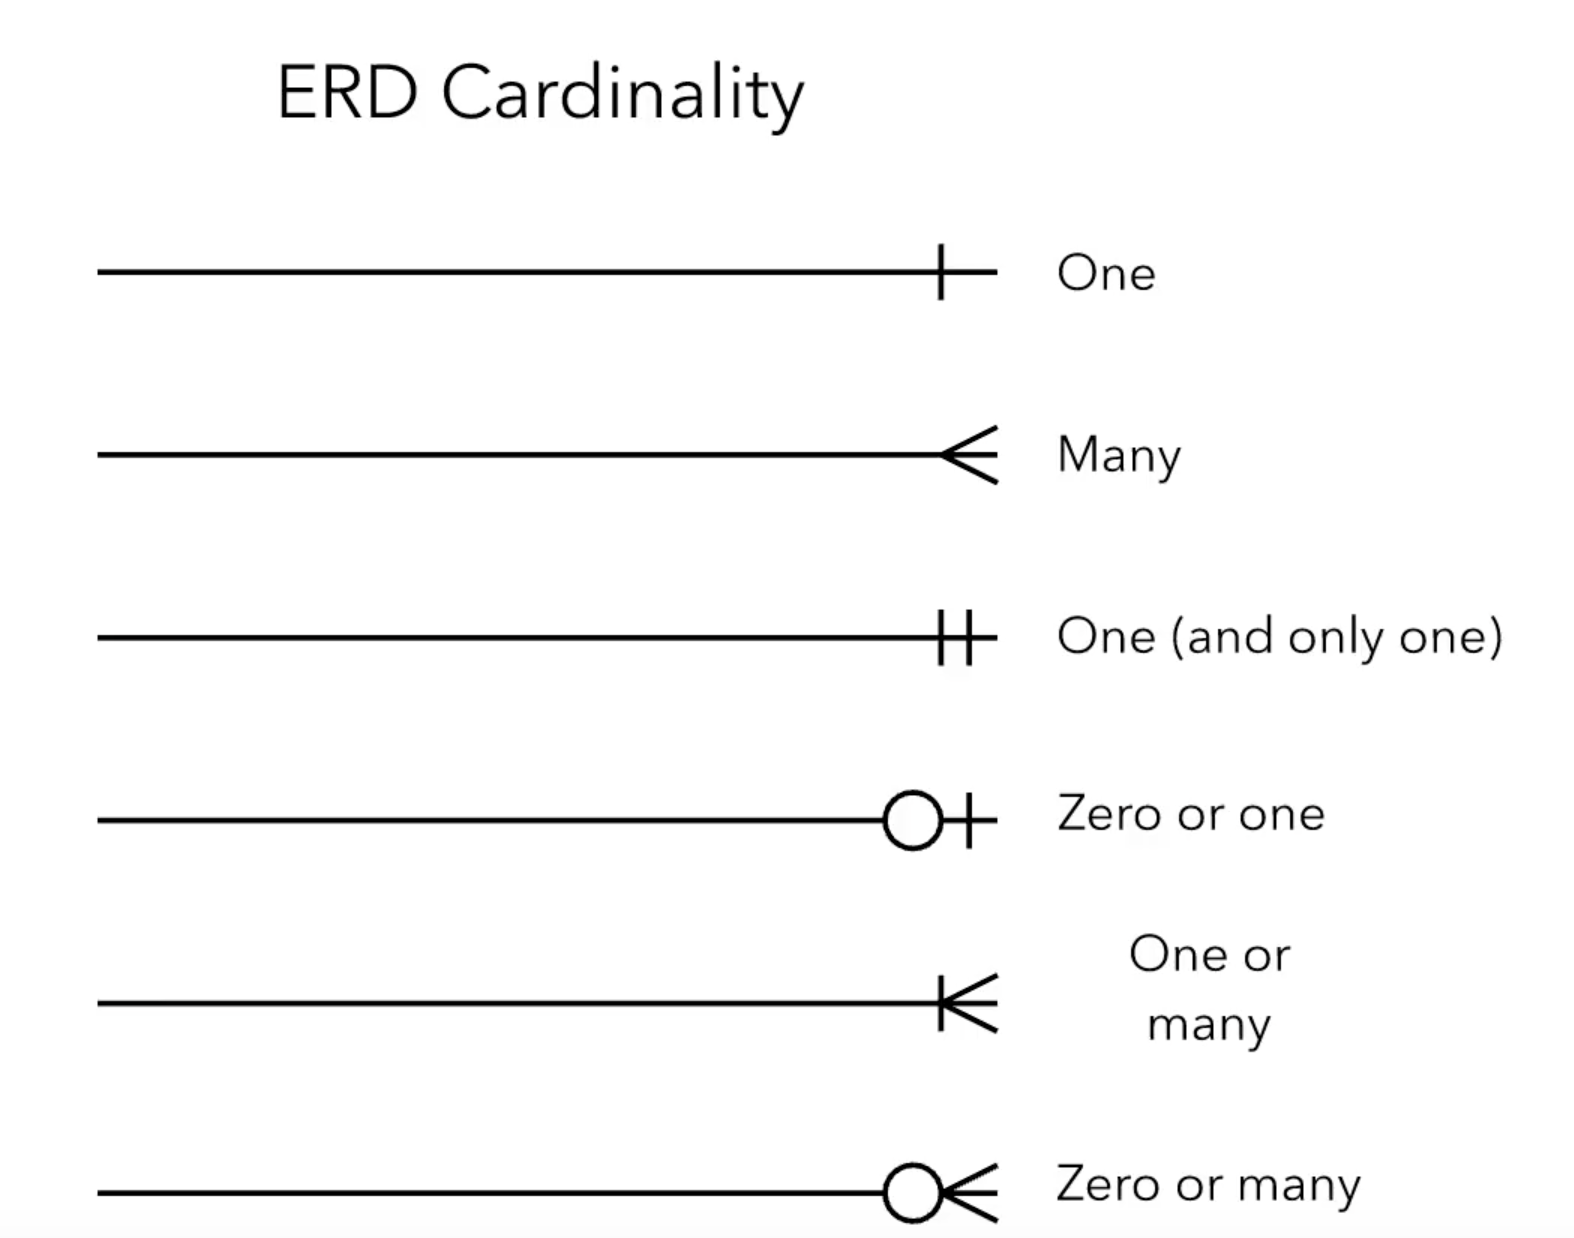
ERD Cardinality를 통해 테이블 간의 연결성을 확인할 수 있다.
1. JOIN
1) ANSI JOIN 종류
(1) INNER JOIN (교집합)
조건이 맞는 행만 남습니다.
SELECT *
FROM A
INNER JOIN B
ON A.id = B.a_id;
(2) LEFT [OUTER] JOIN (왼쪽 기준)
왼쪽(A)은 전부 유지, 오른쪽(B)은 매칭되면 붙고 아니면 NULL.
SELECT *
FROM A
LEFT JOIN B
ON A.id = B.a_id;
(3) RIGHT [OUTER] JOIN (오른쪽 기준)
RIGHT가 기준(실무에서는 LEFT가 더 자주 쓰여서 RIGHT는 지양하는 편입니다).
SELECT *
FROM A
RIGHT JOIN B
ON A.id = B.a_id;
(4) FULL [OUTER] JOIN (양쪽 기준)
양쪽 모두 유지 + 매칭 안 되면 반대쪽 컬럼이 NULL.
SELECT *
FROM A
FULL OUTER JOIN B
ON A.id = B.a_id;- MySQL은 FULL OUTER JOIN을 직접 지원하지 않아서 보통
LEFT JOIN ... UNION ... RIGHT JOIN등으로 우회합니다.
(5) CROSS JOIN (데카르트 곱)
모든 조합을 생성합니다(행 수가 곱으로 증가).
SELECT *
FROM A
CROSS JOIN B;
3) ON vs WHERE 차이 (특히 LEFT JOIN에서 핵심)
ANSI 표준 문법의 장점이 여기서 크게 드러납니다.
-- ON에 조건 (LEFT JOIN 성질 유지)
FROM A
LEFT JOIN B
ON A.id = B.a_id
AND B.flag = 'Y'

-- WHERE에 조건 (B가 NULL인 행 제거 → INNER처럼 변할 수 있음)
FROM A
LEFT JOIN B
ON A.id = B.a_id
WHERE B.flag = 'Y'ON: “붙일 때의 조건”(조인 매칭 규칙)WHERE: “최종 결과 필터”(조인 끝난 뒤 행 제거)
4) USING (같은 컬럼명으로 조인할 때)
두 테이블에 조인 키 이름이 같을 때 간단히 쓸 수 있습니다.
SELECT *
FROM A
JOIN B
USING (id);
ON A.id = B.id를 축약한 형태(표준에 포함)
+ ) 헷갈리는 구문 작성 순서
- SQL 절의 "정석" 작성 순서 (문법 규칙)
우리가 텍스트 창에 쿼리를 타이핑할 때는 이 순서대로만 작성해야 규칙(Syntax) 오류가 나지 않음.
SELECT    -- [1] 조회할 컬럼 선택
FROM      -- [2] 대상 테이블 및 조인(JOIN)
WHERE     -- [3] 일반 조건 필터링
GROUP BY  -- [4] 그룹화할 기준 컬럼
HAVING    -- [5] 그룹화된 결과에 대한 조건 필터링
ORDER BY  -- [6] 정렬 기준 (ASC / DESC)
LIMIT -- [7] 출력할 행의 개수 제한 (MariaDB/MySQL 기준)- 데이터베이스의 실제 실행 순서 (작동 원리)
컴퓨터가 명령을 받으면 사람이 쓴 순서대로가 아니라, 데이터를 가져와 가공하는 논리적 흐름에 맞춰 아래 순서대로 처리함. 왜 SELECT가 뒤로 밀리는지 그 흐름을 이해하는 것이 핵심
FROM (+ JOIN) ➔ WHERE ➔ GROUP BY ➔ HAVING ➔ SELECT ➔ ORDER BY ➔ LIMIT
FROM (+ JOIN)(1순위)- "가장 먼저 어느 창고(테이블)에서 데이터를 꺼내올지 결정해야지!"
- 테이블을 고르고 조인하는 작업이 세상에서 가장 먼저 처리됩니다. 테이블이 합쳐져야 그다음 필터링을 할 수 있으니까요.
WHERE(2순위)- "가져온 전체 데이터 중에서 필요 없는 행들은 미리 다 걸러내자!"
- 원본 데이터 자체에서 개별 행을 걸러내는 필터 역할을 합니다.
GROUP BY(3순위)- "필터링하고 남은 애들을 특정 기준(부서, 성별 등)으로 묶어서 조각내자!"
- 데이터를 룹 단위로 집계하기 위해 쪼개는 단계입니다.
HAVING(4순위)- "묶어놓은 그룹 결과 중에서도 특정 조건(예: 평균 급여 300만 이상)만 남겨!"
WHERE가 개별 데이터 필터라면,HAVING은 그룹화된 묶음 데이터의 필터입니다.
SELECT(5순위)- "준비는 다 끝났네. 이제 사용자가 화면에 보여달라고 한 컬럼들만 쏙쏙 골라서 출력해 주자!"
- 계산, 함수 처리, 별칭(Alias) 지정 등이 바로 이 단계를 거치면서 수행됩니다. 그래서
SELECT보다 앞에 있는WHERE나GROUP BY에서는SELECT에서 지어준 별칭을 인식하지 못하고 에러가 나는 것입니다.
ORDER BY(6순위)- "화면에 내보낼 데이터들이 확정됐으니, 이제 원하는 순서대로 예쁘게 정렬해 볼까?"
- 출력 직전에 정렬하므로,
ORDER BY에서는SELECT에서 만든 별칭을 자유롭게 사용할 수 있습니다.
LIMIT(7순위)- "정렬까지 끝난 결과물 중에서 딱 상위 N개만 끊어서 보여주자!"
- 최종 화면에 노출될 행의 개수를 제한하며 마무리됩니다.
💡 한눈에 기억하는 꿀팁 요약!
- "프웨어 그룹해 셀오리" 처럼 앞 글자만 따서 흐름을 입으로 소리 내어 익혀보세요!
- 프(FROM) ➔ 웨어(WHERE) ➔ 그룹(GROUP BY) ➔ 해(HAVING) ➔ 셀(SELECT) ➔ 오(ORDER BY) ➔ 리(LIMIT)
- 왜 조인이
WHERE앞에 오나요?- 테이블이 먼저 완벽히 합쳐져야(
FROM+JOIN), 그 합쳐진 전체 데이터를 보고 조건(WHERE)을 검사할 수 있기 때문입니다.
- 테이블이 먼저 완벽히 합쳐져야(
예시
-- Q ) 사용자가 JYP인 유저의 이름과 구매 상품을 조회한다면 ?
SELECT NAME,prodname
FROM usertbl U
JOIN buytbl B ON(U.userID=B.userID)
WHERE U.userID = 'JYP';


-- Q ) 사용자의 아이디, 이름, 구매상품, 주소, 연락처 (mobile 1 + mobile 2)
SELECT U.userID,NAME,prodname,addr,
			CONCAT(mobile1,mobile2)
FROM usertbl U
JOIN buytbl B ON(U.userID=B.userID);

-- Q ) 위 요구사항에서 구매이력이 있는 회원만 조회한다면? EXISTS EUBQUERY
SELECT U.userID, U.name, U.addr,
       CONCAT(U.mobile1, U.mobile2) AS mobile
FROM usertbl U
WHERE EXISTS (
    SELECT 1
    FROM buytbl B
    WHERE U.userID = B.userID
);
여기서 가장 마지막 구문이 제일 어려웠는데 이 지점이 바로 subquery 이다.
2. 서브쿼리(Subquery) 정리 (유형별 표)
단일행 ( 단일열, 다중열 )
다중행 (단일열, 다중열)
유형에 따라서 사용하는 연산자가 달라지며 다중행 (IN, ANY, ALL)
| 유형 | 핵심 특징 | 언제 쓰나 | 예시(간단) | 주의점/팁 |
|---|---|---|---|---|
| 스칼라 서브쿼리 (Scalar) | 서브쿼리 결과가 값 1개(1행 1열) | SELECT 절에서 “한 값”을 붙여서 보여줄 때 | SELECT U.userID, (SELECT COUNT(*) FROM buytbl B WHERE B.userID=U.userID) AS buy_cnt FROM usertbl U; | 반드시 1개 값만 반환해야 함. (여러 행 반환하면 오류) |
| 인라인 뷰 / 파생 테이블 (FROM 서브쿼리) | 서브쿼리 결과를 임시 테이블처럼 FROM에 놓고 JOIN/필터 | 집계 결과를 먼저 만들고 그 결과를 다시 조인/필터할 때 | SELECT * FROM (SELECT userID, COUNT(*) cnt FROM buytbl GROUP BY userID) X WHERE X.cnt \>= 2; | 별칭(Alias) 필수인 DB가 많음. (예: ... ) X) |
| 비상관 서브쿼리 (Non-correlated) | 바깥 쿼리 컬럼을 참조하지 않음 → 서브쿼리만 단독 실행 가능 | 기준값(평균, 최대값 등)을 구해 비교할 때 | SELECT * FROM usertbl WHERE height \>= (SELECT AVG(height) FROM usertbl); | 서브쿼리가 1번만 계산되는 형태로 최적화되기 쉬움 |
| 상관 서브쿼리 (Correlated) | 서브쿼리가 바깥 쿼리 컬럼을 참조 → 행마다 서브쿼리 평가 | “각 행별로 존재 여부/조건”을 검사할 때 | SELECT U.* FROM usertbl U WHERE EXISTS (SELECT 1 FROM buytbl B WHERE B.userID=U.userID); | 행마다 수행될 수 있어 느려질 수 있음 → 인덱스(userID) 중요 |
| EXISTS 서브쿼리 | 결과의 존재 여부(true/false) 만 검사 (내용은 중요 X) | “구매 이력이 있는 회원만” 같은 존재성 필터 | WHERE EXISTS (SELECT 1 FROM buytbl B WHERE B.userID=U.userID) | SELECT 1은 관례. DB는 “찾자마자(첫 매칭)” 멈출 수 있어 효율적일 때가 많음 |
| IN / ANY / ALL 서브쿼리 | 서브쿼리 결과(여러 값)와 비교 | 목록에 포함/비교 조건이 필요할 때 | WHERE U.userID IN (SELECT B.userID FROM buytbl B) | NOT IN은 NULL이 섞이면 결과가 예상과 달라질 수 있음 → 가능하면 NOT EXISTS 고려 |
| WHERE-HAVING (SUBQUERY) |
ANY / ALL 비교 (>, <, >=, <=)
| 구분 | ANY (SOME) | ALL | 의미 (예: x > (subquery)) |
|---|---|---|---|
| x > ANY (subquery) | 서브쿼리 결과 중 하나라도 만족하면 TRUE | — | x가 “목록의 어떤 값보다라도 크면” TRUE → 보통 최솟값보다 크면 성립 |
| x < ANY (subquery) | 서브쿼리 결과 중 하나라도 만족하면 TRUE | — | x가 “목록의 어떤 값보다라도 작으면” TRUE → 보통 최댓값보다 작으면 성립 |
| x >= ANY (subquery) | 하나라도 만족 | — | x가 “목록의 어떤 값 이상이면” TRUE → 최솟값 이상이면 성립 |
| x <= ANY (subquery) | 하나라도 만족 | — | x가 “목록의 어떤 값 이하이면” TRUE → 최댓값 이하이면 성립 |
| x > ALL (subquery) | — | 서브쿼리 결과 모두에 대해 만족해야 TRUE | x가 “목록의 모든 값보다 커야” TRUE → 보통 최댓값보다 커야 성립 |
| x < ALL (subquery) | — | 모두 만족 | x가 “목록의 모든 값보다 작아야” TRUE → 보통 최솟값보다 작아야 성립 |
| x >= ALL (subquery) | — | 모두 만족 | x가 “목록의 모든 값 이상이어야” TRUE → 최댓값 이상이면 성립 |
| x <= ALL (subquery) | — | 모두 만족 | x가 “목록의 모든 값 이하이어야” TRUE → 최솟값 이하이면 성립 |
| NULL / 빈 결과 주의 | 비교 대상(서브쿼리 결과)에 NULL이 섞이면 3값 논리(UNKNOWN) 때문에 결과가 직관과 달라질 수 있습니다. DBMS마다 최적화/처리가 달라질 수 있어, 실무에서는 NULL을 제거하거나(WHERE v IS NOT NULL) EXISTS/집계(MIN/MAX)로 바꿔 쓰는 경우가 많음 |
-- Q ) 사용자의 아이디, 이름, 구매상품, 주소, 연락처 (mobile 1 + mobile 2)
SELECT U.userID,NAME,prodname,addr,
			CONCAT(mobile1,mobile2)
FROM usertbl U
JOIN buytbl B ON(U.userID=B.userID);

-- Q ) 위 요구사항에서 구매이력이 있는 회원만 조회한다면? EXISTS EUBQUERY
SELECT U.userID, U.name, U.addr,
       CONCAT(U.mobile1, U.mobile2) AS mobile
FROM usertbl U
WHERE EXISTS (
    SELECT 1
    FROM buytbl B
    WHERE U.userID = B.userID
);
어려웠던 지점을 다시 보면 바깥의 userID 쿼리를 서브쿼리로 재사용하기 떄문에 U행을 순회하면서 buytbl에 userID가 있는지 확인할 수 있다.
+ ) 집계함수는 중첩 사용이 안된다 ?
SUM(),AVG(),COUNT(),MAX(),MIN()같은 집계함수(aggregate function) 안에- 또 다른 집계함수를 직접 넣어 쓰는 형태(중첩)를
- 대부분의 DBMS에서 같은 SELECT 레벨에서는 허용하지 않는다는 뜻입니다.
1) 왜 안 되나? (핵심 이유)
집계함수는 여러 행을 한 덩어리로 모아서 1개의 값으로 만드는 연산입니다.
그런데 “집계 결과(이미 1값으로 뭉친 결과)”를 같은 단계에서 다시 집계하려고 하면, DB 입장에선 어떤 행 단위/그룹 단위로 다시 계산해야 하는지 단계가 분리되지 않아 문법적으로 막아둔 경우가 많습니다.
2) 안 되는 예시
SELECT AVG(SUM(price))
FROM orders;SUM(price)자체가 이미 “여러 행 → 1값”으로 줄이는 집계인데,- 그 결과를 다시
AVG()로 묶으려고 해서 오류가 납니다.
또 다른 흔한 예:
SELECT SUM(COUNT(*))
FROM t;
3) 어떻게 해야 하나? (해결법)
집계를 2단계로 나눠서 하면 됩니다. 보통 서브쿼리/CTE(With절) 로 분리합니다.
예: “고객별 매출 합계”를 구한 다음, 그 합계들의 평균을 구하고 싶다면
SELECT AVG(customer_sum) AS avg_sum
FROM (
  SELECT customer_id, SUM(price) AS customer_sum
  FROM orders
  GROUP BY customer_id
) x;- 1단계(서브쿼리): 고객별
SUM(price)계산 - 2단계(바깥쿼리): 그 결과에 대해
AVG()계산
4) 헷갈리기 쉬운 포인트 1개
“집계함수 중첩 불가”는 보통 집계함수끼리 직접 중첩을 말합니다.
SUM(price * 0.1)처럼 집계함수 안에 일반 수식/일반함수 넣는 건 가능SUM(AVG(price))처럼 집계함수 안에 집계함수 넣는 게 문제
3. Quiz
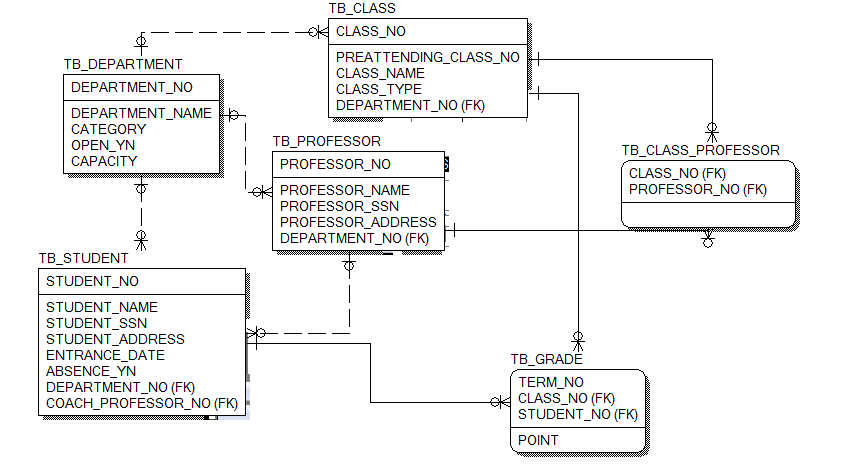
ERD image
풀이하려고 받은 시간 동안 15번까지 풀었다.
-- Q 1
SELECT student_name AS '학생이름',
		student_address AS '주소지'
FROM tb_student
ORDER BY 1 ;

-- Q 2
SELECT student_name, student_ssn
FROM tb_student
WHERE absence_yn = 'Y'
ORDER BY  DATEDIFF(NOW(),(STR_TO_DATE(SUBSTR(STUDENT_SSN, 1, 6), '%y%m%d')));

-- Q 3 주소지가 강원도나 경기도인 학생들 중 1900 년대 학번을 가진 학생들의 이름과 학번,
-- 주소를 이름의 오름차순으로 화면에 출력하시오. 단, 출력헤더에는 "학생이름", "학번", "거주지 주소" 가 출력되도록 한다.
SELECT	student_name AS '학생이름',
			student_no AS '학번',
			student_address AS '주소지'
FROM tb_student
WHERE ( student_address LIKE '강원도%' or student_address LIKE '경기도%')
		AND (student_no NOT LIKE 'A%');

-- Q 4 현재 법학과 교수 중 가장 나이가 많은 사람부터 이름을 확인할 수 있는 SQL 문장을 작성하시오.
-- (법학과의 '학과코드'는 학과 테이블(TB_DEPARTMENT)을 조회해서 찾아내도록 하자)
SELECT prof.PROFESSOR_NAME AS '교수이름',
		 (126 - substr(professor_ssn,1,2)+1) AS '나이'
FROM tb_professor prof
WHERE department_no = (
								SELECT department_no
								FROM tb_department
								WHERE department_name = '법학과'
							)
ORDER BY 나이 desc;

-- Q 5 2004년 2학기에 'C3118100' 과목을 수강한 학생들의 학점을 조회하려고 한다. 학점이 높은 학생부터 표시하고,
-- 학점이 같으면 학번이 낮은 학생부터 표시하는 구문을 작성해보시오.

SELECT student_no , POINT
FROM tb_grade
WHERE class_no = 'C3118100'
AND term_no ='200402'
ORDER BY POINT DESC, student_no ASC;

-- Q 6 학생 번호, 학생 이름, 학과 이름을 학생 이름으로 오름차순 정렬하여 출력하는 SQL 문을 작성하시오.

SELECT ST.student_no AS '학생번호',
		 ST.student_name AS '학생이름',
		 DP.department_name AS '학과이름'
FROM tb_student ST
JOIN tb_department DP ON (ST.DEPARTMENT_NO = DP.DEPARTMENT_NO)
ORDER BY ST.STUDENT_NAME ASC;

-- Q 7 춘 기술대학교의 과목 이름과 과목의 학과 이름을 출력하는 SQL 문장을 작성하시오.

SELECT CL.class_name AS '과목이름',
		 DP.department_name AS '운영학과'
FROM tb_class CL
JOIN tb_department DP ON (CL.DEPARTMENT_NO = DP.DEPARTMENT_NO);
ORDER BY CL.class_name ASC;

-- Q 8 과목별 교수 이름을 찾으려고 한다. 과목 이름과 교수 이름을 출력하는 SQL 문을 작성하시오.
SELECT	CL.class_name AS '과목이름',
			PROF.PROFESSOR_NAME AS '교수이름'
FROM tb_class CL
JOIN tb_class_professor CPROF ON(CPROF.CLASS_NO=CL.CLASS_NO)
JOIN tb_professor PROF ON(CPROF.PROFESSOR_NO=PROF.PROFESSOR_NO)
ORDER BY 과목이름;

-- Q 9
SELECT	CL.class_name AS '과목이름',
			PROF.PROFESSOR_NAME AS '교수이름'
FROM tb_class CL
JOIN tb_class_professor CPROF ON(CPROF.CLASS_NO=CL.CLASS_NO)
JOIN tb_professor PROF ON(CPROF.PROFESSOR_NO=PROF.PROFESSOR_NO)
JOIN tb_department DP ON(PROF.DEPARTMENT_NO=DP.DEPARTMENT_NO)
WHERE DP.CATEGORY = '인문사회'
ORDER BY 교수이름;

-- Q 10 '음악학과' 학생들의 평점을 구하려고 한다. 음악학과 학생들의 "학번", "학생 이름",
-- "전체 평점"을 출력하는 SQL 문장을 작성하시오. (단, 평점은 소수점 1 자리까지만 반올림하여 표시한다.)

SELECT 	ST.STUDENT_NO AS '학번',
			ST.STUDENT_NAME AS '학생이름',
			ROUND(AVG(G.POINT), 1) AS '평점'
FROM tb_student ST
JOIN tb_grade G ON(ST.student_no = G.student_no)
JOIN tb_department D ON(ST.DEPARTMENT_NO=D.DEPARTMENT_NO)
WHERE D.DEPARTMENT_NAME = '음악학과'
GROUP BY ST.STUDENT_NO, ST.STUDENT_NAME
ORDER BY ST.STUDENT_NO;

-- Q 11 학번이 A313047 인 학생이 학교에 나오고 있지 않다. 지도 교수에게 내용을 전달하기 위한 학과 이름, 학생 이름과 지도 교수 이름이 필요하다.
--  이때 사용할 SQL 문을 작성하시오. 단, 출력헤더는 "학과이름", "학생이름", "지도교수이름”으로 출력되도록 한다.

SELECT DP.DEPARTMENT_NAME AS '학과이름',
		ST.STUDENT_NAME AS '학생이름',
		prof.PROFESSOR_NAME AS '지도교수이름'
FROM tb_student ST
JOIN tb_department DP ON (ST.DEPARTMENT_NO=DP.DEPARTMENT_NO)
JOIN tb_professor prof ON (ST.COACH_PROFESSOR_NO=prof.PROFESSOR_NO)
WHERE ST.STUDENT_NO = 'A313047';

-- Q 12 2007 년도에 '인간관계론' 과목을 수강한 학생을 찾아 학생이름과 수강학기를 표시하는 SQL 문장을 작성하시오.
SELECT ST.STUDENT_NAME AS '학생이름',
		GDP.TERM_NO AS '수강학기'
FROM tb_student ST
JOIN tb_grade GDP ON(ST.student_no = GDP.STUDENT_NO)
JOIN tb_class CL ON(CL.CLASS_NO=GDP.CLASS_NO)
WHERE CL.CLASS_NAME='인간관계론'
AND GDP.TERM_NO LIKE '2007%';

-- Q 13 예체능 계열 과목 중 과목 담당교수를 한 명도 배정받지 못한 과목을 찾아
-- 그 과목 이름과 학과 이름을 출력하는 SQL 문장을 작성하시오.
SELECT CL.CLASS_NAME,
		DP.DEPARTMENT_NAME
FROM tb_class CL
left JOIN tb_class_professor CLPROF ON(CLPROF.CLASS_NO=CL.CLASS_NO)
JOIN tb_department DP ON(CL.DEPARTMENT_NO=DP.DEPARTMENT_NO)
WHERE DP.CATEGORY = '예체능'
AND CLPROF.PROFESSOR_NO IS NULL;

-- Q 14 춘 기술대학교 서반아어학과 학생들의 지도교수를 게시하고자 한다.
-- 학생이름과 지도교수 이름을 찾고 만일 지도 교수가 없는 학생일 경우 "지도교수 미지정" 으로 표시
-- 단, 출력헤더는 "학생이름", "지도교수"로 표시하며 고학번 학생이 먼저 표시되도록 한다.
SELECT	ST.student_name AS '학생이름',
			IFNULL(PROF.PROFESSOR_NAME, '지도교수 미지정') AS '지도교수'
FROM tb_student ST
JOIN tb_department DP ON(DP.DEPARTMENT_NO = ST.DEPARTMENT_NO)
left JOIN tb_professor PROF ON(PROF.PROFESSOR_NO = ST.COACH_PROFESSOR_NO)
WHERE DP.DEPARTMENT_NAME = '서반아어학과';

-- Q 15 휴학생이 아닌 학생 중 평점이 4.0 이상인 학생을 찾아
-- 그 학생의 학번, 이름, 학과 이름, 평점을 출력하는 SQL 문을 작성하시오.
SELECT 	ST.STUDENT_NO AS '학번',
			ST.STUDENT_NAME AS '이름',
			DP.DEPARTMENT_NAME AS '학과이름',
			AVG(GDP.POINT) AS '평점'
FROM tb_student ST
JOIN tb_department DP ON(DP.DEPARTMENT_NO = ST.DEPARTMENT_NO)
JOIN tb_grade GDP ON(GDP.STUDENT_NO = ST.STUDENT_NO)
WHERE ST.ABSENCE_YN = 'N'
GROUP BY ST.STUDENT_NO
HAVING AVG(GDP.POINT) >= 4.0
ORDER BY ST.STUDENT_NO;
다음 수업 시간에 답안을 확인하고 최종 정리를 해야할 거 같다.