오늘 배운 것
Maria DB - DDL
Maria DB - View
Quiz 풀기
1) DDL 핵심 개념을 잡을 때 유의했던 포인트
- DDL의 초점은 ‘행 데이터’가 아니라 ‘객체의 정의/변경’
CREATE/ALTER/DROP/TRUNCATE는 데이터 조작(DML)과 목적이 다름
- DBMS별 문법/동작 차이가 실제 문제를 만든다
- 예:
ALTER문법,TRUNCATE의 트랜잭션/로그/권한 동작, CHECK 지원 여부
- 예:
- 운영환경에서 ALTER는 락/시간 비용이 커질 수 있다
- 스키마 변경은 성능/가용성에 직접 영향 → 트래픽 낮을 때, 온라인 DDL/마이그레이션 도구 고려
- 제약조건 ‘수정’은 대부분 DROP 후 ADD
- 직접 수정이 아닌 재정의 패턴이 일반적
- FK의 ON DELETE/ON UPDATE 규칙은 “데이터 정합성 + 삭제/변경 파급”을 동시에 결정
- 편의(CASCADE) vs 안전(RESTRICT/NO ACTION) 트레이드오프
2) DDL 한 장 요약
2-1. CREATE (생성)
- 테이블/뷰/인덱스/시퀀스/제약조건 등 객체를 새로 만든다
- 테이블에서는 컬럼 타입/길이, NULL 허용, 기본값(DEFAULT), 제약조건(PK/UK/FK/CHECK) 등을 정의
CREATE TABLE users (
  user_id     BIGINT PRIMARY KEY,
  email       VARCHAR(255) UNIQUE NOT NULL,
  created_at  TIMESTAMP NOT NULL
);
2-2. ALTER (변경)
- 이미 존재하는 객체의 구조를 수정
- 대표 작업
- 컬럼:
ADD / MODIFY / CHANGE / DROP - 제약:
ADD CONSTRAINT .../ (수정은)DROP후ADD
- 컬럼:
- 실무 팁
- 기존 데이터가 있으면
NOT NULL/FK 추가 시 자주 막힘 → 먼저 데이터 정리(UPDATE등) 후 DDL 적용
- 기존 데이터가 있으면
ALTER TABLE users ADD COLUMN nickname VARCHAR(50);
ALTER TABLE users ALTER COLUMN nickname SET NOT NULL;  -- DBMS마다 문법 차이
2-3. DROP (삭제)
- 객체 자체를 제거(대개 데이터까지 소멸)
- 복구가 어려움 → 권한/환경 분리(개발 vs 운영) 중요
DROP TABLE users;2-4. TRUNCATE (데이터만 비움)
- 구조는 유지하고 행을 전부 제거
DELETE보다 빠를 수 있으나, 롤백/트리거/로그 정책은 DBMS별 차이 큼
TRUNCATE TABLE users;3) 제약조건/참조무결성(Integrity) 정리
3-1. 주요 제약조건
- NOT NULL: NULL 금지
- UNIQUE: 중복 금지
- PRIMARY KEY:
UNIQUE + NOT NULL+ 대표 식별자 - FOREIGN KEY: 부모 키 참조 → 참조 무결성 강제
- CHECK: 값 조건 강제(버전/DBMS에 따라 지원/무시 이력 주의)
3-2. FK 옵션(부모 변경/삭제 시 자식 처리)
- CASCADE: 부모 삭제/수정 → 자식도 연쇄 삭제/수정
- SET NULL: 부모 삭제/수정 → 자식 FK를 NULL로(컬럼이 NULL 허용이어야 함)
- RESTRICT / NO ACTION: 자식이 참조 중이면 부모 삭제/수정 차단(안전 기본값으로 자주 사용)
- SET DEFAULT: 미리 정한 기본값으로 변경(설계/기본값 존재가 전제)
mariaDB 주요 데이터 타입
| 분류 | 타입 예시 | 설명/사용처 |
|---|---|---|
| 정수형 | TINYINT, SMALLINT, INT, BIGINT | 정수 저장. 범위는 타입 크기에 따라 증가. (옵션) UNSIGNED로 음수 미허용 |
| 실수/고정소수점 | FLOAT, DOUBLE, DECIMAL(p,s) | FLOAT/DOUBLE은 부동소수점(근사값). DECIMAL은 고정소수점(정확) → 금액/정밀 계산에 권장 |
| 문자열(고정/가변) | CHAR(n), VARCHAR(n) | CHAR는 고정 길이(짧고 길이가 일정한 코드값 등). VARCHAR는 가변 길이(일반 문자열에 주로 사용) |
| 대용량 텍스트 | TINYTEXT, TEXT, MEDIUMTEXT, LONGTEXT | 긴 문자열 저장(설명/본문). 크기 단계별로 최대 길이가 다름 |
| 바이너리/파일 | BINARY(n), VARBINARY(n), BLOB 계열 | 바이트 데이터 저장(해시/암호화 결과/파일 조각 등). 텍스트 인코딩과 무관 |
| 날짜/시간 | DATE, TIME, DATETIME, TIMESTAMP | DATE(날짜), TIME(시간), DATETIME(날짜+시간). TIMESTAMP는 시스템/타임존 설정 영향 및 자동 갱신 패턴에 자주 활용 |
| 불리언(관용) | BOOLEAN(= TINYINT(1)) | MariaDB/MySQL 계열에서 BOOLEAN은 내부적으로 TINYINT(1)로 취급되는 경우가 많음(0/1 사용) |
| 열거형 | ENUM(...), SET(...) | 정해진 값 집합만 허용. ENUM은 단일 선택, SET은 다중 선택(저장/조회 특성 주의) |
| JSON | JSON(일반적으로 LONGTEXT • JSON 함수) | 버전/설정에 따라 실제 저장 타입이 텍스트 기반일 수 있음. JSON 함수로 검증/추출 가능 |
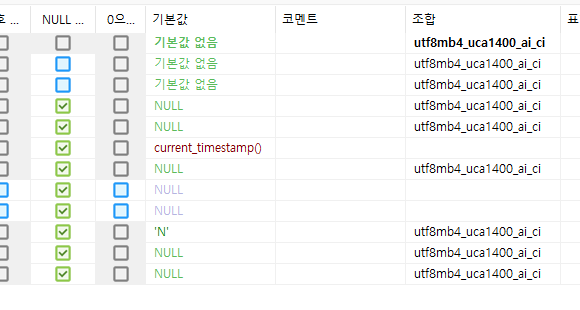
조합 끝에 ci 는 대소문자 구분을 안 하고, cs는 대소문자 구분을 한다는 표시
4) VIEW 총정리 (정의·목적·주의)
4-1. VIEW의 정의
SELECT쿼리를 이름으로 저장해 두고, 조회 시점에 결과를 테이블처럼 사용- 일반 VIEW는 보통 데이터를 별도 저장하지 않음(조회 시 실행)
4-2. VIEW의 대표 목적
- 보안(컬럼/행 단위 통제)
- 민감 컬럼 제외, 특정 조건(예: 활성 사용자)만 노출
- 쿼리 단순화/재사용(복잡 JOIN·집계 캡슐화)
- 자주 쓰는 JOIN/집계를 VIEW로 만들면 재사용성과 일관성↑, 실수↓
- 업무 용어로 데이터 제공(추상화)
- 정규화된 테이블 구조를 업무 친화적 형태로 제공
4-3. VIEW 사용 시 유의점(학습/실무 포인트)
- VIEW는 편하지만, 권한 설계(원본 테이블 접근 차단 + VIEW만 공개)를 같이 해야 보안 효과가 난다
- 어떤 VIEW는 DBMS 규칙에 따라 갱신 가능/불가가 달라질 수 있다(업데이트 방지 목적이면 생성 옵션/규칙을 고려)
5) SEQUENCE(시퀀스) 요약
- 중복되지 않는 숫자 값을 만들어주는 독립 객체(채번기)
- AUTO_INCREMENT/IDENTITY와 비교하면
- 테이블에 종속되지 않고, INSERT 전에 미리 번호를 뽑아 여러 테이블(부모-자식) 작업에 재사용 가능
- 주의: 보통 빈틈 없는 연속성은 보장하지 않음(롤백/캐시/동시성 등으로 점프 가능)
시퀀스 생성
CREATE SEQUENCE seq_orders
  START WITH 1
  INCREMENT BY 1
  MINVALUE 1
  MAXVALUE 999999999
  CACHE 100;
다음 값 뽑기 (NEXTVAL)
SELECT NEXTVAL(seq_orders) AS next_id;현재 값 확인 (LASTVAL)
SELECT LASTVAL(seq_orders) AS current_id;- 보통 “이번 세션에서 NEXTVAL을 한 번이라도 호출한 뒤”
LASTVAL을 조회할 수 있습니다(세션/DBMS 정책 차이 가능).
시퀀스 삭제
DROP SEQUENCE seq_orders;테이블 INSERT에 시퀀스 붙이는 대표 예시
상황
orders테이블의 PK를 시퀀스로 발급하고 싶다.
CREATE TABLE orders (
  order_id   BIGINT PRIMARY KEY,
  user_id    BIGINT NOT NULL,
  created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP
);
INSERT하면서 시퀀스 번호 사용
INSERT INTO orders(order_id, user_id)
VALUES (NEXTVAL(seq_orders), 1004);
방금 넣은 order_id를 다시 확인하고 싶다면
방법 A) INSERT 전에 미리 뽑아서 변수로 쓰기:
SET @new_order_id := NEXTVAL(seq_orders);

INSERT INTO orders(order_id, user_id)
VALUES (@new_order_id, 1004);

SELECT @new_order_id AS inserted_order_id;
방법 B) “현재 세션의 현재값” 조회:
SELECT CURRVAL(seq_orders) AS inserted_order_id;주문(부모) + 주문상세(자식) 같이 넣는 패턴
CREATE TABLE order_items (
  order_id BIGINT NOT NULL,
  item_id  BIGINT NOT NULL,
  qty      INT NOT NULL,
  PRIMARY KEY(order_id, item_id),
  FOREIGN KEY(order_id) REFERENCES orders(order_id)
);
START TRANSACTION;
SET @oid := NEXTVAL(seq_orders);
INSERT INTO orders(order_id, user_id) VALUES (@oid, 1004);
INSERT INTO order_items(order_id, item_id, qty) VALUES
(@oid, 10, 2),
(@oid, 11, 1);
COMMIT;- 이렇게 하면 부모 키를 한 번 발급하고 그 값을 자식들에 재사용할 수 있어요.
- 실무에서 “독립 객체인 SEQUENCE”의 장점이 가장 잘 드러나는 케이스입니다.
시퀀스 사용 시 주의사항
- 번호가 ‘빈틈 없이 연속’인 것을 보장하지 않는 경우가 많습니다.
- 예: NEXTVAL로 번호를 뽑았는데 트랜잭션이 롤백되면, 그 번호는 “사용 안 됐지만” 다시 돌아오지 않아 중간이 건너뛸 수 있습니다.
CACHE를 크게 잡으면 성능에 유리할 수 있지만, 장애/재시작 상황에서 번호 점프가 더 눈에 띌 수 있습니다(정책은 팀/서비스 성격에 따라 결정).
QUIZ 풀이
-
계열 정보를 저장할 카테고리 테이블을 만들려고 한다. 다음과 같은 테이블을 작성하시오.
테이블 이름 : TB_CATEGORY
컬럼 :
NAME, VARCHAR2(10)
USE_YN, CHAR(1), 기본값은 Y가 들어가도록
-
과목 구분을 저장할 테이블을 만들려고 한다. 다음과 같은 테이블을 작성하시오.
테이블이름 : TB_CLASS_TYPE
컬럼 :
NO, VARCHAR2(5), PRIMARY KEY
NAME, VARCHAR2(10)
-
TB_CATEGORY 테이블의 NAME 컬럼에 PRIMARY KEY를 생성하시오.
(KEY 이름을 생성하지 않아도 무방함. 만일 KEY 이를 지정하고자 한다면 이름은 본인이 알아서 적당한 이름을 사용한다.)
-
TB_CLASS_TYPE 테이블의 NAME 컬럼에 NULL 값이 들어가지 않도록 속성을 변경하시오.
-
두 테이블에서 컬럼 명이 NO 인 것은 기존 타입을 유지하면서 크기는 10 으로, 컬럼명이 NAME 인 것은 마찬가지로 기존 타입을 유지하면서 크기 20 으로 변경하시오.
-
두 테이블의 NO 컬럼과 NAME 컬럼의 이름을 각각 TB_를 제외한 테이블 이름이 앞에 붙은 형태로 변경한다.
(ex. CATEGORY_NAME)
-
TB_CATEGORY 테이블과 TB_CLASS_TYPE 테이블의 PRIMARY KEY 이름을 다음과 같이 변경하시오.
Primary Key 의 이름은 "PK_ + 컬럼이름" 으로 지정하시오. (ex. PK_CATEGORY_NAME)
-
다음과 같은 INSERT 문을 수행한다.
INSERT INTO TB_CATEGORY VALUES ('공학', 'Y');
INSERT INTO TB_CATEGORY VALUES ('자연과학', 'Y');
INSERT INTO TB_CATEGORY VALUES ('의학', 'Y');
INSERT INTO TB_CATEGORY VALUES ('예체능', 'Y');
INSERT INTO TB_CATEGORY VALUES ('인문사회', 'Y');
COMMIT;
-
TBDEPARTMENT의 CATEGORY 컬럼이 TB_CATEGORY 테이블의 CATEGORY_NAME 컬럼을 부모 값으로 참조하도록 FOREIGN KEY를 지정하시오. 이 때 KEY 이름은 FK테이블이름_컬럼이름으로 지정한다. (ex. FK_DEPARTMENT_CATEGORY )
-
춘 기술대학교 학생들의 정보만이 포함되어 있는 학생일반정보 VIEW를 만들고자 한다. 아래 내용을 참고하여 적절한 SQL 문을 작성하시오.
뷰 이름 : VW_학생일반정보
컬럼 : 학번, 학생이름, 주소
-
춘 기술대학교는 1년에 두 번씩 학과별로 학생과 지도교수가 지도 면담을 진행한다. 이를 위해 사용할 학생이름, 학과이름, 담당교수이름 으로 구성되어 있는 VIEW를 만드시오. 이때 지도 교수가 없는 학생이 있을 수 있음을 고려하시오 (단, 이 VIEW는 단순 SELECT 만을 할 경우 학과별로 정렬되어 화면에 보여지게 만드시오.)
뷰 이름 : VW_지도면담
컬럼 : 학생이름, 학과이름, 지도교수이름
-
모든 학과의 학과별 학생 수를 확인할 수 있도록 적절한 VIEW를 작성해 보자.
뷰 이름 : VW_학과별학생수
컬럼 : DEPARTMENT_NAME, STUDENT_COUNT
-
위에서 생성한 학생일반정보 View를 통해서 학번이 A213046 인 학생의 이름을 본인 이름으로 변경하는 SQL 문을 작성하시오.
-
13 번에서와 같이 VIEW를 통해서 데이터가 변경될 수 있는 상황을 막으려면 VIEW를 어떻게 생성해야 하는지 작성하시오.
-
춘 기술대학교는 매년 수강신청 기간만 되면 특정 인기 과목들에 수강 신청이 몰려 문제가 되고 있다. 최근 3년을 기준으로 수강인원이 가장 많았던 3 과목을 찾는 구문을 작성해보시오.
결과 예시 헤더 : 과목번호, 과목이름, 누적수강생수(명)
   -- Q 1 , 3) 테이블 작성하기

DROP TABLE if EXISTS TB_CATEGORY;
CREATE TABLE TB_CATEGORY (
	`NAME`		VARCHAR(10),
	USE_YN		CHAR(1) DEFAULT('Y'),
	CONSTRAINT PRIMARY KEY (`NAME`)
	);

SELECT *
FROM TB_CATEGORY;

-- Q 2 , 4 ) 테이블 작성하기

DROP TABLE if EXISTS TB_CLASS_TYPE;
CREATE TABLE TB_CLASS_TYPE(
	`NO`	 VARCHAR(5),
	`NAME` VARCHAR(10) NOT NULL,
	CONSTRAINT PRIMARY KEY (`NO`)
);

SELECT *
FROM TB_CLASS_TYPE;

-- Q 5 ) 두 테이블에서 컬럼 명이 NO 인 것은 기존 타입을 유지하면서
-- 크기는 10 으로, 컬럼명이 NAME 인 것은 마찬가지로 기존 타입을 유지하면서 크기 20 으로 변경하시오.

ALTER TABLE TB_CLASS_TYPE
MODIFY `NO` VARCHAR(10);

ALTER TABLE TB_CLASS_TYPE
MODIFY `NAME` VARCHAR(20);

ALTER TABLE TB_CATEGORY
MODIFY `NAME` VARCHAR(20);

-- Q 6 )

ALTER TABLE TB_CLASS_TYPE
RENAME COLUMN `NO` TO CLASS_TYPE_NO;

ALTER TABLE TB_CATEGORY
RENAME COLUMN `NAME` TO CATEGORY_NAME;

-- Q 7 )
-- 1) TB_CATEGORY 테이블 기본키 드롭 후 제약조건명 명시하여 재생성
ALTER TABLE TB_CATEGORY
DROP PRIMARY KEY;
ALTER TABLE TB_CATEGORY
ADD CONSTRAINT PK_CATEGORY_NAME PRIMARY KEY (CATEGORY_NAME);

-- 2) TB_CLASS_TYPE 테이블 기본키 드롭 후 제약조건명 명시하여 재생성
ALTER TABLE TB_CLASS_TYPE
DROP PRIMARY KEY;
ALTER TABLE TB_CLASS_TYPE
ADD CONSTRAINT PK_CLASS_TYPE_NO PRIMARY KEY (CLASS_TYPE_NO);

-- Q 8 )

INSERT INTO TB_CATEGORY VALUES ('공학', 'Y');
INSERT INTO TB_CATEGORY VALUES ('자연과학', 'Y');
INSERT INTO TB_CATEGORY VALUES ('의학', 'Y');
INSERT INTO TB_CATEGORY VALUES ('예체능', 'Y');
INSERT INTO TB_CATEGORY VALUES ('인문사회', 'Y');
COMMIT;

SELECT *
FROM TB_CATEGORY;

-- Q 9 )
ALTER TABLE tb_department
ADD CONSTRAINT FOREIGN KEY (CATEGORY) REFERENCES tb_category(CATEGORY_NAME);

ALTER TABLE tb_department
RENAME COLUMN CATEGORY TO FK_TB_DEPARTMENT_CATEGORY;

-- Q 10 )


CREATE OR REPLACE VIEW vW_학생일반정보(학번,학생이름,주소)
AS
SELECT E.emp_name,
		E.dept_id
FROM employee E
JOIN department D ON(E.DEPT_ID = D.DEPT_ID)
WHERE E.dept_id = '90';
다섯 문제는 스터디 복습할 때 마저 풀 계획