6. LLM은 어떻게 외부 기능을 사용할까? — Tool Calling & Agent
5편에서는 LLM이 자신의 Parameter 밖에 있는 정보를 사용하는 방법을 살펴봤다.
User Question
      ↓
Retrieval
      ↓
External Knowledge
      ↓
Context
      ↓
LLM
      ↓
Answer
RAG를 이용하면 LLM은 외부의 논문, 문서, Database 등에 있는 정보를 검색해 현재 Context에 추가할 수 있다.
하지만 여기서 한 단계 더 나아가 보자.
사용자가 다음과 같이 요청했다고 하자.
"2020년 이후 한국어 ASR 관련 논문을 찾아서
핵심 실험 결과를 정리하고
내 연구노트에 저장해줘."
이 요청은 단순한 질문이 아니다.
해야 할 일을 나누면:
① 논문을 검색한다.

② 검색 결과를 가져온다.

③ 관련 논문을 선택한다.

④ 논문의 실험 결과를 분석한다.

⑤ 핵심 내용을 정리한다.

⑥ 연구노트에 저장한다.
LLM 혼자 할 수 있는 것은 어디까지일까?
기본적인 LLM은 Text를 입력받고 다음 Token을 생성한다.
Text
 ↓
LLM
 ↓
Text
하지만:
논문 Database 검색

API 호출

Database Query

파일 저장

메일 전송

Calendar 등록
같은 작업은 단순한 Text Generation이 아니다.
외부 System을 실제로 사용해야 한다.
그렇다면:
Text를 생성하는 LLM이 어떻게 외부 프로그램을 사용할 수 있을까?
여기서 Tool Calling이 등장한다.
이번 글에서는 다음 흐름을 따라간다.
WHY

왜 LLM만으로는
실제 작업을 수행할 수 없을까?

        ↓

HOW

LLM은 어떻게
필요한 Tool과 Arguments를 결정할까?

        ↓

CODE

Function Schema와 Tool Call을
직접 구현해보자.

        ↓

LLM

Tool Calling이 반복되면
어떻게 Agent와 Workflow로 확장될까?
6.0 WHY — LLM은 기본적으로 Text Generator다
4편에서 LLM의 Generation을 다음과 같이 살펴봤다.
Context
   ↓
Transformer
   ↓
Logits
   ↓
Decoding
   ↓
Next Token
   ↓
Repeat
결국 LLM의 기본 출력은 Token Sequence다.
예를 들어:
User

"한국어 ASR 논문을 찾아줘."
라고 입력하면 LLM은:
Assistant

"다음과 같은 연구를 참고할 수 있습니다..."
처럼 Text를 생성할 수 있다.
하지만 이것만으로는 실제 검색이 수행되었다고 할 수 없다.
LLM이:
"논문 Database를 검색하겠습니다."라고 출력한다고 해서 실제 Database Query가 실행되는 것은 아니다.
마찬가지로:
"연구노트에 저장했습니다."라고 생성했다고 해서 파일이 실제로 저장된 것도 아니다.
즉:
Text Generation
      ≠
External Action
이다.
이 둘 사이를 연결하는 구조가 필요하다.
6.1 WHY — LLM에게 직접 모든 기능을 넣을 수는 없을까?
하나의 LLM이:
Web Search

Database

Python

File System

Email

Calendar

Research API

...
를 모두 내부적으로 직접 처리한다고 생각하기 쉽다.
하지만 LLM과 외부 기능은 역할이 다르다.
LLM은:
Language Understanding
Reasoning
Decision
Generation
을 담당할 수 있다.
반면 외부 Tool은:
Search 실행

DB Query 실행

계산 실행

파일 저장

API Request 실행
같은 실제 기능을 담당한다.
따라서 시스템을:
LLM
 │
 │ decides
 ▼
Tool
 │
 │ executes
 ▼
External System
으로 분리할 수 있다.
핵심은:
LLM이 직접 Tool의 기능을 수행하는 것이 아니라, 어떤 Tool을 어떤 Arguments로 호출할지를 결정하고 실제 실행은 외부 Runtime이 담당한다.
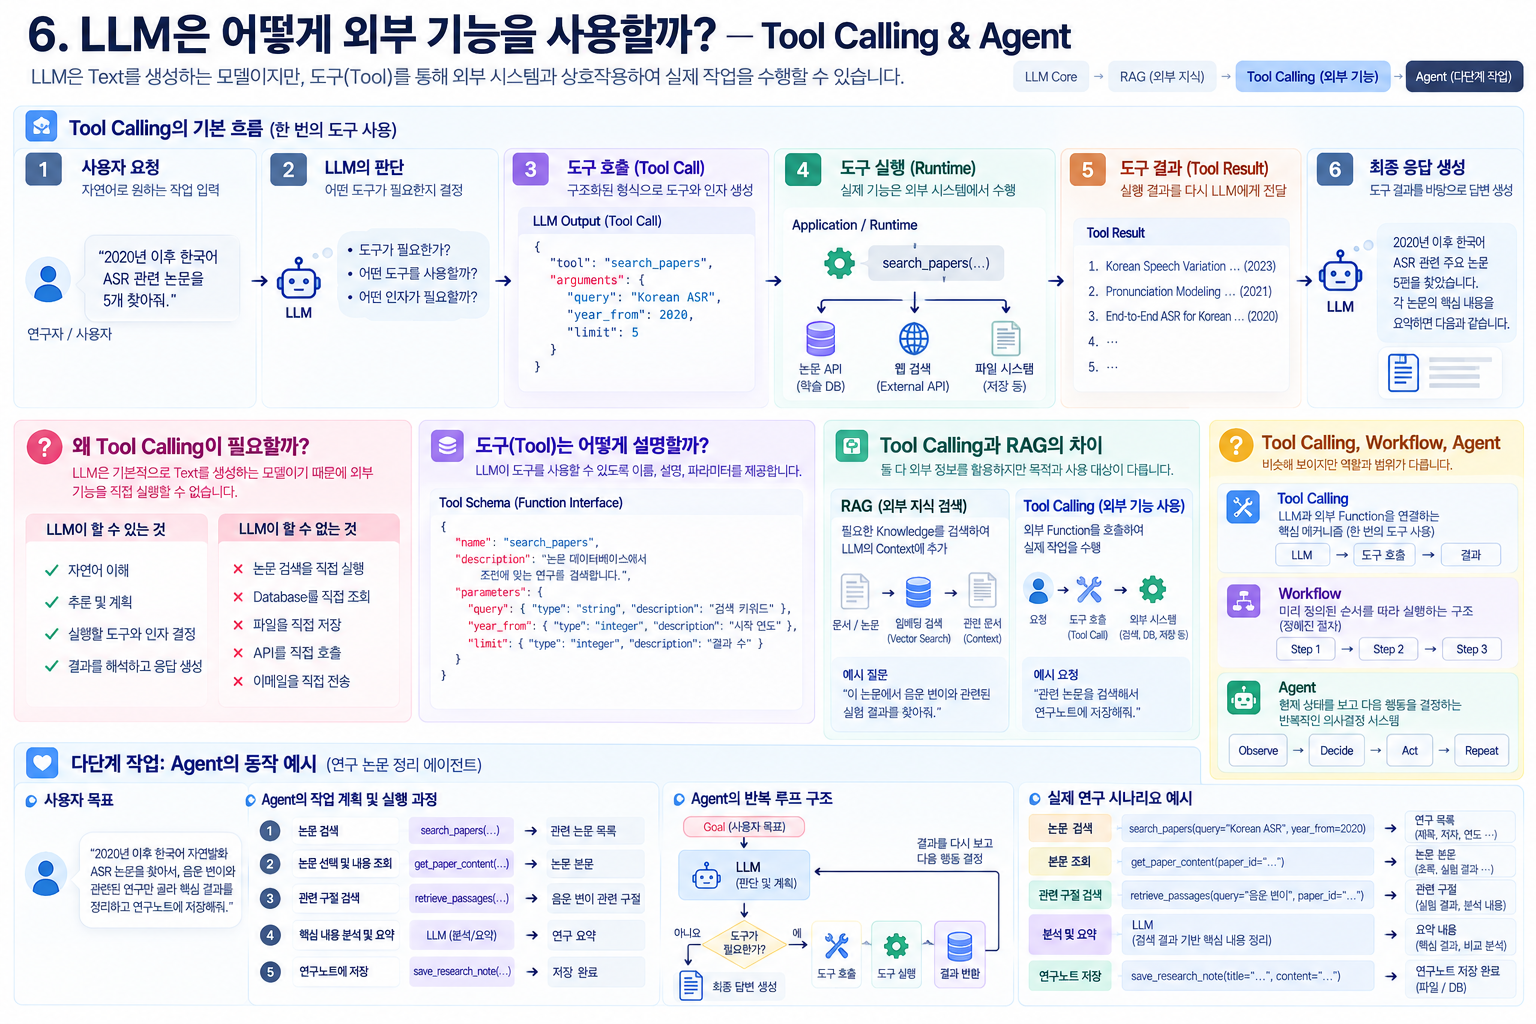
6.2 HOW — Tool Calling의 전체 구조
Tool Calling의 기본 흐름부터 보자.
사용자가:
"2020년 이후 한국어 ASR 논문을 찾아줘."라고 요청한다.
LLM에게 사용할 수 있는 Tool 정보도 함께 제공되어 있다고 하자.
Available Tools

search_papers
get_paper
save_research_note
LLM은 요청을 보고 판단한다.
User Request
      ↓
LLM
      ↓
Tool이 필요한가?
      ↓
YES
      ↓
Tool 선택
      ↓
Arguments 생성
예:
Tool

search_papers


Arguments

{
  "query": "Korean ASR",
  "year_from": 2020
}
하지만 여기서도 LLM이 검색을 직접 수행한 것은 아니다.
이 구조화된 요청을 Application이 받아 실제 Function을 실행한다.
LLM
 ↓
Tool Call
 ↓
Application / Runtime
 ↓
search_papers(...)
 ↓
Research API
검색 결과가 돌아온다.
Tool Result

[
  Paper A,
  Paper B,
  Paper C
]
이 결과를 다시 LLM에게 전달한다.
Tool Result
     ↓
LLM Context
     ↓
Reasoning / Generation
     ↓
Final Answer
전체를 연결하면:
User
 ↓
LLM
 ↓
Tool Call
 ↓
Runtime
 ↓
External Tool
 ↓
Tool Result
 ↓
LLM
 ↓
Answer
이게 Tool Calling의 가장 기본적인 구조다.
6.3 HOW — Tool은 LLM에게 어떻게 설명할까?
LLM이 Tool을 선택하려면 먼저:
어떤 Tool이 존재하는가?

그 Tool은 무엇을 하는가?

어떤 입력이 필요한가?
를 알아야 한다.
그래서 Tool을 Schema 형태로 설명한다.
예를 들어 논문 검색 Tool이 있다고 하자.
Tool Name

search_papers


Description

논문 Database에서
조건에 맞는 연구를 검색한다.


Parameters

query
year_from
language
limit
구조화하면 개념적으로:
{
  "name": "search_papers",
  "description": "Search research papers.",
  "parameters": {
    "query": "string",
    "year_from": "integer",
    "language": "string",
    "limit": "integer"
  }
}
이 Schema가 LLM에게:
이런 기능을 사용할 수 있다.
라는 정보를 제공한다.
6.4 HOW — Function Schema는 API Documentation과 비슷하다
우리가 Python Function을 사용할 때도:
search_papers(
    query="Korean ASR",
    year_from=2020
)
Function의 이름과 Parameter를 알아야 한다.
LLM도 마찬가지다.
Function Name

search_papers


Parameter

query
year_from
language
limit
를 알아야 올바른 호출을 만들 수 있다.
따라서 Tool Schema는 LLM 입장에서 일종의:
Function Interface라고 볼 수 있다.
중요한 것은 Tool Schema가 실제 Function 자체는 아니라는 것이다.
Tool Schema

"이 Tool을 이렇게 사용할 수 있다."
이고,
실제 Function은:
Runtime

"실제로 이 작업을 수행한다."
이다.
6.5 HOW — LLM은 Tool을 실행하는 것이 아니라 Tool Call을 생성한다
이 차이는 매우 중요하다.
사용자 요청:
"2020년 이후 한국어 ASR 논문을
5개 찾아줘."
LLM이 생성하는 것은 개념적으로:
Tool Call

name:
search_papers

arguments:
{
  "query": "Korean ASR",
  "year_from": 2020,
  "limit": 5
}
이다.
그 다음:
Tool Call
    ↓
Application
    ↓
Function Execution
이 이루어진다.
즉:
LLM

결정 / 구조화

        ↓

Runtime

실행
으로 역할을 분리해야 한다.
6.6 HOW — Structured Output이 왜 중요할까?
만약 LLM이 다음처럼 출력한다고 해보자.
"음... search_papers라는 기능을 사용해서
Korean ASR을 검색하면 될 것 같고,
2020년 이후 논문을 다섯 개 정도
가져오면 될 것 같습니다."
사람은 이해할 수 있다.
하지만 프로그램이 이 Text에서:
Function Name?

Arguments?

year_from?

limit?
을 다시 해석해야 한다.
불안정하다.
그래서 Machine이 읽을 수 있는 Structured Output이 중요하다.
{
  "tool": "search_papers",
  "arguments": {
    "query": "Korean ASR",
    "year_from": 2020,
    "limit": 5
  }
}
이제 Application은:
JSON / Structured Output
        ↓
Parsing
        ↓
Function Call
을 안정적으로 수행할 수 있다.
즉 Structured Output은:
Natural Language와 Program Interface 사이의 연결점
이 된다.
6.7 HOW — Arguments도 LLM이 결정한다
Tool 선택만 중요한 것이 아니다.
Tool을 어떻게 사용할지도 결정해야 한다.
예를 들어 사용자가:
"최근 한국어 음성인식 연구를
세 편만 찾아줘."
라고 했다.
LLM은 자연어 요청에서:
"한국어 음성인식"
       ↓
query


"최근"
       ↓
year / sort condition


"세 편"
       ↓
limit = 3
처럼 필요한 값을 추출해야 한다.
결과:
{
  "query": "Korean speech recognition",
  "limit": 3,
  "sort": "recent"
}
즉 Tool Calling에는:
Intent Understanding
       ↓
Tool Selection
       ↓
Argument Extraction
       ↓
Structured Tool Call
과정이 포함된다.
6.8 HOW — Tool Result는 다시 LLM의 Context가 된다
Tool을 실행했다고 끝이 아니다.
검색 결과:
Tool Result

1. Paper A
2. Paper B
3. Paper C
가 돌아왔다.
이 결과를 다시 LLM에게 제공한다.
Original User Request
        +
Tool Call
        +
Tool Result
        ↓
Updated Context
        ↓
LLM
그러면 LLM은 Tool Result를 기반으로:
"검색 결과 중 자연발화의
발음 변이를 직접 다룬 연구는..."
처럼 답변할 수 있다.
이 구조는 5편의 RAG와도 닮았다.
RAG에서는:
Retriever
   ↓
Retrieved Documents
   ↓
LLM Context
였다.
Tool Calling에서는:
Tool
 ↓
Tool Result
 ↓
LLM Context
이다.
즉 둘 모두 외부에서 얻은 정보를 Context에 다시 넣는다.
하지만 목적이 다르다.
6.9 HOW — RAG와 Tool Calling은 무엇이 다를까?
RAG
주된 목적:
필요한 Knowledge를 검색한다.
Question
 ↓
Retriever
 ↓
Knowledge
 ↓
LLM
 ↓
Answer
예:
"이 논문에서
음운 변이와 관련된 결과를 찾아줘."
Tool Calling
주된 목적:
외부 Function을 사용한다.
Request
 ↓
LLM
 ↓
Tool Call
 ↓
Function
 ↓
Result
 ↓
LLM
예:
"관련 논문을 검색해서
내 연구노트에 저장해줘."
RAG는 주로:
External Knowledge를 가져온다면,
Tool Calling은:
External Capability를 연결한다.
하지만 실제 Application에서는 둘이 함께 사용될 수 있다.
6.10 HOW — 하나의 Tool Call로 끝나지 않는다면?
이제 요청을 조금 복잡하게 만들어보자.
"2020년 이후 한국어 자연발화 ASR 논문을 찾아서
음운 변이와 관련된 연구만 골라
핵심 실험 결과를 정리하고
내 연구노트에 저장해줘."
한 번의 Tool Call로 끝낼 수 있을까?
아마 여러 단계가 필요하다.
1. 논문 검색
      ↓
2. 검색 결과 확인
      ↓
3. 관련 논문 선택
      ↓
4. 논문 내용 가져오기
      ↓
5. 핵심 결과 분석
      ↓
6. 연구노트 저장
필요한 Tool도 여러 개일 수 있다.
search_papers

get_paper_content

search_passages

save_research_note
그러면 LLM은 첫 번째 Tool Result를 보고 다음 행동을 결정해야 한다.
LLM
 ↓
Tool A
 ↓
Result A
 ↓
LLM
 ↓
Tool B
 ↓
Result B
 ↓
LLM
 ↓
Tool C
 ↓
Result C
 ↓
Final Answer
이제 단순한 한 번의 Tool Calling보다 더 복잡한 구조가 나타난다.
6.11 HOW — Tool Calling Loop
위 구조를 일반화하면:
             ┌───────────────┐
             │               │
             ▼               │
User → LLM → Decision        │
             │               │
             ├─ Answer ──────┼─→ End
             │               │
             └─ Tool Call    │
                    ↓        │
                  Tool       │
                    ↓        │
               Tool Result   │
                    │        │
                    └────────┘
LLM은 매 단계에서 판단한다.
현재 정보로 답할 수 있는가?

        │
    ┌───┴───┐
    │       │
   YES      NO
    │       │
    ▼       ▼
 Answer   Tool Call
Tool Result가 돌아오면 다시 판단한다.
이러한 반복 구조가 Agent를 이해하는 중요한 기반이 된다.
6.12 HOW — 그렇다면 Agent란 무엇일까?
Agent라는 용어는 Framework나 문맥에 따라 정의 범위가 조금씩 다르다.
하지만 이번 시리즈에서는 다음처럼 이해하자.
LLM이 현재 상태와 목표를 바탕으로 다음 행동을 선택하고, Tool의 결과를 다시 관찰하면서 여러 단계를 반복해 목표를 수행하는 시스템.
즉 단순 Tool Calling이:
Request
 ↓
Tool
 ↓
Result
이라면 Agent는:
Goal
 ↓
Observe
 ↓
Decide
 ↓
Act
 ↓
Observe Result
 ↓
Decide Again
 ↓
...
 ↓
Goal Complete
같은 Loop를 가진다.
핵심은 반복적인 의사결정이다.
6.13 HOW — Agent를 구성하는 핵심 요소
Agent를 너무 추상적으로 이해하지 않기 위해 구성 요소로 분해해보자.
Agent

├─ Goal
├─ LLM
├─ Tools
├─ State / Context
└─ Control Loop
Goal
무엇을 해야 하는가?
"관련 논문을 찾아
실험 결과를 정리하고
연구노트에 저장한다."
LLM
현재 상황을 해석하고 다음 행동을 결정한다.
Tools
실제 외부 작업을 수행한다.
Search

Database

File

API

Code
State / Context
지금까지 무엇을 했고 어떤 결과를 얻었는지 유지한다.
Control Loop
Observe
  ↓
Decide
  ↓
Act
  ↓
Observe
를 반복한다.
6.14 HOW — Agent가 스스로 모든 것을 하는 것은 아니다
AI Agent라는 표현 때문에:
LLM이 자유롭게 컴퓨터를 돌아다니며
모든 일을 스스로 수행한다.
라고 이해하기 쉽다.
하지만 실제 시스템에서는 허용된 Tool과 Runtime의 범위 안에서 동작하도록 설계하는 것이 중요하다.
예를 들어 Agent에게 제공된 Tool이:
search_papers

get_paper

save_note
뿐이라면 이 Agent가 사용할 수 있는 기능도 기본적으로 그 범위 안에서 정의된다.
Agent
  │
  ├── search_papers ✓
  ├── get_paper ✓
  ├── save_note ✓
  │
  └── send_email ✕
즉:
Tool은 Agent가 세상과 상호작용할 수 있는 Interface다.
6.15 HOW — Workflow와 Agent는 같은 것일까?
여기서 또 하나 중요한 구분이 있다.
예를 들어 논문 처리 순서가 항상:
Search
 ↓
Download
 ↓
Summarize
 ↓
Save
라고 정해져 있다고 하자.
이 흐름은 코드로 고정할 수 있다.
Step 1
 ↓
Step 2
 ↓
Step 3
 ↓
Step 4
이런 구조는 Workflow에 가깝다.
반면 어떤 Tool을 다음에 사용할지 상황에 따라 달라진다면:
          Result
            ↓
           LLM
       ┌────┼────┐
       ▼    ▼    ▼
    Search Read Save
Agentic한 의사결정이 더 많이 들어간다.
따라서 개념적으로:
Workflow

Path가 상대적으로 명확


Agent

Next Action이
상태에 따라 동적으로 결정
이라고 구분할 수 있다.
둘은 완전히 배타적인 것도 아니다.
실제 시스템에서는:
Workflow
   +
Agentic Step
처럼 결합할 수도 있다.
6.16 HOW — 언제 Agent가 필요하고 언제 Workflow가 나을까?
무조건 Agent를 사용하는 것이 좋은 설계는 아니다.
작업 순서가 명확하다면:
Input
 ↓
Translate
 ↓
Summarize
 ↓
Save
굳이 매 단계마다 LLM에게:
다음에는 무엇을 해야 할까?
를 판단하게 만들 필요가 없다.
고정 Workflow가 더 단순하고 예측 가능하다.
반면:
관련 논문을 조사하고
부족한 정보가 있으면 추가 검색한 뒤
충분한 근거가 모이면 결과를 정리해줘.
처럼 다음 행동이 중간 결과에 따라 달라지는 Task라면 Agentic Loop가 유용할 수 있다.
즉:
Predictable Task
      ↓
Workflow


Dynamic Task
      ↓
Agentic Decision
이라는 설계 관점이 필요하다.
6.17 HOW — Tool Calling에는 안전장치가 필요하다
Text를 생성하는 것과 실제 Action을 실행하는 것은 위험도가 다르다.
예를 들어:
Search는 비교적 읽기 중심의 작업이다.
하지만:
Delete File

Send Email

Update Database

Make Payment
같은 Tool은 실제 상태를 변경한다.
따라서 Application에서는 Tool Call을 무조건 실행하기보다:
LLM Tool Call
      ↓
Validation
      ↓
Permission Check
      ↓
Optional User Confirmation
      ↓
Execution
같은 Control Layer가 필요할 수 있다.
즉:
LLM Decision
     ≠
Automatic Permission
이다.
LLM이 어떤 Action을 제안했다는 것과 그 Action을 실행해도 된다는 것은 별개의 문제다.
6.18 HOW — Tool Result도 검증해야 한다
Tool이 실행되었다고 항상 성공하는 것도 아니다.
예를 들어 논문 검색 API가:
404

Rate Limit

Empty Result

Invalid Query

Timeout
등을 반환할 수 있다.
따라서:
Tool Call
   ↓
Execution
   ↓
Success?
   │
 ┌─┴─┐
 │   │
YES  NO
 │   │
 ▼   ▼
Result Error Handling
이 필요하다.
Agent가 여러 Tool을 사용하는 경우에는 이런 Error Handling이 더욱 중요해진다.
6.19 CODE — 가장 단순한 Tool부터 만들어보자
이번에도 먼저 Framework 없이 핵심 구조를 직접 만들어보자.
논문 검색 Function이 있다고 가정한다.
def search_papers(
    query,
    year_from=None,
    limit=5
):
    # 실제 환경에서는
    # 논문 API / DB 등을 호출할 수 있다.

    return [
        {
            "title": "Korean Speech Variation Study",
            "year": 2023
        },
        {
            "title": "Pronunciation Modeling for ASR",
            "year": 2021
        }
    ]
이 Function은 실제 작업을 수행하는 Tool Implementation이다.
6.20 CODE — Tool Schema를 정의한다
LLM에게 이 Function을 설명해야 한다.
개념적인 Schema는 다음과 같다.
search_papers_tool = {
    "name": "search_papers",

    "description":
        "Search research papers by topic and year.",

    "parameters": {
        "query": {
            "type": "string"
        },
        "year_from": {
            "type": "integer"
        },
        "limit": {
            "type": "integer"
        }
    }
}
여기서:
Tool Implementation과:
Tool Schema는 구분해야 한다.
Schema는:
LLM에게 Tool 사용법을 알려준다.
Implementation은:
실제 기능을 수행한다.
6.21 CODE — LLM의 Tool Call을 받아 실행한다
LLM이 다음과 같은 Tool Call을 생성했다고 가정하자.
tool_call = {
    "name": "search_papers",
    "arguments": {
        "query": "Korean ASR",
        "year_from": 2020,
        "limit": 3
    }
}
Application은 Function Name을 확인한다.
if tool_call["name"] == "search_papers":

    result = search_papers(
        **tool_call["arguments"]
    )
전체 구조는:
Natural Language Request
        ↓
LLM
        ↓
Structured Tool Call
        ↓
Python Function
        ↓
Result
이다.
6.22 CODE — 여러 Tool을 연결해보자
이번에는 Research Workflow에 필요한 Tool을 여러 개 만든다.
def search_papers(query):
    ...


def get_paper_content(paper_id):
    ...


def save_research_note(
    title,
    content
):
    ...
LLM에게 제공되는 Tool은:
Tools

├─ search_papers
├─ get_paper_content
└─ save_research_note
이다.
사용자 요청:
"한국어 자연발화 ASR 논문을 찾아
핵심 결과를 연구노트에 저장해줘."
첫 번째 판단:
LLM
 ↓
search_papers
결과:
Paper A
Paper B
Paper C
두 번째 판단:
LLM
 ↓
get_paper_content
세 번째 판단:
LLM
 ↓
save_research_note
이제 단일 Function Call에서 Multi-step Tool Use로 확장됐다.
6.23 CODE — Agent Loop의 핵심 구조
Agent Loop를 매우 단순화하면:
while True:

    response = llm(
        messages=messages,
        tools=tools
    )

    if response.has_tool_call:

        result = execute_tool(
            response.tool_call
        )

        messages.append(
            result
        )

    else:
        final_answer = response.text
        break
핵심은 코드의 문법이 아니다.
구조를 보자.
LLM
 ↓
Tool Call?
 │
 ├─ YES
 │    ↓
 │   Execute Tool
 │    ↓
 │   Add Result to Context
 │    ↓
 │   LLM
 │
 └─ NO
      ↓
   Final Answer
즉 Agent는 마법 같은 별도의 존재라기보다 LLM + Tools + State + 반복 Control Logic으로 이해할 수 있다.
6.24 LLM — Research Agent를 조립해보자
이제 하나의 Research Agent를 생각해보자.
사용자의 Goal:
"2020년 이후
한국어 자연발화 ASR 논문을 찾아서

음운 변이와 관련된 결과를 비교하고

핵심 내용을 연구노트에 저장해줘."
Agent에게 다음 Tool이 제공되어 있다.
Tools

① search_papers

② retrieve_passages

③ get_paper_metadata

④ save_research_note
첫 번째 단계:
Goal
 ↓
LLM
 ↓
"먼저 관련 논문이 필요하다."
 ↓
search_papers
결과:
Paper A
Paper B
Paper C
다시 판단한다.
Search Result
      ↓
LLM
      ↓
"음운 변이 관련 Passage를 찾아야 한다."
      ↓
retrieve_passages
결과:
Relevant Passage A

Relevant Passage B

Relevant Passage C
LLM이 결과를 비교한다.
Retrieved Evidence
        ↓
LLM
        ↓
Analysis
        ↓
Research Summary
마지막으로:
Research Summary
       ↓
save_research_note
       ↓
Saved
최종적으로 사용자에게:
"관련 논문 3편을 검토하고
음운 변이와 ASR 성능의 관계를 정리해
연구노트에 저장했습니다."
라고 응답할 수 있다.
이제 LLM은 단순히 Text를 생성한 것이 아니다.
허용된 Tool을 통해 외부 System과 상호작용하는 Application의 의사결정 구성 요소가 되었다.
6.25 RAG와 Tool Calling을 하나로 연결하면
chapter.5와 6을 연결해보자.
RAG:
Question
 ↓
Retriever
 ↓
External Knowledge
 ↓
LLM
Tool Calling:
Request
 ↓
LLM
 ↓
Tool
 ↓
External System
둘을 결합하면:
                    ┌─ Search
                    │
                    ├─ RAG
                    │
User → LLM ─────────┼─ Database
       ▲            │
       │            ├─ API
       │            │
       │            └─ File System
       │
       └──── Tool Results
즉 LLM Application은:
LLM
 +
Knowledge
 +
Tools
 +
Control Logic
으로 확장된다.
6.26 Tool Calling과 Agent의 차이를 다시 정리하면
이 둘을 같은 의미로 사용하면 안 된다.
Tool Calling
LLM
 ↓
Tool Selection
 ↓
Arguments
 ↓
Tool Execution
 ↓
Result
핵심:
LLM과 외부 Function을 연결하는 Mechanism
Agent
Goal
 ↓
LLM
 ↓
Decision
 ↓
Tool
 ↓
Observation
 ↓
LLM
 ↓
Next Decision
 ↓
...
핵심:
현재 상태와 Tool Result를 바탕으로 다음 행동을 반복적으로 결정하는 System
따라서:
Tool Calling

Agent를 구성할 수 있는
핵심 Mechanism 중 하나
라고 이해하는 것이 좋다.
Workflow와 Agent도 다시6.27 구분해보자
세 개념을 함께 놓으면 더 선명하다.
Tool Calling
│
└─ 외부 Function을 호출하는 Mechanism


Workflow
│
└─ 미리 정의된 절차를 따라 실행하는 구조


Agent
│
└─ 현재 상태를 보고 다음 Action을
   동적으로 결정하는 구조
예를 들어:
PDF 업로드
 ↓
Text 추출
 ↓
요약
 ↓
저장
순서가 항상 같다면 Workflow로 충분할 수 있다.
반면:
Research Goal
     ↓
Search
     ↓
충분한 자료가 있는가?
   ↙            ↘
 NO              YES
 ↓                ↓
Search Again    Analyze
                  ↓
               Save
처럼 결과에 따라 다음 행동이 달라진다면 Agentic한 구조가 유용할 수 있다.
6.28 WHY → HOW → CODE → LLM으로 다시 정리하면
WHY
LLM의 기본 출력은 Text다.
LLM
 ↓
Token
 ↓
Text
하지만 실제 Application에는:
Search

API

Database

File

External Service
가 필요하다.
따라서:
Text Generation
       ↓
External Action
을 연결할 Interface가 필요하다.
HOW
LLM에게 Tool Schema를 제공한다.
Tool Name
+
Description
+
Parameters
사용자 요청이 들어오면:
User Request
      ↓
LLM
      ↓
Tool Selection
      ↓
Argument Generation
      ↓
Structured Tool Call
      ↓
Runtime
      ↓
Tool Execution
결과를 다시 Context에 추가한다.
Tool Result
     ↓
LLM Context
     ↓
Next Decision / Answer
CODE
Function을 만들고:
search_papers()Schema를 정의하고:
name
description
parameters
LLM의 Structured Tool Call을:
{
  "name": "...",
  "arguments": {...}
}
실제 Function Execution으로 연결했다.
그리고 이를 반복하면:
LLM
 ↓
Tool
 ↓
Result
 ↓
LLM
 ↓
Tool
 ↓
...
이라는 Agent Loop를 만들 수 있다.
LLM
최종적으로:
                  Goal
                   │
                   ▼
                  LLM
                   │
          ┌────────┼─────────┐
          │        │         │
          ▼        ▼         ▼
       Search     RAG       Database
          │        │         │
          └────────┼─────────┘
                   │
                   ▼
               Tool Results
                   │
                   ▼
                  LLM
                   │
             Next Decision
                   │
                   ▼
                 ...
                   │
                   ▼
               Final Result
가 된다.
6.29 지금까지의 전체 흐름
이제 시리즈 전체를 처음부터 연결해보자.
처음에는 자연어 하나에서 시작했다.
Language이를 모델이 계산할 수 있도록:
Language
   ↓
Tokenization
   ↓
Embedding
   ↓
Number
로 바꿨다.
Transformer는:
Number
   ↓
Attention
   ↓
Transformer
   ↓
Context
를 계산했다.
그리고:
Context
   ↓
Logits
   ↓
Decoding
   ↓
Generation
으로 답변을 만들었다.
여기까지가 LLM Core였다.
그 다음 외부 Knowledge를 연결했다.
LLM
 +
External Knowledge
 ↓
RAG
그리고 이번에는 외부 Capability를 연결했다.
LLM
 +
External Tools
 ↓
Tool Calling
여기에 반복적인 의사결정을 추가하면:
LLM
 +
Tools
 +
State
 +
Control Loop
 ↓
Agent
로 확장된다.
전체 흐름은:
Language
   ↓
Number
   ↓
Context
   ↓
Generation
   ↓
────────────────
    LLM Core
   ↓
External Knowledge
   ↓
RAG
   ↓
External Capability
   ↓
Tool Calling
   ↓
Multi-step Decision
   ↓
Agent
   ↓
────────────────
  LLM System
이 된다.
6.30 Agent가 끝은 아니다
여기까지 오면 LLM이 상당히 많은 일을 할 수 있는 것처럼 보인다.
하지만 실제 시스템을 만들려면 새로운 질문들이 생긴다.
Tool이 잘못 선택되면?

검색 결과가 틀리면?

Agent가 같은 행동을 반복하면?

어떤 단계에서 실패했는지 어떻게 알까?

RAG 검색 품질은 어떻게 평가할까?

생성된 Answer는 어떻게 평가할까?

Agent의 실행 결과는 어떻게 테스트할까?
즉:
동작하는 LLM System을 만들었다면, 이제 그것이 제대로 동작하는지 측정해야 한다.
그래서 마지막에는 지금까지 분리해서 배운 모든 구성 요소를 다시 조립하고, 각 단계의 입력과 출력을 추적해볼 필요가 있다.
다음 글
7. Final — LLM System 다시 조립하기
마지막 글에서는 새로운 기술을 계속 추가하기보다 지금까지 배운 구조를 하나로 합친다.
User Input
    ↓
Tokenizer
    ↓
Embedding
    ↓
Transformer
    ↓
Generation
    ↓
        ┌──────────────┐
        │              │
        ▼              ▼
      RAG          Tool Calling
        │              │
        ▼              ▼
External Knowledge  External Action
        │              │
        └──────┬───────┘
               ▼
          LLM System
그리고 하나의 요청이 들어왔을 때:
어떤 Text가 입력되고

어떤 Vector가 만들어지고

어떤 Context가 구성되고

어떤 Token이 생성되고

언제 Retrieval이 실행되고

언제 Tool이 호출되고

어떻게 최종 Answer가 만들어지는지
처음부터 끝까지 추적한다.
0편에서 Black Box처럼 보였던:
User
 ↓
LLM
 ↓
Answer
를 마지막에는:
User
 ↓
Language
 ↓
Token
 ↓
Vector
 ↓
Attention
 ↓
Context
 ↓
Generation
 ↓
Retrieval / Tool
 ↓
External System
 ↓
Result
 ↓
LLM
 ↓
Answer
로 완전히 펼쳐보는 것이 이번 시리즈의 마지막 목적지이다!