7. Final — LLM System 다시 조립하기
chapter.0에서 처음 LLM을 바라봤을 때 구조는 아주 단순했다.
User
 ↓
LLM
 ↓
Answer
사용자가 Text를 입력하면 LLM이 답변을 만든다.
겉으로 보면 이게 전부다.
하지만 chapter.1부터 6까지 이 Black Box를 하나씩 열어봤다.
Language
   ↓
Number
   ↓
Context
   ↓
Generation
   ↓
External Knowledge
   ↓
External Action
그 과정에서:
Tokenization
Embedding
Vector
Tensor

Attention
Q · K · V
Transformer

Logits
Softmax
Decoding

RAG
Vector Search

Tool Calling
Agent
을 각각 분리해서 살펴봤다.
이번에는 새로운 기술을 추가하지 않는다.
대신 지금까지 배운 구조를 하나의 실제 LLM System 안에서 다시 조립해본다.
7.0 Final Mission — 학습자의 자유발화를 분석하는 AI를 만든다면?
이번에는 앞에서 사용했던 논문 검색 예제를 떠나 완전히 다른 문제를 생각해보자.
한국어를 학습하는 외국인 학습자가 AI Language Tutor와 자유롭게 대화하고 있다고 하자.
학습자가 다음과 같이 말했다.
"어제 친구하고 영화를 봤는데
영화가 재미있어서 시간이 빨리 갔어요.

근데 영화 끝나고 친구가
밥을 먹자고 했는데 저는 이미 먹었어서
그냥 카페에 갔어요."
그리고 이렇게 요청한다.
"제가 방금 말한 한국어를 분석해서
어색한 표현을 찾아주고,

왜 어색한지 설명한 다음
제가 자주 틀리는 부분을 반영해서
연습문제도 만들어 주세요."
단순한 Chatbot이라면 바로 답변을 생성할 수도 있다.
하지만 우리가 만들고 싶은 것은 조금 다르다.
학습자의 실제 발화
        ↓
언어적 특징 분석
        ↓
오류 후보 탐지
        ↓
학습자 수준과 과거 오류 확인
        ↓
관련 문법·용례 검색
        ↓
개인화된 설명
        ↓
연습문제 생성
        ↓
학습 기록 업데이트
이 시스템을 만든다고 생각해보자.
그럼 하나의 주제 아래 지금까지 배운 거의 모든 개념이 필요해질 것이다.
7.1 WHY — 왜 LLM 하나만 호출하면 끝나는 문제가 아닐까?
LLM에게 그대로:
"이 발화를 분석해줘."라고 요청하면 답변을 생성할 수 있다.
하지만 실제 Language Learning System이라면 몇 가지 문제가 생긴다.
첫째, 학습자의 과거 학습 기록을 알아야 한다.
최근 자주 틀린 문법은 무엇인가?

어휘 수준은 어느 정도인가?

같은 오류를 반복하고 있는가?
둘째, 피드백의 근거가 필요하다.
문법 설명

실제 용례

교육 자료

학습 수준별 설명
셋째, 결과를 다시 시스템에 기록해야 한다.
이번에 발견된 오류

새롭게 학습한 표현

다음 복습 대상
즉 이 문제는:
LLM하나가 아니라,
LLM
+
Learner Data
+
External Knowledge
+
Tools
+
Control Logic
이 결합된 LLM System 문제다.
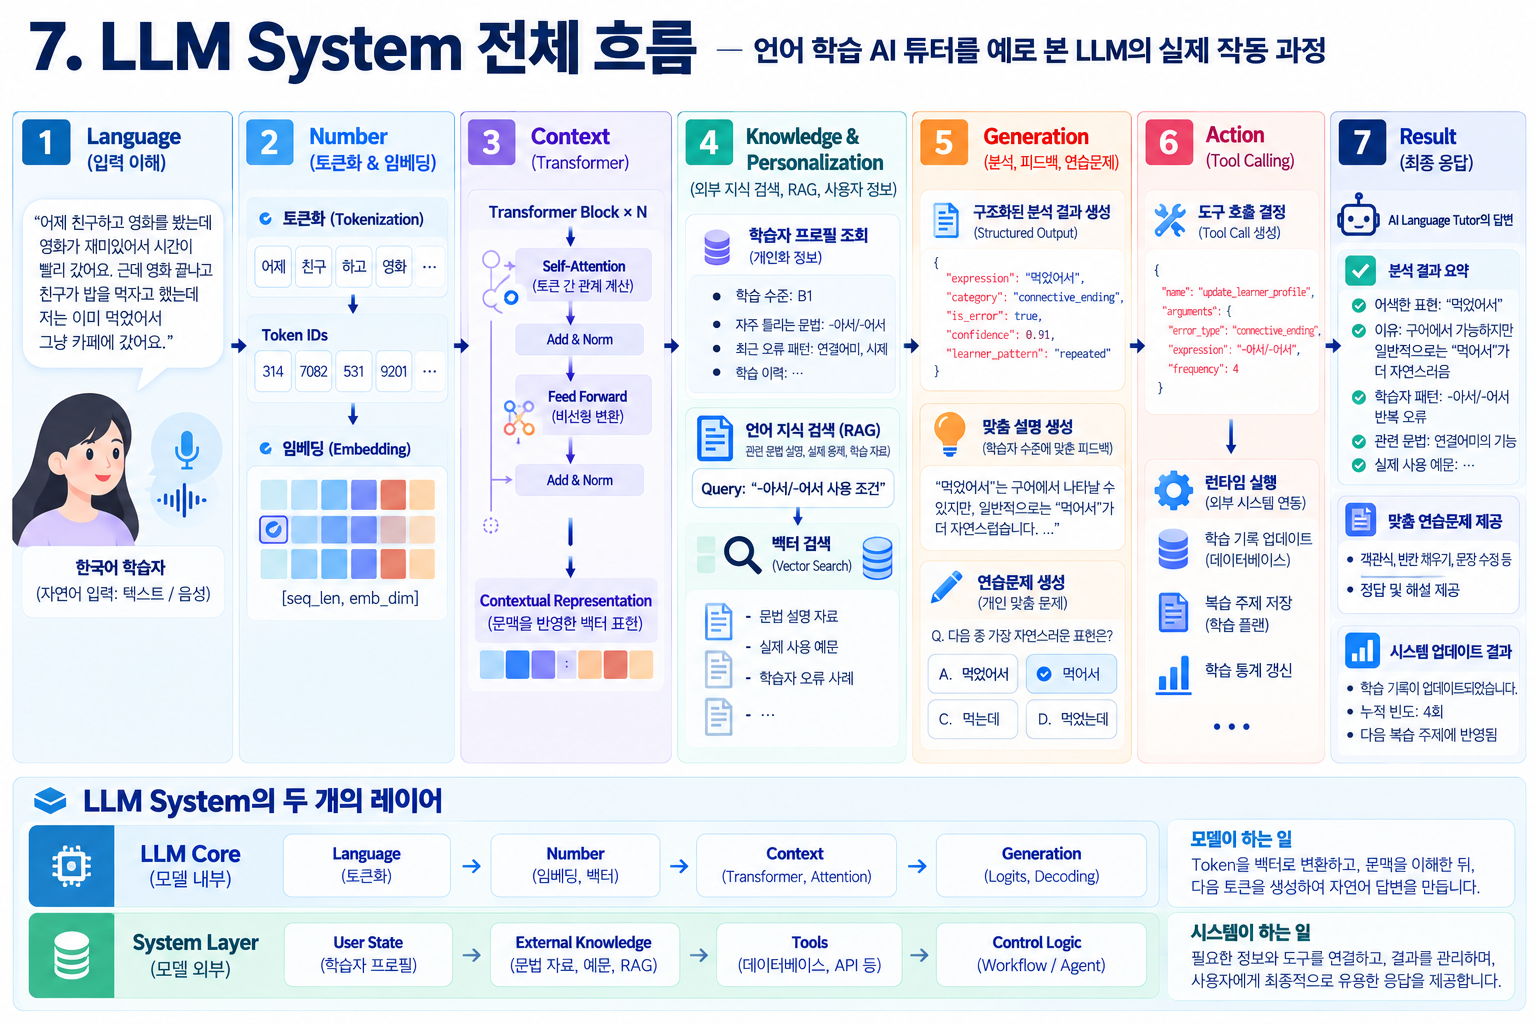
7.2 전체 System을 먼저 펼쳐보자
이번 예제를 전체 구조로 그리면 다음과 같다.
Learner Utterance
        ↓
Speech / Text Input
        ↓
Tokenizer
        ↓
Token IDs
        ↓
Embedding
        ↓
Transformer
        ↓
Contextual Representation
        ↓
Language Analysis
        ↓
 ┌──────────────┬────────────────┐
 │              │                │
 ▼              ▼                ▼
Learner      Grammar /         Error
Profile      Example RAG       Detection
 │              │                │
 └──────────────┼────────────────┘
                ↓
         Updated Context
                ↓
               LLM
                ↓
      Personalized Feedback
                ↓
       Structured Output
                ↓
       ┌────────┴────────┐
       ▼                 ▼
Practice Generation   Profile Update
       │                 │
       └────────┬────────┘
                ↓
           Final Response
이제 이 흐름을 하나씩 따라가보자.
7.3 Language — 출발점은 다시 인간의 언어다
입력은 학습자의 자연스러운 발화다.
"친구가 밥을 먹자고 했는데
저는 이미 먹었어서
그냥 카페에 갔어요."
여기에는 단순한 단어 이상의 정보가 있다.
문법

어휘

담화 관계

시제

화자의 의도

표현의 자연스러움
같은 요소가 함께 존재한다.
사람은 이것을 언어로 바로 이해하지만 모델은 먼저 계산 가능한 형태로 바꿔야 한다.
Language
   ↓
Number
2편에서 시작했던 문제가 다시 등장한다.
7.4 Number — Language가 Token과 Vector로 변환된다
Tokenizer가 Text를 Token Sequence로 변환한다.
Text
 ↓
Tokenizer
 ↓
Subword Tokens
 ↓
Token IDs
그리고 Token ID는 Embedding Matrix를 통해 Vector가 된다.
Token ID
   ↓
Embedding Lookup
   ↓
Token Vector
문장 전체는:
Token 1 → Vector 1
Token 2 → Vector 2
Token 3 → Vector 3
...
로 표현된다.
이를 Matrix로 쌓고 Batch Dimension까지 포함하면 Tensor가 된다.
[batch_size,
 sequence_length,
 embedding_dimension]
여기서 1편에서 배웠던 개념이 실제 LLM 입력으로 연결된다.
Vector
 ↓
one Token

Matrix
 ↓
one Sequence

Tensor
 ↓
Batch of Sequences
즉:
Human Language
      ↓
Tokenization
      ↓
Embedding
      ↓
Numerical Representation
이 완료됐다.
7.5 Context — 모델은 왜 단어 하나만 보면 안 될까?
이번 발화에서:
"먹었어서"만 떼어 놓고 보면 분석하기 어렵다.
앞에는:
친구가 밥을 먹자고 했는데가 있고,
뒤에는:
그냥 카페에 갔어요.가 있다.
즉 표현의 자연스러움과 의미는 주변 Context와 연결되어 있다.
여기서 Self-Attention이 다시 등장한다.
Token Embeddings
       ↓
Q / K / V
       ↓
Attention Scores
       ↓
Softmax
       ↓
Attention Weights
       ↓
Contextual Representation
모델은 각 Token을 독립적으로 처리하는 것이 아니라 다른 Token과의 관계를 계산한다.
따라서:
Token Embedding이 Transformer Layer를 통과하면서:
Contextual Representation으로 변한다.
7.6 Context — 언어인지 관점에서 보면 무엇이 달라졌을까?
여기서 흥미로운 지점이 하나 있다.
Embedding 단계의 Representation은 Token의 출발 표현에 가깝다.
하지만 실제 언어 이해에서는 같은 표현도 Context에 따라 역할이 달라진다.
예를 들어:
"먹었어요."와:
"이미 먹었어서 카페에 갔어요."에서 먹었이라는 형태가 놓인 언어적 환경은 다르다.
Transformer는 주변 Token과의 관계를 반복적으로 계산하면서 Representation을 갱신한다.
Initial Representation
        ↓
Context Interaction
        ↓
Updated Representation
        ↓
Context Interaction
        ↓
Updated Representation
따라서 LLM의 언어 처리를 단순한:
단어 → 의미매핑으로 보기보다는:
Token Representation
        +
Contextual Interaction
        ↓
Context-sensitive Representation
으로 보는 편이 구조적으로 더 정확하다.
여기서 언어인지과학과 LLM 사이의 흥미로운 연결점도 나타난다.
인간의 언어 처리와 Transformer가 동일한 메커니즘이라는 뜻은 아니다.
하지만 둘 모두에서:
언어 단위의 해석은 주변 Context와 분리해서 보기 어렵다.
는 문제를 발견할 수 있다.
7.7 Generation — 모델은 분석 결과를 어떻게 Text로 만들까?
Transformer를 통과한 뒤 모델은 Contextual Representation을 가진다.
Generation 과정에서는:
Contextual Representation
        ↓
LM Head
        ↓
Logits
        ↓
Softmax
        ↓
Token Probability
        ↓
Decoding
        ↓
Next Token
을 반복한다.
예를 들어 모델이:
"‘먹었어서’는 이 문맥에서는..."까지 생성했다고 하자.
다음 Token 후보에 대한 Logits가 계산된다.
조금      5.1
다소      4.6
문법적으로 3.9
자연스럽지 3.7
...
Softmax를 거쳐 Probability Distribution이 만들어지고 Decoding Strategy에 따라 다음 Token이 선택된다.
이 과정이 반복되면서 설명 문장이 생성된다.
7.8 그런데 바로 답변을 생성하면 충분할까?
여기서 시스템 관점의 질문을 해야 한다.
사용자는 단순히:
"이 문장이 자연스러운가?"만 묻지 않았다.
요청에는:
내 발화를 분석하고

왜 어색한지 설명하고

내가 자주 틀리는 부분을 반영해서

연습문제를 만들어줘.
가 포함되어 있다.
특히:
"내가 자주 틀리는 부분"은 현재 Prompt만으로 알 수 없다.
따라서 외부 정보가 필요하다.
7.9 External Context — Learner Profile을 가져온다
학습자의 기존 기록이 Database에 있다고 하자.
Learner Profile

Level
B1

Frequent Errors
- 연결어미
- 시제 일치
- 조사 선택

Recent Pattern
- -아서 / -어서 연결 표현 반복 오류
현재 요청만 보면:
Current Utterance만 존재한다.
Learner Profile을 가져오면:
Current Utterance
        +
Learner History
가 된다.
즉 모델이 같은 발화를 분석하더라도 사용자에 따라 다른 피드백을 만들 수 있다.
Same Sentence

Learner A
 ↓
Beginner Explanation


Learner B
 ↓
Advanced Explanation
이것이 Personalization이다.
7.10 RAG — 설명의 근거를 외부 Knowledge에서 가져온다
이번에는 문법 설명이 필요하다.
LLM의 Parameter에만 의존하지 않고 검증된 학습 자료를 Retrieval하도록 설계할 수 있다.
예를 들어 Knowledge Base에:
Korean Grammar Guide

Learner Corpus

Usage Examples

Teaching Materials
가 저장되어 있다고 하자.
Indexing 단계에서는:
Documents
   ↓
Chunking
   ↓
Embedding
   ↓
Vector Store
가 이루어진다.
현재 오류 후보:
"-아서 / -어서 연결 표현"를 Query로 만든다.
Query
 ↓
Embedding
 ↓
Vector Search
관련 자료를 찾는다.
Retrieved Knowledge

- 연결어미의 기능
- 원인·이유 표현의 제약
- 자연스러운 실제 용례
- 학습자 오류 사례
이제:
Learner Utterance
       +
Learner Profile
       +
Retrieved Knowledge
가 하나의 Context를 구성한다.
7.11 지금 Context에는 세 종류의 정보가 있다
여기서 구조를 분리해서 보면 중요하다.
① Current Input
학습자가 지금 말한 것② User-specific Context
학습자의 수준과 과거 오류③ External Knowledge
문법 자료와 실제 용례이를 결합하면:
Current Input
      +
Learner Context
      +
External Knowledge
      ↓
Augmented Context
가 된다.
LLM은 이제 단순히 “문법적으로 맞다/틀리다”가 아니라 학습자에게 맞는 피드백을 생성할 수 있다.
7.12 Structured Output — 분석 결과를 먼저 구조화한다
실제 시스템에서는 바로 긴 설명문을 생성하는 것보다 중간 분석 결과를 구조화하는 것이 유용할 수 있다.
예를 들어:
{
  "expression": "먹었어서",
  "category": "connective_ending",
  "confidence": 0.91,
  "learner_pattern": "repeated",
  "needs_feedback": true
}
처럼 표현할 수 있다.
이 구조는 프로그램이 후속 처리를 하기 쉽다.
Language Analysis
       ↓
Structured Result
       ↓
 ┌──────────────┬──────────────┐
 ▼              ▼              ▼
Feedback      Exercise       Profile
Generation    Generation     Update
여기서 6편의 Structured Output이 다시 연결된다.
7.13 Tool Calling — 이제 실제 시스템 상태를 바꾼다
피드백 생성만으로는 학습 시스템이 완성되지 않는다.
이번 오류를 다음 학습에도 반영하려면 기록해야 한다.
예를 들어:
update_learner_profile이라는 Tool이 있다고 하자.
Tool Schema는 개념적으로:
{
  "name": "update_learner_profile",
  "parameters": {
    "error_type": "string",
    "expression": "string",
    "frequency": "integer"
  }
}
LLM은 현재 분석 결과를 보고:
이 오류를 학습 기록에 추가해야 한다.고 판단한다.
그리고:
{
  "name": "update_learner_profile",
  "arguments": {
    "error_type": "connective_ending",
    "expression": "-아서/-어서",
    "frequency": 4
  }
}
와 같은 Tool Call을 생성할 수 있다.
하지만 실제 Database Update는 LLM이 하지 않는다.
LLM
 ↓
Tool Call
 ↓
Runtime
 ↓
Database
이다.
7.14 Tool Result — 실제 업데이트 결과를 다시 확인한다
Runtime이 Database를 업데이트한다.
Learner Profile Updated결과가 다시 LLM에게 전달된다.
Tool Result
     ↓
Updated Context
이제 모델은:
이번 오류가 반복된 오류라는 사실
+
Profile Update 성공 여부
를 알고 다음 단계를 결정할 수 있다.
7.15 다음 Action은 무엇일까?
사용자는 연습문제도 요청했다.
따라서 현재 Context를 이용해 개인화된 문제를 생성한다.
Detected Error
      +
Learner Level
      +
Past Error Pattern
      +
Retrieved Examples
      ↓
Practice Generation
예를 들어 일반적인 문법 문제가 아니라:
다음 상황에서 가장 자연스러운 표현을 고르세요.

A. 밥을 이미 먹었어서 카페에 갔어요.
B. 밥을 이미 먹어서 카페에 갔어요.
C. 밥을 이미 먹는데 카페에 갔어요.
처럼 실제 오류 패턴과 연결된 연습문제를 만들 수 있다.
즉 Generation이 단순한 Text Generation이 아니라:
Context-conditioned Generation이 된다.
7.16 여기서 Agent가 꼭 필요할까?
6편에서 배웠듯 복잡해 보인다고 해서 무조건 Agent가 필요한 것은 아니다.
현재 시스템의 절차가 항상:
Analyze
 ↓
Retrieve Profile
 ↓
Retrieve Knowledge
 ↓
Generate Feedback
 ↓
Generate Practice
 ↓
Update Profile
이라면 고정된 Workflow로 만드는 편이 더 적절할 수 있다.
하지만 요청이:
"제 발화를 계속 분석하면서
필요하면 이전 학습 내용을 찾아보고,
같은 오류가 반복되면 추가 연습을 만들고,
충분히 개선되었다면 다음 학습 항목으로 넘어가 주세요."
처럼 바뀐다면 상황이 달라진다.
Current Performance
       ↓
      LLM
   ┌────┼────────────┐
   ▼    ▼            ▼
Review Practice   Next Topic
다음 행동이 상태에 따라 달라진다.
이런 경우 Agentic Decision이 의미를 갖기 시작한다.
7.17 Workflow와 Agent를 실제 사례에서 비교하면
Workflow
Utterance
 ↓
Analyze
 ↓
Retrieve
 ↓
Feedback
 ↓
Practice
 ↓
Save
Path가 미리 정해져 있다.
Agentic System
Utterance
 ↓
Analyze
 ↓
Current Learner State
 ↓
LLM Decision
 │
 ├─ 설명이 부족함 → Retrieve More
 │
 ├─ 반복 오류 → Generate Practice
 │
 ├─ 이해 완료 → Next Topic
 │
 └─ 판단 불확실 → Ask User
즉:
Workflow

"정해진 일을 수행한다."


Agent

"현재 상태를 보고
다음 일을 결정한다."
라는 차이가 실제 시스템 안에서 보인다.
7.18 End-to-End — 하나의 요청을 처음부터 끝까지 따라가보자
이제 전체 과정을 한 번에 추적해보자.
User Input
"제가 방금 말한 한국어를 분석해서
어색한 표현을 찾아주고,
제가 자주 틀리는 부분을 반영해서
연습문제도 만들어 주세요."
① Language
Natural Language② Tokenization
Text
 ↓
Tokens
 ↓
Token IDs
③ Embedding
Token IDs
 ↓
Embedding Matrix
 ↓
Vectors
④ Context
Vectors
 ↓
Self-Attention
 ↓
Transformer
 ↓
Contextual Representation
⑤ Language Analysis
Contextual Representation
 ↓
Error Candidate Detection
⑥ Personal Context
Learner ID
 ↓
Profile Retrieval
 ↓
Past Error Pattern
⑦ External Knowledge
Error Candidate
 ↓
Vector Search
 ↓
Grammar / Usage Evidence
⑧ Context Augmentation
Current Utterance
       +
Learner Profile
       +
Retrieved Knowledge
       ↓
Augmented Context
⑨ Structured Analysis
Augmented Context
       ↓
LLM
       ↓
Structured Error Analysis
⑩ Generation
Analysis
 ↓
Personalized Feedback
 ↓
Practice Questions
⑪ Tool Calling
Detected Learning Pattern
       ↓
update_learner_profile
       ↓
Runtime
       ↓
Database
⑫ Tool Result
Profile Updated
 ↓
Updated Context
⑬ Final Response
Feedback
+
Explanation
+
Personalized Practice
결국 하나의 요청이:
Language
   ↓
Number
   ↓
Context
   ↓
Knowledge
   ↓
Personalization
   ↓
Generation
   ↓
Action
을 모두 통과했다.
7.19 CODE — 전체 시스템을 구조로 표현하면
이번에는 알고리즘 하나를 구현하는 대신 Application의 구조를 코드로 보자.
learner_request = {
    "utterance": """
    친구가 밥을 먹자고 했는데
    저는 이미 먹었어서
    그냥 카페에 갔어요.
    """,

    "request": """
    어색한 표현을 분석하고
    제가 자주 틀리는 부분을 반영해서
    연습문제를 만들어 주세요.
    """
}
먼저 필요한 Context를 준비한다.
learner_profile = get_learner_profile(
    learner_id
)
언어 분석 결과에서 Retrieval Query를 만든다.
knowledge = retrieve_language_examples(
    query="Korean connective ending usage"
)
그리고 Context를 구성한다.
context = {
    "utterance": learner_request["utterance"],
    "learner_profile": learner_profile,
    "knowledge": knowledge
}
이 Context를 기반으로 LLM이 분석한다.
analysis = llm.analyze(
    context=context,
    output_schema=language_analysis_schema
)
7.20 CODE — 분석 결과가 다음 동작의 Input이 된다
구조화된 분석 결과가:
analysis = {
    "error_type": "connective_ending",
    "expression": "먹었어서",
    "is_repeated_error": True
}
라고 하자.
이 결과를 기반으로 Feedback을 생성한다.
feedback = generate_feedback(
    analysis=analysis,
    learner_profile=learner_profile,
    knowledge=knowledge
)
반복 오류라면 연습문제를 생성한다.
if analysis["is_repeated_error"]:

    practice = generate_practice(
        error_type=analysis["error_type"],
        learner_level=learner_profile["level"]
    )
그리고 Profile을 업데이트한다.
update_learner_profile(
    learner_id=learner_id,
    error_type=analysis["error_type"]
)
여기서 중요한 것은:
Output of Step A
       ↓
Input of Step B
라는 연결이다.
이것이 Pipeline이다.
7.21 Model과 System은 다르다
이 예제를 보면 차이가 훨씬 선명하다.
LLM Model
모델 내부에서는:
Tokens
 ↓
Embeddings
 ↓
Transformer
 ↓
Hidden States
 ↓
Logits
 ↓
Tokens
이 일어난다.
하지만 우리가 만든 AI Language Tutor에는:
Learner Profile

Grammar Knowledge Base

Vector Search

Structured Output

Practice Generator

Database

Tool Calling

Control Logic
이 추가되어 있다.
따라서:
LLM
≠
AI Language Tutor
다.
정확히는:
                LLM
                 │
                 ▼
Learner Data → Application ← Knowledge Base
                 │
                 ├─ Retrieval
                 ├─ Tools
                 ├─ State
                 └─ Control Logic
                 │
                 ▼
          Language Tutor
가 된다.
LLM은 시스템의 핵심 Engine이지만 전체 Product 자체는 아니다.
7.22 현재 LLM 개발에서 왜 이 구분이 중요할까?
최근 LLM Application 개발에서는 단순히:
Prompt
 ↓
LLM
 ↓
Answer
만 잘 만드는 것보다 모델 주변의 Context와 System을 어떻게 설계하는가가 중요하다.
예를 들어 같은 모델을 사용하더라도:
System A

User
 ↓
LLM
과:
System B

User
 ↓
User State
 ↓
Relevant Knowledge Retrieval
 ↓
Structured Context
 ↓
LLM
 ↓
Tool
 ↓
Validation
은 전혀 다른 결과를 만들 수 있다.
즉 실제 개발에서는:
Model Capability
       +
Context Engineering
       +
Retrieval
       +
Tool Integration
       +
Evaluation
을 함께 봐야 한다.
모델의 성능만큼 모델에게 어떤 Context를 언제 제공하고, 어떤 외부 기능과 연결하며, 그 결과를 어떻게 검증할 것인가가 중요해진다.
7.23 Context Engineering 관점에서 다시 보면
앞에서는 Context를 Transformer 내부의 문맥 표현이라는 의미로 사용했다.
System Level에서는 더 넓은 의미의 Context도 생각할 수 있다.
이번 예제에서 LLM에게 제공되는 Context에는:
Current Utterance

Learner Level

Previous Errors

Retrieved Grammar Knowledge

Usage Examples

Current Task

Tool Results
가 포함될 수 있다.
즉 실제 Application에서는:
모델에게 어떤 정보를, 어떤 시점에, 어떤 구조로 제공할 것인가
가 중요한 설계 문제가 된다.
이를 넓게 Context Engineering 관점에서 바라볼 수 있다.
7.24 같은 모델인데 왜 결과가 달라질까?
두 시스템이 같은 LLM을 사용한다고 해보자.
System A
User Utterance
      ↓
LLM
      ↓
Feedback
System B
User Utterance
      ↓
Learner History
      +
Retrieved Evidence
      +
Task Instruction
      ↓
LLM
      ↓
Structured Analysis
      ↓
Personalized Feedback
Model은 같다.
하지만 Model이 받는 Context가 다르다.
따라서 결과도 달라진다.
이제:
좋은 LLM Application
=
좋은 Model
만으로 설명할 수 없다.
오히려:
LLM Application Quality

=
Model Capability
+
Context Quality
+
Retrieval Quality
+
Tool Reliability
+
System Design
처럼 생각해야 한다.
7.25 Evaluation — 이 시스템이 정말 잘 작동하는지 어떻게 알까?
이제 시스템을 만들었다.
하지만:
"잘 되는 것 같다."만으로는 충분하지 않다.
각 단계별로 평가해야 한다.
Language Analysis
실제 오류를 정확히 찾았는가?

정상 표현을 오류라고 판단하지 않았는가?

오류 유형을 정확히 분류했는가?
Retrieval
관련 문법 자료를 가져왔는가?

실제 용례가 Query와 관련 있는가?
Feedback
설명이 언어학적으로 타당한가?

학습자 수준에 적절한가?

근거와 모순되지 않는가?
Personalization
과거 오류 패턴을 실제로 반영했는가?

모든 사용자에게 같은 답을 만들고 있지는 않은가?
Tool
올바른 학습 기록을 업데이트했는가?

잘못된 정보가 Database에 저장되지는 않았는가?
Task Completion
사용자가 요청한

분석
+
설명
+
연습문제

를 모두 제공했는가?
즉:
Final Answer하나만 평가해서는 안 된다.
7.26 Observability — 어디서 잘못됐는지 추적할 수 있어야 한다
학습자에게 이상한 피드백이 나왔다고 하자.
원인은 LLM일 수도 있지만 아닐 수도 있다.
Utterance
 ↓
Error Detection
 ↓
Retrieval
 ↓
Learner Profile
 ↓
Prompt / Context
 ↓
Generation
 ↓
Tool Call
중 어느 단계에서든 문제가 생길 수 있다.
예를 들어:
잘못된 Error Detection
       ↓
잘못된 Retrieval Query
       ↓
관련 없는 Grammar Example
       ↓
Incorrect Feedback
일 수도 있다.
반대로:
Correct Analysis
       ↓
Correct Knowledge
       ↓
Wrong Learner Profile
       ↓
Inappropriate Feedback
일 수도 있다.
따라서 시스템은:
Input

Intermediate Result

Retrieval Result

Tool Call

Tool Result

Final Output
을 추적할 수 있어야 한다.
이것이 System-level Observability다.
7.27 언어인지과학 관점에서 다시 보면
이번 예제는 LLM의 구조를 배우는 것에서 한 단계 더 나아간다.
언어인지과학에서는 오래전부터:
언어 입력

어휘 접근

문맥 처리

의미 해석

언어 산출
같은 문제를 다뤄왔다.
LLM에서는 다른 계산 구조를 사용하지만 역시:
Language Input

Representation

Context Interaction

Prediction

Generation
이라는 문제를 해결한다.
여기서 중요한 것은:
Human Cognition
=
Transformer
라고 주장하는 것이 아니다.
두 시스템은 동일하지 않다.
오히려 흥미로운 질문은:
인간의 언어 처리에서 중요하게 다뤄온 문제들이 현재 LLM System에서는 어떤 계산 문제로 다시 나타나는가?
이다.
예를 들어:
Lexical Representation
↔
Embedding

Context-sensitive Interpretation
↔
Contextual Representation

Language Production
↔
Autoregressive Generation

Prior Knowledge
↔
Model Parameters / External Context

Individual Differences
↔
User State / Personalization
처럼 비교할 수 있다.
완전히 동일한 메커니즘은 아니지만 서로 다른 분야가 같은 언어 문제를 어떤 방식으로 다루는지 비교할 수 있다.
7.28 README의 첫 번째 축으로 돌아가보자
시리즈의 처음부터 유지했던 흐름은:
Language
 ↓
Number
 ↓
Context
 ↓
Generation
이었다.
이제 각각을 설명할 수 있다.
Language
Natural Language
 ↓
Tokenizer
 ↓
Tokens
Number
Tokens
 ↓
Token IDs
 ↓
Embedding
 ↓
Vector / Tensor
Context
Vectors
 ↓
Self-Attention
 ↓
Transformer
 ↓
Contextual Representation
Generation
Contextual Representation
 ↓
Logits
 ↓
Probability
 ↓
Decoding
 ↓
Next Token
이것이 LLM Core다.
7.29 그리고 LLM Core 밖으로 확장했다
현재 정보만으로 부족하다면:
LLM
 +
External Knowledge
 ↓
RAG
사용자별 정보가 필요하다면:
LLM
 +
User State
 ↓
Personalization
실제 기능을 실행해야 한다면:
LLM
 +
External Capability
 ↓
Tool Calling
다음 행동이 상황에 따라 달라진다면:
LLM
 +
Tools
 +
State
 +
Control Loop
 ↓
Agentic System
으로 확장할 수 있다.
그래서 전체 흐름은:
Language
   ↓
Number
   ↓
Context
   ↓
Generation
   ↓
────────────────────
       LLM Core
   ↓
External Context
   ↓
RAG / User State
   ↓
External Capability
   ↓
Tool Calling
   ↓
Control Logic
   ↓
────────────────────
      LLM System
이 된다.
7.30 README의 두 번째 축도 완성된다
두 번째 학습 축은:
WHY
 ↓
HOW
 ↓
CODE
 ↓
LLM
이었다.
우리는 기술 용어를 단순히 정의하지 않았다.
항상 먼저 물었다.
WHY

왜 이 문제가 생기는가?
그리고:
HOW

어떤 계산 구조로 해결하는가?
를 봤다.
그 다음:
CODE

실제로 어떻게 구현되는가?
를 확인했다.
마지막으로:
LLM

전체 모델과 시스템에서
어디에 위치하는가?
를 연결했다.
그래서 새로운 기술을 만났을 때도:
이 기술의 이름이 무엇인가?보다 먼저:
이 기술은 전체 Pipeline의
어떤 문제를 해결하기 위해 존재하는가?
를 물을 수 있다.
7.31 처음의 Black Box를 다시 보자
0편에서는:
User
 ↓
LLM
 ↓
Answer
였다.
이제 가운데 상자를 열면:
User Language
      ↓
Tokenization
      ↓
Token IDs
      ↓
Embedding
      ↓
Vector / Tensor
      ↓
Transformer
      ↓
Contextual Representation
      ↓
Generation
이 보인다.
그리고 그 바깥에는:
User State

RAG

Vector Search

External Knowledge

Structured Output

Tool Calling

Database

API

Control Logic
이 연결된다.
결국 우리가 사용하는 실제 AI Application은:
                    ┌─ Knowledge
                    │
                    ├─ User State
                    │
                    ├─ Retrieval
                    │
User → Application ─┼─ LLM
                    │
                    ├─ Tools
                    │
                    └─ Control Logic
                           ↓
                         Output
에 더 가깝다.
7.32 전체 구조를 한 장으로 압축하면
                         USER
                          │
                          ▼
                       Language
                          │
                          ▼
                       Tokenizer
                          │
                          ▼
                        Tokens
                          │
                          ▼
                       Embedding
                          │
                          ▼
                    Vector / Tensor
                          │
                          ▼
                     Transformer
                          │
                          ▼
              Contextual Representation
                          │
                          ▼
                     LLM Analysis
                          │
            ┌─────────────┼─────────────┐
            │             │             │
            ▼             ▼             ▼
      User State         RAG       Structured
      Retrieval      Vector Search   Analysis
            │             │             │
            ▼             ▼             │
      Learner Data   Knowledge          │
            │             │             │
            └─────────────┼─────────────┘
                          ▼
                   Augmented Context
                          │
                          ▼
                         LLM
                          │
             ┌────────────┴────────────┐
             ▼                         ▼
         Generation                Tool Call
             │                         │
             ▼                         ▼
         Feedback                 External DB
         Practice                     │
             │                         ▼
             │                    Tool Result
             └────────────┬────────────┘
                          ▼
                     Final Response
이제 처음의:
User → LLM → Answer가 얼마나 많은 과정을 압축하고 있었는지 보인다.
7.33 이 시리즈에서 결국 배우고 싶었던 것
LLM을 공부하다 보면 새로운 용어가 계속 등장한다.
Token
Embedding
Transformer
Attention
RAG
Vector DB
Tool Calling
Agent
Context Engineering
각각을 따로 보면 끝없이 새로운 기술처럼 느껴진다.
하지만 구조를 따라가면 질문은 몇 개로 줄어든다.
언어를 어떻게 계산 가능한 형태로 바꾸는가?

표현 사이에서 어떻게 Context를 계산하는가?

Context를 이용해 어떻게 다음 Token을 생성하는가?

모델이 모르는 Knowledge는 어디서 가져오는가?

사용자별 Context는 어떻게 반영하는가?

실제 Action은 어떻게 실행하는가?

각 단계가 제대로 작동하는지는 어떻게 확인하는가?
결국 모두 하나의 흐름으로 연결된다.
Language
   ↓
Number
   ↓
Context
   ↓
Generation
   ↓
Knowledge
   ↓
Action
   ↓
System
7.34 LLM.zip — 압축 해제 완료
처음에는:
LLM이라는 하나의 압축된 단어에서 시작했다.
그리고 하나씩 압축을 풀었다.
LLM.zip

├─ 0. LLM Overview
│
├─ 1. Vector & NumPy
│
├─ 2. Tokenization & Embedding
│
├─ 3. Attention & Transformer
│
├─ 4. Training & Inference
│
├─ 5. RAG & Vector Search
│
├─ 6. Tool Calling & Agent
│
└─ 7. LLM System
이제:
User
 ↓
LLM
 ↓
Answer
를 보면 그 사이에 무엇이 숨어 있는지 설명할 수 있다.
그리고 더 나아가:
"이 모델의 성능이 좋은가?"만 묻는 것이 아니라,
어떤 Input이 들어가는가?

어떤 Representation으로 바뀌는가?

어떤 Context가 필요한가?

어떤 Knowledge를 Retrieval해야 하는가?

어떤 부분을 LLM에게 맡길 것인가?

어떤 부분은 Tool로 실행해야 하는가?

어떤 State를 유지해야 하는가?

어디에서 오류가 발생할 수 있는가?

어떻게 평가하고 추적할 것인가?
를 물을 수 있다.
특정 Framework와 Model은 계속 바뀐다.
하지만 이 구조를 이해하면 새로운 기술이 등장해도 전체 Pipeline에서 그 기술이 어떤 문제를 해결하는지 찾을 수 있다.
그래서 마지막 흐름은 다시 처음으로 돌아온다.
Language
   ↓
Number
   ↓
Context
   ↓
Generation
   ↓
Knowledge
   ↓
Action
   ↓
System
LLM.zip | 압축 해제 완료.