World Model의 latent space에서 미래 trajectory를 상상하고, 그 미래의 value gradient를 dynamics를 통해 Actor까지 직접 역전파하여 policy를 학습하는 Model-based RL 방법
Contribution
Dreamer의 핵심 contribution은 크게 두 가지다.
- Latent Imagination: 실제 환경이나 pixel space가 아니라, 학습된 world model의 compact latent space에서 미래 trajectory를 rollout한다.
- Long-horizon Behavior Learning: imagination horizon 안의 reward만 사용하는 대신 Value Model로 horizon 이후의 return을 추정하고, 이 value의 analytic gradient를 latent dynamics를 거슬러 Actor까지 backpropagation한다.
즉 Dreamer는 단순히
“World Model로 미래를 예측한다”
에서 끝나는 것이 아니라,
“예측된 미래를 직접 미분해서 policy를 학습한다”
는 것이 핵심이다.
1. Background
1.1 Model-free RL의 문제
일반적인 Reinforcement Learning에서는 agent가 실제 environment와 반복해서 interaction하며 policy를 학습한다.
State
  ↓
Action
  ↓
Environment
  ↓
Next State + Reward
문제는 image input을 사용하는 control task에서는 실제 environment interaction이 매우 많이 필요하다는 것이다.
예를 들어 로봇이라면 실제로 수많은 행동을 수행해야 하고, simulation에서도 수백만 frame을 경험해야 할 수 있다.
이 때문에 다음과 같은 아이디어가 등장한다.
환경 자체를 학습해서, 실제 환경에 가지 않고도 미래를 예측하면 어떨까?
이것이 World Model이다.
1.2 World Model
World Model은 현재 state와 action으로부터 미래를 예측하는 모델이다.
가장 단순하게 쓰면,
라고 볼 수 있다.
즉 현재 state s_t에서 action a_t를 수행했을 때,
다음 state가 어떻게 될지
를 모델이 학습한다.
하지만 Dreamer의 input은 단순한 state vector가 아니라 image observation이다.
예를 들어 하나의 observation이
크기의 RGB image라면, 이를 그대로 여러 step 예측하는 것은 계산량과 메모리 사용량이 크다.
그래서 Dreamer는 image를 작은 latent state로 압축한 뒤, 그 공간에서 dynamics를 학습한다.
Image Observation
       ↓
     Encoder
       ↓
  Latent State
       ↓
Latent Dynamics
       ↓
Future Latent State
이를 Latent Dynamics Model이라고 한다.
1.3 MDP와 POMDP
Dreamer가 다루는 실제 visual control 환경은 POMDP이다.
POMDP에서는 실제 environment state가 존재하지만 agent는 그것을 직접 보지 못하고 observation만 얻는다.
True Environment State
          ↓
   Image Observation
          ↓
        Agent
예를 들어 공이 화면 가운데 있는 image 한 장만 본다면, 공이 왼쪽으로 움직이는지 오른쪽으로 움직이는지 알기 어렵다.
따라서 Dreamer는 현재 observation뿐 아니라 과거 state와 action까지 이용해 latent state를 만든다.
반면 latent dynamics 내부에서는 s_t가 history를 요약한 Markov state가 되도록 학습한다.
따라서 imagination 내부에서는 다음과 같이 MDP로 다룰 수 있다.
즉 실제 환경은 POMDP, 학습된 latent space 내부는 MDP처럼 사용한다고 이해하면 된다.
2. Dreamer Overview
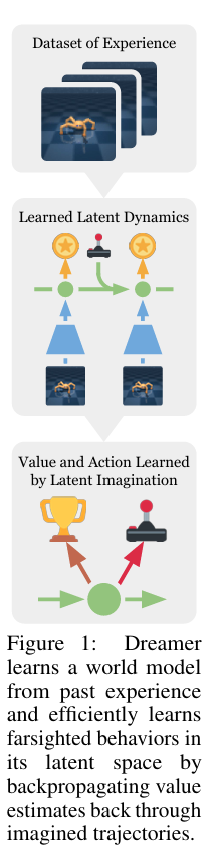
Figure 1은 Dreamer를 세 단계로 설명한다.
1. 실제 환경에서 Experience 수집
            ↓
2. Latent World Model 학습
            ↓
3. Latent Space에서 미래를 상상하며
   Actor와 Value 학습
기존 World Model 기반 방법에서도 미래를 예측했지만, Dreamer는 imagined trajectory의 value gradient를 직접 Actor까지 전달한다.
3. Latent World Model
Dreamer의 latent dynamics는 크게 세 모델로 구성된다.
3.1 Representation Model
입력은
- 이전 latent state
s_{t-1} - 이전 action
a_{t-1} - 현재 실제 observation
o_t
이고, 이를 이용해 현재 latent state s_t를 추론한다.
쉽게 말하면,
“실제 image를 보니 현재 environment state는 아마 이런 상태일 것이다.”
라고 판단하는 모델이다.
3.2 Transition Model
Representation Model과 달리 현재 observation o_t가 없다.
즉,
이전 latent state와 action만으로 다음 latent state를 예측한다.
Previous Latent State
        +
      Action
        ↓
 Transition Model
        ↓
Predicted Next State
Dreamer가 미래를 imagination할 때 사용하는 것이 바로 이 Transition Model이다.
미래의 실제 image를 볼 수 없기 때문이다.
3.3 Reward Model
현재 latent state에서 얻을 reward를 예측한다.
Latent State
     ↓
Reward Model
     ↓
Predicted Reward
따라서 Dreamer는 실제 environment에 가지 않고도
를 반복해서 미래 trajectory를 생성할 수 있다.
4. Latent Imagination
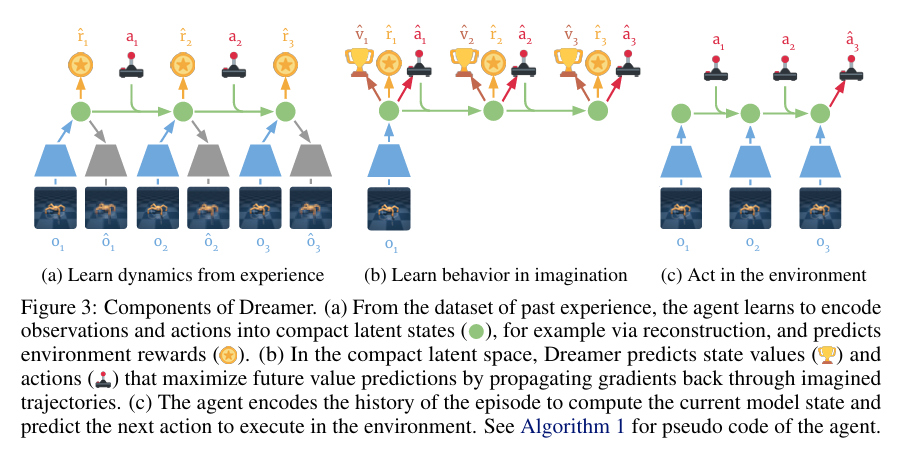
Dreamer의 학습은 크게 다음과 같이 반복된다.
Past Experience
      ↓
World Model 학습
      ↓
Latent State에서 미래 trajectory imagination
      ↓
Actor / Value 학습
      ↓
학습된 Actor로 실제 환경에서 행동
      ↓
새로운 Experience 추가
특히 중요한 점은 imagination 과정에서 미래 image를 생성하지 않는다는 것이다.
Pixel → Pixel → Pixel이 아니라,
Latent → Latent → Latent만 예측한다.
따라서 많은 trajectory를 병렬로 rollout하기 쉽고 memory footprint도 작다.
5. Actor와 Value Model
Dreamer는 imagination 내부에서 Actor와 Value Model을 학습한다.
5.1 Actor
Actor는 현재 latent state에서 action을 선택한다.
여기서 φ는 Actor의 parameter이다.
5.2 Value Model
Value Model은 현재 state에서 앞으로 받을 reward의 기대값을 예측한다.
여기서
ψ: Value Model parameterγ: discount factorH: imagination horizon
이다.
즉,
현재 state에서 시작했을 때 미래에 얼마나 많은 reward를 받을 수 있는가
를 학습한다.
6. 왜 Value Model이 필요한가?
Dreamer가 미래를 무한히 imagination할 수는 없다. 따라서 실제로는 일정한 길이의 imagination horizon (H) 까지만 latent trajectory를 rollout한다.
만약 horizon 안의 reward만 사용한다면,
까지만 고려하게 된다.
그러면 H 이후에 발생하는 reward는 전혀 반영되지 않기 때문에 shortsighted behavior가 생길 수 있다.
예를 들어,
Action A
→ 당장은 reward가 큼
→ 30 step 뒤 실패

Action B
→ 당장은 reward가 작음
→ 30 step 뒤 큰 reward
라고 하자.
imagination horizon이 15라면, horizon 안에서만 보면 Action A가 더 좋아 보일 수 있다.
Bellman Equation과 Bootstrapping
여기서 Dreamer는 RL의 Bellman equation을 이용한다.
State value는 원래
로 표현할 수 있다.
즉 현재 state의 value는
지금 받을 reward + 다음 state부터 받을 미래 reward의 가치
로 나눌 수 있다.
이 아이디어를 여러 step으로 확장하면,
처럼 쓸 수 있다.
앞의 reward들은 world model이 실제로 imagination한 값이고,
는 horizon 이후의 미래 reward를 Value Model이 대신 추정한 값이다.
이처럼 trajectory 끝에서 value estimate를 붙여 미래를 보완하는 방식을 bootstrapping이라고 한다.
왜 이것이 중요한가?
Dreamer는 horizon을 무작정 길게 늘리는 대신,
짧은 rollout + Value Model
을 사용해서 long-horizon return을 추정한다.
즉,
직접 imagination
t → t+1 → ... → t+H
                  ↓
             Value Model
                  ↓
          H 이후 미래까지 추정
하는 구조다.
이 덕분에 imagination horizon이 짧아도 먼 미래의 reward를 고려할 수 있다.
7. k-step Return
Dreamer는 다음 형태의 k-step return을 사용한다.
여기서
이다.
이 식은 생각보다 단순하다.
앞의 k step까지는 world model이 실제로 상상한 reward를 사용하고, 그 이후의 먼 미래는 Value Model에게 맡긴다.
예를 들어 3-step return이면,
이다.
현재
 ↓
Reward
 ↓
Reward
 ↓
Reward
 ↓
여기 이후의 미래는 Value Model이 예측
하는 구조이다.
8. λ-return
여기서 한 가지 문제가 생긴다.
몇 step까지 직접 imagination한 reward를 사용할 것인가?
예를 들어 k=1이라면 한 step 뒤까지만 직접 보고,
처럼 그 이후의 미래는 바로 Value Model에 맡긴다.
반대로 k를 크게 잡으면 더 많은 step을 직접 rollout해서 reward를 확인할 수 있지만, world model의 prediction error가 여러 step 동안 누적될 수 있다.
즉,
k가 작으면 Value Model에 많이 의존k가 크면 World Model의 긴 rollout에 많이 의존
하게 된다.
Dreamer는 둘 중 하나를 고르지 않고, 서로 다른 길이의 return을 함께 사용한다.
예를 들어,
처럼 1-step, 2-step, 3-step, ... return을 모두 계산한 뒤 이를 가중해서 합친 값이 λ-return이다.
여기서 λ는 짧은 return과 긴 return 중 어느 쪽을 더 많이 반영할지 조절하는 값이다.
λ가 작으면 짧은 return의 비중이 커지고λ가 크면 긴 rollout에서 얻은 reward를 더 많이 반영한다.
즉 λ-return은
Value Model을 너무 믿지도 않고, 긴 World Model rollout을 너무 믿지도 않도록 여러 길이의 return을 적절히 섞는 방법
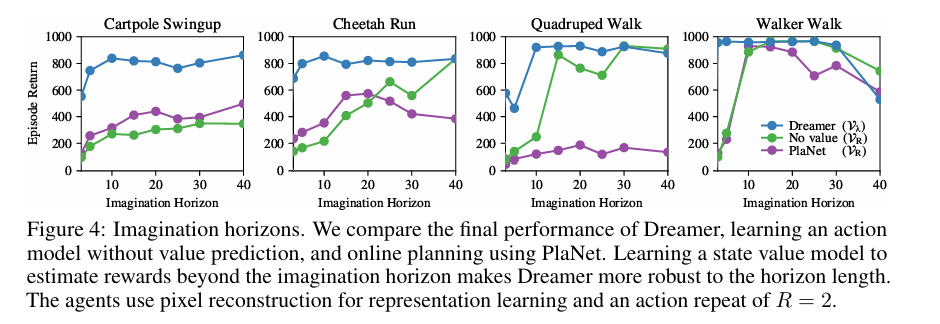
Figure 4는 Value Model이 왜 필요한지 바로 보여준다.
Dreamer는 imagination horizon이 달라져도 비교적 안정적인 반면, No Value 방식은 horizon 변화에 민감하다.
즉 Figure 4의 메시지는:
Value Model이 imagination horizon 이후의 reward까지 추정하기 때문에 Dreamer는 짧은 imagination horizon에서도 long-horizon behavior를 학습할 수 있다.
이다.
9. Reparameterization Trick
Dreamer는 stochastic policy를 사용한다.
Actor가 Gaussian의 평균과 표준편차를 출력하고 action을 sampling한다.
하지만 단순히
처럼 sample하면 sampling operation을 통해 gradient를 전달하기 어렵다.
그래서 Dreamer는 다음처럼 바꾼다.
이를 Reparameterization Trick이라고 한다.
랜덤성은 ε로 분리하고,
형태로 만들면 action이 neural network output의 differentiable function이 된다.
따라서 gradient를
Value
  ↑
State
  ↑
Action
  ↑
Actor
까지 전달할 수 있다.
tanh는 action을 보통 [-1,1] 범위로 제한하기 위해 사용한다.
10. Dreamer의 핵심: Backpropagation through Dynamics
이 논문에서 가장 중요한 부분이다.
Actor가 action을 생성하면,
와 같이 imagined trajectory가 만들어진다.
그리고 최종적으로 계산된 V_λ의 gradient를 반대로 전달한다.
즉 미래 state의 value가 좋았다면,
“그 미래를 만들기 위해 현재 action을 어느 방향으로 수정해야 하는가?”
를 gradient로 직접 계산한다.
이것이 Dreamer가 단순한 online planning이나 derivative-free optimization과 다른 핵심이다.
11. Actor Objective
Actor의 목표는 미래의 long-term value가 커지는 action을 선택하도록 학습되는 것이다.
Actor가 어떤 action을 선택하느냐에 따라 이후의 imagined trajectory가 달라진다.
Actor
  ↓
Action 선택
  ↓
다음 Latent State가 달라짐
  ↓
예측되는 Reward / Value가 달라짐
  ↓
최종 V_λ가 달라짐
즉 V_λ는 Actor가 선택한 action의 영향을 받는다.
따라서 Dreamer는
“V_λ를 더 크게 만들려면 Actor의 action을 어느 방향으로 바꿔야 하는가?”
를 gradient로 계산할 수 있다.
이 gradient는 다음과 같이 역방향으로 전달된다.
V_λ
 ↑
Reward / Value
 ↑
Future Latent State
 ↑
Action
 ↑
Actor Parameter φ
결국 Actor는 더 높은 장기 return을 만드는 action을 선택하도록 업데이트된다.
수식으로는 다음 objective를 최대화한다.
즉 한마디로,
Dreamer의 Actor는 상상한 미래의
V_λ가 커지는 방향으로 action을 수정하면서 학습된다.
12. Value Objective
Value Model의 역할은 현재 latent state가 장기적으로 얼마나 좋은 상태인지 예측하는 것이다.
Dreamer에서는 이때 target으로 λ-return인
를 사용한다.
Value Model의 prediction은
이고, 두 값의 차이가 작아지도록 학습한다.
즉 예를 들어,
Value Model prediction = 7
V_λ target            = 10
이라면 Value Model이 다음에는 10에 더 가까운 값을 예측하도록 parameter ψ를 업데이트한다.
여기서 V_λ는 단순한 하나의 reward가 아니라,
- imagined trajectory에서 얻은 여러 step의 reward
- horizon 이후를 보완하는 Value prediction
을 함께 반영해서 만든 long-term value estimate이다.
따라서 Value Model은 결국
“이 state에서 시작하면 앞으로 어느 정도의 long-term return을 얻을 수 있는가?”
를 V_λ에 맞춰 학습한다고 볼 수 있다.
Stop-gradient는 왜 사용할까?
이 학습에서는 V_λ를 target으로 고정한다.
즉 loss를 줄일 때
v_ψ(s_τ)  → 수정 O

V_λ(s_τ) → 수정 X
가 되도록 V_λ 쪽으로는 gradient를 전달하지 않는다.
만약 target인 V_λ까지 같이 움직여버리면, Value Model이 target을 따라가는 regression 문제 자체가 불안정해질 수 있기 때문이다.
정리하면:
Actor
→ V_λ가 커지는 action을 배우고

Value Model
→ 현재 state의 V_λ를 잘 예측하도록 배운다
즉 Actor는 value를 높이는 역할, Value Model은 그 value를 예측하는 역할을 한다.
13. World Model의 Latent Representation은 어떻게 학습할까?
Dreamer의 behavior learning은 특정한 representation learning 방식 하나에 묶여 있지 않다. 중요한 것은 control에 필요한 정보를 잘 담은 latent state (s_t) 를 만드는 것이다.
논문에서는 이를 위해 세 가지 학습 방법을 비교한다.
13.1 Reward Prediction
가장 단순한 방법은 latent state만 보고 reward를 잘 예측하도록 학습하는 것이다.
즉 latent state가
“이 state에서 reward가 얼마나 나올지 판단하는 데 필요한 정보”
를 담도록 만드는 방식이다.
하지만 reward가 드문 sparse reward 환경에서는 문제가 생길 수 있다.
0, 0, 0, 0, 0, 1, 0, 0, ...처럼 대부분의 step에서 reward가 비슷하다면, latent representation을 풍부하게 학습할 신호가 부족하기 때문이다.
13.2 Pixel Reconstruction
두 번째 방법은 latent state로부터 원래 image를 다시 복원하도록 학습하는 것이다.
Image o_t
   ↓
Latent State s_t
   ↓
Reconstructed Image
즉 latent state가 원래 observation의 정보를 충분히 담고 있어야 image를 다시 만들 수 있다.
이때 학습 objective는 크게 세 부분으로 구성된다.
Observation Reconstruction
latent state (s_t)로부터 실제 observation (o_t)를 잘 복원하도록 학습한다.
Reward Prediction
latent state로 실제 reward도 잘 예측하도록 학습한다.
Dynamics Regularization
이 항은 두 latent state distribution이 너무 달라지지 않도록 만든다.
- 첫 번째는 실제 observation (o_t)까지 보고 추론한 state
- 두 번째는 observation 없이 이전 state와 action만으로 예측한 state
이다.
Dreamer가 실제 imagination을 할 때는 미래 image를 볼 수 없기 때문에 Transition Model의 예측만 사용한다.
따라서
“실제 image를 보고 얻은 latent state”와 “transition으로만 예측한 latent state”가 비슷하도록 학습하는 것
이 중요하다.
13.3 Contrastive Estimation
Pixel reconstruction은 image의 모든 pixel을 다시 생성해야 하기 때문에 model capacity를 많이 사용할 수 있다.
그래서 세 번째 방법은 image 자체를 복원하는 대신,
현재 image와 올바른 latent state가 잘 대응하도록 학습하는 것
이다.
논문에서는 다음과 같은 State Model을 사용한다.
직관적으로는
Correct Image ↔ Correct Latent State
        잘 대응되게

Other Image ↔ Latent State
        서로 구별되게
학습한다.
즉 pixel을 직접 생성하지 않고도 image와 latent representation 사이의 관계를 학습하는 방식이다.
세 방법의 차이
| 방법 | latent state가 잘해야 하는 것 |
|---|---|
| Reward Prediction | reward를 잘 예측 |
| Pixel Reconstruction | 원래 image를 잘 설명하고 복원 |
| Contrastive Estimation | 올바른 image와 latent를 잘 대응 |
논문 실험에서는 Pixel Reconstruction이 대부분의 task에서 가장 안정적인 성능을 보였고, Reward Prediction만 사용하는 것은 충분하지 않았다.
14. Experiments
Dreamer는 DeepMind Control Suite의 20개 visual control task에서 평가되었다.
Observation은
RGB image이며, action dimension은 task에 따라 1~12차원이다.
Dreamer는 5 × 10^6 environment steps 이후 평균 score 823을 기록했다.
반면 강한 model-free baseline인 D4PG는 10^8 environment steps에서 평균 786을 기록했다.
즉 논문에서는 Dreamer가
- Data Efficiency
- Computation Time
- Final Performance
측면에서 강한 성능을 보였다고 보고한다.
15. PlaNet과 Dreamer의 차이
Dreamer를 이해할 때 가장 좋은 비교 대상이 PlaNet이다.
두 방법은 비슷한 latent world model을 사용하지만 behavior를 얻는 방식이 다르다.
PlaNet
매 순간 여러 action sequence를 world model에서 rollout한다.
Action Sequence A → Future Reward
Action Sequence B → Future Reward
Action Sequence C → Future Reward
그리고 가장 좋은 sequence를 선택한다.
즉 Online Planning이다.
Dreamer
World Model의 imagination을 이용해서 Actor 자체를 미리 학습한다.
Latent Imagination
       ↓
Actor Learning
       ↓
state → Actor → action
그리고 단순히 imagined reward만 보는 것이 아니라 Value Model을 이용해 long-horizon return을 고려한다.
가장 중요한 차이는:
Dreamer는 imagined trajectory의 value gradient를 latent dynamics를 통해 Actor까지 직접 backpropagation한다.
는 것이다.
16. Dreamer 전체 흐름 다시 보기
최종적으로 Dreamer는 다음 cycle을 반복한다.
[Real Environment]

Image Observation
      ↓
Representation Model
      ↓
Latent State

──────────────────────

[Latent Imagination]

Latent State
      ↓
    Actor
      ↓
    Action
      ↓
Transition Model
      ↓
Future Latent State
      ↓
Reward / Value Prediction
      ↓
    V_λ

──────────────────────

[Learning]

V_λ
 ↑ gradient
Future State
 ↑
Transition
 ↑
Action
 ↑
Actor
그리고 학습된 Actor로 실제 environment에서 행동하여 새로운 experience를 수집한다.
Conclusion
Dreamer의 핵심은 단순히 World Model에서 미래를 상상한다는 것이 아니다.
기존 Model-based RL에서도 model을 이용한 rollout과 planning은 존재했다.
Dreamer의 핵심은
compact latent space에서 미래를 imagination하고, Value Model을 이용해 imagination horizon 너머의 long-term return을 추정하며, 그 value의 analytic gradient를 learned dynamics를 통해 Actor까지 직접 전달한다
는 점에 있다.
이를 한 줄로 정리하면,
이다.