LLaVA: Visual Instruction Tuning
Visual Instruction Tuning
Haotian Liu, Chunyuan Li, Qingyang Wu, Yong Jae Lee
NeurIPS 2023
Paper
LLaVA는 Instruction Tuning을 Vision-Language 영역으로 확장한 초기 Multimodal LLM이다.
구조만 보면 상당히 단순하다.
CLIP Vision Encoder
        ↓
Linear Projection
        ↓
      Vicuna
하지만 LLaVA의 핵심은 새로운 복잡한 architecture보다, GPT-4를 이용해 Visual Instruction Data를 만들고 이를 이용해 multimodal model을 instruction-following assistant로 학습했다는 점에 있다.
1. Background
1.1 기존 Vision-Language Model에서는 무엇이 부족했을까?
LLaVA 이전에도 vision model은 Classification, Detection, Segmentation, Captioning 등 다양한 task를 수행할 수 있었다.
다만 논문이 비교 대상으로 삼는 기존 연구에서는 각 task가 독립적으로 다뤄졌고, 수행해야 할 task가 model design에 암묵적으로 포함되어 있었다.
예를 들어 Captioning Model이라면
Image → Caption을 생성하도록 처음부터 설계된다.
즉 사용자가 "Describe this image"라는 instruction을 입력해서 captioning task를 선택한 것이 아니라, 모델 자체가 이미 Captioning이라는 task를 수행하도록 정해져 있는 것이다.
이 때문에 모델이 제공하는 interface 역시 비교적 고정되어 있다.
반면 LLM은 language 자체를 task를 지정하는 interface로 사용할 수 있다.
같은 모델이라도 사용자가
"요약해줘."
"비교해줘."
"이유를 설명해줘."
처럼 서로 다른 instruction을 주면, 해당 instruction에 맞춰 수행할 task를 바꿀 수 있다.
LLM처럼 하나의 multimodal model도 자연어 instruction에 따라 서로 다른 visual task를 수행하게 만들 수 없을까?
1.2 Instruction Tuning
LLM의 기본 pre-training은 이전 token들을 바탕으로 다음 token을 예측한다.
하지만 next-token prediction을 잘한다고 해서 사용자의 instruction을 잘 따른다는 의미는 아니다.
따라서 다음과 같은 Instruction-Response Pair를 이용해 추가로 fine-tuning할 수 있다.
Instruction:
Summarize the following paragraph.

Response:
...
중요한 점은 새로운 loss function을 사용하는 것이 아니라는 것이다. 여전히 autoregressive next-token prediction을 사용하지만, 데이터를 Instruction → Response 형태로 구성함으로써 모델이 자연어 instruction을 task specification으로 해석하는 방법을 배우게 된다.
LLaVA는 이 아이디어를 Text-only LLM에서 Image-Language Multimodal Space로 확장한다.
2. Visual Instruction Tuning
LLaVA 이전에도 Flamingo, BLIP-2, KOSMOS-1과 같은 Large Multimodal Model은 존재했다.
하지만 논문에서 지적하는 차이는 이 모델들이 주로 Image-Text Pair로 학습되었으며, Vision-Language Instruction Data로 명시적으로 tuning되지는 않았다는 점이다.
LLaVA가 제안하는 Visual Instruction Tuning은 다음과 같다.
Image + Language Instruction
            ↓
     Multimodal Model
            ↓
         Response
예를 들어 같은 이미지라도
Describe this image.What is unusual about this image?
는 서로 다른 task다.
첫 번째는 이미지의 내용을 설명해야 하고, 두 번째는 이미지 안에서 일반적이지 않은 요소를 찾은 뒤 그 이유까지 설명해야 한다.
즉 Visual Instruction Tuning의 목적은 단순히 Image → Text 변환을 잘하는 것이 아니라,
이미지를 이해한 뒤, 사용자가 자연어로 요구한 task에 맞는 response를 생성하도록 학습하는 것
3. GPT-assisted Visual Instruction Data Generation
문제는 Visual Instruction Tuning을 하려면
Image + Instruction + Response형태의 데이터가 필요한데, 당시에는 이런 multimodal instruction-following data가 충분하지 않았다는 것이다.
반면 Image + Caption 형태의 데이터는 이미 대규모로 존재했다.
그래서 LLaVA는 기존 Image-Text Pair를 GPT-4를 이용해 Instruction-following Data로 재구성한다.
3.1 단순히 Caption에 질문을 붙이면 안 될까?
가장 단순한 방법은 기존 caption을 answer로 사용하고, 앞에 질문 하나를 붙이는 것이다.
Human:
Describe this image briefly.

Assistant:
[Original Caption]
실제로 LLaVA는 이후 Stage 1에서는 이러한 단순한 형태를 사용한다.
하지만 이것만으로 Instruction Tuning Data를 구성하면 대부분의 instruction이 이미지 설명에 집중되고, response 역시 짧은 caption 수준에 머문다.
즉 Conversation, Detailed Description, Reasoning과 같은 다양한 instruction-following 능력을 학습시키기 어렵다.
그래서 Stage 2를 위한 데이터 생성에는 GPT-4를 사용한다.
3.2 Text-only GPT-4에게 이미지를 어떻게 전달했을까?
여기서 중요한 점은 당시 사용한 GPT-4가 이미지를 직접 입력받지 못하는 language-only model이었다는 것이다.
따라서 실제 이미지를 주는 대신 두 가지 정보를 제공한다.
Captions
하나의 이미지를 서로 다른 관점에서 설명하는 여러 caption을 제공한다.
Bounding Boxes
이미지에 어떤 object가 있고, 각 object가 어느 위치에 있는지를 제공한다.
즉 전체 과정은 다음과 같다.
Image
  ↓
Captions + Bounding Boxes
  ↓
Text-only GPT-4
  ↓
Visual Instruction Data
Caption은 scene의 semantic information을 제공하고, Bounding Box는 object와 spatial location에 대한 정보를 보완한다.
논문에서는 이를 이미지를 GPT가 처리할 수 있는 형태로 바꾸는 Symbolic Representation이라고 설명한다.
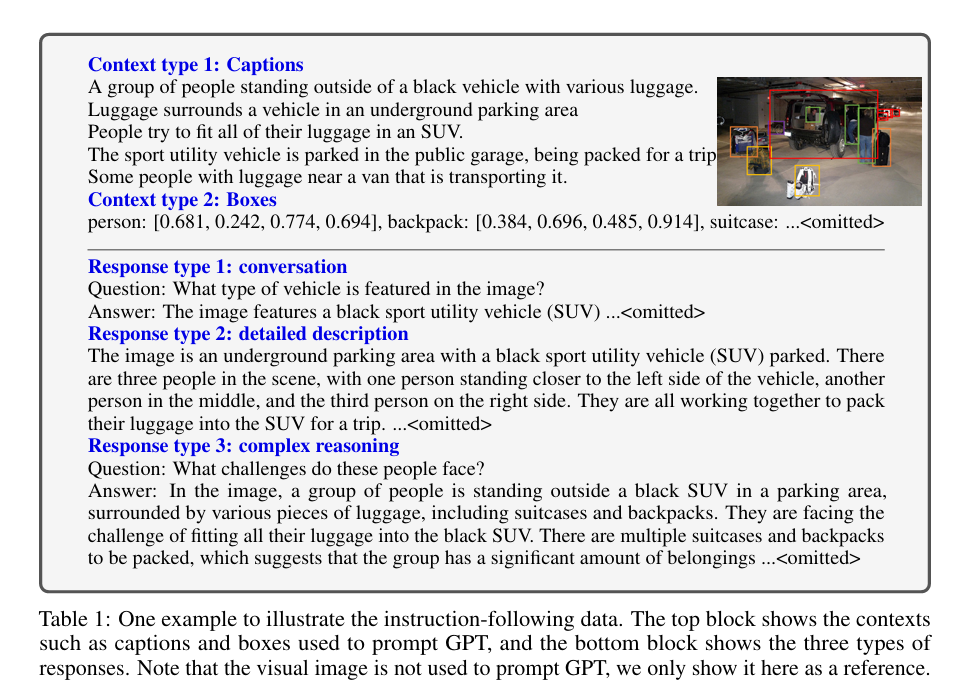
위 Table에서 중요한 것은 GPT-4가 실제 이미지를 본 것이 아니라는 점이다.
위쪽의 Captions + Boxes가 GPT-4의 context이고, 이를 바탕으로 아래의 세 종류의 instruction-following data를 생성한다.
3.3 세 종류의 Instruction Data
Conversation
이미지에 대해 여러 질문을 주고받는 형태이다.
Object Type, Counting, Action, Location, Relative Position 등 다양한 visual information을 질문한다.
특히 GPT-4에게 이미지 정보만으로 definite answer를 낼 수 있는 질문만 생성하도록 제한한다.
Detailed Description
짧은 caption보다 더 풍부한 visual information을 포함하도록 한다.
단순히 어떤 object가 존재하는지만 말하는 것이 아니라, scene의 구성과 object의 위치 및 행동 등을 자세하게 설명한다.
Complex Reasoning
이미지에 직접 보이는 내용을 넘어, 해당 visual evidence를 기반으로 추론하는 질문을 만든다.
예를 들어 많은 짐을 SUV에 싣고 있는 장면에서
What challenges do these people face?
와 같은 질문을 생성하고, 제한된 공간에 짐을 배치해야 한다는 reasoning을 포함한 response를 만든다.
최종적으로 생성된 데이터는 총 158K이다.
| Type | Samples |
|---|---|
| Conversation | 58K |
| Detailed Description | 23K |
| Complex Reasoning | 77K |
| Total | 158K |
또한 사람이 각 유형별로 몇 개의 seed example을 직접 작성하고, 이를 Few-shot In-Context Learning Example로 GPT-4에게 제공한다.
즉 GPT-4가 임의로 데이터를 만든 것이 아니라, question type과 answerable condition 등을 prompt로 꽤 구체적으로 제한했다.
4. LLaVA Architecture
LLaVA의 architecture는 의외로 단순하다.
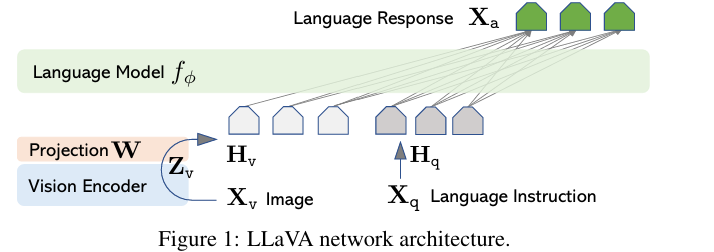
크게 세 부분으로 구성된다.
- CLIP ViT-L/14: Image → Visual Feature
- Linear Projection: Visual Feature → LLM이 사용할 Visual Token
- Vicuna: Visual Token + Language Instruction → Response
4.1 Vision Encoder
입력 이미지를 라고 하면 pretrained CLIP Vision Encoder 를 통해 visual feature 를 얻는다.
CLIP은 ViT 기반이므로 이미지를 여러 patch로 나누어 처리한다.
따라서 는 이미지 전체를 나타내는 단일 vector가 아니라 여러 grid feature로 이루어진 Visual Feature Sequence라고 볼 수 있다.
4.2 Linear Projection
그런데 CLIP에서 나온 를 그대로 Vicuna에 넣을 수는 없다.
CLIP의 visual feature와 Vicuna의 word embedding은 서로 다른 representation space에서 만들어진 representation이기 때문이다.
LLaVA는 둘 사이를 연결하기 위해 trainable projection matrix 를 사용한다.
여기서
- : CLIP Visual Feature
- : Trainable Linear Projection
- : Language Model에 입력되는 Visual Token
이다.
Projection을 거친 는 Vicuna의 word embedding과 동일한 dimensionality를 갖는다.
다만 W의 역할을 단순히 dimension을 맞추는 것으로만 보면 부족하다.
이 projection은 학습 과정에서 CLIP이 만든 visual representation을 pretrained LLM이 response 생성에 활용할 수 있는 representation으로 변환하는 방법을 함께 학습한다.
결과적으로
형태의 Visual Token Sequence를 얻는다.
그리고 이 Visual Token들이 Language Instruction과 함께 Vicuna에 입력된다.
4.3 BLIP-2와 비교
BLIP-2를 먼저 읽었다면 구조 차이가 명확하다.
| BLIP-2 | LLaVA | |
|---|---|---|
| Vision Encoder | Frozen Vision Encoder | CLIP ViT-L/14 |
| Connector | Q-Former | Linear Projection |
| 주요 학습 방향 | Vision-Language Representation Bridging | Visual Instruction Following |
| LLM | Frozen | Stage 2에서 Fine-tuning |
BLIP-2는 Vision Encoder와 LLM 사이에 Q-Former를 두지만, LLaVA는 Linear Projection 하나만 사용한다.
저자들은 이 lightweight한 projection을 선택함으로써 data-centric experiment를 빠르게 반복할 수 있었다고 설명한다.
따라서 LLaVA의 핵심은 새로운 connector를 복잡하게 설계하는 것보다 Visual Instruction Data와 Training Strategy에 더 가깝다.
5. Training Objective
LLaVA는 별도의 새로운 multimodal loss를 제안하지 않는다.
기존 LLM처럼 Auto-regressive Language Modeling Objective를 그대로 사용한다.
여기서
- : Image
- : Language Instruction
- : Assistant Answer
- : 현재 예측할 Answer Token
이다.
즉 Image, Instruction, 이전까지의 Answer를 조건으로 다음 Answer Token을 예측한다.
또한 모든 input token에 loss를 계산하는 것이 아니라, Assistant가 생성해야 하는 Response Token에 대해서만 loss를 계산한다.
6. Two-Stage Training
6.1 Stage 1: Pre-training for Feature Alignment
첫 번째 단계에서는 CLIP과 Vicuna를 모두 frozen하고 Projection 만 학습한다.
Vision Encoder → Frozen
Projection     → Train
Vicuna         → Frozen
CC3M을 filtering한 595K Image-Text Pair를 사용한다.
기존 caption을 정답으로 두고, 이미지를 간단히 설명하도록 하는 instruction을 붙여 Single-turn Conversation 형태로 변환한다.
따라서 학습 가능한 parameter는
뿐이다.
이 단계의 목적은 reasoning이나 instruction-following을 학습하는 것이 아니다.
CLIP의 Visual Feature를 어떤 형태로 변환해야 pretrained Vicuna가 사용할 수 있는가?
를 먼저 학습한다.
논문에서는 이를 “frozen LLM과 호환되는 visual tokenizer를 학습하는 과정”으로 설명한다.
6.2 Stage 2: Fine-tuning End-to-End
Stage 2에서는 Vision Encoder는 계속 frozen한 상태로 유지하지만, Projection과 Vicuna를 함께 업데이트한다.
Vision Encoder → Frozen
Projection     → Train
Vicuna         → Train
따라서 trainable parameter는
가 된다.
여기서 앞서 생성한 LLaVA-Instruct-158K를 사용해 실제 Visual Instruction Following을 학습한다.
| Stage 1 | Stage 2 | |
|---|---|---|
| 목적 | Feature Alignment | Visual Instruction Following |
| Vision Encoder | Frozen | Frozen |
| Projection | Train | Train |
| LLM | Frozen | Train |
| Data | CC-595K | LLaVA-Instruct-158K |
| 학습 형태 | Image → Caption | Image + Instruction → Response |
즉 두 단계의 역할을 구분하면,
Stage 1은 Vision과 Language를 연결하고, Stage 2는 그 연결을 이용해 사용자의 Instruction을 따르는 법을 학습한다.
7. Experiments
7.1 Visual Instruction Tuning이 실제로 효과가 있을까?
논문에서는 What is unusual about this image?라는 질문을 이용해 LLaVA, BLIP-2, OpenFlamingo를 비교한다.
BLIP-2와 OpenFlamingo는 주로 이미지에 무엇이 보이는지 설명하는 답변을 생성한다.
반면 LLaVA는 차량 위에서 다림질하는 행동이 일반적이지 않고 위험할 수 있다는 식으로 질문에서 요구한 unusual aspect 자체를 설명한다.
여기서 논문이 보여주려는 차이는 단순한 Visual Recognition 성능이 아니다.
이미지의 내용을 인식하는 것과, 그 정보를 사용해서 사용자의 Instruction에 맞는 답을 생성하는 것은 다른 문제다.
LLaVA는 후자를 Visual Instruction Tuning으로 명시적으로 학습한다.
7.2 어떤 Instruction Data를 사용하는지도 중요하다
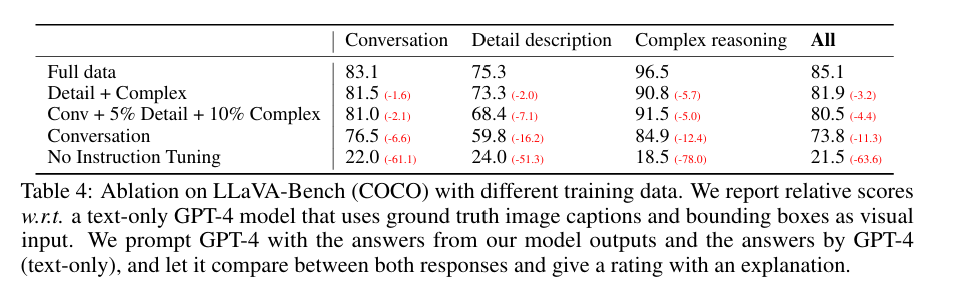
Table 4에서는 Training Data의 조합을 바꾸면서 성능을 비교한다.
가장 큰 차이는 Instruction Tuning 자체를 제거한 경우다.
Overall Relative Score가
- Full Data: 85.1
- No Instruction Tuning: 21.5
로 크게 감소한다.
또한 Conversation Data만 사용하면 73.8이지만, Detailed Description과 Complex Reasoning을 함께 사용하면 성능이 더 높아진다.
즉 Visual Instruction Tuning의 성능은 단순히 conversation sample 수를 늘리는 것보다 서로 다른 형태의 instruction을 함께 학습시키는 것에서 이점을 얻는다.
7.3 Feature Alignment Stage도 필요한가?
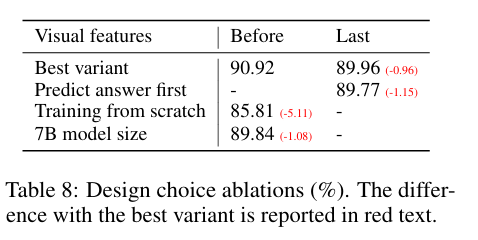
ScienceQA ablation에서 Stage 1 Pre-training을 생략하면
Best Variant          90.92
Training from Scratch 85.81
로 5.11%p 성능이 감소한다.
즉 Projection을 초기 상태로 둔 채 바로 downstream instruction tuning을 하는 것보다,
Feature Alignment
       ↓
Instruction Tuning
순서로 학습하는 것이 효과적이었다.
또한 CLIP의 마지막 Transformer Layer보다 마지막 layer 직전의 visual feature를 사용했을 때 성능이 조금 더 높았다.
Before Last Layer : 90.92
Last Layer        : 89.96
저자들은 마지막 layer가 global하고 abstract한 image property에 더 집중하는 반면, 그 이전 layer에는 특정 image detail을 이해하는 데 필요한 localized information이 더 남아 있을 가능성을 제시한다.
8. Limitation
LLaVA가 instruction을 잘 따른다고 해서 이미지의 모든 관계를 정확히 이해하는 것은 아니다.
논문에서는 냉장고 이미지에 Strawberry와 Yogurt가 각각 존재하지만 Strawberry-flavored Yogurt는 없는 상황을 예로 든다.
그런데
Is there strawberry-flavored yogurt in the fridge?
라는 질문에 LLaVA가 Yes라고 답한다.
즉 strawberry와 yogurt라는 visual concept은 각각 인식했지만, 두 object 사이의 관계를 잘못 결합한 것이다.
논문에서는 이를 모델이 이미지를 때때로 “bag of patches”처럼 인식한다고 표현한다.
따라서 patch-level object를 인식하는 능력과 별개로, object 간 관계나 compositional semantics를 정확하게 이해하는 능력에는 여전히 한계가 있다.
High-resolution detail, fine-grained visual understanding, hallucination 역시 남아 있는 문제다.
9. Conclusion
LLaVA의 Architecture 자체는 단순하다.
CLIP Vision Encoder
        ↓
Linear Projection
        ↓
      Vicuna
하지만 이 논문의 중요한 contribution은 Architecture의 복잡성보다는 다음 과정에 있다.
기존 Image-Text Pair
        ↓
GPT-4를 이용한 Visual Instruction Data 생성
        ↓
Feature Alignment
        ↓
Visual Instruction Tuning
즉 pretrained Vision Encoder와 LLM을 연결하는 것만으로 끝나는 것이 아니라, 모델에게 실제로 사용자의 visual instruction을 어떻게 따라야 하는지 학습시켰다는 점이 핵심이다.
| Component | LLaVA |
|---|---|
| Vision Encoder | CLIP ViT-L/14 |
| LLM | Vicuna |
| Connector | Linear Projection |
| Stage 1 | Feature Alignment |
| Stage 2 | Visual Instruction Tuning |
| Alignment Data | CC-595K |
| Instruction Data | LLaVA-Instruct-158K |
| Data Generation | GPT-4 + Captions + Bounding Boxes |
| Instruction Types | Conversation / Detailed Description / Complex Reasoning |
| Objective | Auto-regressive Next-token Prediction |
LLaVA는 CLIP의 visual representation을 Linear Projection을 통해 Vicuna에 연결하고, GPT-4로 생성한 Visual Instruction Data를 이용해 하나의 multimodal model이 다양한 자연어 visual instruction을 따르도록 학습한 모델이다.
이후의 Multimodal LLM에서는 이 기본적인 Vision Encoder → Projector → LLM 구조를 바탕으로 더 좋은 visual representation, connector, high-resolution processing, visual token efficiency 등을 개선하는 방향으로 연구가 이어진다.