BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models(2023)
Paper Notes
1. Problem: Frozen Model 사이의 Modality Gap
대규모 VLP 모델을 End-to-End로 학습하면 Image Encoder와 Language Model 양쪽을 업데이트해야 하므로 학습 비용이 커진다. BLIP-2는 이미 강력한 Pretrained Vision Encoder와 Pretrained LLM을 재사용하는 방향을 택한다. 하지만 두 모델을 단순히 연결한다고 이미지 정보가 언어 모델에 유용한 형태로 전달되지는 않는다.
- 표현의 차이: Vision Encoder 출력은 이미지 패치에서 학습한 Visual Representation이고, LLM 입력은 Language Embedding Space에 놓인다.
- 학습 목적의 차이: Vision Encoder가 추출한 정보가 반드시 문장 생성에 필요한 정보는 아니다.
- 연결의 제약: 두 대형 모델을 Freeze한 상태에서 중간 모듈이 시각 정보를 추출하고 언어 생성에 적합하도록 변환해야 한다.
BLIP-2는 이 역할을 Q-Former에 맡기고, 한 번에 학습시키지 않고 두 단계로 나누어 학습한다.
| 단계 | 학습 목표 | 핵심 질문 |
|---|---|---|
| Stage 1 | Vision–Language Representation Learning | 이미지에서 언어와 관련 있는 정보는 무엇인가? |
| Stage 2 | Vision-to-Language Generative Learning | 추출한 시각 정보를 Frozen LLM에 어떻게 전달할 것인가? |
Contribution은 Q-Former라는 연결 모듈 하나가 아니라, Frozen Model 재사용 + Two-stage Training의 조합이다. 여기서 Compute-efficient는 주로 Pre-training에서 거대한 Backbone의 업데이트를 피한다는 뜻이며, 추론 시 Vision Encoder 연산까지 없어진다는 의미는 아니다.
2. Q-Former: Query를 통해 이미지 정보를 추출하는 모듈
2.1 Learnable Query, Self-Attention, Cross-Attention
Q-Former는 32개의 Learnable Query Embedding을 사용한다. Query는 특정 이미지 패치에 고정 대응하는 좌표가 아니라, 학습을 통해 유용한 정보를 얻도록 조정되는 벡터다. Query는 Self-Attention으로 상호작용하고, Cross-Attention으로 Frozen Vision Encoder의 이미지 특징을 참조한다.
Self-Attention에서는 Query와 Key, Value가 같은 Query Hidden State에서 만들어진다. Query 입력을 라 하면:
Cross-Attention에서는 Query는 Q-Former 쪽에서, Key와 Value는 Vision Encoder 출력에서 나온다. 이미지 특징을 라 하면:
따라서 Query가 이미지의 어느 특징을 얼마나 참조할지 결정하고, 그 가중치로 Image Value의 정보를 통합한다.
Q-Former의 Transformer는 BERT-base에서 초기화하고, Vision Encoder에 연결하는 Cross-Attention Layer는 한 Block 건너 하나씩 배치해 새로 초기화한다.
2.2 Information Bottleneck
Vision Encoder가 다음과 같은 이미지 특징을 출력한다고 하자.
257: Visual Token의 개수1024: 각 Visual Token의 Feature Dimension
Q-Former를 거친 Query Output은 다음과 같이 표현할 수 있다.
여기서 토큰 수의 변화와 Feature Dimension의 변화를 구분해야 한다.
먼저 1024 → 768은 Projection이다. 각 토큰의 1024차원 특징을 Linear Projection을 통해 Attention 연산에 필요한 차원으로 변환한다. 기존 특징 중 일부를 단순히 삭제하는 것이 아니라, 학습된 Weight를 이용해 새로운 특징으로 변환한다.
반면 257 → 32는 Q-Former의 Query Bottleneck과 관련된다. 257개의 이미지 토큰 중 32개를 그대로 선택하는 것이 아니라, 32개의 Learnable Query가 Cross-Attention을 통해 이미지 특징 전체를 참조하여 각각 새로운 표현을 만든다.
내부 Attention 차원을 768로 두면,
이고,
이 된다.
32×257 Attention Map의 각 행은 하나의 Query가 257개의 이미지 특징을 얼마나 참고하는지를 나타낸다. 이를 Value와 결합하면,
의 Query Output을 얻는다.
따라서 Q-Former의 Bottleneck에서 중요한 것은 단순한 1024 → 768 차원 축소가 아니라, 많은 이미지 특징의 정보가 32개의 Query Representation을 통해 전달되도록 제한된다는 점이다.
2.3 Q-Former Architecture와 Mask
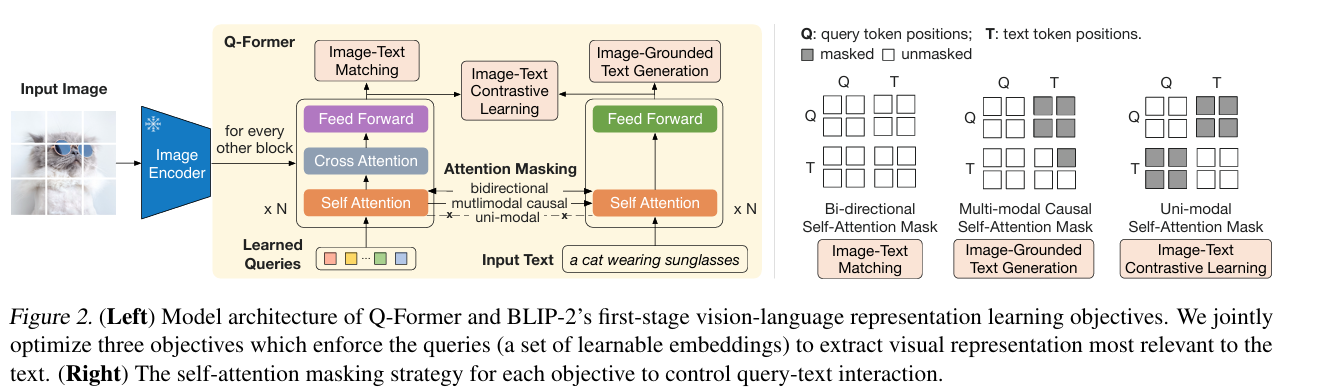
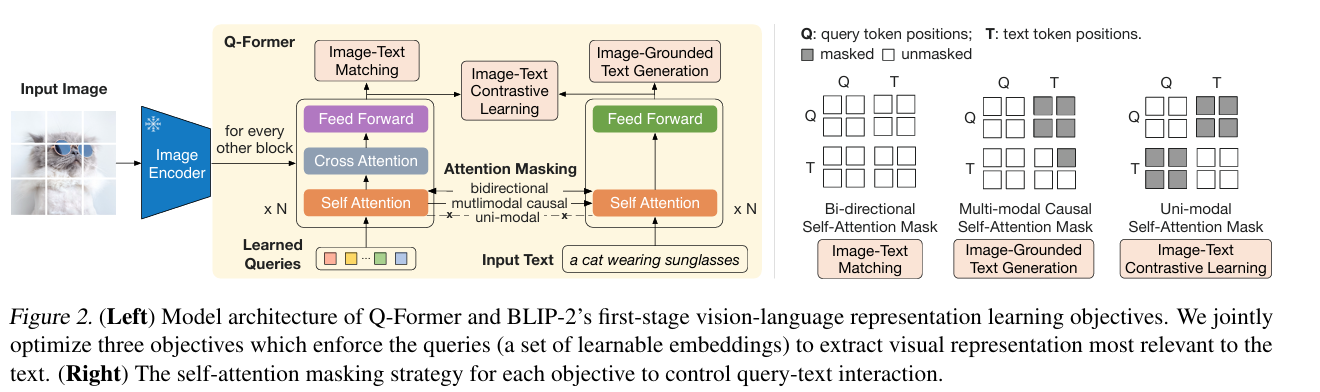
논문은 Q-Former를 이미지 쪽 Transformer와 텍스트 쪽 Transformer가 Self-Attention Parameter를 공유하는 구조로 설명한다. 이미지 Query는 Cross-Attention을 통해 Frozen Image Encoder 특징을 읽는다. Text Token의 정보 흐름은 학습 목적에 따라 Attention Mask로 제어한다.
중요한 점은 세 Objective가 서로 다른 Q-Former를 학습하는 것이 아니라, 공유하는 모델에서 Attention Mask와 Loss를 바꾸어 서로 보완적인 능력을 학습한다는 것이다.
3. Stage 1: 왜 ITC, ITG, ITM을 함께 사용하는가?
Stage 1의 목표는 Q-Former가 단순한 이미지 요약기가 아니라 언어와 의미적으로 연결되고 문장 생성에도 유용한 시각적 표현을 만들도록 학습하는 것이다.
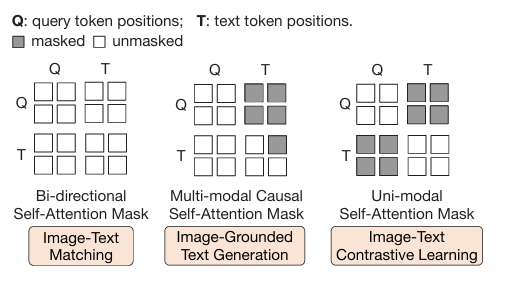
| Objective | 학습하는 관계 | Attention Mask의 핵심 |
|---|---|---|
| ITC | 이미지와 문장의 Representation 정렬 | Query와 Text를 분리 |
| ITG | 이미지 조건부 다음 Text Token 예측 | Text는 Query와 과거 Text를 참조 |
| ITM | 주어진 Image–Text Pair가 Matching인지 판별 | Query와 Text의 양방향 Interaction 허용 |
세 가지가 순서대로 실행되는 Pipeline이라기보다, Stage 1에서 결합되는 학습 목적이라는 점에 주의하자.
3.1 ITC — Image–Text Contrastive Learning
ITC는 Matching Pair의 유사도를 높이고 Non-matching Pair의 유사도를 낮추어 Image와 Text 표현을 정렬한다. 하나의 이미지에서 Query Representation 32개가 생성된다.
텍스트의 대표 표현을 라 할 때 이미지–텍스트 유사도는 Query별 유사도 중 최댓값을 사용한다.
이렇게 하면 모든 Query가 같은 Text Representation과 동일하게 대응해야 하는 것은 아니다. 32개 중 하나 이상의 Query가 해당 텍스트를 잘 설명하도록 유도한다.
실제 Contrastive Learning에서는 Matching Pair가 같은 Batch의 Non-matching Pair보다 높은 Similarity를 갖도록 Loss를 구성한다. 핵심은 아래의 를 이용해 정답 Pair에 높은 확률을 주는 것이다. (정확한 Loss는 Image-to-Text 및 Text-to-Image 방향과 모델 설정을 함께 고려한다.)
ITC의 Unimodal Self-Attention Mask에서는 Query↔Query, Text↔Text는 허용하지만 Query↔Text는 차단한다. 이미지 표현을 만들 때 정답 텍스트를 미리 참고하면 Contrastive Similarity가 두 Modality의 독립적인 표현 비교가 되지 않기 때문이다.
3.2 ITG — Image-Grounded Text Generation
ITG는 Q-Former가 가져온 이미지 정보에 근거해 텍스트를 생성하도록 학습한다. Image Encoder 출력은 Text Token에 직접 들어가지 않는다. 이미지 정보는 반드시 Query Representation을 거쳐 Text에 전달된다.
Multimodal Causal Attention Mask의 핵심은 다음과 같다.
- Query는 Query를 참조하지만 Text를 참조하지 않는다.
- Text는 Query 전체와 이전 Text Token을 참조한다.
- Text는 미래 Text Token을 참조하지 못한다.
예를 들어 a cat wearing sunglasses를 생성할 때 a cat 뒤에서는 이미지 Query와 이전 Text를 참고해 다음 Token을 예측한다. 핵심은 정답 문장의 각 Token을 학습하는 Next-token Cross-Entropy다. 단순화해 쓰면:
여기서 는 Image Feature를 참조한 Query Representation이다. 미래 Text를 보지 못하게 막으면서 를 참고하도록 하므로, ITG는 문장 생성에 필요한 시각 정보가 Query Bottleneck에 실제로 보존되도록 압박하는 학습 목적이다.
3.3 ITM — Image–Text Matching
ITM은 Image와 Text가 Matching Pair인지 판단하는 Binary Classification이다. ITC가 두 표현을 독립적으로 생성해 유사도를 비교한다면, ITM은 Query와 Text의 양방향 Self-Attention을 허용해 서로 직접 상호작용하게 한다.
Matching/Non-matching Label을 이용해 Query Output별 Matching Logit을 계산하고 이를 종합해 Pair의 Matching Score를 산출한다. 이 과정은 Global Similarity만으로 놓치기 쉬운 Image–Text의 세밀한 대응 관계를 학습하도록 유도한다.
예를 들어 Matching 확률을 라고 하고 정답 Label을 로 두면 이진 분류 Loss는 다음 형태다.
ITC와 달리 Pair를 먼저 결합해 직접 상호작용시킨 후 판별한다는 차이가 중요하다.
정리: ITC는 표현 정렬, ITG는 생성에 필요한 시각 정보 보존, ITM은 상호작용 기반의 세밀한 Pair 판별을 담당한다.
4. Stage 2: Query Representation을 Frozen LLM으로 전달하기
Stage 1에서 얻은 표현이 Image–Text 관련 정보를 담고 있다고 해도, Frozen LLM의 입력 Embedding Dimension 및 생성 방식에 바로 맞는 것은 아니다. Stage 2는 Query Output을 LLM의 입력에 연결하고 Generation Loss로 학습한다.
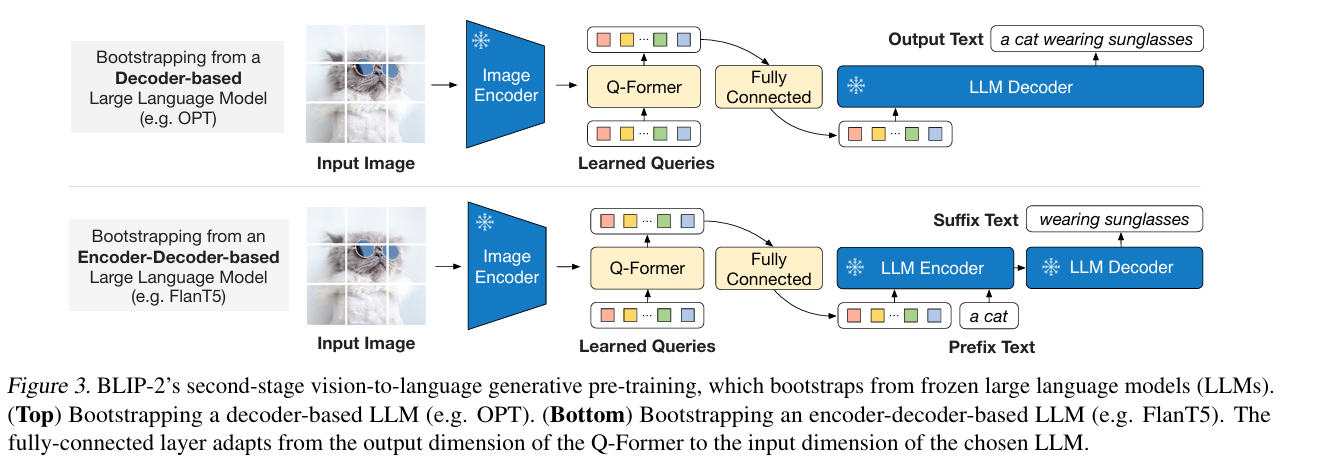
4.1 FC Projection과 Soft Visual Prompt
Q-Former의 출력을 다음처럼 두자.
LLM의 Embedding Dimension을 이라고 하면 학습 가능한 FC Projection은:
여기서 32라는 Query 수는 유지되고, 각 Query 벡터의 차원을 LLM의 입력 크기에 맞춘다. Projection 자체가 시각 정보를 새로 검색하거나 복잡한 추론을 수행하는 단계는 아니다.
이렇게 얻은 연속적인 Visual Embedding을 Text Embedding 앞에 붙여 Soft Visual Prompt로 사용한다. 즉 LLM이 이미지의 픽셀을 직접 읽는 것이 아니라, 이미지에서 추출된 32개 Query 표현을 조건으로 텍스트를 생성한다.
4.2 Decoder-only LLM과 Encoder–Decoder LLM
Decoder-only(OPT): Projected Visual Query Embedding과 Text Embedding을 함께 제공하고 일반적인 Next-token Prediction으로 학습한다.
Encoder–Decoder(FlanT5): Text를 Prefix와 Suffix로 나눈다. Visual Embedding과 Prefix는 Encoder에 입력되고, Decoder는 그 조건 아래 Suffix를 생성한다.
예컨대 전체 Target Text가 A cat is wearing sunglasses.일 때 Prefix를 A cat is로 정하면, Suffix는 wearing sunglasses.가 된다. Prefix는 Encoder가 이미 알고 있는 텍스트 문맥, Suffix는 Decoder가 생성해야 하는 나머지 텍스트이다. 이미지 조건 없이 문장 뒷부분을 외워서 완성하는 것이 아니라, Visual Prompt가 Encoder의 입력 조건에 함께 포함된다.
Stage 1과 Stage 2의 기능을 혼동하지 말자. Stage 1은 언어에 관련된 Visual Representation을 학습하고, Stage 2는 이를 Frozen LLM의 생성 입력으로 연결한다. Stage 2에서 LLM의 파라미터는 동결하지만, 그 앞의 Q-Former와 연결 Projection은 Generation Loss로 조정할 수 있다. Frozen LLM이라는 표현이 전체 파이프라인을 업데이트하지 않는다는 뜻은 아니다.
5. Experiments: Architecture보다 Training Strategy가 중요한 근거
5.1 Zero-shot VQA: Backbone의 능력 활용
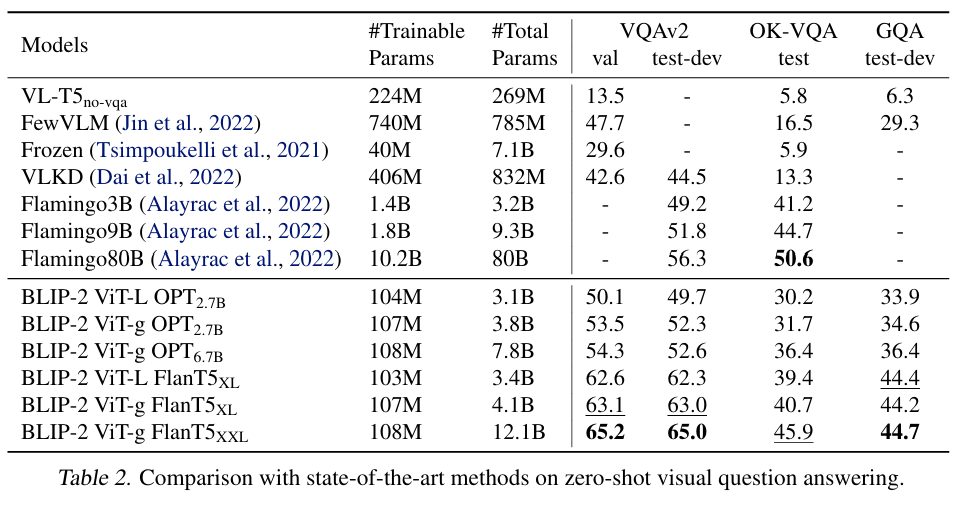
원문에 정리한 Table 2의 관찰은 더 강력한 Vision Encoder와 LLM을 활용하면 VQA 성능이 높아질 수 있다는 것이다. 이는 BLIP-2가 Backbone을 새로 만들지 않고 Pretrained Component를 결합하는 Modularity를 지닌다는 해석으로 이어진다. 다만 서로 다른 LLM 계열 간 성능 차이를 모델 크기 하나로 설명해서는 안 된다. FlanT5와 OPT는 Instruction Tuning 등 학습 설정도 다르다.
5.2 Two-stage Ablation: Stage 1을 제거하면?
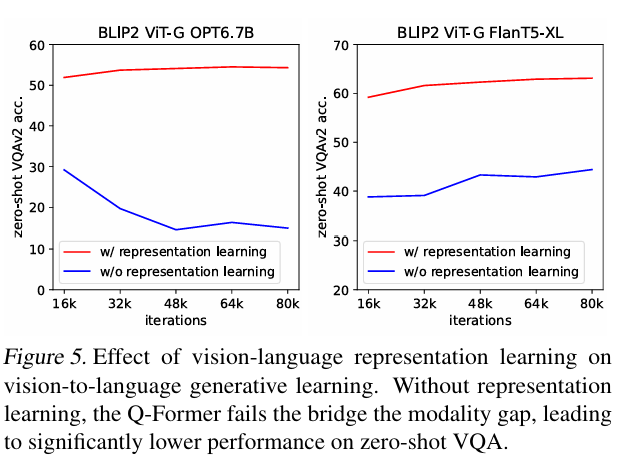
Stage 1을 제거하고 Stage 2의 Generation Loss만으로 학습하면 Zero-shot VQA 성능이 크게 떨어진다. Stage 1이 없으면 Q-Former가 이미지 특징 추출, Image–Text Alignment, LLM Generation에 필요한 표현 구성을 동시에 학습해야 한다.
반대로 Stage 1을 수행하면 Q-Former가 언어 관련 시각 정보를 먼저 학습하므로, Stage 2에서는 그 출력을 LLM에 연결하는 문제에 집중할 수 있다. 이 Ablation은 BLIP-2의 기여가 Q-Former 배치뿐 아니라 Two-stage Optimization에 있음을 보여주는 핵심 근거다.
5.3 ITG를 추가했을 때 Retrieval이 좋아지는 이유
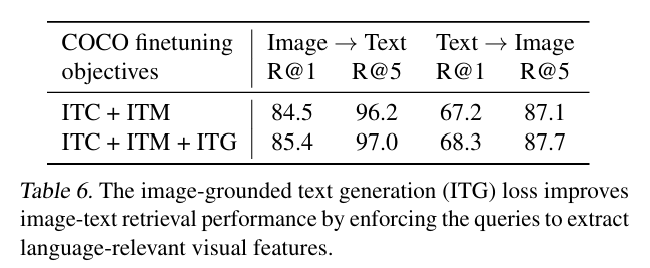
원문에 기록한 Ablation에서는 ITC+ITM에 ITG를 추가했을 때 Image-to-Text와 Text-to-Image Retrieval이 모두 개선된다. Retrieval은 생성 태스크가 아닌데도 ITG가 도움이 된다는 점은, 생성 학습이 Query가 언어와 관련 있는 시각 정보를 추출하도록 만드는 데에도 기여할 수 있음을 뒷받침한다.
6. Downstream Tasks: 같은 Q-Former를 어떻게 활용하는가?
6.1 Image Captioning
이미지를 입력받아 설명 문장을 생성한다. 원문에 정리한 Captioning Fine-tuning 설정에서는 Q-Former와 Image Encoder도 조정하며 LLM은 Freeze한다. 따라서 Pre-training에서 Image Encoder를 Freeze한다는 설명을 모든 Downstream Fine-tuning 상황에 무조건 일반화하면 안 된다.
6.2 Visual Question Answering: 질문이 Query에 들어가는 이유
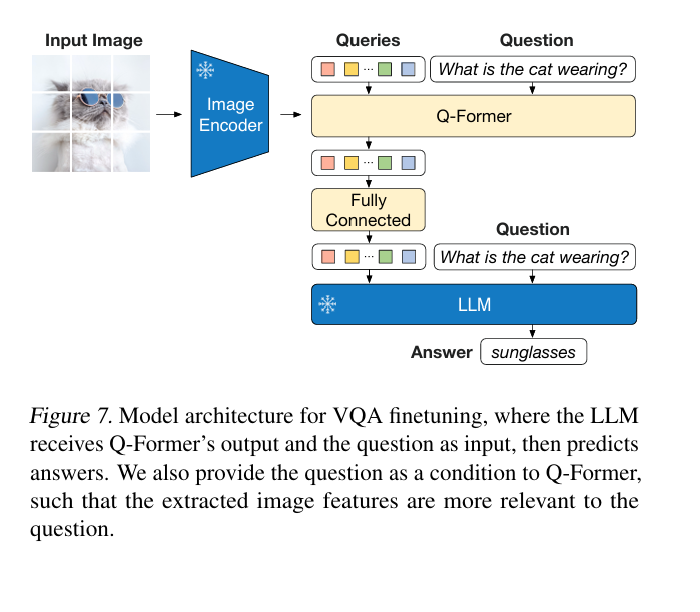
VQA Fine-tuning에서는 질문을 Q-Former에도 조건으로 제공하고 LLM에도 입력한다. Q-Former에 들어간 질문은 Query와의 Self-Attention을 통해 어떤 시각 정보가 현재 질문에 유용한지를 반영할 수 있다. 이어지는 Cross-Attention에서 이미지 특징을 참조하고, 그 출력이 LLM의 Visual Prompt가 된다.
- Q-Former에서 질문: 질문에 적합한 Image Representation 형성.
- LLM에서 질문: 그 Representation을 조건으로 실제 답변 생성.
즉 Stage 1의 ITC에서 Query와 Text를 분리하는 Mask와, Downstream VQA에서 질문을 Query에 Condition하는 방식은 서로 다른 설정이다.
6.3 Image–Text Retrieval
Retrieval에서는 Frozen LLM의 Language Generation이 필요하지 않다. Stage 1에서 학습한 Q-Former를 사용해 우선 ITC Similarity로 후보를 선택하고, ITM Matching Score로 Re-ranking한다. 원문에 적어 둔 설정은 ITC 기반 Top-128 후보 → ITM Re-ranking이다.
Recall@K는 정답 Pair가 상위 K개 후보에 존재하는 비율이다.
같은 평가 샘플 및 후보 집합을 사용한다면 K가 증가해도 Recall은 감소하지 않는다.
7. Limitations: 무엇이 해결되지 않았는가?
① Multimodal In-context Learning: 이미지–텍스트 Pair가 하나씩 들어 있는 Pre-training Data만으로는 한 Sequence 안에서 여러 Image–Text Example이 연결되는 관계를 충분히 학습하기 어렵다. 논문은 여러 VQA Example을 Prompt로 제공해도 원하는 성능 향상이 관찰되지 않았다고 보고한다.
② Frozen LLM의 한계 상속: LLM을 Freeze하면 이미 보유한 언어 능력을 활용할 수 있지만, 잘못된 지식이나 생성 오류 등 기존 모델의 한계가 자동으로 해소되지는 않는다.
③ 고정 Query Bottleneck의 잠재적 제약 — 프로젝트 관점의 해석: 32개의 Query를 사용해 정보를 집약하므로 세밀한 국소 결함처럼 작은 정보가 얼마나 보존되는지는 별도로 확인해야 한다. 이는 원문에서 보고한 위의 두 Limitation과 구분되는 후속 연구 관점의 질문이며, BLIP-2가 실제로 모든 작은 결함을 놓친다고 단정하는 실험 결과는 아니다.
8. 결론: BLIP-2에서 반드시 기억할 세 가지
- Q-Former는 32개 Query를 통해 많은 이미지 특징을 제한된 시각 표현으로 모으는 Query Bottleneck이다. 이 과정은 단순한 Token 삭제나 FC Dimension Reduction과 다르다.
- Stage 1의 ITC·ITG·ITM은 서로 다른 상호작용과 목적을 통해 언어 관련 Visual Representation을 학습한다. Attention Mask 차이를 이해해야 세 Objective의 역할이 보인다.
- Stage 2는 그 표현을 FC Projection으로 Frozen LLM의 Embedding Space에 연결하여 Generation에 사용한다. Stage 1 제거 Ablation은 이 두 단계 분리의 필요성을 보여준다.