모발이식 가격 데이터를 만들며 버린 것과 남긴 것
탈모케어랩에 모발이식 비용 페이지를 만들기로 했다.
검색하는 사람들이 가장 궁금해하는 정보인데, 인터넷에 떠도는 평균 가격을 다시 정리하는 건 의미가 없다고 봤다. 출처 없는 숫자를 하나 더 만드는 일이니까.
그래서 실제 의료기관이 공개한 가격을 직접 모으기로 했다. 절개와 비절개를 나누고 1,000모부터 5,000모까지 모수별로 정리하면 검증 가능한 데이터가 될 거라고 생각했다.
AI로 수집하면 될 줄 알았다
리서치에 강한 모델 두 개로 전국 의료기관의 공개 가격을 수집했다. 조건을 바꿔가며 세 차례 반복했다.
첫 수집에서 확보한 게 11개 의료기관, 공개가격 19건이었다. 생각보다 너무 적었다.
조건을 넓히고 다시 돌렸다. 병원 공식 홈페이지, 비급여 고지 페이지, 블로그, 의료 플랫폼까지 범위를 늘렸다. 그런데도 같은 기준으로 비교할 수 있는 의료기관이 전국 20곳을 안정적으로 넘지 못했다.
검색 결과에 병원은 훨씬 많았다. 문제는 다른 데 있었다.
검색되는 가격과 비교 가능한 데이터는 다르다
수집한 자료를 하나씩 열어보니 그대로 쓸 수 있는 게 거의 없었다.
상당수가 “2,000모 이상”처럼 범위만 적혀 있었다. 절개인지 비절개인지 표기가 없는 경우도 많았다. 수술 방식에 따라 가격 차이가 큰데 그게 빠져 있으면 어느 쪽 숫자인지 알 수 없다.
단위도 섞여 있었다. 어떤 병원은 모(毛) 기준이고 어떤 병원은 모낭 기준인데, 그대로 비교하면 전혀 다른 규모의 수술을 같은 조건처럼 취급하게 된다. 모낭 하나에 머리카락이 한두 가닥 넘게 나오니까 환산하면 숫자가 완전히 달라진다.
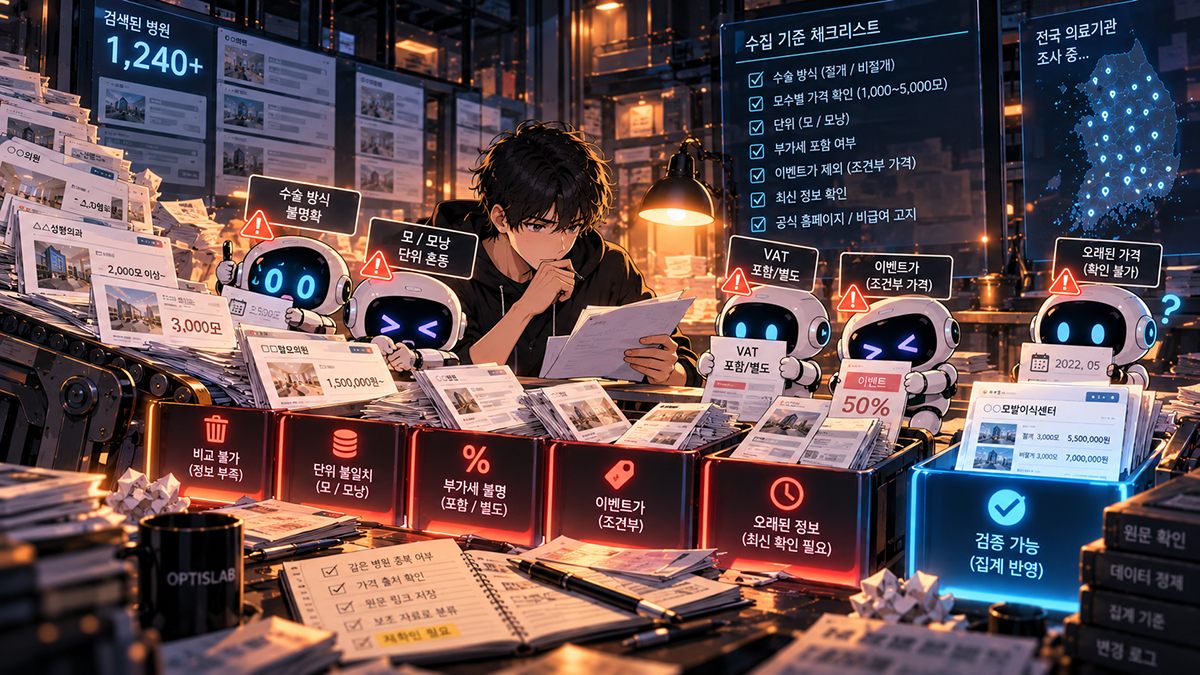
부가세도 문제였다. 포함 가격과 별도 가격이 섞여 있는데, 10퍼센트 차이를 무시하고 통계를 내면 의미가 없다.
정상가와 이벤트가가 함께 노출된 경우도 있었다. 모델, 후기 작성, 선착순 같은 조건이 붙은 특가를 시세로 넣으면 실제보다 낮게 나온다.
같은 병원의 삭발, 부분삭발, 무삭발 가격을 각각 다른 표본처럼 계산하면 그 병원 하나가 통계에 세 번 반영된다. 이것도 왜곡이다.
가격이 명확해 보여도 쓸 수 없는 경우가 있었다. 페이지는 살아 있는데 몇 년 전 가격표일 수 있고, 검색 결과에 숫자는 남아 있는데 원문에서 확인되지 않기도 했다. 공식 비급여 페이지까지 갔는데 가격표가 이미지로 올라가 있어 수술 방식과 가격의 연결을 확인할 수 없는 경우도 있었다.
방향을 바꾸자 데이터가 늘었다
AI에게 더 많이 찾으라고 하는 대신, 사람이 하나씩 원문을 확인하기 시작했다.
예상과 반대되는 일이 벌어졌다.
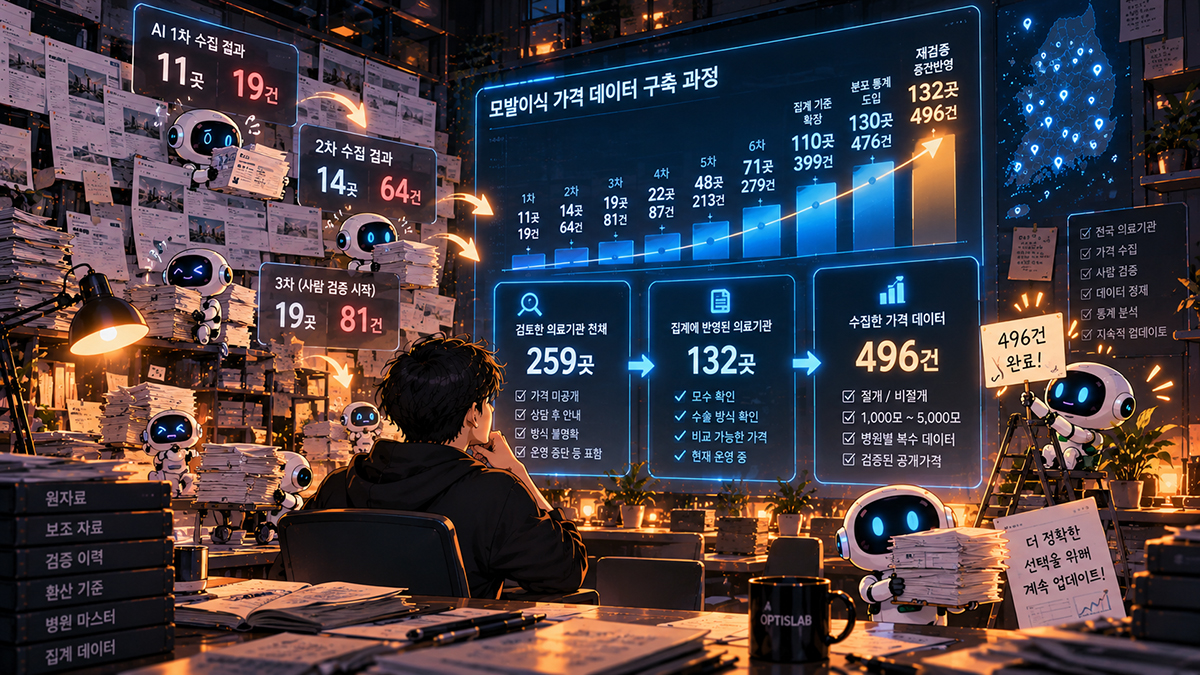
| 단계 | 집계 반영 | 가격 데이터 |
|---|---|---|
| 1차 | 11곳 | 19건 |
| 2차 | 14곳 | 64건 |
| 3차 (사람 검증 시작) | 19곳 | 81건 |
| 4차 | 22곳 | 87건 |
| 5차 | 48곳 | 213건 |
| 6차 | 71곳 | 279건 |
| 집계 기준 확장 | 110곳 | 399건 |
| 분포 통계 도입 | 130곳 | 476건 |
| 재검증 중간반영 | 132곳 | 496건 |
자동 수집을 줄이고 사람이 붙은 뒤에 오히려 속도가 붙었다. 기준이 잡히니까 어떤 자료를 살리고 어떤 자료를 보류할지 판단이 빨라졌기 때문이다.
71곳에서 110곳으로 뛴 구간은 병원을 새로 찾아서가 아니다. 모당 단가나 가격 구간, 딱 떨어지지 않는 모수로 공개된 가격을 표준 모수 기준으로 환산해 넣는 기준을 세우면서, 이미 확보해둔 자료가 집계로 들어온 것이다.
숫자 세 개를 구분해야 한다
여기서 헷갈리기 쉬운 지점이 있다. 나도 작업하면서 섞어 쓰다가 정리했다.
259곳은 검토 범위다.
살펴본 의료기관 전체 개수다. 가격을 못 찾은 곳, 상담 후에만 안내하는 곳, 수술 방식이 불명확한 곳까지 전부 포함된 조사 대상 목록이다.
132곳은 집계에 실제 반영된 곳이다.
검토한 곳 중에서 모수와 방식이 확인되는 가격을 공개한 곳만 남긴 숫자다. 나머지는 살펴봤지만 비교 조건을 못 맞춰서 통계에 들어가지 못했다.
496건은 가격 데이터 개수다.
병원 수가 아니라 가격 줄 수다. 한 병원이 절개 1,000모와 2,000모와 3,000모, 비절개 1,000모와 2,000모와 3,000모를 공개하면 그 병원 하나로 6건이 나온다. 그래서 132곳에서 496건이 나온다.
한 문장으로 정리하면 259곳을 살펴봤고, 그중 132곳이 비교 가능한 가격을 공개했고, 그 132곳에서 496개의 가격 데이터를 얻었다.
통계에 못 들어간 곳도 버린 게 아니다
집계에서 빠진 곳도 삭제하지 않았다. 데이터를 층으로 나눴다.
메인 통계에 들어가는 것, 환산 기준으로 보존하는 것, 보조 자료로 남기는 것, 병원 정보만 확보해두는 것으로.
방식이 표기되지 않아 메인에 못 들어간 데이터도 지역별 분포를 볼 때는 쓸 수 있다. 출처끼리 충돌하는 자료도 삭제하지 않고 충돌 이력으로 보존한다. 나중에 어느 쪽이 맞는지 확인될 수 있기 때문이다.
실제로 초기에 보조 자료였던 병원 상당수가 재조사에서 메인으로 옮겨갔다. 처음 조사에서 조건이 안 맞았던 자료가 두 번째, 세 번째 조사에서 다시 확인되면서 기준을 통과한 것이다. 버렸다면 매번 처음부터 다시 찾아야 했을 것이다.
웹에 없으면 전화를 걸었다
공개 자료만으로 확인이 안 되는 경우에는 병원에 직접 전화했다.
여기서 예상 못 한 게 나왔다. 피부과나 성형외과에 탈모 진료가 붙어 있는 건 자연스러운 조합이라 조사 대상에 넣었는데, 전화해보니 지금은 모발이식을 하지 않는다는 답이 돌아온 곳이 꽤 있었다.
웹에는 여전히 남아 있다. 페이지도 살아 있고 검색에도 걸린다. 그런데 실제로는 안 하는 것이다.
이런 곳은 뺐다. 가격이 확인되더라도 지금 받을 수 없는 수술의 가격은 데이터가 아니기 때문이다.
검색 결과만 보고 데이터를 만들면 이런 걸 걸러낼 수 없다. 화면에 있는 정보와 실제로 존재하는 서비스는 다른 이야기다.
기준은 문제를 만날 때마다 늘었다
처음 조사 기준은 열한 개였다. 지금은 스물두 개다. 새 기준은 전부 실제로 부딪힌 문제에서 나왔다.
3,200모나 4,800모처럼 딱 떨어지지 않는 자료가 많아서, 원본은 그대로 보존하고 비교가 필요할 때만 표준 모수로 환산하기로 했다. 다만 모와 모낭은 임의 환산하지 않는다. 애초에 다른 단위이기 때문이다.
이상치 처리도 기준을 나눴다. 모수와 방식과 정상가가 명확하면 시장 가격에서 크게 벗어나도 제외하지 않는다. 반면 조건이 불명확한 값은 뺀다. 비싸서 빼는 게 아니라 비교 조건이 부족해서 빼는 것이다.
표현 기준도 정했다. "전수조사"라는 말은 쓰지 않는다. "현재 확인된 공개가격 표본 기준"이라고만 쓴다. 실제로 전수조사가 아니기 때문이다.
가장 늦게 발견한 문제
데이터를 어느 정도 모은 뒤에 통계 왜곡을 발견했다.
3,000모 중앙값과 4,000모 중앙값이 있으면 두 숫자를 빼서 “1,000모 늘 때 얼마 오른다”를 계산할 수 있을 것 같다. 실제로 그렇게 쓰려고 했다.
그런데 각 모수에 포함된 병원이 다르다. 고가 병원이 3,000모 표본에만 있고 4,000모에는 빠지면 상승폭이 작아 보이는 착시가 생긴다. 반대 경우면 과장된다.
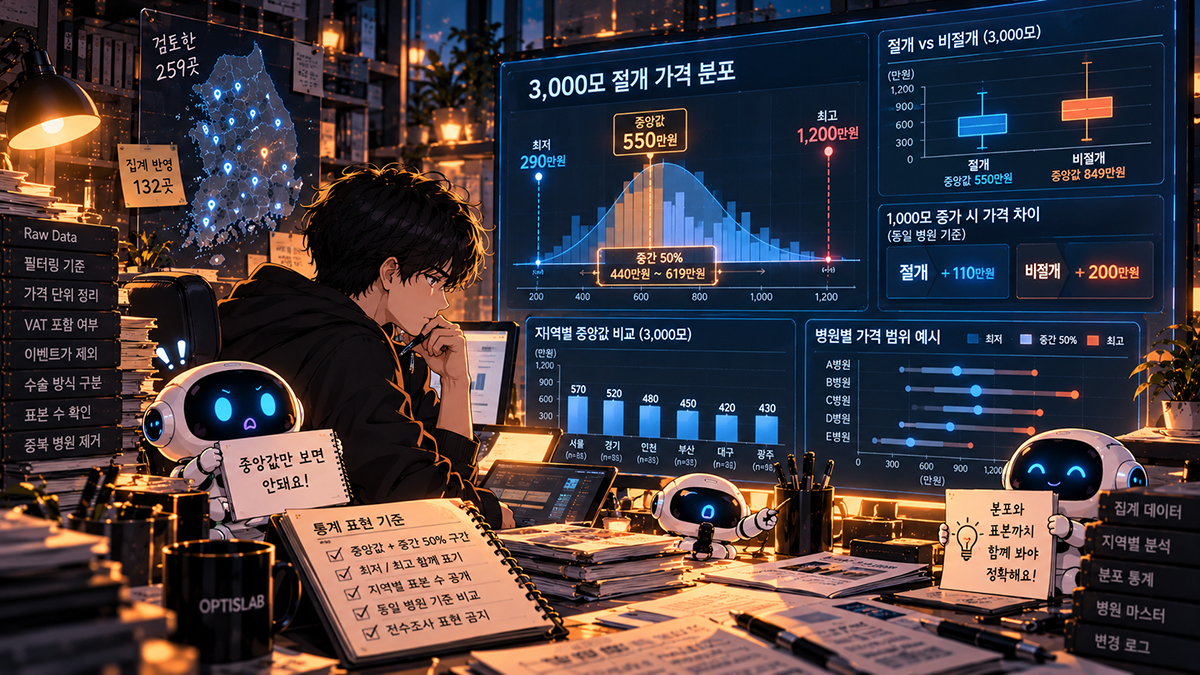
그래서 모수 간 가격 차이는 두 모수 가격을 모두 공개한 같은 병원끼리만 비교하기로 했다. 이 방식으로 계산하면 3,000모에서 4,000모로 갈 때 절개는 중앙값 110만원, 비절개는 200만원이 오른다.
중앙값 하나로는 부족했다
표본이 늘자 대표값을 어떻게 보여줄지도 다시 정해야 했다.
3,000모 절개의 중앙값은 550만원이다. 그런데 확인된 가격은 290만원부터 1,200만원까지 퍼져 있다. 중앙값만 적으면 이 폭이 사라지고, 최저와 최고만 적으면 극단값 두 개가 전체처럼 보인다.
그래서 가격순으로 줄 세웠을 때 가운데 절반이 들어가는 구간을 같이 공개하기로 했다. 3,000모 절개는 대부분 440만원에서 619만원 사이에 몰려 있다. 읽는 사람이 받은 견적이 어디쯤인지 가늠할 수 있는 숫자는 이쪽이다.
지역별로 보니 다른 게 보였다
표본이 늘면서 권역별 비교가 가능해졌다. 3,000모 구간이 표본이 가장 두꺼워서 비교 기준으로 삼았다.
처음 예상은 지역에 따라 가격이 다를 거라는 것이었다. 서울이 비싸고 지방이 저렴할 거라고.
그런데 확인해보니 지역 차이보다 병원과 수술 방식에 따른 편차가 훨씬 컸다.
같은 서울 안에서 3,000모 절개가 290만원부터 1,200만원까지 확인됐다. 권역 간 중앙값 차이보다 한 지역 안의 편차가 더 크다.
그리고 표본 수 자체가 정보였다. 검토한 259곳 중 131곳이 서울이다. 지역별 표본 수의 차이가 그대로 시장의 공급 집중도를 보여준다.
표본이 한 자릿수인 권역은 중앙값을 참고값으로만 표기한다. 확정적으로 말할 수 없기 때문이다. 아직 표본이 없는 칸은 비워두지 않고 "수집 중"이라고 적는다. 대신 확인된 숫자와 표본 수를 함께 공개해서 읽는 사람이 판단할 수 있게 했다.
평균 하나를 던지는 것과, 그 숫자가 몇 개의 표본에서 나왔는지를 같이 보여주는 것은 다르다.
버전이 올라가며 구조도 바뀌었다
작업 파일도 같이 자랐다.
처음엔 시트가 세 개였다. 집계 데이터, 조사 기준, 보조 원자료.
지금은 열한 개다. 작업 지시, 변경 로그, 2차 검증, 집계 대상, 집계 요약, 기준점 환산, 원자료, 보조 자료, 조사 기준, 병원 마스터, 아웃바운드 목차.
시트가 늘어난 건 기능을 추가해서가 아니다. 데이터를 어디에 둘지 판단이 필요해질 때마다 자리가 하나씩 생긴 것이다. 보조로 보존할 곳이 필요해서 보조 자료 시트가 생겼고, 충돌 이력을 남겨야 해서 2차 검증 시트가 생겼다.
정리하면
리서치를 시작할 때 가장 어려울 거라고 예상한 일은 전국의 병원 가격을 많이 찾는 것이었다.
실제로 해보니 가장 어려운 일은 그다음이었다. 찾은 숫자 중에서 무엇을 쓰지 않을지 결정하는 것.
AI는 후보를 빠르게 찾아준다. 그런데 찾아준 259개를 그대로 259개의 데이터라고 부를 수는 없었다. 여러 단계의 필터를 통과하고 원문을 다시 확인한 뒤 남은 게 132곳이다.
그리고 이 작업은 한 번으로 끝나지 않는다. 가격은 바뀌고 이벤트는 끝나고 페이지는 수정된다. 그래서 주기적으로 다시 확인하면서 변경된 값을 갱신하고 새로 확보한 의료기관을 추가하는 방식으로 운영한다.
지금까지 집계한 결과와 갱신 이력은 탈모케어랩의 모발이식 비용 페이지에 공개하고 있다.
