[Zero to ML Master #40] NumPy 배열 입문 — shape·axis·브로드캐스트와 * vs @ 행렬 곱, for문보다 빠른 벡터화까지 (02권 7부)
Zero to 머신러닝 딥러닝 Master
NumPy를 처음 쓰면 가장 자주 만나는 게 shape이 맞지 않는다는 에러입니다. 😵 그런데 정말 무서운 건 에러가 안 날 때예요. *와 @를 헷갈리면 같은 (2,2) 행렬끼리인데도 전혀 다른 값이 조용히 나오거든요.
이번 글은 딥러닝의 실제 계산 엔진인 NumPy입니다. 배열이 왜 리스트보다 빠른지("제약이 곧 속도"), shape과 축(axis)을 읽는 법, 원소별 곱 *와 행렬 곱 @의 차이, 크기가 달라도 자동으로 펼쳐지는 브로드캐스트, 그리고 100만 개 원소로 for문과 벡터화의 속도를 직접 재 보는 것까지 정리합니다. 01권에서 손으로 계산한 가 여기서 한 줄 코드가 됩니다.
📘 이 글은 위키독스 도서 Zero to 머신러닝 딥러닝 Master 의 02-07 🔢 7부 — NumPy: 딥러닝의 계산 엔진 을 블로그용으로 다듬은 글입니다.
💻 실습 코드: GitHub · 🏠 mldict.net · ✍️ 기술 블로그
💻 이 글의 코드:
02-07-numpy· Open in Colab — 핵심 코드와 실제 실행 결과는 글 아래 💻 GitHub 실습 섹션에 있습니다.
⬅️ 이전 글: #39 파이썬 예외 처리·모듈·파일 입출력·PEP8 — try·except부터 with open·import numpy as np·코드 컨벤션까지 (02권 6부) \
➡️ 다음 글: #41 판다스(Pandas) 입문 — Series·DataFrame 만들기, CSV·엑셀 읽고 쓰기, loc·iloc·조건 필터까지 (02권 8부 1)
TL;DR — 3줄 요약
- NumPy 배열은 같은 종류만 담는 레고 판입니다. 이 제약 덕분에 메모리에 붙여 저장하고 통째로 계산할 수 있어요. 에러가 나면 가장 먼저
.shape(모양)을 확인하고,.ndim·.dtype·.size도 함께 봅니다. X[행, 열]·X[:, 1]로 자르고,X[X > 6]·np.where로 조건을 배열 전체에 적용합니다(ReLU의 원리).reshape(-1, 6)은 모양만 바꾸고,axis=N은 N번째 차원이 뭉개져 사라진다는 뜻입니다.*는 같은 자리끼리(짝 맞추기),@는 행렬 곱(변환하기)이고 shape 규칙은(m,n) @ (n,k) = (m,k)입니다. 브로드캐스트가 편향b를 배치 전체에 펼쳐 주므로Z = X @ W + b한 줄로 배치를 처리하고, 벡터화는 for문보다 몇 배에서 수십 배 빠릅니다.
🔗 지난 글 복습: #39 파이썬 예외 처리·모듈·파일 입출력·PEP8 (02권 6부)에서
import numpy as np관례와np.save로 배열을 저장하는 법까지 봤습니다. 이번 글은 그 NumPy 자체를 본격적으로 다룹니다.
02-07-Z NumPy 배열 — "숫자들의 격자판"
🔍 더 쉽게 이해하기 — 🧱 레고 판 vs 레고 탑
🗼 파이썬 리스트 = 블록을 일렬로 쌓은 탑. 아무거나 섞어 담을 수 있음(숫자·글자·리스트).\
🟩 NumPy 배열 = 레고 판. 같은 종류만 격자로 빽빽하게 정렬.\
\
🤔 왜 굳이 제약을 두나? "전부 같은 크기·같은 종류"라고 보장되면, 컴퓨터가 메모리에 딱 붙여 저장하고 한 번에 통째로 계산할 수 있기 때문입니다.\
제약이 곧 속도입니다. AD단원에서 28배 차이를 직접 측정합니다.
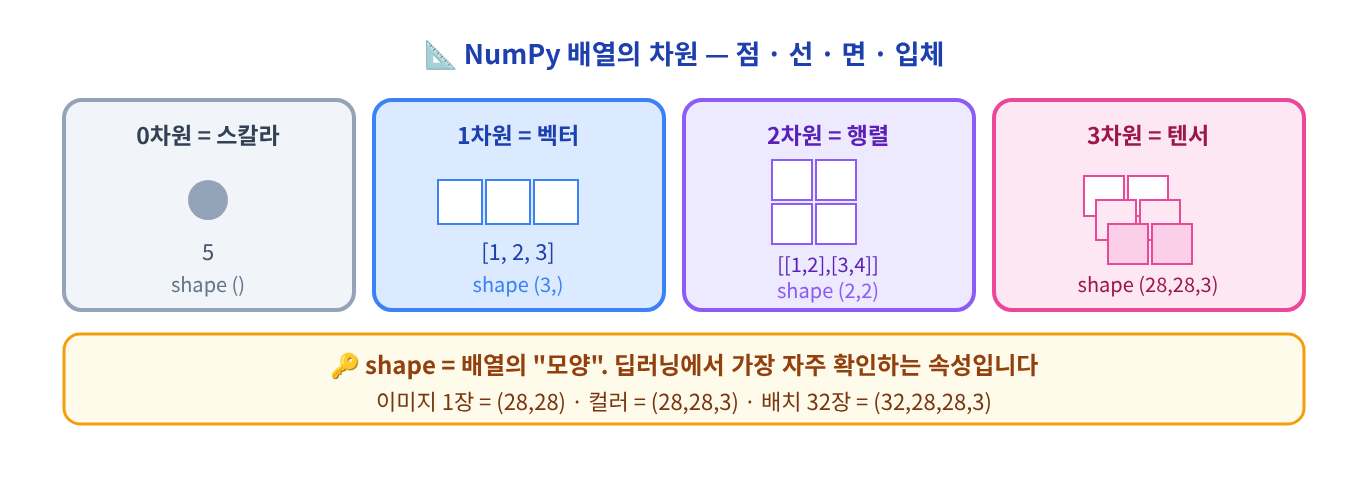
📐 차원과 shape — 딥러닝에서 가장 자주 보는 것
💻 코드 — 배열 만들기와 속성 확인
Python — Z-1: 배열 생성과 속성
import numpy as np      # 관례: 반드시 np 라는 별명으로

# ── 1차원 (벡터) ──
a = np.array([1, 2, 3])
print(a, a.shape, a.ndim, a.dtype, a.size)

# ── 2차원 (행렬) ──
B = np.array([[1, 2],
              [3, 4],
              [5, 6]])
print(B.shape, B.ndim, B.dtype)   # (3,2) = 3행 2열

# ── 자주 쓰는 생성 함수 ──
print(np.zeros((2, 3)))        # 0으로 채운 2×3 (편향 초기화!)
print(np.ones(3))              # 1로 채운 벡터
print(np.arange(0, 10, 2))     # range의 배열 버전
print(np.linspace(0, 1, 5))    # 0~1을 5등분 (그래프 x축용!)

# ── 랜덤 (가중치 초기화) ──
rng = np.random.default_rng(0)  # 시드 고정 → 재현 가능
print(np.round(rng.normal(0, 1, (2, 3)), 2))
🔗 GitHub에서 코드 보기 — 02_07_numpy.py L12–L32
▶ 실행 결과
[1 2 3] (3,) 1 int64 3
(3, 2) 2 int64
[[0. 0. 0.]
 [0. 0. 0.]]
[1. 1. 1.]
[0 2 4 6 8]
[0.   0.25 0.5  0.75 1.  ]
[[ 0.13 -0.13  0.64]
 [ 0.1  -0.54  0.36]]
🧠 코드 이해 — 4대 속성
| 속성 | 뜻 | 예 | 언제 확인하나 |
|---|---|---|---|
.shape | 모양 (튜플!) | (3, 2) | 에러가 나면 가장 먼저 |
.ndim | 차원 수 | 2 | 배치 차원이 있나 확인 |
.dtype | 데이터 타입 | int64 | float이어야 하는데 int면 오류 |
.size | 전체 원소 개수 | 6 | 메모리 추정 |
🔗 shape이 튜플인 이유는 F단원(#35 자료형)에서 배웠죠 — 배열의 모양은 함부로 바뀌면 안 되기 때문입니다.\
📌np.zeros((2,3))에서 괄호가 두 겹인 이유도 같습니다. shape을 튜플 하나로 넘기는 것입니다.
⭐ 오늘의 한 줄 — NumPy 배열은 "같은 종류만 담는 레고 판"이고, shape은 그 판의 모양입니다.
02-07-AA NumPy 심화 — 인덱싱 · reshape · 축(axis)
🔍 인덱싱과 슬라이싱 — 2차원 버전
🔍 더 쉽게 이해하기 — 🎬 극장 좌석표
2차원 배열은 극장 좌석표입니다.
X[행, 열]= "3열 5번 좌석"\
·X[0]→ 0번째 줄 전체 (앞줄 통째로)\
·X[:, 1]→ 1번 열 전체 (콜론은 "전부") — 세로줄!\
·X[0:2, 1:3]→ 0~1행 × 1~2열 구역 (직사각형 블록)
Python — AA-1: 인덱싱 · 불리언 인덱싱
import numpy as np

X = np.arange(1, 13).reshape(3, 4)
print(X)

print("0번 행    :", X[0])          # 첫 줄 전체
print("1번 열    :", X[:, 1])       # : = "전부"
print("[1,2] 값  :", X[1, 2])       # 1행 2열
print("블록      :", X[0:2, 1:3].tolist())

# ── 불리언 인덱싱: 조건에 맞는 것만 (파이썬 if의 배열 버전!) ──
print("6보다 큰 값:", X[X > 6])

# ── np.where: 조건에 따라 다른 값 (ReLU의 원리!) ──
print(np.where(X > 6, 1, 0))
🔗 GitHub에서 코드 보기 — 02_07_numpy.py L36–L50
▶ 실행 결과
[[ 1  2  3  4]
 [ 5  6  7  8]
 [ 9 10 11 12]]
0번 행    : [1 2 3 4]
1번 열    : [ 2  6 10]
[1,2] 값  : 7
블록      : [[2, 3], [6, 7]]
6보다 큰 값: [ 7  8  9 10 11 12]
[[0 0 0 0]
 [0 0 1 1]
 [1 1 1 1]]
🤖 딥러닝 연결 — np.where(x > 0, x, 0)이 바로 ReLU입니다! 🔗 01-13(#31)의 (self.z1 > 0)도 불리언 인덱싱이었습니다.\
for문 없이 배열 전체에 조건을 적용하는 것 — 이것이 벡터화 사고입니다.
🔄 reshape — 모양 바꾸기
🔍 더 쉽게 이해하기 — 🧊 얼음틀 갈아끼우기
물 12칸을 3×4 틀에 넣든 2×6 틀에 넣든 물의 양은 그대로입니다. reshape은 틀만 바꾸는 것이죠.\
📌 원소 개수는 반드시 같아야 합니다. 12개를 3×5(=15)로는 못 바꿉니다.\
🪄-1의 마법 —reshape(-1, 6)은 "열은 6, 행은 알아서 계산해"라는 뜻입니다.
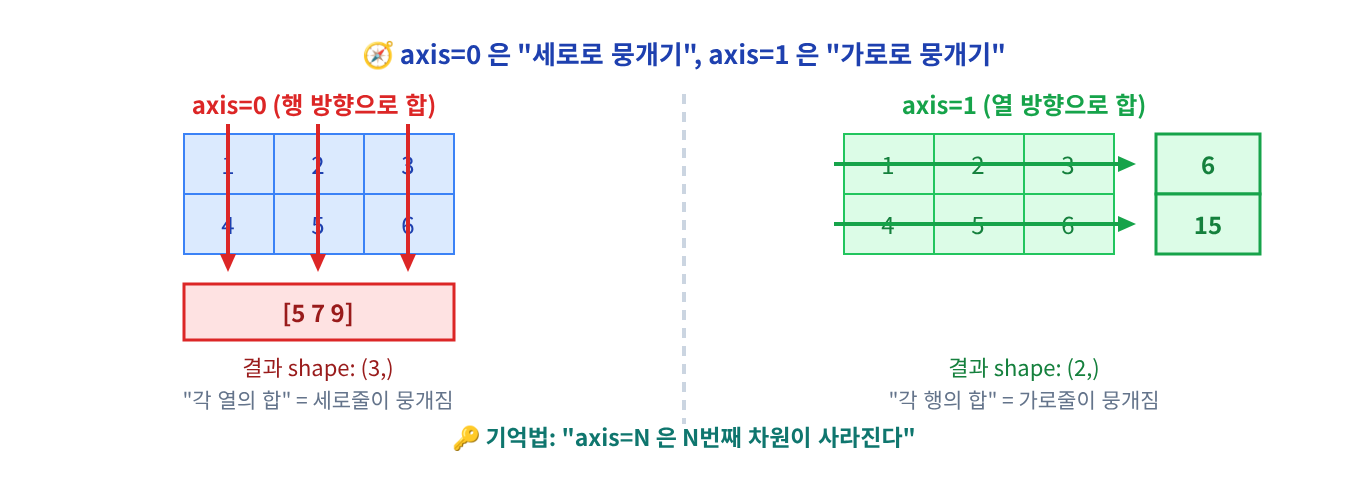
🧭 축(axis) — 딥러닝에서 가장 헷갈리는 개념
Python — AA-2: reshape과 축 연산
import numpy as np

c = np.arange(12)
print(c.reshape(3, 4))       # 3행 4열로
print(c.reshape(-1, 6))      # -1 = "알아서 계산해" → 2행 6열
print(c.reshape(3, 4).T)     # .T = 전치 (행↔열 뒤집기)

M = np.array([[1, 2, 3],
              [4, 5, 6]])
print("전체합  :", M.sum())
print("axis=0  :", M.sum(axis=0))   # 각 열의 합
print("axis=1  :", M.sum(axis=1))   # 각 행의 합
print("평균    :", M.mean(), "최대:", M.max())
print("행별 최대 위치:", M.argmax(axis=1))  # 예측 클래스 뽑기!
🔗 GitHub에서 코드 보기 — 02_07_numpy.py L54–L67
▶ 실행 결과
[[ 0  1  2  3]
 [ 4  5  6  7]
 [ 8  9 10 11]]
[[ 0  1  2  3  4  5]
 [ 6  7  8  9 10 11]]
[[ 0  4  8]
 [ 1  5  9]
 [ 2  6 10]
 [ 3  7 11]]
전체합  : 21
axis=0  : [5 7 9]
axis=1  : [ 6 15]
평균    : 3.5 최대: 6
행별 최대 위치: [2 2]
🤖 딥러닝 연결 — axis를 매일 씁니다
· reshape(-1, 784) — 28×28 이미지를 784차원 벡터로 펴기 (배치 크기는 자동)\
· logits.argmax(axis=1) — 배치 각 샘플의 예측 클래스 뽑기\
· loss.mean(axis=0) — 배치 방향으로 평균 (🔗 01-12 기댓값, #29)\
· x.T — 역전파의 전치 (🔗 01-13 4단계, #31)\
"axis=0은 배치 방향, axis=1은 특성 방향" — 이 감각이 딥러닝 코딩의 기본입니다.
⭐ 오늘의 한 줄 — axis=N은 "N번째 차원이 뭉개져 사라진다"는 뜻입니다.
02-07-AB 원소별 연산 vs 행렬 곱 — 신경망 계산의 심장
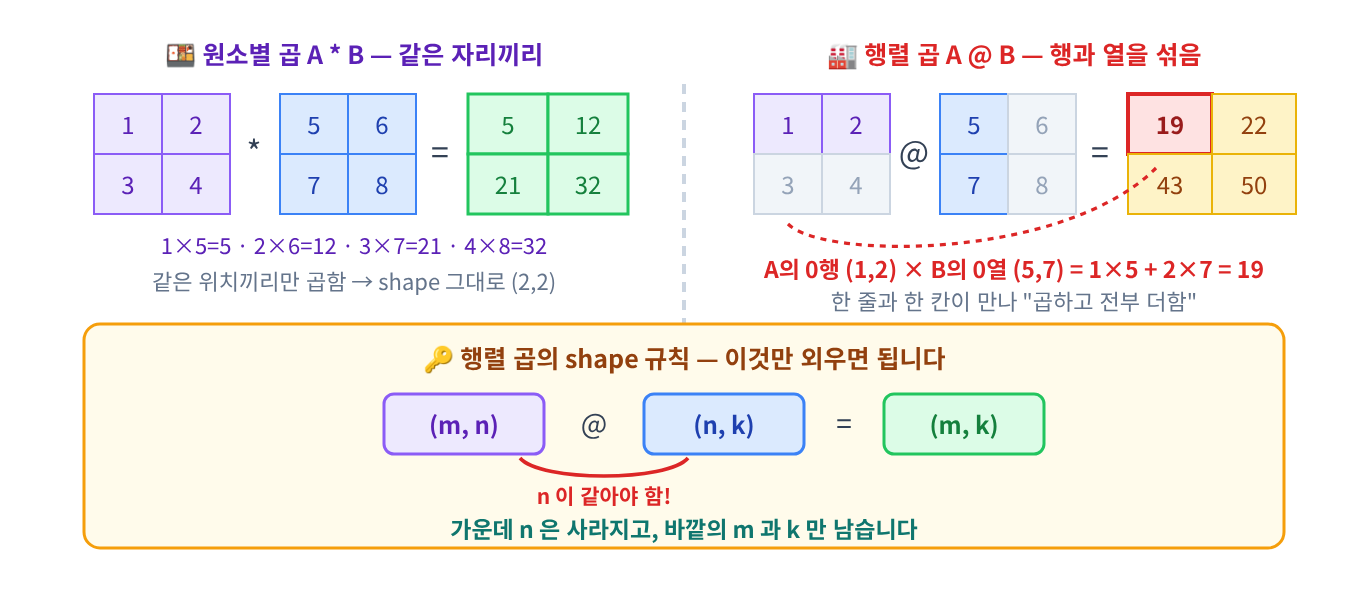
NumPy의 연산은 딱 두 종류입니다. 이 둘을 헷갈리면 에러 없이 조용히 틀린 값이 나오기 때문에, 초보자가 가장 오래 헤매는 지점입니다.
🔍 더 쉽게 이해하기 — 🍱 도시락 두 개 합치기 vs 🏭 공장 조립
🍱 원소별 연산
*= 도시락 칸끼리 합치기\
밥칸은 밥칸끼리, 반찬칸은 반찬칸끼리. 같은 위치끼리만 만납니다.\
→ 모양이 똑같아야 합니다.\
\
🏭 행렬 곱@= 공장 조립 라인\
"입력 2개"가 들어가서 "출력 3개"로 변환됩니다. 각 출력은 모든 입력을 섞어서 만듭니다.\
→ 앞의 열 수와 뒤의 행 수가 맞아야 합니다.\
\
기억법:*는 "짝 맞추기",@는 "변환하기".
🖼️ 시각화 — 두 연산의 결정적 차이
💻 코드 — 두 연산 비교와 신경망 순전파
Python — AB-1: 원소별 연산 vs 행렬 곱
import numpy as np

# ── ① 원소별 연산: 같은 위치끼리 ──
a = np.array([1, 2, 3])
b = np.array([10, 20, 30])
print("a + b =", a + b)      # 짝끼리 더하기
print("a * b =", a * b)      # 짝끼리 곱하기 (행렬곱 아님!)
print("a * 2 =", a * 2)      # 스칼라 곱 (전부에 2배)
print("a @ b =", a @ b)      # 벡터 내적 = 곱해서 전부 더함

# ── ② 행렬 곱: np.dot 또는 @ (둘은 같습니다) ──
A = np.array([[1, 2],
              [3, 4]])
B = np.array([[5, 6],
              [7, 8]])
print("\nA @ B (행렬 곱):")
print(np.dot(A, B))
# [0,0] = 1×5 + 2×7 = 19    [0,1] = 1×6 + 2×8 = 22
# [1,0] = 3×5 + 4×7 = 43    [1,1] = 3×6 + 4×8 = 50

print("\nA * B (원소별 곱):")
print(A * B)              # 완전히 다른 결과!
🔗 GitHub에서 코드 보기 — 02_07_numpy.py L71–L92
▶ 실행 결과
a + b = [11 22 33]
a * b = [10 40 90]
a * 2 = [2 4 6]
a @ b = 140

A @ B (행렬 곱):
[[19 22]
 [43 50]]

A * B (원소별 곱):
[[ 5 12]
 [21 32]]
🚨 가장 무서운 버그 — 에러 없이 틀린 값
같은 (2,2) 행렬끼리인데 @는 [[19,22],[43,50]], *는 [[5,12],[21,32]]입니다.\
😱 shape이 같으니 에러가 안 납니다. 학습이 안 되는데 원인을 못 찾는 상황이 여기서 생깁니다.\
"선형변환은 @, 마스크·스칼라는 *" — 코드를 쓸 때마다 의식적으로 확인하세요.
💻 코드 — 신경망 순전파를 직접 계산하기
Python — AB-2: 입력 × 가중치 + 편향
import numpy as np

x = np.array([1.0, 0.5])              # 입력 뉴런 2개
W = np.array([[0.1, 0.3, 0.5],        # 가중치 (2×3)
              [0.2, 0.4, 0.6]])
b = np.array([0.1, 0.2, 0.3])          # 편향 (출력 뉴런 3개)

y = np.dot(x, W) + b                   # 🔗 01-13의 z = xW + b !

print(f"입력 x  : {x}  shape {x.shape}")
print(f"가중치 W: shape {W.shape}")
print(f"출력 y  : {y}  shape {y.shape}")

# 손으로 검산해보기
print("\n[검산] y[0] = 1.0×0.1 + 0.5×0.2 + 0.1 =",
      round(1.0*0.1 + 0.5*0.2 + 0.1, 4))
🔗 GitHub에서 코드 보기 — 02_07_numpy.py L96–L111
▶ 실행 결과
입력 x  : [1.  0.5]  shape (2,)
가중치 W: shape (2, 3)
출력 y  : [0.3 0.7 1.1]  shape (3,)

[검산] y[0] = 1.0×0.1 + 0.5×0.2 + 0.1 = 0.3
🤖 딥러닝 연결 — 이 한 줄이 신경망의 전부입니다
y = np.dot(x, W) + b\
🔗 01-13(#31)에서 배운 순전파 수식 가 정확히 이 한 줄입니다.\
📐 shape 흐름: (2,) @ (2,3) → (3,) — 입력 2개가 출력 3개로 변환되었습니다.\
🏗️ V단원(#38)의 Affine.forward() 안에 있던 x @ self.W + self.b가 바로 이것입니다.\
GPT-3의 1750억 파라미터도 결국 이 연산을 어마어마하게 크게, 여러 번 하는 것뿐입니다.
⭐ 오늘의 한 줄 — *는 짝 맞추기, @는 변환하기. shape은 (m,n)@(n,k)=(m,k).
02-07-AC 브로드캐스트 — 크기가 달라도 자동 확장
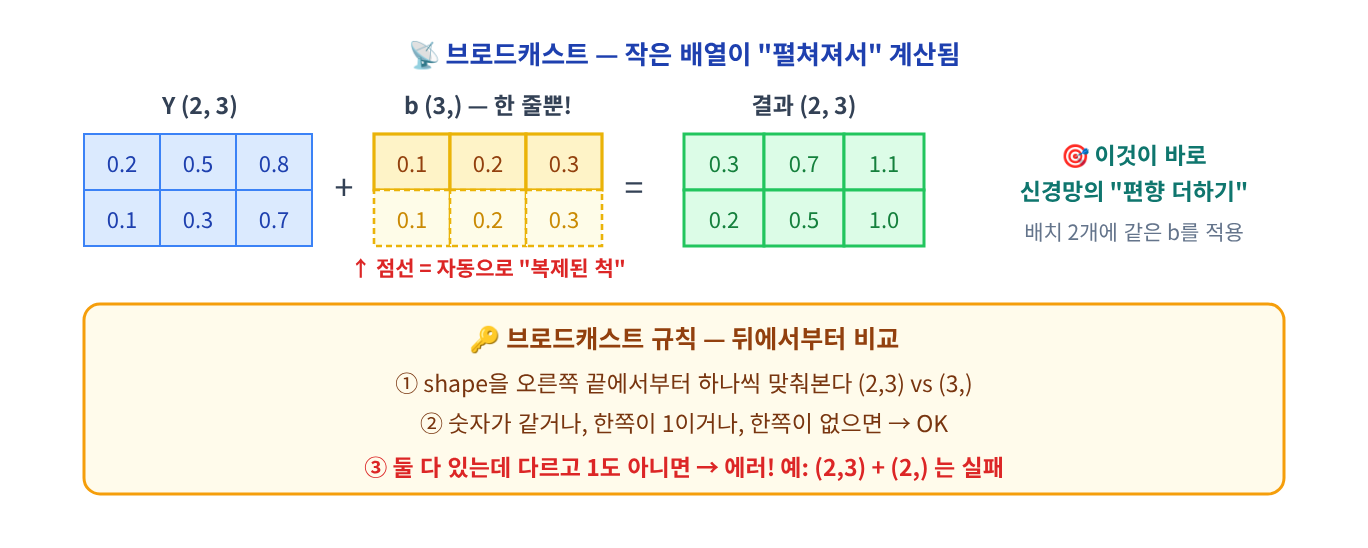
🔍 더 쉽게 이해하기 — 📋 30명 시험지에 가산점 주기
30명이 3과목 시험을 봤습니다 → 점수표 (30, 3) 행렬\
각 과목에 가산점을 줍니다 → 가산점 (3,) 벡터 = [국어+5, 영어+3, 수학+7]\
\
😰 보통이라면 — 30명 × 3과목 = 90번 반복문을 돌려야 합니다.\
✨ NumPy라면 —점수표 + 가산점한 줄이면 끝!\
\
🪄 NumPy가 가산점 벡터를 자동으로 30줄 복사해 계산해줍니다. 이것이 브로드캐스트입니다.\
실제로 메모리를 복사하지는 않습니다 — "그런 척하고" 계산만 합니다. 그래서 빠르고 메모리도 안 씁니다.
🖼️ 시각화 — 브로드캐스트가 일어나는 과정
💻 코드 — 브로드캐스트 3가지 패턴
Python — AC-1: 브로드캐스트
import numpy as np

# ── ① 스칼라 × 배열: 숫자 하나가 전체로 퍼짐 ──
A = np.array([[1, 2], [3, 4]])
print("A * 10 =")
print(A * 10)                    # 10이 (2,2) 전체로 확장

# ── ② 행렬 + 행벡터: 신경망의 편향 더하기! ──
Y = np.array([[0.2, 0.5, 0.8],    # 배치 2개 × 뉴런 3개
              [0.1, 0.3, 0.7]])
b = np.array([0.1, 0.2, 0.3])      # 편향 (뉴런 3개)

print(f"\nY shape {Y.shape} + b shape {b.shape}")
print(Y + b)                    # b가 두 행 모두에 적용!

# ── ③ 열벡터 + 행렬: 세로 방향 확장 ──
col = np.array([[1], [2]])       # shape (2, 1) — 열벡터
M = np.array([[1, 2, 3],
              [4, 5, 6]])
print(f"\n(2,1) + (2,3):")
print(M + col)                  # 열벡터가 가로로 확장
🔗 GitHub에서 코드 보기 — 02_07_numpy.py L115–L135
▶ 실행 결과
A * 10 =
[[10 20]
 [30 40]]

Y shape (2, 3) + b shape (3,)
[[0.3 0.7 1.1]
 [0.2 0.5 1. ]]

(2,1) + (2,3):
[[2 3 4]
 [6 7 8]]
🤖 딥러닝 연결 — 배치 학습이 가능한 이유
신경망에 이미지 32장을 한 번에 넣는다고 합시다. 각 층에서 편향을 더해야 하는데, 32장 각각에 반복문을 돌리면 끔찍하게 느립니다.\
✨ 브로드캐스트 덕분에 Z = X @ W + b 한 줄로 32장을 동시에 처리합니다.\
📐 shape: (32, 784) @ (784, 128) + (128,) → (32, 128)\
"배치 처리"라는 딥러닝의 기본 전략은 브로드캐스트 위에 서 있습니다.
⭐ 오늘의 한 줄 — 작은 배열이 자동으로 "펼쳐진 척"하며 계산됩니다. shape은 뒤에서부터 맞춰보세요.
02-07-AD NumPy는 왜 빠른가 — 직접 측정해보기
🔍 더 쉽게 이해하기 — 🏭 수작업 vs 자동화 라인
🐌 파이썬 for문 = 장인이 하나씩 손으로 만들기\
물건마다 "이게 숫자인가? 문자인가?" 확인하고, 포장을 뜯고, 계산하고, 다시 포장합니다.\
\
⚡ NumPy 벡터화 = 자동화 컨베이어 벨트\
"전부 같은 규격"이 보장되어 있으니 확인 절차가 없습니다. C로 짜인 기계가 통째로 처리합니다.\
\
🎯 속도 차이의 진짜 이유 3가지\
① 타입 확인 생략 — 전부 같은 dtype이 보장됨\
② 메모리 연속 배치 — 데이터가 한 줄로 붙어 있어 읽기가 빠름\
③ SIMD 명령 — CPU가 한 번에 4~8개를 동시에 계산
💻 코드 — 100만 개 원소로 속도 측정
Python — AD-1: 속도 비교 실험
import numpy as np
import time

N = 1_000_000                     # 100만 개 (숫자에 _ 를 넣어 읽기 쉽게)

py_a = list(range(N))              # 파이썬 리스트
py_b = list(range(N))
np_a = np.arange(N, dtype=np.float64)  # NumPy 배열
np_b = np.arange(N, dtype=np.float64)

# ── 파이썬 for문 방식 ──
t0 = time.perf_counter()
result_py = sum(x * y for x, y in zip(py_a, py_b))
t1 = time.perf_counter()

# ── NumPy 벡터화 방식 ──
t2 = time.perf_counter()
result_np = (np_a * np_b).sum()
t3 = time.perf_counter()

py_time, np_time = t1 - t0, t3 - t2
print(f"파이썬 for  : {py_time*1000:.1f} ms")
print(f"NumPy 벡터화: {np_time*1000:.1f} ms")
print(f"→ 약 {py_time/np_time:.0f}배 빠름")
print(f"결과 동일   : {abs(result_py - result_np) < 1}")
🔗 GitHub에서 코드 보기 — 02_07_numpy.py L139–L163
▶ 실행 결과
파이썬 for  : 46.0 ms
NumPy 벡터화: 1.7 ms
→ 약 28배 빠름
결과 동일   : True
💡 직접 재 보니: 이 글을 만들며 같은 코드를 박스(Linux · Python 3.13.5 · numpy 2.5.3)에서 세 번 실행했더니 파이썬 for 40.5~75.8 ms, NumPy 8.4~9.9 ms로 약 5~9배였습니다. 위 46.0 ms · 1.7 ms · 28배는 책 원고의 측정값이고, 배수는 컴퓨터와 실행할 때마다 크게 달라집니다. 그래도 결과 동일: True와 NumPy 쪽이 빠르다는 점은 매번 같았습니다.
✅ 실행 결과 요약 — 28배가 의미하는 것
같은 계산인데 28배 차이입니다. 학습 시간이 28시간 vs 1시간이 되는 셈이죠.\
📌 컴퓨터마다 배수는 다르지만 수십 배 차이는 항상 납니다. 배열이 클수록 격차가 벌어집니다.\
🎮 그리고 GPU를 쓰면 여기서 다시 수십~수백 배가 빨라집니다. PyTorch의 .cuda()가 하는 일입니다.\
"딥러닝 코드에서 for문이 보이면 의심하라" — 벡터화로 바꿀 수 있는지 항상 생각하세요.
🧠 벡터화 사고 — for문을 없애는 연습
❌ 느린 코드
result = []
for i in range(len(x)):
    result.append(x[i] * 2 + 1)
✅ 빠른 코드
result = x * 2 + 1"각 원소에 같은 일을 반복한다"면 → 전부 벡터화할 수 있습니다.
⭐ 오늘의 한 줄 — "제약이 곧 속도"입니다. 같은 종류만 담기 때문에 C 엔진이 통째로 계산할 수 있습니다.
🔜 다음 부 예고 — 02-08. 🐼 8부 — Pandas: 파이썬으로 쓰는 엑셀
숫자를 계산하는 엔진을 손에 넣었습니다. 다음 8부에서는 세상 데이터의 대부분인 표를 다루는 Pandas를, 이어지는 9부에서는 그 결과를 그래프로 확인하는 Plotly를 배웁니다. 손실 곡선·결정 경계를 눈으로 보는 습관은 03권 내내 쓰입니다.
💻 GitHub 실습 — 코드로 직접 확인하기
📂 이 장의 코드 폴더: book/02-hello-python/02-07-numpy
책에 실린 코드를 장(절)별로 모아 둔 폴더입니다. 아래 파일을 열어 보거나, Colab에서 바로 실행해 보세요.
| 파일 | 용도 | 링크 |
|---|---|---|
02_07_numpy.py | 책의 코드 블록 7개를 순서대로 모은 실행 스크립트 (# %% 셀 구분) | 코드 보기 |
02_07_numpy.ipynb | 같은 코드를 블록당 셀 1개로 담은 주피터 노트북 | 보기 · Colab |
README.md | 코드 블록 목록 · 실행 방법 · 검증 결과 | 보기 |
🧪 저장소 검증 상태: ✅ 실행 OK
🔑 핵심 코드 1 — reshape·전치·축(axis) 연산 — sum(axis=0/1)과 argmax로 예측 클래스 뽑기
📄 02_07_numpy.py L54–L67 · Block 3 (02-07-AA NumPy 심화 — 인덱싱 · reshape · 축(axis))
import numpy as np

c = np.arange(12)
print(c.reshape(3, 4))       # 3행 4열로
print(c.reshape(-1, 6))      # -1 = "알아서 계산해" → 2행 6열
print(c.reshape(3, 4).T)     # .T = 전치 (행↔열 뒤집기)

M = np.array([[1, 2, 3],
              [4, 5, 6]])
print("전체합  :", M.sum())
print("axis=0  :", M.sum(axis=0))   # 각 열의 합
print("axis=1  :", M.sum(axis=1))   # 각 행의 합
print("평균    :", M.mean(), "최대:", M.max())
print("행별 최대 위치:", M.argmax(axis=1))  # 예측 클래스 뽑기!
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Linux · Python 3.13.5 · numpy 2.5.3, 앞 블록부터 순서대로 실행)
[[ 0  1  2  3]
 [ 4  5  6  7]
 [ 8  9 10 11]]
[[ 0  1  2  3  4  5]
 [ 6  7  8  9 10 11]]
[[ 0  4  8]
 [ 1  5  9]
 [ 2  6 10]
 [ 3  7 11]]
전체합  : 21
axis=0  : [5 7 9]
axis=1  : [ 6 15]
평균    : 3.5 최대: 6
행별 최대 위치: [2 2]
🔑 핵심 코드 2 — 신경망 순전파 y = xW + b — (2,) @ (2,3) → (3,)와 손 검산
📄 02_07_numpy.py L96–L111 · Block 5 (02-07-AB 원소별 연산 vs 행렬 곱 — 신경망 계산의 심장)
import numpy as np

x = np.array([1.0, 0.5])              # 입력 뉴런 2개
W = np.array([[0.1, 0.3, 0.5],        # 가중치 (2×3)
              [0.2, 0.4, 0.6]])
b = np.array([0.1, 0.2, 0.3])          # 편향 (출력 뉴런 3개)

y = np.dot(x, W) + b                   # 🔗 01-13의 z = xW + b !

print(f"입력 x  : {x}  shape {x.shape}")
print(f"가중치 W: shape {W.shape}")
print(f"출력 y  : {y}  shape {y.shape}")

# 손으로 검산해보기
print("\n[검산] y[0] = 1.0×0.1 + 0.5×0.2 + 0.1 =",
      round(1.0*0.1 + 0.5*0.2 + 0.1, 4))
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Linux · Python 3.13.5 · numpy 2.5.3, 앞 블록부터 순서대로 실행)
입력 x  : [1.  0.5]  shape (2,)
가중치 W: shape (2, 3)
출력 y  : [0.3 0.7 1.1]  shape (3,)

[검산] y[0] = 1.0×0.1 + 0.5×0.2 + 0.1 = 0.3
☁️ Colab에서 바로 실행
👉 Open in Colab — 02_07_numpy.ipynb · 설치 없이 브라우저에서 셀을 위에서부터 순서대로 실행하세요.
🖥️ 내 컴퓨터에서 실행하기
git clone https://github.com/otoloism/Zero_to_ML_Master.git
cd Zero_to_ML_Master
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r book/requirements.txt   # 책 전체용 (PyTorch 등 포함, 용량 큼)
# 이 장만 실행한다면 이것만으로 충분합니다: pip install numpy
cd book/02-hello-python/02-07-numpy
python 02_07_numpy.py
⭐ GitHub Star / Fork
⭐ 코드가 도움이 되셨다면 GitHub 저장소에 Star를 눌러 주세요. 새 장의 코드가 올라올 때 가장 먼저 알 수 있습니다.
🍴 직접 고쳐 보며 실험하고 싶다면 Fork 해서 내 저장소에서 마음껏 바꿔 보세요. 오류 제보·개선 제안은 Issues로 환영합니다!
🔮 다음 글 예고
다음 글은 #41 판다스(Pandas) 입문 — Series·DataFrame 만들기, CSV·엑셀 읽고 쓰기, loc·iloc·조건 필터까지 (02권 8부 1) 입니다. 세상의 데이터는 거의 전부 표 모양으로 들어옵니다. CSV·엑셀 파일을 열어 빈칸을 찾고, 자동 필터·피벗 테이블·VLOOKUP을 코드 한 줄로 대신하는 판다스를 배웁니다.
⬅️ 이전 글: #39 파이썬 예외 처리·모듈·파일 입출력·PEP8 — try·except부터 with open·import numpy as np·코드 컨벤션까지 (02권 6부) \
➡️ 다음 글: #41 판다스(Pandas) 입문 — Series·DataFrame 만들기, CSV·엑셀 읽고 쓰기, loc·iloc·조건 필터까지 (02권 8부 1)
📚 더 깊이 공부하고 싶다면
이 시리즈는 수학을 놓았던 비전공자가 AI를 직접 구현하기까지의 공부 기록을 그대로 옮긴 연재입니다. 원문 책, 코드, 개념 사전을 함께 보면 훨씬 빨리 늡니다. 🚀
| 바로가기 | 이런 분께 | |
|---|---|---|
| 📘 책 (위키독스, 무료) | Zero to 머신러닝 딥러닝 Master | 5권 · 20개 장 · 163개 절 전체를 순서대로 읽고 싶은 분 |
| 📄 이 글의 원문 | 02-07 🔢 7부 — NumPy: 딥러닝의 계산 엔진 | 연습문제·해설까지 전부 보고 싶은 분 |
| 💻 실습 코드 (GitHub) | otoloism/Zero_to_ML_Master | .py·.ipynb를 Colab에서 바로 돌려보고 싶은 분 |
| 🏠 머신러닝 백과사전 | mldict.net | 본문 속 핵심 개념을 카드로 다시 확인하고 싶은 분 |
| ✍️ 기술 블로그 | wikidocs.net/blog/@mldict | 새 글 알림을 가장 먼저 받고 싶은 분 |
⭐ 도움이 되셨다면 velog 팔로우와 GitHub Star를 눌러 주세요. 다음 글을 쓰는 가장 큰 힘이 됩니다. 궁금한 점은 댓글로 편하게 남겨 주세요! 🙌