Redshift 특징
- AWS에서 지원하는 데이터 웨어하우스 서비스
- 2 PB의 데이타까지 처리 가능
- 최소 160GB로 시작해서 점진적으로 용량 증감 가능 - Still OLAP
- 응답속도가 빠르지 않기 때문에 프로덕션 데이터베이스로 사용불가 - 컬럼 기반 스토리지
- 레코드 별로 저장하는 것이 아니라 컬럼별로 저장함
- 컬럼별 압축이 가능하며 컬럼을 추가하거나 삭제하는 것이 아주 빠름 - 벌크 업데이트 지원
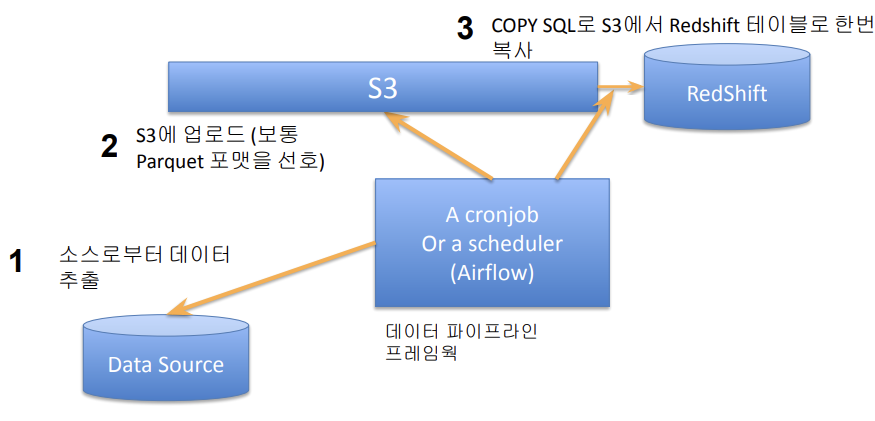
- 레코드가 들어있는 파일을 S3로 복사 후 COPY 커맨드로 Redshift로 일괄 복사 - 고정 용량/비용 SQL 엔진
- 최근 가변 비용 옵션도 제공 (Redshift Serverless) - 데이터 공유 기능 (Datashare):
- 다른 AWS 계정과 특정 데이터 공유 가능. Snowflake의 기능을 따라함 - 다른 데이터 웨어하우스처럼 primary key uniqueness를 보장하지 않음
- 프로덕션 데이터베이스들은 보장함
Redshift는 SQL 기반 관계형 데이터베이스
- Postgresql 8.x와 SQL이 호환됨
- 하지만 Postgresql 8.x의 모든 기능을 지원하지는 않음
- 예를 들어 text 타입이 존재하지 않음 - Postgresql 8.x를 지원하는 툴이나 라이브러리로 액세스 가능
- JDBC/ODBC - 다시 한번 SQL이 메인 언어라는 점 명심
- 그래서 데이터 모델링(테이블 디자인)이 아주 중요
Redshift의 스케일링 방식
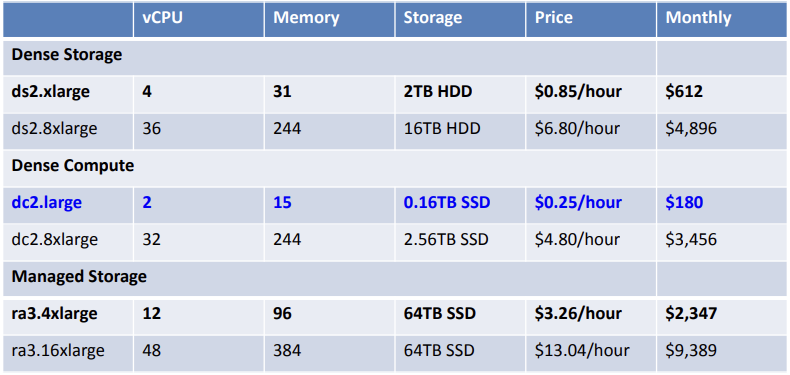
- 용량이 부족해질 때마다 새로운 노드를 추가하는 방식으로 스케일링
- 예) Scale Out 방식과 Scale Up 방식
- dc2.large가 하나면 최대 0.16TB까지의 용량을 갖게됨
- 공간이 부족해지면
-> dc2.large 한대를 더 추가 -> 총 0.32TB (Scale Out)
-> 아니면 사양을 더 좋은 것으로 업그레이드 -> dc2.8xlarge 한대로 교체 (Scale Up) - 이를 Resizing이라 부르며 Auto Scaling 옵션을 설정하면 자동으로 이뤄짐
- 이는 Snowflake나 BigQuery의 방식과는 굉장히 다름
- 여기서는 특별히 용량이 정해져있지 않고 쿼리를 처리하기 위해 사용한 리소스에 해당하는
비용 지불
-> 즉 Snowflake와 BigQuery가 훨씬 더 스케일하는 데이터베이스 기술이라 볼 수 있음
-> 장단점 존재 -> 비용의 예측이 불가능하다는 단점 존재 - Redshift에도 가변비용 옵션 존재 -> Redshift Serverless
- 뒤에 데모에서는 Redshift Serverless를 사용해볼 예정 (Pay as You Go)
Redshift 최적화는 굉장히 복잡
- Redshift가 두 대 이상의 노드로 구성되면 한 테이블의 레코드들의 저장방식은?
- 분산 저장되어야함
- 또 한 노드 내에서는 순서가 정해주어야함
Redshift의 레코드 분배와 저장 방식
Redshift가 두 대 이상의 노드로 구성되면 그 시점부터 테이블 최적화가 중요
- 한 테이블의 레코드들을 어떻게 다수의 노드로 분배할 것이냐!
Distkey, Diststyle, Sortkey 세 개의 키워드를 알아야함
- Diststyle은 레코드 분배가 어떻게 이뤄지는지를 결정
- all, even, key (디폴트는 “even”) - Distkey는 레코드가 어떤 컬럼을 기준으로 배포되는지 나타냄 (diststyle이 key인 경우)
- Sortkey는 레코드가 한 노드내에서 어떤 컬럼을 기준으로 정렬되는지 나타냄
- 이는 보통 타임스탬프 필드가 됨
Diststyle이 key인 경우 컬럼 선택이 잘못되면?
- 레코드 분포에 Skew가 발생 -> 분산처리의 효율성이 사라짐
- BigQuery나 Snowflake에서는 이런 속성을 개발자가 지정할 필요가 없음 (시스템이 알아서 선택)
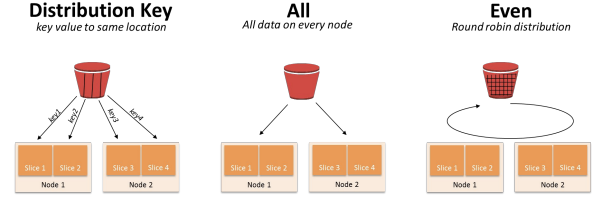
Redshift의 레코드 분배와 저장 방식 예
CREATE TABLE my_table (
 column1 INT,
 column2 VARCHAR(50),
 column3 TIMESTAMP,
 column4 DECIMAL(18,2)
) DISTSTYLE KEY DISTKEY(column1) SORTKEY(column3);
-- my_table의 레코드들은 column1의 값을 기준으로 분배되고 같은 노드(슬라이스)안에서는 column3의 값을 기준으로 소팅이 됨
Redshift의 벌크 업데이트 방식 - COPY SQL
Redshift의 기본 데이터 타입
• SMALLINT (INT2)
• INTEGER (INT, INT4)
• BIGINT (INT8)
• DECIMAL (NUMERIC)
• REAL (FLOAT4)
• DOUBLE PRECISION (FLOAT8)
• BOOLEAN (BOOL)
• CHAR (CHARACTER)
• VARCHAR (CHARACTER VARYING)
• TEXT (VARCHAR(256))
• DATE
• TIMESTAMP
Redshift의 고급 데이터 타입
• GEOMETRY
• GEOGRAPHY
• HLLSKETCH
• SUPER
Redshift 초기 설정
Redshift Schema: 다른 기타 관계형 데이터베이스와 동일한 구조
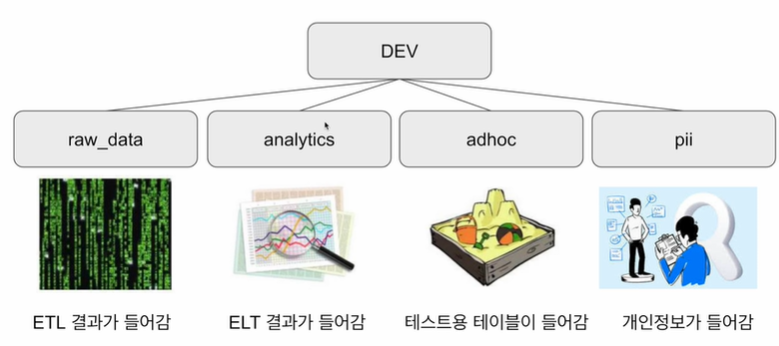
스키마(Schema) 설정
- 모든 스키마를 리스트하기: select * from pg_namespace;
CREATE SCHEMA raw_data;
CREATE SCHEMA analytics;
CREATE SCHEMA adhoc;
CREATE SCHEMA pii;
사용자(User) 생성
- 모든 사용자를 리스트하기: select * from pg_user;
CREATE USER keeyong PASSWORD '...';그룹(Group) 생성/설정
-
한 사용자는 다수의 그룹에 속할 수 있음
-
그룹의 문제는 계승이 안된다는 점
- 즉 너무 많은 그룹을 만들게 되고 관리가 힘들어짐 -
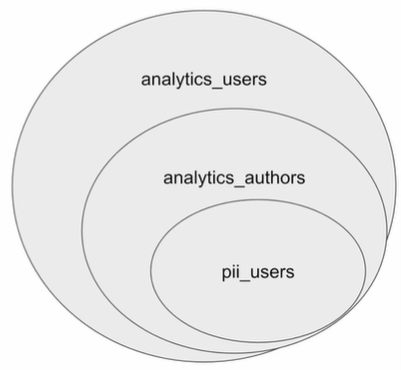
예를 들어 다음과 같은 그룹이 존재
- 어드민을 위한 pii_users
- 데이터 분석가를 위한 analytics_authors
- 데이터 활용을 하는 개인을 위한 analytics_users
-
그룹 생성 - CREATE GROUP
-
그룹에 사용자 추가 - ALTER GROUP 그룹이름 ADD USER 사용자이름
-
그룹에 스키마/테이블 접근 권한 설정 (나중에 설명)
-
모든 그룹을 리스트하기: select * from pg_group;
CREATE GROUP analytics_users;
CREATE GROUP analytics_authors;
CREATE GROUP pii_users;
ALTER GROUP analytics_authors ADD USER keeyong;
ALTER GROUP analytics_users ADD USER keeyong;
ALTER GROUP pii_users ADD USER keeyong;
역할(Role) 생성/설정
- 역할은 그룹과 달리 계승 구조를 만들 수 있음
- 역할은 사용자에게 부여될 수도 있고 다른 역할에 부여될 수도 있음
- 한 사용자는 다수의 역할에 소속가능함
- 모든 역할을 리스트하기: select * from SVV_ROLES;
CREATE ROLE staff;
CREATE ROLE manager;
CREATE ROLE external;
GRANT ROLE staff TO keeyong;
GRANT ROLE staff TO ROLE manager;
새싹 개발자