데이터 팀의 역할
데이터 조직의 비전은?
- 신뢰할 수 있는 데이터를 바탕으로 부가 가치 생성
- Data is the new oil? (데이터가 새로운 석유다)
- 데이터의 중요성을 강조하니 데이터 팀도 회사에서 인정을 받는다? (매출에 기여를 해야 인정을 받음)
데이터 조직이 하는 일
-
고품질 데이터를 기반으로 의사 결정권자에게 입력 제공 (데이터 분석가)
- 결정 과학 (Decision Science)라고 부르기도 함.
- 데이터를 고려한 결정(data informed decisions)을 가능하게 해줌
vs. 데이터 기반 결정(data driven decisions)
- 예를 들면 데이터 기반 지표 정의, 대시보드와 리포트 생성 등을 수행 -
고품질 데이터를 기반으로 사용자 서비스 경험 개선 혹은 프로세스 최적화 (Product Science)
- 머신 러닝과 같은 알고리즘을 통해 사용자의 서비스 경험을 개선
예) 개인화를 바탕으로한 추천과 검색 기능 제공
- 공장이라면 공정 과정에서 오류를 최소화하는 일을 수행
데이터의 흐름과 데이터 팀의 발전 단계
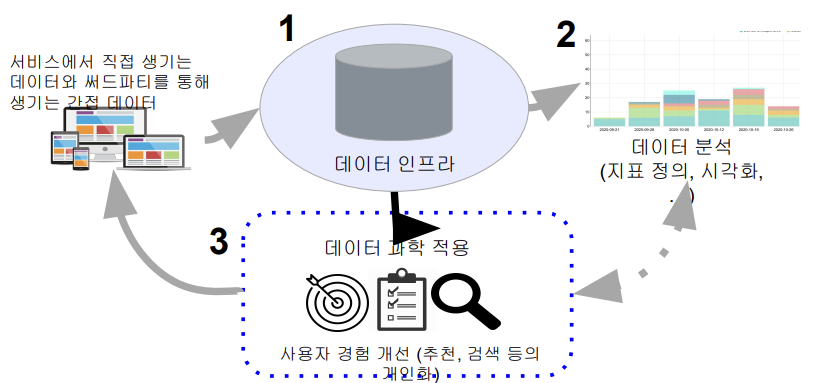
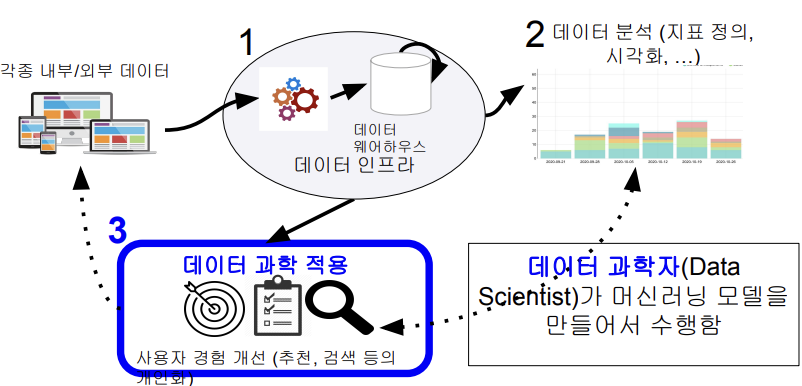
데이터 팀의 발전 - 1. 데이터 인프라 구축
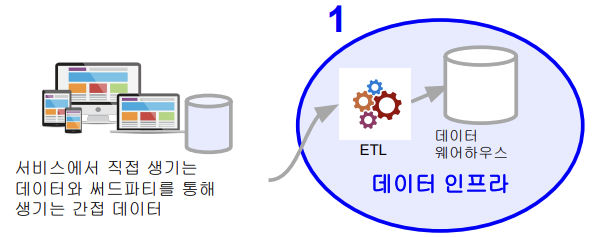
데이터 인프라의 구축은 데이터 엔지니어가 수행함
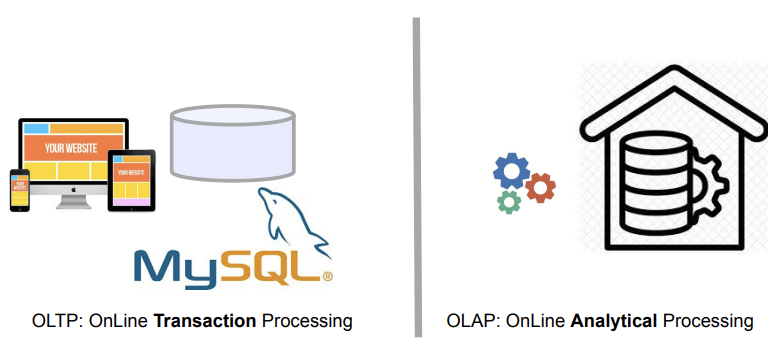
프로덕션 데이터베이스 vs. 데이터 웨어하우스
데이터 웨어하우스
-
회사에 필요한 모든 데이터를 모아놓은 중앙 데이터베이스 (SQL 데이터베이스)
- 데이터의 크기에 맞게 어떤 데이터베이스를 사용할지 선택
- 크기가 커진다면 다음 중 하나를 선택▪ AWS Redshift, 구글 클라우드의 BigQuery
▪ 스노우플레이크(Snowflake)
▪ 오픈소스 기반의 하둡(Hive/Presto)/스팍
▪ 이 모두 SQL을 지원 -
중요 포인트는 프로덕션용 데이터베이스와 별개의 데이터베이스여야 한다는 점
-
데이터 웨어하우스의 구축이 진정한 데이터 조직이 되는 첫 번째 스텝
ETL(Extract, Transform, Load)이란?
- 다른 곳에 존재하는 데이터를 가져다가 데이터 웨어하우스에 로드하는 작업
- Extract: 외부 데이터 소스에서 데이터를 추출
- Transform: 데이터의 포맷을 원하는 형태로 변환
- Load: 변환된 데이터를 최종적으로 데이터 웨어하우스로 적재
- 데이터 파이프라인이라고 부르기도 함 - 관련하여 가장 많이 쓰이는 프레임웍은 Airflow
- Airflow는 오픈소스 프로젝트로 파이썬 3 기반이며 Airbnb에서 시작
- AWS와 구글 클라우드에서도 지원 - ETL 관련 SaaS (Software as a Service)도 출현하기 시작
- 흔한 데이터 소스의 경우 FiveTran, Stitch Data와 같은 SaaS를 사용하는 것도 가능
데이터 팀의 발전 - 2. 데이터 분석 수행
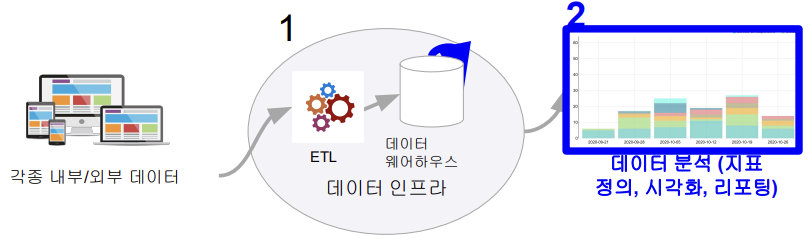
이는 데이터 분석가 (Data Analyst)가 맡는 일임
시각화 대시보드란?
- 보통 중요한 지표를 시간의 흐름과 함께 보여주는 것이 일반적
- 지표의 경우 3A(Accessible, Actionable, Auditable)가 중요
- 중요 지표의 예: 매출액, 월간/주간 액티브 사용자수, ... - 가장 널리 사용되는 대시보드:
- 구글 클라우드의 룩커(Looker)
- 세일즈포스의 태블로 (Tableau)
- 마이크로소프트의 파워 BI(Power BI)
- 오픈소스 아파치 수퍼셋(Superset)
데이터 팀의 발전 - 3. 데이터 과학 적용
머신 러닝(Machine Learning)이란?
- (프로그래밍 없이) 배움이 가능한 알고리즘 -> 블랙박스
- A field of study that gives computers the ability to learn without being explicitly programmed’ (Arthur Samuel) - 데이터로부터 패턴을 찾아 학습
- 데이터의 품질과 크기가 중요
- 데이터로 인한 왜곡 (bias) 발생 가능
AI 윤리
- 내부동작 설명 가능 여부도 중요
ML Explainability
데이터 조직의 구성원
데이터 팀에는 누가 있는가?
- 작은 회사에서는 한 사람이 몇 개의 역할을 동시 수행하는 것이 일반적
- 데이터 엔지니어 (Data Engineer)
- 데이터 인프라 (데이터 웨어하우스와 ETL) 구축 - 데이터 분석가 (Data Analyst)
- 데이터 웨어하우스의 데이터를 기반으로 지표를 만들고 시각화 (대시보드)
- 내부 직원들의 데이터 관련 질문 응답 - 데이터 과학자 (Data Scientist)
- 과거 데이터를 기반으로 미래를 예측하는 머신러닝 모델을 만들어 고객들의 서비스 경험을 개선 (개인화 혹은 자동화 혹은 최적화)
데이터 엔지니어의 역할
- 기본적으로는 소프트웨어 엔지니어
- 파이썬이 대세. 자바 혹은 스칼라와 같은 언어도 아는 것이 좋음 - 데이터 웨어하우스 구축
- 데이터 웨어하우스를 만들고 이를 관리. 클라우드로 가는 것이 추세
AWS의 Redshift, 구글클라우드의 BigQuery, 스노우플레이크
- 관련해서 중요한 작업중의 하나는 ETL 코드를 작성하고 주기적으로 실행해주는 것
ETL 스케줄러 혹은 프레임웍이 필요 (Airflow라는 오픈소스가 대세) - 데이터 분석가와 과학자 지원
- 데이터 분석가, 데이터 과학자들과의 협업을 통해 필요한 툴이나 데이터를
제공해주는 것이 데이터 엔지니어의 중요한 역할 중의 하나
데이터 엔지니어가 알아야하는 기술
- SQL: 기본 SQL, Hive, Presto, SparkSQL, …
- 프로그래밍 언어: 파이썬, 스칼라, 자바
- 데이터 웨어하우스
- Redshift/Snowflake/BigQuery - ETL/ELT 프레임웍: Airflow, …
- 대용량 데이터 처리 플랫폼: Spark/YARN
- 컨테이너 기술 - Docker/K8s
- 클라우드 컴퓨팅
- AWS, GCP, Azure - 도움이 되는 기타 지식
- 머신 러닝 일반
- A/B 테스트, 통계 - 데이터 엔지니어 스킬 로드맵
- https://github.com/datastacktv/data-engineer-roadmap
- MLOps 혹은 ML Engineer가 다음 스텝이 많이 됨
데이터 분석가의 역할
비지니스 인텔리전스를 책임짐 (의사결정을 객관적이고 과학적이도록)
- 중요 지표를 정의하고 이를 대시보드 형태로 시각화
- 대시보드로는 태블로(Tableau)와 룩커(Looker)등의 툴이 가장 흔히 사용됨
- 오픈소스로는 수퍼셋(Superset)이 많이 사용됨 - 이런 일을 수행하려면 비지니스 도메인에 대한 깊은 지식이 필요
회사내 다른 팀들의 데이터 관련 질문 대답
- 임원들이나 팀 리드들이 데이터 기반 결정을 내릴 수 있도록 도와줌
- 질문들이 굉장히 많고 반복적이기에 어떻게 셀프서비스로 만들 수 있느냐가 관건
데이터 분석가가 알아야하는 기술
- SQL: 기본 SQL, Hive, Presto, SparkSQL, …
- 대시보드
- 룩커, 태블로, 파워 BI, 수퍼셋
- 엑셀, 구글 스프레드시트, 파이썬 - 데이터 모델링
- 통계 지식
- AB 테스트 분석 혹은 다양한 데이터 분석에서 통계 지식은 아주 유용함 - 비지니스 도메인에 관한 깊은 지식
- 좋은 지표를 정의하는 능력
- 보통 코딩을 하지는 않음 (추세는 데이터 엔지니어링 적인 지식이 있으면 좋음, DBT)
데이터 분석가의 딜레마
- 보통 많은 수의 긴급한 데이터 관련 질문들에 시달림
- 좋은 데이터 인프라 없이는 일을 잘 하기 힘듬!
- 많은 경우 현업팀에 소속되기도 함
- 내 커리어에서 다음은 무엇인가?
- 소속감이 불분명하고 내 고과 기준이 불명확해짐 - 데이터 분석가의 경우 조직 구조가 더 중요함
어떤 새로운 직군들 혹은 뜨는 서비스들이 있는가?
- ML 엔지니어 (vs. 데이터 과학자 & 데이터 엔지니어)
- ML옵스 (MLOps)
- 프라이버시 엔지니어: 개인정보 보호
- 데이터 디스커버리 서비스
MLOps란 무슨 일을 하는가?
DevOps가 하는 일은?
- 개발자가 만든 코드를 시스템에 반영하는 프로세스 (CI/CD, deployment)
- 시스템이 제대로 동작하는지 모니터링 그리고 이슈 감지시 escalation 프로세스
- On-call 프로세스
MLOps가 하는 일은?
- 앞의 DevOps가 하는 일과 동일. 차이점은 서비스 코드가 아니라 ML 모델이 대상
- 모델을 계속적으로 빌딩하고 배포하고 성능을 모니터링
- ML모델 빌딩과 프로덕션 배포를 자동화할 수 있을까? 계속적인 모델 빌딩(CT)과 배포!
- 모델 서빙 환경과 모델의 성능 저하를 모니터링하고 필요시 escalation 프로세스 진행
MLOps 엔지니어가 알아야하는 기술
데이터 엔지니어가 알아야 하는 기술
- 파이썬/스칼라/자바
- 데이터 파이프라인과 데이터 웨어하우스
DevOps 엔지니어가 알아야 하는 기술
- CI/CD, 서비스 모니터링, …
- 컨테이너 기술 (K8S, 도커)
- 클라우드 (AWS, GCP, Azure)
머신러닝 관련 경험/지식
- 머신러닝 모델 빌딩과 배포
- ML 모델 빌딩 프레임웍 경험
- SageMaker, Kubeflow, MLflow
프라이버시 엔지니어
전체 시스템에서 개인정보 보호를 위한 가이드라인/툴을 제공
- 개인정보란? 개인을 식별할 수 있는 정보
이는 데이터 시스템에서 더욱 중요
개인 정보 보호 법안의 징벌 조항이 점점 강화되는 추세
- 정보 주체의 권리를 강화하는 방향으로도 변화: GDPR의 프로파일링 거부권
- 유럽 연합의 GDPR (General Data Protection Regulation)
- 미국의 HIPAA (건강보험 이전 및 책임에 관한 법률)
- 미국 캘리포니아의 CCPR (캘리포니아 소비자 개인정보 보호 법안)
데이터 디스커버리 (Data Discovery)란?
- 별도 직군은 아니지만 데이터 팀이 커지면 꼭 필요한 서비스
- 데이터가 커지면 테이블과 대시보드의 수도 증가!
- 데이터 분석시 어느 테이블이나 대시보드를 봐야하는지 혼란이 생김
-> 그러면 에라 모르겠다 직접 새로운 테이블이나 대시보드를 또 만들어냄
-> 정보 과잉 문제가 더 심해지는 악순환!
- 주기적인 테이블과 대시보드 클린업이 필수! - 테이블과 대시보드 관련 검색 서비스!
- 리프트에서 만든 아문센
- 링크드인에서 만든 데이터허브
- 셀렉트스타
데이터 웨어하우스와 데이터 레이크와 ETL/ELT
데이터 웨어하우스 옵션별 장단점
- 데이터 웨어하우스는 기본적으로 클라우드가 대세
- 데이터가 커져도 문제가 없는 확장가능성(Scalable)과 적정한 비용이 중요한 포인트
- 크게 고정비용 옵션과 가변비용 옵션이 존재하며 후자가 좀더 확장가능한 옵션
- AWS의 Redshift, 구글 클라우드의 BigQuery, 스노우플레이크(Snowflake)
- Redshift는 고정비용 옵션이며 BigQuery와 스노우플레이크는 가변비용 - 오픈소스 기반(Presto, Hive)을 사용하는 경우도 클라우드 버전 존재
- 데이터가 작다면 굳이 빅데이터 기반 데이터베이스를 사용할 필요가 없음
데이터 레이크
- 구조화 데이터 + 비구조화 데이터 (로그 파일)
- 보존 기한이 없는 모든 데이터를 원래 형태대로 보존하는 스토리지에 가까움
- 보통은 데이터 웨어하우스보다 몇 배는 더 크고 더 경제적인 스토리지
- 보통 클라우드 스토리지가 됨
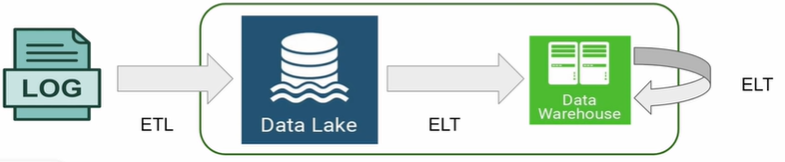
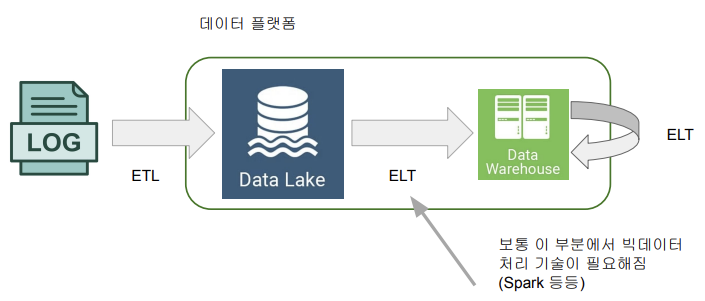
- AWS라면 S3가 대표적인 데이터 레이크라 볼 수 있음 - 데이터 레이크가 있는 환경에서 ETL과 ELT
- 데이터 레이크와 데이터 웨어하우스 바깥에서 안으로 데이터를 가져오는 것: ETL
- 데이터 레이크와 데이터 웨어하우스 안에 있는 데이터를 처리하는 것: ELT
ETL(Extract, Transform, Load) -> ELT
ETL의 수는 회사의 성장에 따라 쉽게 100+개 이상으로 발전
- 중요한 데이터를 다루는 ETL이 실패했을 경우 이를 빨리 고쳐서 다시 실행하는 것이 중요
- 이를 적절하게 스케줄하고 관리하는 것이 중요해지며 그래서 ETL 스케줄러 혹은 프레임웍이
필요해짐
- Airflow가 대표적인 프레임웍
데이터 요약를 위한 ETL도 필요해짐 -> ELT라고 부름
- 앞에서 설명한 ETL은 다양한 데이터 소스에 있는 데이터를 읽어오는 일을 수행.
- 하지만 이를 모두 이해해서 조인해서 사용하는 것은 데이터가 다양해지고 커지면서 거의
불가능해짐. - 주기적으로 요약 데이터를 만들어 사용하는 것이 더 효율적. dbt 사용
- 예) 고객 매출 요약 테이블, 제품 매출 요약 테이블, …
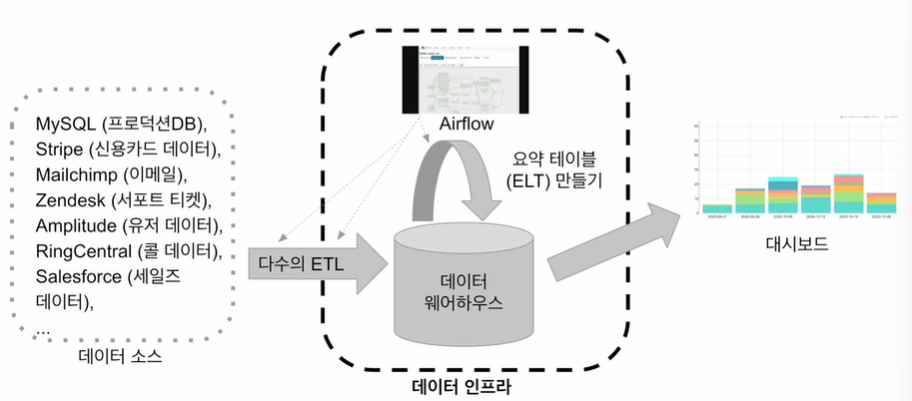
다양한 데이터 소스의 예
- 프로덕션 데이터베이스(웹/앱에서 사용하는 데이터베이스)의 데이터
- 보통 MySQL, Postgres등이 프로덕션 데이터베이스로 사용됨 - 이메일 마케팅 데이터
- Mailchimp, HubSpot, SendGrid, ... - 크레딧카드 매출 데이터
- Stripe - 서포트 티켓 데이터
- Zendesk, Kustomer, ... - 서포트 콜 데이터
- ChannelTalk, RingCentral, Talkdesk, … - 세일즈 데이터
- Salesforce - 사용자 이벤트 로그
- Amplitude, MixPanel, 웹서버로그, ...
Airflow (ETL 스케줄러) 소개
- ETL 관리 및 운영 프레임웍의 필요성
- 다수의 ETL이 존재할 경우 이를 스케줄해주고 이들간의 의존관계(dependency)를 정의해주는기능 필요
- 특정 ETL이 실패할 경우 이에 관한 에러 메세지를 받고 재실행해주는 기능도 중요해짐 (Backfill - 데이터 엔지니어한테는 악몽) - 가장 많이 사용되는 프레임웍은 Airflow
- Airflow는 오픈소스 프로젝트로 파이썬 3 기반이며 에어비앤비, 우버, 리프트, 쿠팡등에서 사용
AWS와 구글클라우드와 Azure에서도 지원
- Airflow에서는 ETL을 DAG라 부르며 웹 인터페이스를 통한 관리 기능 제공
- 크게 3가지 컴포넌트로 구성됨: 스케줄러, 웹서버, 워커 (Worker)
데이터 웨어하우스의 구성 예
ELT
- ETL: 데이터를 데이터 웨어하우스 외부에서 내부로 가져오는 프로세스
- 보통 데이터 엔지니어가 이를 수행함 - ELT: 데이터 웨어하우스 내부 데이터를 조작해서 (보통은 좀더 추상화되고 요약된) 새로운 데이터를 만드는 프로세스
- 이런 프로세스 전용 기술들이 있으며 dbt가 가장 유명: Analytics Engineering
- 보통 데이터 분석가가 이를 수행함
- 이 경우 데이터 레이크를 쓰기도 함
데이터 레이크를 포함한 데이터 플랫폼 아키덱처
빅데이터 처리 프레임웍
- 분산 환경 기반 (1대 혹은 그 이상의 서버로 구성)
- 분산 파일 시스템과 분산 컴퓨팅 시스템이 필요 (2개의 컴포넌트) - Fault Tolerance
- 소수의 서버가 고장나도 동작해야함 - 확장이 용이해야함
- Scale Out이 되어야함
- 용량을 증대하기 위해서 서버 추가
대표적 빅데이터 프로세싱 시스템
- 1 세대 -> 하둡 기반의 Mapreduce, Hive/Presto
- 2 세대 -> Spark (SQL, DataFrame, Streaming, ML, Graph)
데이터 웨어하우스 옵션들
살펴볼 옵션들
- AWS Redshift
- Snowflake
- Google Cloud BigQuery
- Apache Hive
- Apache Presto
- Apache Iceberg (스토리지이고 Spark이랑 같이쓰면 웨어하우스라고 할 수 있음)
- Apache Spark
- 이 옵션들의 공통점은?
- Iceberg를 제외하고는 모두 SQL을 지원하는 빅데이터 기반 데이터베이스
AWS Redshift
- 2012년에 시작된 AWS 기반의 데이터웨어하우스로 PB 스케일 데이터 분산
처리 가능
- Postgresql과 호환되는 SQL로 처리 가능하게 해줌
- Python UDF (User Defined Function)의 작성을 통해 기능 확장 가능
- 처음에는 고정비용 모델로 시작했으나 이제는 가변비용 모델도 지원 (Redshift Serverless)
- 온디맨드 가격 이외에도 예약 가격 옵션도 지원 - CSV, JSON, Avro, Parquet 등과 같은 다양한 데이터 포맷을 지원
- AWS내의 다른 서비스들과 연동이 쉬움
- S3, DynamoDB, SageMaker 등등
ML 모델의 실행도 지원 (SageMaker)
- Redshift의 기능 확장을 위해 Redshift Spectrum, AWS Athena등의 서비스와 같이 사용 가능 - 배치 데이터 중심이지만 실시간 데이터 처리 지원
- 웹 콘솔 이외에도 API를 통한 관리/제어 가능
Snowflake
- 2014년에 클라우드 기반 데이터웨어하우스로 시작됨 (2020년 상장)
- 지금은 데이터 클라우드라고 부를 수 있을 정도로 발전
- 데이터 판매를 통한 매출을 가능하게 해주는 Data Sharing/Marketplace 제공- ETL과 다양한 데이터 통합 기능 제공
- SQL 기반으로 빅데이터 저장, 처리, 분석을 가능하게 해줌
- 비구조화된 데이터 처리와 머신러닝 기능 제공 - CSV, JSON, Avro, Parquet 등과 같은 다양한 데이터 포맷을 지원
- S3, GC 클라우드 스토리지, Azure Blog Storage도 지원 - 배치 데이터 중심이지만 실시간 데이터 처리 지원
- 웹 콘솔 이외에도 API를 통한 관리/제어 가능
Apache Hive
- Facebook이 2008년에 시작한 아파치 오픈소스 프로젝트
- 하둡 기반으로 동작하는 SQL 기반 데이터 웨어하우스 서비스
- HiveQL이라 부르는 SQL 지원
- MapReduce위에서 동작하는 버전과 Apache Tez를 실행 엔진으로 동작하는 버전 두 가지가 존재
- 다른 하둡 기반 오픈소스들과 연동이 쉬움 (Spark, HBase 등등)
- 자바나 파이썬으로 UDF 작성 가능 - CSV, JSON, Avro, Parquet 등과 같은 다양한 데이터 포맷을 지원
- 배치 빅데이터 프로세싱 시스템
- 데이터 파티셔닝과 버킷팅과 같은 최적화 작업 지원
- 빠른 처리속도 보다는 처리할 수 있는 데이터 양의 크기에 최적화 - 웹 UI와 커맨드라인 UI (CLI라고 부름) 두 가지를 지원
- 점점 Spark에 의해 밀리는 분위기임
Apache Presto
- Facebook이 2013년에 시작한 아파치 오픈소스 프로젝트
- 다양한 데이터소스에 존재하는 데이터를 대상으로 SQL 실행 가능
- HDFS (Hadoop Distributed File System), S3, Cassandra, MySQL 등등
- PrestoSQL이란 부르는 SQL 지원 - CSV, JSON, Avro, ORC, Parquet 등과 같은 다양한 데이터 포맷을 지원
- 배치 빅데이터 프로세싱 시스템
- Hive와는 다르게 빠른 응답 속도에 좀더 최적화 (메모리 기반) - 웹 UI와 커맨드라인 UI (CLI라고 부름) 두 가지를 지원
- AWS Athena가 바로 Presto를 기반으로 만들어짐
Apache Iceberg
- Netflix가 2018년에 시작한 아파치 오픈소스 프로젝트로 데이터 웨어하우스 기술이 아님
- 대용량 SCD (Slowly-Changing Datasets) 데이터를 다룰 수 있는 테이블 포맷
- HDFS, S3, Azure Blob Storage 등의 클라우드 스토리지 지원
- ACID 트랙잭션과 타임여행 (과거 버전으로 롤백과 변경 기록 유지 등등)
- 스키마 진화 (Schema Evolution) 지원을 통한 컬럼 제거와 추가 가능 (테이블 재작성 없이) - 자바와 파이썬 API를 지원
- Spark, Flink, Hive, Hudi 등의 다른 Apache 시스템과 연동 가능
Apache Spark
- UC 버클리 AMPLab이 2013년에 시작한 아파치 오픈소스 프로젝트
- 빅데이터 처리 관련 종합선물세트
- 배치처리(API/SQL), 실시간처리, 그래프처리, 머신러닝 기능 제공 - 다양한 분산처리 시스템 지원
- 하둡(YARN), AWS EMR, Google Cloud Dataproc, Mesos, K8s 등등 - 다양한 파일시스템과 연동 가능
- HDFS, S3, Cassandra, HBase 등등 - CSV, JSON, Avro, ORC, Parquet 등과 같은 다양한 데이터 포맷을 지원
- 다양한 언어 지원: 자바, 파이썬, 스칼라, R
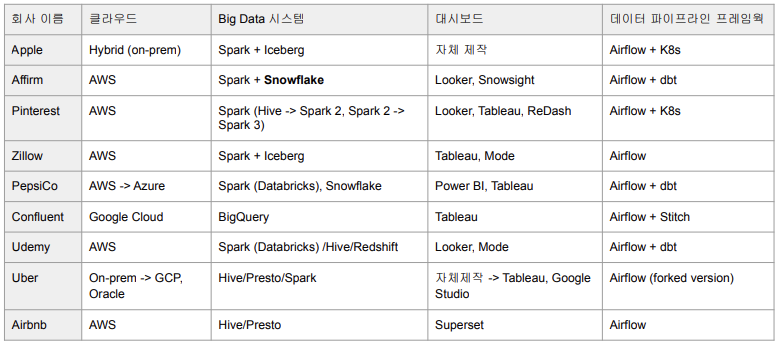
실리콘밸리 회사들의 데이터 스택 트렌드
데이터 플랫폼의 발전단계
- 초기 단계: 데이터 웨어하우스 + ETL
- 이미 앞에서 살펴봄 - 발전 단계: 데이터 양 증가
- Spark과 같은 빅데이터 처리시스템 도입
- 데이터 레이크 도입 - 성숙 단계: 데이터 활용 증대
- 현업단의 데이터 활용이 가속화
- ELT 단이 더 중요해지면서 dbt 등의 analytics engineering 도입
- MLOps 등 머신러닝 관련 효율성 증대 노력 증대
발전 단계: 데이터 양 증가
Spark과 같은 빅데이터 처리시스템 도입
데이터 레이크 도입: 보통 로그 데이터와 같은 대용량 비구조화 데이터 대상
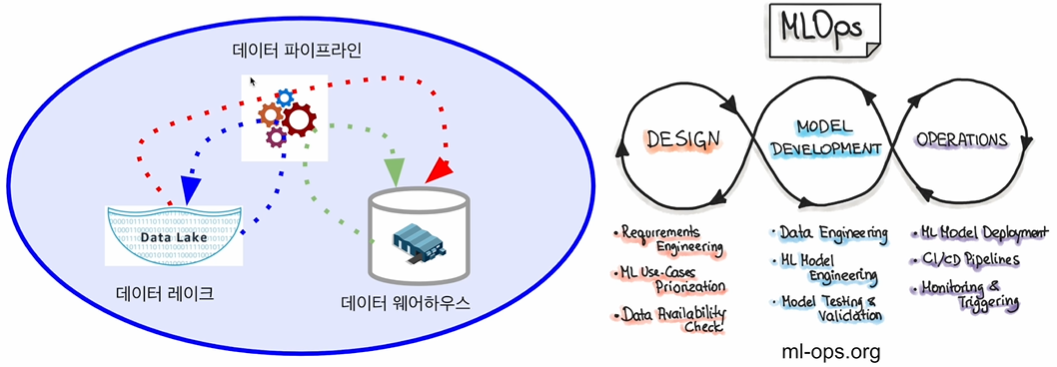
- 데이터 소스 -> 데이터 파이프라인 -> 데이터 웨어하우스
- 데이터 소스 -> 데이터 파이프라인 -> 데이터 레이크
- 데이터 레이크 -> 데이터 파이프라인 -> 데이터 웨어하우스
- 이때 Spark/Hadoop 등이 사용됨
- Hadoop: Hive/Presto등이 기반됨
성숙 단계: 현업단의 데이터 활용 가속화
- ELT단이 더 중요해지면서 dbt 등의 analytics engineering 도입
- 데이터 레이크 to 데이터 레이크, 데이터 레이크 to 데이터 웨어하우스, 데이터 웨어하우스 to 데이터 웨어하우스 - MLOps 등 머신러닝 개발 운영 관련 효율성 증대 노력 증대
실리콘밸리 회사 데이터 스택 비교

새싹 개발자