1강 안녕 자료구조 & 알고리즘!
자료구조 (Data structures)
자료형 (Data Type) : 문자열(str), 리스트 (list), 사전 (dict), 순서쌍(tuple), 집합(set), ...
Python에서 제공하는 데이터 타입으로 다 해결할 수 있을 것 같은데 "자료구조" 라는 것은, 도대체 왜 알아야 하는 거지?
효과적으로 해결해야하는 문제가 무엇인지에 따라서 이용하는 자료구조의 성질이 다르다.
자료구조를 만들어서 사용하면 걸리는 시간을 줄일 수 있다.
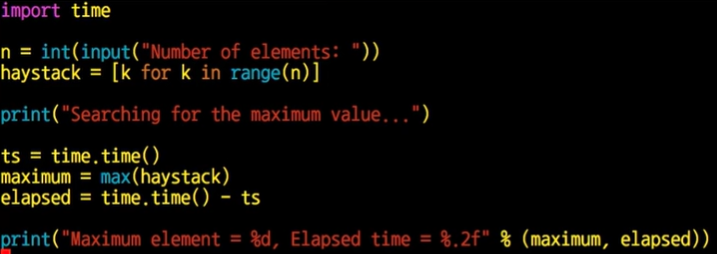
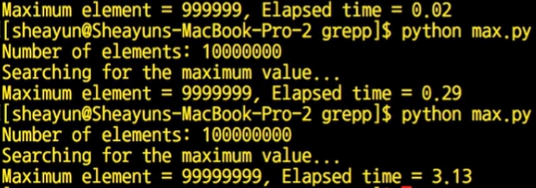
크기가 큰 리스트에서 최대값을 찾는 코드 실행 결과, 갯수에 비례하게 시간이 증가한다.
알고리즘 (Algorithm)
사전적 정의 : 어떤 문제를 해결하기 위한 절차, 방법, 명령어들의 집합
프로그래밍 : 주어진 문제의 해결을 위한 자료구조와 연산 방법에 대한 선택
2강 선형 배열 (Linear Array)
Python에서는 서로 다른 종류의 데이터도 줄세울 수 있는 리스트 (list)라는 데이터형이 있습니다.
Python의 리스트에 활용할 수 있는 연산들
원소 덧붙이기 : append()
원소 하나를 꺼내기 : pop()
-> 리스트 길이와 상관 없음, O(1), 상수 시간
원소 삽입하기 : insert()
원소 삭제하기 : del()
-> 리스트 길이에 비례, O(n), 선형 시간
추가 다른 연산
원소 탐색하기 : index()
-> O(n)
정렬된 리스트에 원소 삽입
def solution(L, x):
    answer = []
    index = 0
    for i in range(len(L)):
        if L[i] > x:
            index = i
            break
        elif i == len(L)-1:
            index = i+1
    L.insert(index,x)
    answer = L
    return answer
리스트에서 원소 찾아내기
def solution(L, x):
    answer = []
    while x in L:
        i = L.index(x)
        if answer:
            answer.append(i + answer[-1]+1)
        else: answer.append(i)
        L = L[i+1:]
    if not answer:
        answer.append(-1)
    return answer
3강 정렬(Sort), 탐색(Search)
Python 리스트의 정렬
- sorted() : 내장함수, 정렬된 새로운 리스트를 얻어냄
- sort() : 리스트의 메서드, 해당 리스트를 정렬함
정렬의 순서를 반대로
ex)
L2 = sorted(L, reverse=True)
L.sort(reverse=True)
문자열로 이루어진 리스트의 경우 정렬 순서는 사전 순서를 따름
문자열 길이 순서로 정렬하려면?
-> 정렬에 이용하는 키(key) 설정
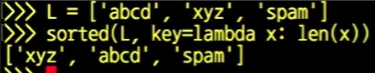
키를 지정하는 또 다른 예
L = [{'name' : 'John' , 'score' : 83},{'name' : 'Paul' , 'score' : 92}]
L.sort(key = lambda x: x['name'])

-> 레코드들을 이름 순서대로 정렬
L = [{'name' : 'John' , 'score' : 83},{'name' : 'Paul' , 'score' : 92}]
L.sort(key = lambda x: x['score'], reverse = True)
-> 레코드들을 점수 높은 순으로 정렬탐색 알고리즘 1 - 선형 탐색 (Linear Search)
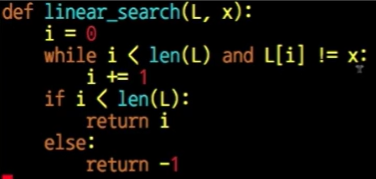
일렬로 나열된 자료를 왼쪽부터 오른쪽으로 차례대로 탐색
리스트 길이에 비례하는 시간 소요, O(n), 선형 시간
최악의 경우 모든 원소를 다 비교
탐색 알고리즘 2 - 이진 탐색 (Binary Search)
탐색하려는 리스트가 이미 정렬되어 있는 경우에만 적용 가능
크기 순으로 정렬되어 있다는 성질 이용
한 번의 비교가 일어날 때마다 리스트 반씩 줄임(divide & conquer), O(logn)
이진탐색
def solution(L, x):
    answer = -1
    lower = 0
    upper = len(L)-1
    while lower <= upper:
        middle = (upper + lower)//2
        if L[middle]==x:
            answer = middle
            break
        elif L[middle]>x:
            upper = middle-1
        else:
            lower = middle+1
    return answer
4강 재귀 알고리즘 기초 (Recursive Algorithms)
재귀함수(recursive functions)란?
하나의 함수에서 자신을 다시 호출하여 작업을 수행하는것
생각보다 많은 종류의 문제가 재귀적으로 해결가능
ex) 이진트리(binary trees)
왼쪽 서브트리의 원소들은 모두 작거나 같을 것
오른쪽 서브트리의 원소들은 모두 클 것
-> 이 원칙을 모든 노드에서 적용
ex) 자연수의 합 구하기
1부터 n까지의 모든 자연수의 합을 구하시오.
def sum(n):
	if n <= 1:
    	return n
    else:
    	return n+sum(n-1)
재귀 호출의 종결 조건
알고리즘의 종결조건에 반드시 필요
재귀 알고리즘의 효율
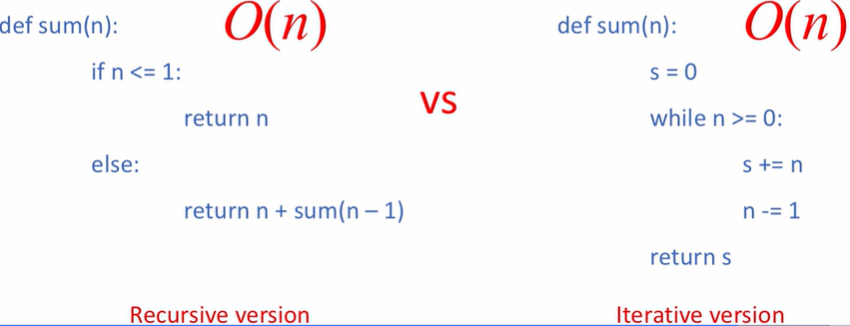
두 알고리즘의 복잡도는 O(n)이지만 효율성 측면에서 보면 재귀 알고리즘의 경우 n의 크기에 따라 함수를 호출하고 반환하는데 부가적인 작업이 필요하기 때문에 반복문이 더 효율적이다.
재귀 알고리즘 추가 예제
ex) n!

def what(n):
	if n <= 1:
    	return 1
    else:
    	return n * what(n - 1)
피보나치 순열
1. 재귀적 방법

def solution(x):
    if x < 2:
        return x
    else:
        return solution(x-1)+ solution(x-2)

2. 반복적 방법

        def solution(x):
    f0 = 0
    f1 = 1
    if x < 2:
        return x
    else:
        for _ in range(0, x):
            answer = f1
            f1 = f0 + f1
            f0 = answer
        return answer
5강 재귀 알고리즘 응용
조합의 수 계산
n개의 서로 다른 원소에서 m개를 택하는 경우의 수
from math import factorial as f

def combi(n,m)
	return f(n) / (f(m) * f(n-m))
재귀적 방법
def combi(n,m):
if n == m:
return 1
if m == 0:
return 1
else:
return combi(n - 1, m) + combi(n - 1, m - 1) 효율성 측면에서 n이 커지면 함수가 여러번 호출됨, 반복문이 더 효율적
재귀 알고리즘의 유용성
하노이의 탑
크기 순서로 쌓여있는 원반을 한 막대에서 다른 막대로 옮기기
재귀 알고리즘의 효율
피보나치 순열
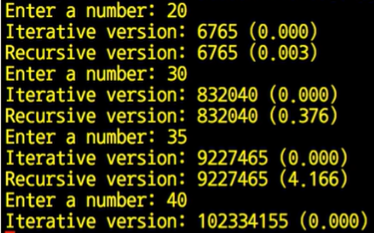
재귀적인 방법일 때 성능적으로 불리함이 있다
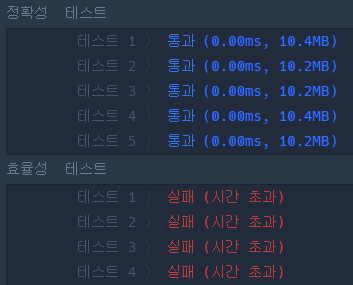
재귀적 이진 탐색
def solution(L, x, l, u):
    if x not in L:
        return -1
    mid = (l + u) // 2
    if x == L[mid]:
        return mid
    elif x < L[mid]:
        return solution(L, x, l, mid-1)
    else:
        return solution(L, x, mid+1, u)
6강 알고리즘의 복잡도
시간복잡도 (Time Complexity)
문제의 크기와 이를 해결하는데 걸리는 시간 사이의 관계
공간복잡도 (Time Complexity)
문제의 크기와 이를 해결하는데 필요한 메모리 공간 사이의 관계
평균 시간 복잡도 (Average Time Complexity)
임의의 입력 패턴을 가정했을 때 소요되는 시간의 평균
최악 시간 복잡도 (Worst-case Time Complexity)
가장 긴 시간을 소요하게 만드는 입력에 따라 소요되는 시간
Big-O Notation
점근 표기법(asymptotic notation)의 하나
어떤 함수의 증가 양상을 다른 함수와의 비교로 표현 (알고리즘의 복잡도를 표현할 때 흔히 쓰임)
ex) O(logn), O(n)...
입력의 크기가 n일 때,
O(logn) - 입력의 크기의 로그에 비례하는 시간 소요
O(n) - 입력의 크기에 비례하는 시간 소요
...
계수는 그다지 중요하지 않음
선형 시간 알고리즘 - O(n)
ex) n개의 무작위로 나열된 수에서 최댓값을 찾기 위해 선형 탐색 알고리즘 적용
최댓값 - 끝까지 다 살펴 보기 전까지는 알 수 없음
평균 시간 복잡도 : O(n)
최악 시간 복잡도 : O(n)
로그 시간 알고리즘 - O(logn)
ex) n개의 크기 순으로 정렬된 수에서 특정 값을 찾기 위해 이진 탐색 알고리즘을 적용
이차 시간 알고리즘 - O(n제곱)
ex) 삽입 정렬 (insertion sort)
Best case : O(n)
Worst case : O(n제곱)
보다 낮은 복잡도를 가지는 정렬 알고리즘 - O(nlogn)
참고 : 입력 패턴에 따라 정렬 속도에 차이가 있지만 정렬 문제에 대해 O(nlogn)보다 낮은 복잡도를 갖는 알고리즘은 존재할 수 없음이 증명되어 있음
ex) 병합 정렬 (merge sort) - O(nlogn)
정렬할 데이터를 반씩 나누어 각각을 정렬시킨다. - O(logn)
정렬된 데이터를 두 묶음씩 한데 합친다. - O(n)
꽤나 복잡한 문제
ex) 배낭 문제 (Knapsack Problem)
