7강 연결 리스트 (Linked Lists)(1)
추상적 자료구조 (Abstract Data structures)
자료구조의 내부구현은 숨겨두고 보여지는 것들 두가지를 제공하는 것
Data : 정수, 문자열, 레코드, ...
A set of operations (연산) : 삽입, 삭제, 순회, 정렬, 탐색, ....
기본적 연결 리스트
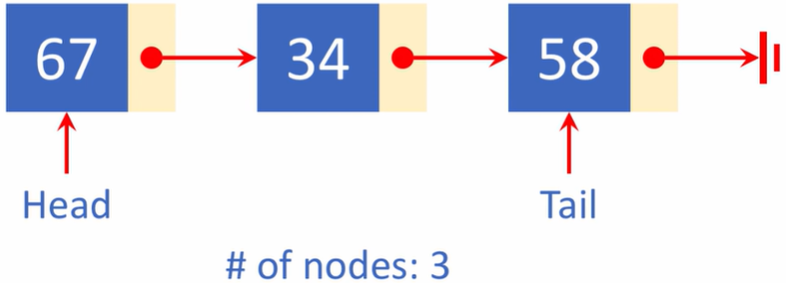
하나의 Node에는 Data, Link(next)가 있음
노드 내의 데이터는 다른 구조로 이루어질 수 있음
ex) 문자열, 레코드, 또 다른 연결리스트 등
비어있는 연결리스트
class Node:
	def_init_(self, item):
    	self.data = item
    	self.next = None
class LinkedList:
def_init_(self):
self.nodeCount = 0
self.head = None
self.tail = None연산 정의
- 특정 원소 참조 (k번쨰)
def getAt(self, pos):
	if pos<=0 or pos>self.nodeCount:
		return None
    i=1
    curr = self.head
    while i<pos:
    	curr = curr.next
        i+=1
return curr- 리스트 순회
- 길이 얻어내기
- 원소 삽입
- 원소 삭제
- 두 리스트 합치기
배열과 비교한 연결 리스트
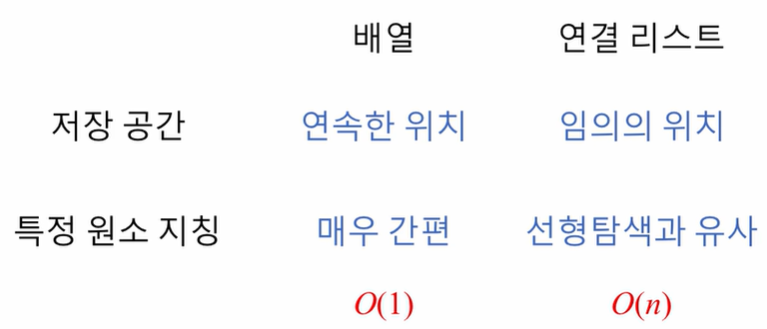
연결리스트 순회
class Node:
    def __init__(self, item):
        self.data = item
        self.next = None

class LinkedList:
    def __init__(self):
        self.nodeCount = 0
        self.head = None
        self.tail = None

    def getAt(self, pos):
        if pos < 1 or pos > self.nodeCount:
            return None
        i = 1
        curr = self.head
        while i < pos:
            curr = curr.next
            i += 1
        return curr

    def traverse(self):
        answer = []
        curr = self.head
        while curr != None:
            answer.append(curr.data)
            curr = curr.next
        return answer

# 이 solution 함수는 그대로 두어야 합니다.
def solution(x):
    return 0
8강 연결 리스트 (Linked Lists)(2)
원소의 삽입
def insertAt(self, pos, newNode):
pos가 가리키는 위치에 (1 <= pos <= nodeCount+1)
newNode를 삽입하고 성공/실패에 따라 True/False를 리턴
def insertAt(self, pos, newNode):
	prev = self.getAt(pos-1)
    newNode.next = prev.next
    prev.next = newNode
    self.nodeCount+1
코드 구현 주의사항
(1) 삽입하려는 위치가 리스트 맨 앞일 때
-> prev 없음
-> Head 조정 필요
(2) 삽입하려는 위치가 리스트 맨 끝일 때
-> Tail 조정 필요
(3) 빈 리스트에 삽입할 때?
-> 이 두 조건에 의해 처리됨
def insertAt(self, pos, newNode):
	if pos < 1 or pos > self.nodeCount+1:
    	return False
    if pos ==1:
    	newNode.next = self.head
        self.head = newNode
    else:
    	if pos == self.nodeCount+1:
        	prev = self.tail #앞에서 부터 찾아갈 필요 없음
        else:
        	prev = self.getAt(pos-1)
    	newNode.next = prev.next
    	prev.next = newNode
    if pos == self.nodeCount+1:
    	self.tail = newNode
    self.nodeCount+=1
    return True
연결리스트 원소 삽입의 복잡도
맨 앞에 삽입하는 경우 : O(1)
중간에 삽입하는 경우 : O(n)
맨 끝에 삽입하는 경우 : O(1)
원소의 삭제
def popAt(self, pos, newNode):
pos가 가리키는 위치의 (1 <= pos <= nodeCount)
node를 삭제하고 그 node의 데이터를 리턴
코드 구현 주의사항
(1) 삭제하려는 위치가 리스트 맨 앞의 것일 때
-> prev 없음
-> Head 조정 필요
(2) 리스트 맨 끝의 node를 삭제할 때
-> Tail 조정 필요
(3) 유일한 노드를 삭제할 때?
-> 이 두 조건에 의해 처리되는가?
연결리스트 원소 삭제의 복잡도
맨 앞에서 삭제하는 경우 : O(1)
중간에서 삭제하는 경우 : O(n)
맨 끝에서 삭제하는 경우 : O(n)
두 리스트의 연결
def concat(self, L)
	self.tail.next = L.head
    if L.tail:
    	self.tail = L.tail
    self.nodeCount+=L.nodeCount
연결리스트 노드 삭제
    def popAt(self, pos):
        popNode = self.getAt(pos)

        if pos < 1 or pos > self.nodeCount:
            raise IndexError

        if pos == 1:
            if self.nodeCount == 1:
                self.head = None
                self.tail = None
                self.nodeCount = 0
            else:
                self.head = self.head.next
                self.nodeCount -= 1

            return popNode.data

        else:
            prev = self.getAt(pos - 1)
            prev.next = self.getAt(pos).next
            if pos == self.nodeCount:
                prev.next = None
                self.tail = prev

        self.nodeCount -= 1
        return popNode.data
9강 연결 리스트 (Linked Lists)(3)
연결 리스트가 힘을 발휘할 때
삽입과 삭제가 유연하다는 것이 가장 큰 장점
새로운 매서드들
insertAfter(prev, newNode)
popAfter(prev)
-> 맨 앞일때 곤란함
조금 변형된 연결 리스트
맨 앞에 dummy node를 추가한 형태로
class LinkedList:
	def __init__(self):
    	self.nodeCount=0
        self.head=Node(None)
        self.tail=None
self.head.next=self.tail- 길이 얻어내기
- 리스트 순회
- 특정 원소 참조 (k번쨰)
- 원소 삽입
- 원소 삭제
- 두 리스트 합치기
리스트 순회
def traverse(self):
	result=[]
    curr=self.head
    while curr.next:
    	curr = curr.next
        result.append(curr.data)
    return result
k번째 원소 얻어내기
    def getAt(self, pos):
        if pos < 0 or pos > self.nodeCount:
            return None
        i = 0 #이제는 0부터
        curr = self.head
        while i < pos:
            curr = curr.next
            i += 1
        return curr
원소의 삽입
def insertAfter(self, prev, newNode):
prev가 가리키는 node의 다음에 newNode를 삽입하고 성공/실패에 따라 True/False를 리턴
	def insertAfter(self, prev, newNode):
		newNode.next = prev.next
		if prev.next is None:
			self.tail = newNode
		prev.next = newNode
		self.nodeCount += 1
		return True
insertAt() 구현
이미 구현한 insertAfter()를 호출하여 이용하는 것으로
(1) pos 범위 조건 확인
(2) pos==1 인 경우에는 head 뒤에 새 node 삽입
(3) pos==nodeCount+1 인 경우는 prev <- tail
(4) 그렇지 않은 경우에는 prev<-getAt(...)
	def insertAt(self, pos, newNode):
		if pos < 1 or pos > self.nodeCount + 1:
			return False

		if pos != 1 and pos == self.nodeCount + 1:
			prev = self.tail
		else:#빈 노드
			prev = self.getAt(pos - 1)
		return self.insertAfter(prev, newNode)
원소의 삭제
def popAfter(self, prev):
prev의 다음 node를 삭제하고 그 node의 data를 리턴
코드 구현 주의사항
(1) prev가 마지막 node 일 때(prev.next == None)
-> 삭제할 node 없음
-> return None
(2) 리스트 맨 끝의 node를 삭제할 때 (curr.next==None)
-> Tail 조정 필요
두 리스트의 연결
	def concat(self, L):
		self.tail.next = L.head.next
		if L.tail:
			self.tail = L.tail
		self.nodeCount += L.nodeCount
dummy head를 가지는 연결 리스트 노드 삭제
    def popAfter(self, prev):
        if prev.next == None:
            return None
        else:
            curr = prev.next
            popData = curr.data
            if curr.next == None:
                self.tail = prev
                prev.next = None
            else:
                prev.next = curr.next
        self.nodeCount -= 1
        curr = None
        return popData


    def popAt(self, pos):
        if pos < 1 or pos > self.nodeCount:
            raise IndexError
        prev = self.getAt(pos-1)
        return self.popAfter(prev)
10강 양방향 연결 리스트 (Doubly Linked Lists)
한쪽으로만 링크를 연결하지 말고 다음 node로도 이전 node로도 양쪽으로 진행 가능
Node의 구조 확장
class Node:
    def __init__(self, item):
        self.data = item
        self.prev = None
        self.next = None
리스트 처음과 끝에 dummy node를 두면 데이터를 담고 있는 node들은 모두 같은 모양
class DoublyLinkedList:

    def __init__(self):
        self.nodeCount = 0
        self.head = Node(None)
        self.tail = Node(None)
        self.head.prev = None
        self.head.next = self.tail
        self.tail.prev = self.head
        self.tail.next = None
리스트 순회
    def traverse(self):
        result = []
        curr = self.head
        while curr.next.next:
            curr = curr.next
            result.append(curr.data)
        return result
리스트 역순회
    def reverse(self):
        result = []
        curr = self.tail
        while curr.prev.prev:
            curr = curr.prev
            result.append(curr.data)
        return result
원소의 삽입
    def insertAfter(self, prev, newNode):
        next = prev.next
        newNode.prev = prev
        newNode.next = next
        prev.next = newNode
        next.prev = newNode
        self.nodeCount += 1
        return True
def insertAt(self, pos, newNode):
if pos < 1 or pos > self.nodeCount + 1:
return False
prev = self.getAt(pos - 1)
return self.insertAfter(prev, newNode)리스트 마지막에 원소 삽입하면?
-> getAt 개선
    def getAt(self, pos):
        if pos < 0 or pos > self.nodeCount:
            return None
#절반 나누어서 찾아가도록
        if pos > self.nodeCount // 2:
            i = 0
            curr = self.tail
            while i < self.nodeCount - pos + 1:
                curr = curr.prev
                i += 1
        else:
            i = 0
            curr = self.head
            while i < pos:
                curr = curr.next
                i += 1

        return curr
하지만 여전히 선형시간 알고리즘
양방향 연결 리스트 노드 삽입
    def insertBefore(self, next, newNode):
        prev = next.prev
        newNode.next = next
        newNode.prev = prev
        next.prev = newNode
        prev.next = newNode
        self.nodeCount += 1
        return True
양방향 연결 리스트 노드 삭제
    def popAfter(self, prev):
        popNode = prev.next
        prev.next = popNode.next
        popNode.next.prev = prev
        self.nodeCount -= 1
        return popNode.data

    def popBefore(self, next):
        popNode = next.prev
        next.prev = popNode.prev
        popNode.prev.next = next
        self.nodeCount -= 1
        return popNode.data


    def popAt(self, pos):
        if pos < 1 or pos > self.nodeCount:
            raise IndexError
        prev = self.getAt(pos - 1)
        return self.popAfter(prev)
양방향 연결 리스트의 병합
    def concat(self, L):
        self.tail.prev.next = L.head.next
        L.head.next.prev = self.tail.prev
        self.tail = L.tail
        self.nodeCount += L.nodeCount
11강 스택 (Stack)
자료 (data element)를 보관할 수 있는 (선형) 구조
단, 넣을 때에는 한 쪽 끝에서 밀어 넣어야 하고 꺼낼 때에는 같은 쪽에서 뽑아 꺼내야 하는 제약이 있음
후입선출 (LIFO - Last In First Out) 특징을 가지는 선형 자료구조
스택에서 발생하는 오류
비어 있는 스택에서 데이터 원소를 꺼내려 할 때 -> 스택 언더플로우(Stack Underflow)
꽉 찬 스택에서 데이터 원소를 넣으려 할 때 -> 스택 오버플로우(Stack Overflow)
스택의 추상적 자료구조 구현
(1) 배열(array)을 이용하여 구현 - Python 리스트와 메서드들을 이용
(2) 연결 리스트(linked list)를 이용하여 구현 - 지난 강의에서 마련한 양방향 연결 리스트 이용
연산의 정의
size() - 현재 스택에 들어 있는 데이터 원소의 수를 구함
isEmpty() - 현재 스택이 비어 있는지를 판단
push(x) - 데이터 원소 x를 스택에 추가
pop() - 스택의 맨 위에 저장된 데이터 원소를 제거 (또한, 반환)
peek() - 스택의 맨 위에 저장된 데이터 원소를 반환 (제거하지 않음)
배열로 구현한 스택
class ArrayStack:

	def __init__(self):
		self.data = []

	def size(self):
		return len(self.data)

	def isEmpty(self):
		return self.size() == 0
# 데이터 원소를 추가
	def push(self, item):
		self.data.append(item)
# 데이터 원소를 삭제
	def pop(self):
		return self.data.pop()
# 스택의 꼭대기 원소 반환
	def peek(self):
		return self.data[-1]
양방향 연결 리스트로 구현한 스택
from doublylinkedlist import Node
from doublylinkedlist import DoublyLinkedList

class LinkedListStack:

	def __init__(self):
		self.data = DoublyLinkedList()

	def size(self):
		return self.data.getLength()

	def isEmpty(self):
		return self.size() == 0

	def push(self, item):
		node = Node(item)
		self.data.insertAt(self.size() + 1, node)

	def pop(self):
		return self.data.popAt(self.size())

	def peek(self):
		return self.data.getAt(self.size()).data
이미 만들어진 Python 라이브러리의 스택도 있음
연습문제 - 수식의 괄호 유효성 검사
알고리즘 설계 - 수식을 왼쪽부터 한 글자씩 읽어서:
-
여는 괄호를 만나면 스택에 푸시
-
닫는 괄호를 만나면 :
스택에 비어 있으면 올바르지 않은 수식
스택에서 pop, 쌍을 이루는 여는 괄호인지 검사
- 맞지 않으면 올바르지 않은 수식 -
끝까지 검사한 후, 스택이 비어 있어야 올바른 수식
12강 수식의 후위 표기법
중위 표기법과 후위 표기법
중위 표기법(infix notation)
-
연산자가 피연산자들의 사이에 위치
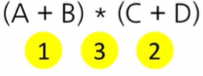
후위 표기법(postfix notation)
-
연산자가 피연산자들의 뒤에 위치
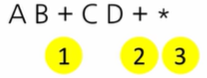
중위 표현식 -> 후위 표현식
알고리즘의 설계
연산자의 우선순위 설정
#dictionary
prec={'*':3,'/':3,'+':2,'-':2,'(':1}
중위 표현식을 왼쪽부터 한 글자씩 읽어서
- 피연산자이면 그냥 출력
- '('이면 스택에 push
- ')' 이면 '(' 이 나올 때까지 스택에서 pop, 출력
- 연산자이면 스택에서 이보다 높(거나 같)은 우선순위 것들을 pop, 출력
- 그리고 이 연산자는 스택에 push
- 스택에 남아 있는 연산자는 모두 pop, 출력
코드의 구현 - 힌트
스택의 맨 위에 있는 연산자와의 우선순위 비교 - peek()연산 이용
스택에 남아 있는 연산자 모두 pop()하는 순환문
while not opStack.isEmpty():중위표현 수식-->후위표현 수식
class ArrayStack:

    def __init__(self):
        self.data = []

    def size(self):
        return len(self.data)

    def isEmpty(self):
        return self.size() == 0

    def push(self, item):
        self.data.append(item)

    def pop(self):
        return self.data.pop()

    def peek(self):
        return self.data[-1]

prec = {
    '*': 3, '/': 3,
    '+': 2, '-': 2,
    '(': 1
}

def solution(S):
    opStack = ArrayStack()
    answer = ''
    for x in S:
        if x.isalpha():
            answer += x
        elif x == '(':
            opStack.push(x)
        elif x == ')':
            while opStack.peek() != '(':
                answer += opStack.pop()
            opStack.pop()
        else:
            if opStack.isEmpty():
                opStack.push(x)
            else:
                while opStack.isEmpty() == False and prec[opStack.peek()] >= prec[x]:
                    answer += opStack.pop()
                opStack.push(x)


    while not opStack.isEmpty():
        answer += opStack.pop()
    return answer
13강 후위 표기 수식 계산
알고리즘의 설계
후위 표현식을 왼쪽부터 한 글자씩 읽어서
- 피연산자이면 스택에 push
- 연산자를 만나면 스택에서 pop->(1), 또 pop->(2)
- (2) 연산 (1)을 계산, 이 결과를 스택에 push - 수식의 끝에 도달하면 스택에서 pop-> 이것이 계산 결과
후위표현 수식 계산
def splitTokens(exprStr):
	tokens = []
    val = 0
    valProcessing = False
    for c in exprStr:
    	if c == '':
        	continue
        if c in '0123456789':
        	val = val * 10 + int(c)
            valProcessing = True
       	else:
        	if valProcessing:
            	tokens.append(val)
                val = 0
            valProcessing = False
            tokens.append(c)
    if valProcessing:
    	tokens.append(val)

    return tokens
from stacks import ArrayStrack as Stack
#이번 함수 인자는 리스트
def infixToPostfix(tokenList):
prec = {
'*': 3,
'/': 3,
'+': 2,
'-': 2,
'(': 1,
}
opStack = ArrayStack()
postfixList = []
for token in tokenList:
if type(token) is int:
postfixList.append(token)
elif token == '(':
opStack.push(token)
elif token == ')':
while opStack.peek() != '(':
postfixList.append(opStack.pop())
opStack.pop()
else:
if opStack.isEmpty():
opStack.push(token)
else:
while opStack.size() > 0:
if prec[opStack.peek()] >= prec[token]:
postfixList.append(opStack.pop())
else:
break
opStack.push(token)
while not opStack.isEmpty():
postfixList.append(opStack.pop())
return postfixList
def postfixEval(tokenList):
valStack = ArrayStack()
for token in tokenList:
if type(token) is int:
valStack.push(token)
elif token == '*':
x = valStack.pop()
y = valStack.pop()
valStack.push(x*y)
elif token == '/':
x = valStack.pop()
y = valStack.pop()
valStack.push(int(y/x))
elif token == '+':
x = valStack.pop()
y = valStack.pop()
valStack.push(x+y)
elif token == '-':
x = valStack.pop()
y = valStack.pop()
valStack.push(y-x)
return valStack.pop()
def solution(expr):
tokens = splitTokens(expr)
postfix = infixToPostfix(tokens)
val = postfixEval(postfix)
return val