14강 큐 (Queues)
자료(data element)를 보관할 수 있는 선형 구조
단, 넣을 때에는 한 쪽 끝에서 밀어 넣어야 하고 -> 인큐 (enqueue) 연산
꺼낼 때에는 반대 쪽에서 뽑아 꺼내야 하는 제약이 있음 -> 디큐 (dequeue) 연산
선입선출 (FIFO) 특징을 가지는 선형 자료구조
큐의 추상적 자료구조 구현
(1) 배열을 이용하여 구현 : Python 리스트와 매세드들을 이용
(2) 연결 리스트를 이용하여 구현 : 이전 강의에서 마련한 양방향 연결 리스트 이용
연산의 정의
size() - 현재 큐에 들어있는 데이터 원소의 수를 구함
isEmpty() - 현재 큐가 비어 있는지를 판단
enqueue(x) - 데이터 원소 x를 큐에 추가
dequeue() - 큐의 맨 앞에 저장된 데이터 원소를 제거(또한, 반환)
peek() - 큐의 맨 앞에 저장된 데이터 원소를 반환 (제거하지 않음)
배열로 구현한 큐
class ArrayQueue:
	#큐의 크기를 리턴
	def size(self):
    	return len(self.data)
    #큐가 비어 있는지 판단
    def isEmpty(self):
    	return self.size()==0
    #데이터 원소를 추가
    def enqueue(self, item):
    	self.data.append(item)
    #데이터 원소를 삭제(리턴)
    def dequeue(self):
    	return self.data.pop(0)
    #큐의 맨 앞 원소 반환
    def peek(self):
    	return self.data[0]
배열로 구현한 큐의 연산 복잡도
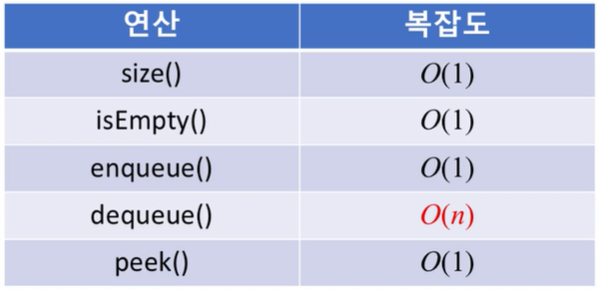
파이썬 공개 라이브러리에도 있음
from pythonds.basic.queue import Queue
양방향 연결리스트로 구현하는 큐
class LinkedListQueue:

    def __init__(self):
        self.data = DoublyLinkedList()

    def size(self):
        return self.data.getLength()

    def isEmpty(self):
        return self.data.getLength()==0

    def enqueue(self, item):
        node = Node(item)
        self.data.insertAt(self.data.nodeCount+1, node)

    def dequeue(self):
        return self.data.popAt(1)

    def peek(self):
        return self.data.getAt(1).data
15강 환형 큐 (Circular Queues)
큐의 활용
자료를 생성하는 작업과 그 자료를 이용하는 작업이 비동기적으로(asynchronously) 일어나는 경우
자료를 생성하는 작업이 여러 곳에서 일어나는 경우
자료를 이용하는 작업이 여러 곳에서 일어나는 경우
자료를 생성하는 작업과 그 자료를 이용하는 작업이 양쪽 다 여러 곳에서 일어나는 경우
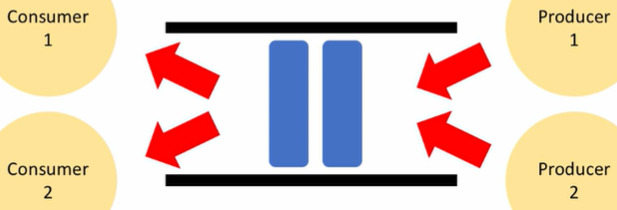
자료를 처리하여 새로운 자료를 생성하고, 나중에 그 자료를 또 처리해야 하는 작업의 경우
환형 큐
정해진 개수의 저장공간을 빙 돌려가며 이용
큐가 가득 차면?
-> 더이상 원소를 넣을 수 없음 (큐 길이를 기억하고 있어야함)
환형 큐의 추상적 자료구조 구현
연산의 정의
size() - 현재 큐에 들어있는 데이터 원소의 수를 구함
isEmpty() - 현재 큐가 비어 있는지를 판단
isFull() - 큐에 데이터 원소가 꽉 차 있는지를 판단
enqueue(x) - 데이터 원소 x를 큐에 추가
dequeue() - 큐의 맨 앞에 저장된 데이터 원소를 제거(또한, 반환)
peek() - 큐의 맨 앞에 저장된 데이터 원소를 반환 (제거하지 않음)
환형 큐 구현
class CircularQueue:
	#빈 큐를 초기화 인자로 주어진 최대 큐 길이 설정
	def __init__(self, n):
    	self.maxCount=n
        self.data=[None]*n
        self.count=0
        self.front=-1
        self.rear=-1
	#현재 큐 길이를 반환
	def size(self):
    	return self.count
    #큐가 비어 있는가?
    def isEmpty(self):
    	return self.count==0
    #큐가 꽉 차 있는가?
    def isFull(self):
    	return self.count==self.maxCount
    #큐에 데이터 원소를 추가
    def enqueue(self, x):
    	if self.isFull():
        	raise IndexError('Queue full')
        self.rear = (self.rear+1)%self.maxCount
        self.data[self.rear] = x
        self.count += 1

    #큐에서 데이터 원소 뽑아내기
    def dequeue(self):
        if self.isEmpty():
            raise IndexError('Queue empty')
        self.front = (self.front+1)%self.maxCount
        x = self.data[self.front]
        self.count -= 1
        return x
    #큐의 맨 앞 원소 들여다보기
    def peek(self):
        if self.isEmpty():
            raise IndexError('Queue empty')
        return self.data[(self.front+1)%self.maxCount]
16강 우선순위 큐 (Priority Queues)
큐가 FIFO 방식을 따르지 않고 원소들의 우선순위에 따라 큐에서 빠져나오는 방식
우선순위 큐의 활용
운영체제의 CPU 스케쥴러
우선순위 큐의 구현
서로 다른 두 가지 방식이 가능할 듯
(1) Enqueue 할 때 우선순위 순서를 유지하도록
(2) Dequeue 할 때 우선순위 높은 것을 선택
-> 어느 것이 더 유리할까? (1)
서로 다른 두 가지 재료를 이용할 수 있음:
(1) 선형 배열 이용
(2) 연결 리스트 이용
-> 어느 것이 더 유리할까? 시간적으로는 (2) 유리, 메모리는 (1)이 덜 차지함
우선순위 큐의 초기화
from doublylinkedlist import Node, DoublyLinkedList

class PriorityQueue:
    # 양방향 연결리스트를 이용하여 빈 큐를 초기화
    def __init__(self, x):
        self.queue = DoublyLinkedList()
[주의] 탐색시간 때문에 양방향 연결 리스트의 getAt() 메서드를 이용하지 않음
우선순위 큐의 enqueue 연산 구현
    def enqueue(self, x):
        newNode = Node(x)
        curr = self.queue.head
        while curr.next != self.queue.tail and x < curr.next.data:
            curr = curr.next
        self.queue.insertAfter(curr, newNode)
17강 트리 (Trees)
정점(node)과 간선(edge)을 이용하여 데이터의 배치 형태를 추상화한 자료구조
이진 트리 (Binary Trees)
모든 노드의 차수가 2이하인 트리
재귀적으로 정의할 수 있음 : 빈 트리(empty tree)이거나 루트 노드 + 왼쪽 서브트리 + 오른쪽 서브트리
(단, 이 때 왼쪽과 오른쪽 서브트리 또한 이진트리)
포화 이진 트리 (Full Binary Tree)
모든 레벨에서 노드들이 모두 채워져 있는 이진 트리
(높이가 k이고 노드의 개수가 2^k-1인 이진트리)
완전 이진 트리 (Complete Binary Tree)
높이 k인 완전 이진 트리
레벨 k-2까지는 모든 노드가 2개의 자식을 가진 포화 이진 트리
레벨 k-1에서는 왼쪽부터 노드가 순차적으로 채워져 있는 이진 트리
18강 이진 트리 (Binary Trees)
연산의 정의
size() - 현재 트리에 포함되어 있는 노드의 수를 구함
depth() - 현재 트리의 깊이(또는 높이;height)를 구함
순회(traversal)
이진 트리의 구현 - 노드
class Node:
    def __init__(self, item):
        self.data = item
        self.left = None
        self.right = None
이진 트리의 구현 - 트리
class BinaryTree:
    def __init__(self, r):
        self.root = r
이진 트리의 구현 - size()
class Node:
    def size(self):
        l = self.left.size() if self.left else 0
        r = self.right.size() if self.right else 0
        return l + r + 1


class BinaryTree:
    def size(self):
        if self.root:
            return self.root.size()
        else:
            return 0
이진 트리의 순회 (Traversal)
- 깊이 우선 순회(depth first traversal)
- 중위 순회(in-order traversal)
- 전위 순회(pre-order traversal)
- 후위 순회(post-order traversal) - 넓이 우선 순회(breadth first traversal)
중위 순회 (in-order traversal)
순회의 순서
(1) Left subtree
(2) 자기 자신
(3) Right subtree
class Node:
	def inorder(self):
    	traversal = []
        if self.left:
        	traversal += self.left.inorder()
            traversal.append(self.data)
        if self.right:
        	traversal += self.right.inorder()
        return traversal
class BinaryTree:
def inorder(self):
if self.root:
return self.root.inorder()
else:
return []
전위 순회 (Pre-order traversal)
순회의 순서
(1) 자기 자신
(2) Left subtree
(3) Right subtree
후위 순회 (Post-order traversal)
순회의 순서
(1) Left subtree
(2) Right subtree
(3) 자기 자신
이진트리의 depth() 연산 구현
class Node:
    def __init__(self, item):
        self.data = item
        self.left = None
        self.right = None

    def size(self):
        l = self.left.size() if self.left else 0
        r = self.right.size() if self.right else 0
        return l + r + 1

    def depth(self):
        l = self.left.depth() if self.left else 0
        r = self.right.depth() if self.right else 0
        return max(l,r) + 1

class BinaryTree:
    def __init__(self, r):
        self.root = r

    def size(self):
        if self.root:
            return self.root.size()
        else:
            return 0

    def depth(self):
        if self.root:
            return self.root.depth()
        else:
            return 0
이진트리의 전위 순회 연산 구현
#중위 순회 연산과 유사

    def preorder(self):
        traversal = []
        traversal.append(self.data)
        if self.left:
            traversal += self.left.preorder()
        if self.right:
            traversal += self.right.preorder()
        return traversal

    def preorder(self):
        if self.root:
            return self.root.preorder()
        else:
            return []
이진트리의 후위 순회 연산 구현
#중위 순회 연산과 유사

    def postorder(self):
        traversal = []
        if self.left:
            traversal += self.left.postorder()
        if self.right:
            traversal += self.right.postorder()
        traversal.append(self.data)
        return traversal

    def postorder(self):
        if self.root:
            return self.root.postorder()
        else:
            return []
19강 이진 트리 - 넓이 우선 순회(breadth first traversal)
원칙
- 수준이 낮은 노드를 우선으로 방문
- 같은 수준의 노드들 사이에는,
- 부모 노드의 방문 순서에 따라 방문
- 왼쪽 자식 노드를 오른쪽 자식보다 먼저 방문
- 재귀적 방법이 적합한가? X
- 한 노드를 방문했을 때,
- 나중에 방문할 노드들을 순서대로 기록해 두어야 -> 큐(Queue)를 이용
넓이 우선 순회 알고리즘 구현
- (초기화)traversal<-빈 리스트, q<-빈 큐
- 빈 트리가 아니면, root node를 q에 추가(enqueue)
- q가 비어 있지 않은 동안
3.1 node<-q에서 원소를 추출 (dequeue)
3.2 node를 방문
3.3 node의 왼쪽, 오른쪽 자식 (있으면) 들을 q에 추가 - q가 빈 큐가 되면 모든 노드 방문 완료
이진 트리의 넓이 우선 순회
class ArrayQueue:

    def __init__(self):
        self.data = []

    def size(self):
        return len(self.data)

    def isEmpty(self):
        return self.size() == 0

    def enqueue(self, item):
        self.data.append(item)

    def dequeue(self):
        return self.data.pop(0)

    def peek(self):
        return self.data[0]


class Node:

    def __init__(self, item):
        self.data = item
        self.left = None
        self.right = None


class BinaryTree:

    def __init__(self, r):
        self.root = r


    def bft(self):
        q = ArrayQueue()
        traversal = []

        if self.root:
            q.enqueue(self.root)
        while not q.isEmpty():
            node = q.dequeue()
            traversal.append(node.data)
            if node.left:
                q.enqueue(node.left)
            if node.right:
                q.enqueue(node.right)
        return traversal

def solution(x):
    return 0
20강 이진 탐색 트리(Binary Search Trees) (1)
모든 노드에 대해서,
왼쪽 서브트리에 있는 데이터는 모두 현재 노드의 값보다 작고
오른쪽 서브트리에 있는 데이터는 모두 현재 노드의 값보다 큰 성질을 만족하는 이진 트리
(중복되는 데이터 원소는 없는 것으로 가정)
정렬된 배열을 이용한 이진 탐색과 비교
장점 : 데이터 원소의 추가, 삭제가 용이
단점 : 공간 소요가 큼
항상 O(logn)의 탐색 복잡도? X
이진 탐색 트리의 추상적 자료구조
데이터 표현 - 각 노드는 (key, value)의 쌍으로
키를 이용해서 검색 가능
보다 복잡한 데이터 레코드로 확장 가능
연산의 정의
insert(key, data) - 트리에 주어진 데이터 원소를 추가
remove(key) - 특정 원소를 트리로부터 삭제
lookup(key) - 특정 원소를 검색
inorder() - 키의 순서대로 데이터 원소를 나열
min(), max() - 최소 키, 최대 키를 가지는 원소를 각각 탐색
코드 구현 - 초기화
class Node:
    # 초기화
    def __init__(self, key, data):
        self.key = key
        self.data = data
        self.left = None
        self.right = None

class BinSearchTree:
    def __init__(self):
        self.root = None
코드 구현 - inorder traversal
class Node:
    def inorder(self):
        traversal = []
        if self.left:
            traversal += self.left.inorder()
        traversal.append(self)
        if self.right:
            traversal += self.right.inorder()
        return traversal

class BinSearchTree:
    def inorder(self):
        if self.root:
            return self.root.inorder()
        else:
            return []
코드 구현 - min(), max()
class Node:

    def min(self):
        if self.left:
            return self.left.min()
        else:
            return self
    #min과 완전히 대칭
    def max(self):
        if self.right:
            return self.right.max()
        else:
            return self

class BinSearchTree:

    def min(self):
        if self.root:
            return self.root.min()
        else:
            return None
    def max(self):
        if self.root:
            return self.root.max()
        else:
            return None
코드 구현 - lookup()
입력 인자: 찾으려는 대상 키
리턴 : 찾은 노드와, 그것의 부모 노드 (각각, 없으면 None으로)
class Node:

    def lookup(self, key, parent=None):
        if key < self.key:
            if self.left:
                return self.left.lookup(key, self)
            else:
                return None, None
        elif key > self.key:
            if self.right:
                return self.right.lookup(key, self)
            else:
                return None, None
        else:
            return self, parent

class BinSearchTree:

    def lookup(self, key):
        if self.root:
            return self.root.lookup(key)
        else:
            return None, None
이진 탐색 트리의 원소 삽입 연산 구현
입력 인자: 키, 데이터 원소
리턴 : 없음
class Node:

    def __init__(self, key, data):
        self.key = key
        self.data = data
        self.left = None
        self.right = None


    def insert(self, key, data):
        if key < self.key:
            if self.left:
                self.left.insert(key, data)
            else:
                self.left = Node(key,data)

        elif key > self.key:
            if self.right:
                self.right.insert(key, data)
            else:
                self.right = Node(key, data)

        else:
            raise KeyError

        return True


    def inorder(self):
        traversal = []
        if self.left:
            traversal += self.left.inorder()
        traversal.append(self)
        if self.right:
            traversal += self.right.inorder()
        return traversal


class BinSearchTree:

    def __init__(self):
        self.root = None


    def insert(self, key, data):
        if self.root:
            self.root.insert(key, data)
        else:
            self.root = Node(key, data)


    def inorder(self):
        if self.root:
            return self.root.inorder()
        else:
            return []


def solution(x):
    return 0
21강 이진 탐색 트리(Binary Search Trees) (2)
이진 탐색 트리에서 원소 삭제
- 키를 이용해서 노드를 찾는다
- 해당 키의 노드가 없으면, 삭제할 것도 없음
- 찾은 노드의 부모 노드도 알고 있어야 함
- 찾은 노드를 제거하고도 이진 탐색 트리 성질을 만족하도록 트리의 구조를 정리한다.
인터페이스의 설계
입력 : 키
출력 : 삭제한 경우 True, 해당 키의 노드가 없는 경우 False
이진 탐색 트리 구조의 유지
삭제되는 노드가
- 말단 (leaf) 노드인 경우 :
그냥 그 노드를 없애면 됨 -> 부모 노드의 링크를 조정- 자식을 하나 가지고 있는 경우 :
삭제되는 노드 자리에 그 자식을 대신 배치 -> 부모 노드의 링크를 조정- 자식을 둘 가지고 있는 경우 :
삭제되는 노드보다 바로 다음 (큰) 키를 가지는 노드를 찾아 그 노드를 삭제되는 노드 자리에 대신 배치하고 이 노드를 대신 삭제
이진 탐색 트리가 별로 효율적이지 못한 경우
순서대로 삽입하는 경우 효율적이지 못하다
한쪽으로 치우치는 모양
보다 나은 성능을 보이는 이진 탐색 트리들
높이의 균형을 유지함으로써 O(logN)의 탐색 복잡도를 보장
삽입, 삭제 연산이 보다 복잡해짐
ex) AVL tree, Red black tree
이진 탐색 트리에서 노드의 삭제 연산 구현
class Node:

    def __init__(self, key, data):
        self.key = key
        self.data = data
        self.left = None
        self.right = None


    def insert(self, key, data):
        if key < self.key:
            if self.left:
                self.left.insert(key, data)
            else:
                self.left = Node(key, data)
        elif key > self.key:
            if self.right:
                self.right.insert(key, data)
            else:
                self.right = Node(key, data)
        else:
            raise KeyError('Key %s already exists.' % key)


    def lookup(self, key, parent=None):
        if key < self.key:
            if self.left:
                return self.left.lookup(key, self)
            else:
                return None, None
        elif key > self.key:
            if self.right:
                return self.right.lookup(key, self)
            else:
                return None, None
        else:
            return self, parent


    def inorder(self):
        traversal = []
        if self.left:
            traversal += self.left.inorder()
        traversal.append(self)
        if self.right:
            traversal += self.right.inorder()
        return traversal


    def countChildren(self):
        count = 0
        if self.left:
            count += 1
        if self.right:
            count += 1
        return count


class BinSearchTree:

    def __init__(self):
        self.root = None


    def insert(self, key, data):
        if self.root:
            self.root.insert(key, data)
        else:
            self.root = Node(key, data)


    def lookup(self, key):
        if self.root:
            return self.root.lookup(key)
        else:
            return None, None


    def remove(self, key):
        node, parent = self.lookup(key)
        if node:
            nChildren = node.countChildren()
            # The simplest case of no children
            if nChildren == 0:
                # 만약 parent 가 있으면
                # node 가 왼쪽 자식인지 오른쪽 자식인지 판단하여
                # parent.left 또는 parent.right 를 None 으로 하여
                # leaf node 였던 자식을 트리에서 끊어내어 없앱니다.
                if parent:
                    if parent.left == node:
                        parent.left = None
                    if parent.right == node:
                        parent.right = None
                # 만약 parent 가 없으면 (node 는 root 인 경우)
                # self.root 를 None 으로 하여 빈 트리로 만듭니다.
                else:
                    self.root = None
            # When the node has only one child
            elif nChildren == 1:
                # 하나 있는 자식이 왼쪽인지 오른쪽인지를 판단하여
                # 그 자식을 어떤 변수가 가리키도록 합니다.
                if node.left:
                    x = node.left
                else:
                    x = node.right
                # 만약 parent 가 있으면
                # node 가 왼쪽 자식인지 오른쪽 자식인지 판단하여
                # 위에서 가리킨 자식을 대신 node 의 자리에 넣습니다.
                if parent:
                    if parent.left == node:
                        parent.left = x
                    else:
                        parent.right = x              # 만약 parent 가 없으면 (node 는 root 인 경우)
                # self.root 에 위에서 가리킨 자식을 대신 넣습니다.
                else:
                    self.root = x
            # When the node has both left and right children
            else:
                parent = node
                successor = node.right
                # parent 는 node 를 가리키고 있고,
                # successor 는 node 의 오른쪽 자식을 가리키고 있으므로
                # successor 로부터 왼쪽 자식의 링크를 반복하여 따라감으로써
                # 순환문이 종료할 때 successor 는 바로 다음 키를 가진 노드를,
                # 그리고 parent 는 그 노드의 부모 노드를 가리키도록 찾아냅니다.
                while successor.left:
                    parent = successor
                    successor = successor.left
                # 삭제하려는 노드인 node 에 successor 의 key 와 data 를 대입합니다.
                node.key = successor.key
                node.data = successor.data
                # 이제, successor 가 parent 의 왼쪽 자식인지 오른쪽 자식인지를 판단하여
                # 그에 따라 parent.left 또는 parent.right 를
                # successor 가 가지고 있던 (없을 수도 있지만) 자식을 가리키도록 합니다.
                if parent.left == successor:
                    parent.left = successor.right
                else:
                    parent.right = successor.right

            return True

        else:
            return False


    def inorder(self):
        if self.root:
            return self.root.inorder()
        else:
            return []


def solution(x):
    return 0
22강 힙 (Heaps) (1)
이진 트리의 한 종류 (이진 힙 - binary heap)
1. 루트 (root) 노드가 언제나 최댓값 또는 최솟값을 가짐
- 최대 힙 (max heap), 최소 힙 (min heap)
2. 완전 이진 트리여야 함
최대 힙 내의 임의의 노드를 루트로 하는 서브트리 또한 최대 힙(재귀적으로 정의가 됨)
이진 탐색 트리와의 비교
-
원소들은 완전히 크기 순으로 정렬되어 있는가?
→ 이진탐색트리는 크기순으로 정렬이 가능하다 | 이진 힙은 그렇지 않다 -
특정 키 값을 가지는 원소를 빠르게 검색할 수 있는가?
→ 이진탐색트리는 가능 | 이진 힙은 불가능 -
부가의 제약 조건은 어떤 것인가?
→ 이진 힙은 이진탐색트리에 비해 완전 이진트리여야한다
최대 힙(max heap)의 추상적 자료구조
연산의 정의
init() : 비어 있는 최대 힙을 생성
insert(item) : 새로운 원소를 삽입
remove() : 최대 원소(root node)를 반환하고 삭제
데이터 표현의 설계
배열을 이용한 이진 트리의 표현
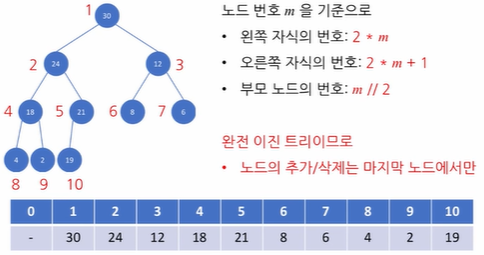
빈 힙 생성
class MaxHeap:
     def __init__(self):
        self.data = [None]
최대 힙에 원소 삽입
- 트리의 마지막 자리에 새로운 원소를 임시로 저장
- 부모 노드의 키 값을 비교하여 위로, 비교하고 위로 이동
최대 힙에 원소 삽입의 복잡도
원소 개수가 n 인 최대 힙에 새로운 원소 삽입
→ 부모 노드와 대소 비교 최대 회수 : 2를 밑으로 하는 logn
최악 복잡도 O(logn)의 삽입 연산
최대 힙에 새로운 원소 삽입
힌트 : python에서 두 변수의 값 바꾸기
class MaxHeap:

    def __init__(self):
        self.data = [None]


    def insert(self, item):
        self.data.append(item)
        a = len(self.data) - 1

        while a > 1:
            if self.data[a] > self.data[(a // 2)]:
                self.data[a], self.data[(a // 2)] = self.data[(a // 2)], self.data[a]
                a = a // 2
            else:
                break

def solution(x):
    return 0
23강 힙 (Heaps) (2)
최대 힙에 원소의 삭제
- 루트 노드의 제거 - 이것이 원소들 중 최댓값
- 트리 마지막 자리 노드를 임시로 루트 노드의 자리에 배치
- 자식 노드들과의 값 비교와 아래로, 아래로 이동
- 자식은 둘 있을 수 있는데 어느 쪽으로 이동? 더 큰 키 값을 가지는 쪽으로
최대 힙에 원소 삭제 복잡도
원소 개수가 n 인 최대 힙에 새로운 원소 삭제
→ 자식 노드들과의 대소 비교 최대 회수 : 2 * 2를 밑으로 하는 logn
최악 복잡도 O(logn)의 삭제 연산
최대/최소 힙의 응용
1. 우선 순위 큐(Priority queue)
Enqueue 할 때, "느슨한 정렬"을 이루고 있도록 함 : O(logn)
Dequeue 할 때, 최대값을 순서대로 추출 : O(logn)
제 16강에서의 양방향 연결 리스트 이용 구현과 효율성 비교
2. 힙 정렬(heap sort)
정렬되지 않은 원소들은 아무 순서로나 최대 힙에 삽입 : O(logn)
삽입이 끝나면, 힙이 비어지게 될 때까지 하나씩 삭제 : O(logn)
원소들이 삭제되는 순서가 원소들의 정렬 순서
정렬 알고리즘 복잡도 : O(nlogn)
힙 정렬(heap sort)의 코드 구현
def heapSort(unsorted):
    H = MaxHeap()
    for item in unsorted:
        H.insert(item)
    sorted = []
    d = H.remove()
    while d:
        sorted.append(d)
        d = H.remove()
    return sorted
최대 힙에서의 원소 삭제
class MaxHeap:
    def __init__(self):
        self.data = [None]

    def remove(self):
        if len(self.data) > 1:
            self.data[1], self.data[-1] = self.data[-1], self.data[1]
            data = self.data.pop(-1)
            self.maxHeapify(1)
        else:
            data = None
        return data


    def maxHeapify(self, i):
        # i는 어느 기준으로 바꿀건가

        # 왼쪽 자식 (left child) 의 인덱스를 계산합니다.
        left = i * 2
        # 오른쪽 자식 (right child) 의 인덱스를 계산합니다.
        right = i * 2 + 1
        smallest = i

        # 자신(i), 왼쪽자식(left), 오른쪽자식(right) 중 최대를 찾아서 이것의 인덱스를 smallest에 담는다
        # 왼쪽 자식이 존재하는지, 그리고 왼쪽 자식의 (키) 값이 (무엇보다?) 더 큰지를 판단합니다.
        if left < len(self.data) and self.data[left] > self.data[smallest]:
            # 조건이 만족하는 경우, smallest 는 왼쪽 자식의 인덱스를 가집니다.
            smallest = left

        # 오른쪽 자식이 존재하는지, 그리고 오른쪽 자식의 (키) 값이 (무엇보다?) 더 큰지를 판단합니다.
        if right < len(self.data) and self.data[right] > self.data[smallest]:
            # 조건이 만족하는 경우, smallest 는 오른쪽 자식의 인덱스를 가집니다.
            smallest = right

        # 만약 이 인덱스가 i와 같지 않다면 자식들 중에 나보다 큰 키값을 가진 노드가 발견된 경우
        if smallest != i:
            # 현재 노드 (인덱스 i) 와 최댓값 노드 (왼쪽 아니면 오른쪽 자식) 를 교체합니다.
            self.data[i], self.data[smallest] = self.data[smallest], self.data[i]
            # 재귀적 호출을 이용하여 최대 힙의 성질을 만족할 때까지 트리를 정리합니다.
            self.maxHeapify(smallest)

def solution(x):
    return 0