학습내용
- 머신러닝 기본 개념
- 머신러닝 기술 원리
- 머신러닝 주요 알고리즘1
- 머신러닝 주요 알고리즘2
학습 목표
- 머신러닝 이론을 이해하고 주요 알고리즘을 활용할 수 있다.
머신러닝 프로세스
데이터 수집 > 데이터 정리 > 테스트 데이터셋/ 모델학습 > 모델 테스트 > 모델 배포
1. 머신러닝 기본 개념
머신러닝 기본 개념
-
과거 : Data, Model, Prediction
사람이 직접 알고리즘을 코딩하거나 패턴을 만들어 결과를 얻음 -
AI/머신러닝 : Data, Model, Prediction
데이터와 결과를 기반으로 스스로 패턴 학습하고 이를 이용해서 예측
Linear Regression (직선 회귀)
- 가설: "공부를 많이 하면 공부를 잘할 것이다."
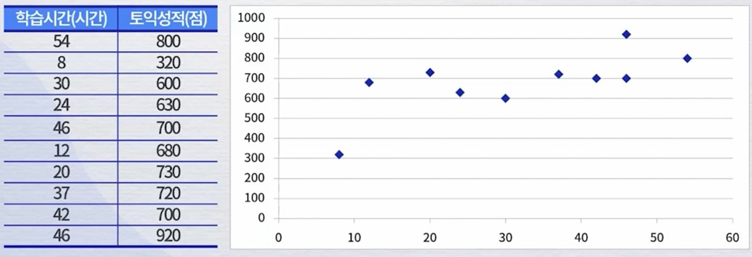
y=ax+b
가장 잘 맞는 직선을 구한다는 의미는?
- a와 b를 잘맞춘다. y=wx w는 가중치, x는 학습 시간, y는 토익 성적
컴퓨터는 W 가중치가 최적인지 어떻게 알 수 있을까?
- y=wx -> Cost Function 사용
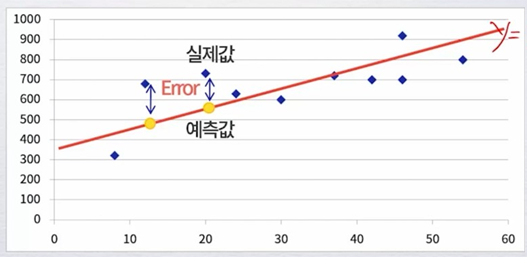
- 예측값 - 실제값 = error, cost
- Cost Function = (실제값-예측값)2/N -> MSE(Mean Squared Error)
Gradient Descent Algorithm (경사 하강)
Cost Function을 어떻게 최적화 할 것인가?
- 그래프상에서 비용이 제일 낮은 아래부분(기울기 0)을 찾으면 된다!
- Cost 가장 낮아지는 수준까지 진행하면서 가중치 업테이트 진행
W:=W−η⋅∇L(W)
- W: 가중치 벡터 (학습하고자 하는 변수)
- η: 학습률 (learning rate)
- ∇L(W): 손실 함수 L(W)에 대한 W의 그래디언트
모델 학습이란?
- (1) 목표: 최적 직선 구하기
- (2) 직선별 손실함수 구하기
- (3) 손실 함수 최소값 구하기
- (4) Gradient Descent Algorithm 이용
2. 머신러닝 기술 원리
데이터 확보
- 잘 정리된 데이터 확보가 중요!
지도 학습 (Supervised Learning)
- 정답을 알려주면서 진행하는 학습
- 데이터와 레이블(정답)이 함꼐 제공됨
- 레이블(Label) = 정답, 실제값, 타깃, 클래스, y
- 예측된 값 = 예측값, 분류값, ŷ(y hat)
비지도 학습 (Un-Supervised Learning)
- 레이블(정답) 없이 진행되는 학습
- 데이터 자체에서 패턴을 찾아내야 할 때 사용함
지도학습 모델 종류
분류 모델 (Classification)
- 레이블의 값들이 이산적으로 나눠질 수 있는 문제에 사용
- ex. 밥값이 많이 나오면 남성, 적게 나오면 여성
예측 모델 (Regression, 회귀모델)
- 레이블의 값들이 연속적인 문제에 사용
- ex. 밥값이 많이 나올수록, 팁의 크기도 게속 커짐
지도학습 데이터셋 구조
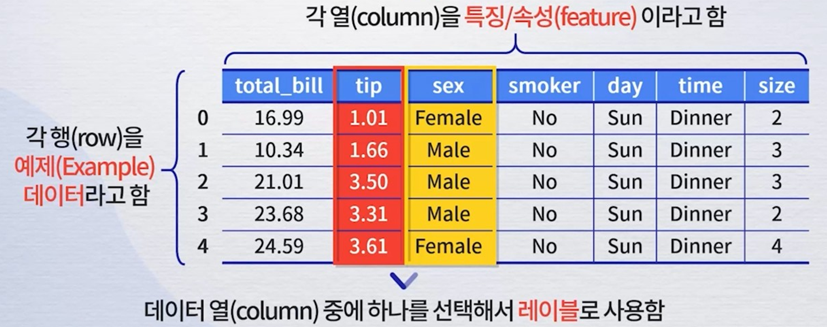
데이터셋 분리
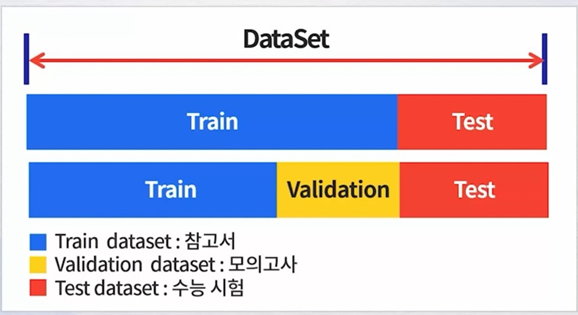
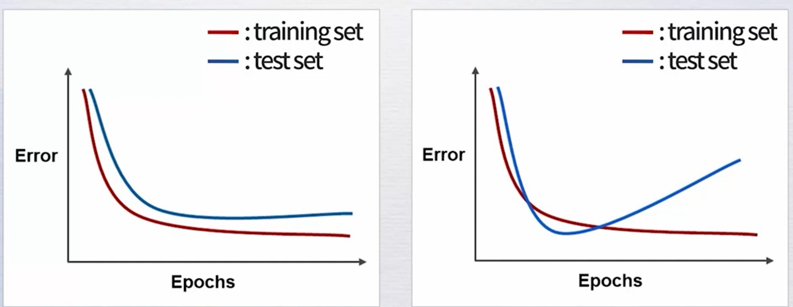
모델 선택
- 데이터 -> 좋은 모델 : 데이터들에 대해서 완만한 직선을 그림
- 데이터 -> 과적합(Overfitting) : 학습한 데이터들에 대해서는 잘하지만, test data 에서는 좋은 성적을 얻을 없음
- 데이터 -> 과소적합(Underfitting) : 학습을 덜했기 떄문에 패턴을 따라가지 못함
모델 성능 평가
Confusion Matrix(오차행렬)
- 모델의 대략적인 성능 확인과 모딜의 성능을 오차 행렬을 기반으로 수치로 표현
- True Positive(TP): True를 True로 예측(정답)
- True Negative(TN): False를 False로 예측(정답)
- False Positive(FP): False를 True로 예측(오답)
- False Negative(FN): True를 False로 예측(오답)
성능지표
- 학습이 끝난 후 모델을 평가하는 용도로 사용됨
정밀도 (Precision)
- 모델이 Ture라고 분류한 것 중에서 실제 True인 것의 비율
- 날씨 예측 모델이 맑다로 예측했는데, 실제 날씨가 맑았는지 나타낸 지표
- (Precision) = TP / (TP+FP)
재현율 (Recall)
- 실제 True인 것중에서 모델이 True라고 예측한 것의 비율
- 실제 날씨가 맑은 날 중에서 모델이 맑다고 예측한 비율을 나타낸 지표
- (Recall) = TP / (TP+FN)
정확도 (Accuracy)
- 가장 직관적으로 모델의 성능을 나타낼 수 있는 평가 지표
- 한 달에 맑은 날이 28일이고 비가 오는 날이 2일인 경우, 비가 오는 것을 예측하는 성능은 매우 낮을 수 밖에 없으믈 이를 보완할 지표가 필요
- (Accuracy) = (TP+TN)/(TP+FN+FP+TN)
F1 점수 (F1-score)
- 정밀도와재현울의 조화 평균
- F1-score=2⋅(Precision+Recall)/(Precision⋅Recall)
3. 머신러닝 주요 알고리즘1
Scikit-learn
- 가장 인기 있는 머신러닝 패키지, 많은 머신러닝 알고리즘이 내장되어 있음
- from sklearn.family import Model
머신러닝 주요 알고리즘 분류
회귀
- Linear Regression
분류
- Logistic Regression
회귀 분류
- Decision Tree
- Random Forest
- K-Nearest Neighbor
Linear Regression
- 최적의 기울기 w 구하기
from sklearn.lenear_model import LinearRegression
model = LinearRegression()
model.fit(X_train, Y_train)
pred = model.predict(X_test)
Logistic Regression
- 이진 분류 규칙은 0과 1의 두 클래스를 갖는 것으로, 일반 선형 회귀 모델을 이진 분류에 사용하기 어려움
- 로지스틱(logistic)함수를 사용하여 로지스틱 회귀 곡선으로 변환하여 이진 분류 할 수 있음
- σ(z)= 1/(1+e^(−z))
z: 입력 값
e: 자연상수 (≈2.718)
from sklearn.linear_model import LogisticRegression
model=LogisticRegression()
model.fit(X_train, Y_train)
pred = model.predict(X_test)
K-Nearest Neighbor
- 새로운 데이터가 주어졌을 때 기존 데이터 가운데 가장 가까운 k개의 이웃의 정보로 새로운 데이터를 예측하는 방법론
from sklearn.neighbors import KNeighborsClassifier
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, Y_train)
pred = knn.predict(X_test)
Decision Tree
- 분류와 회귀 작업이 가능한 다재다능한 머신러닝 알고리즘
- 복잡한 데이터셋도 학습할 수 있으며 강력한 머신러닝 알고리즘인 랜덤 포레스트의 기본 구성 요소
from sklearn.tree import DecisionTreeClassifier
model = DecisionTreeClassifier(max_depth=2)
model.fit(X_train, Y_train)
pred = model.predict(X_test)
Random Forest
- 일련의 예측기(분류, 회귀모델)로부터 예측을 수집하면 가장 좋은 모델 하나보다 더 좋은 예측을 얻을 수 있음
- 훈련 세트로부터 무작위로 각기 다른 서브셋을 만들어 일련의 결정 트리 분류기를 훈련시킬 수 있음
from sklearn.ensemble import RandomForestClassifier
model = RandomForestClassifier(n_estimatiors=50)
model.fit(X_train, Y_train)
pred = model.predict(X_test)
4. 머신러닝 주요 알고리즘2
Ensemble
- 여러 개의 분류기를 생성하고, 그 예측을 결합함으로써 보다 정확한 예측을 도출하는 기법
- 약한 모델 여러 개를 조합하여 더 정확한 예측 방식
적절한 Hyperparameter 튜닝이 중요
Ensemble 기법
1) Boosting
- 이전 학습에 대하여 잘못 예측된 데이터에 가중치를 부여해 오차를 보완해 나가는 방식
- 대표 모델: XGBoost, LightGBM
- 순차적인 학습을 하며 weight(가중치)를 부여해서 오차를 보완하므로 학습 시간이 길 수 있음
2) Stacking
- 여러 개 모델이 예측한 결과 데이터를 기반으로 final_estimator 모델로 종합하여 예측 수행
- 성능은 향상될 수 있으나 과대 적합을 유발할 수 있음
3) Weighted Blending
- 각 모델의 예측값에 대하여 weight를 곱하여 최종 output 계산
- 가중치의 합은 1.0이 되도록 함
Ensemble 대표 모델
1) XGBoost
!pip install xgboost
from xgboost innport XGBClassifier
model = XGBClassifier(n_estimators=50)
model.fit(X_train, y_train)
pred = model.predict(X_test)
2) LightGBM
!pip install lightgbm
from xgboost innport LGBMClassifier
model = LGBMClassifier(n_estimators=50)
model.fit(X_train, y_train)
pred = model.predict(X_test)
머신러닝
기본 개념
- 최적의 선을 긋는 것
- Cost Function
- Gradient Decent(경사하강법)
기술 원리
- 지도 학습 vs 비지도 학습
- 회귀와 분류
- 데이터 확보/전처리 시간 소요
- 모델 성능 지표
주요 알고리즘
- Linear Regression
- Logistic Regression
- Decision Tree
- LightGBM
- XGBoost
- Random Forest
