학습 목표
- 딥러닝 기본 개념
- 딥러닝 기술 원리
- 딥러닝 주요 알고리즘 1
- 딥러닝 주요 알고리즘 2
학습 내용
- DNN, CNN, RNN 모델을 구성하고, 모델 성능을 평가할 수 있다.
1. 딥러닝 기본 개념
어떻게 강아지와 고양이를 인식해서 분류할 수 있을까?
- 데이터를 통해 패턴을 배우자!
딥러닝 목표
- 모델에 입력값을 넣었을 떄의 출력값이 최대한 정답과 일치하게 하는 것
딥러닝 학습 방법
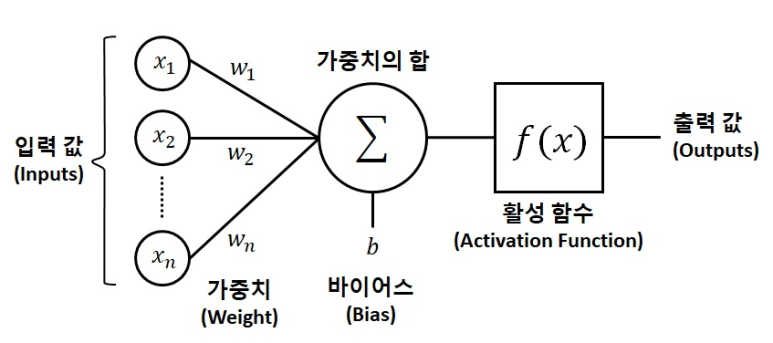
- 딥러닝 모델의 매개변수(weight, bias)를 무작위로 부여한 후, 반복학습을 통해 모델의 출력값을 정답과 일치하도록 매개변수를 조금씩 조정함.
→ Gradient Descent 최적화 알고리즘
2. 딥러닝 기술 원리
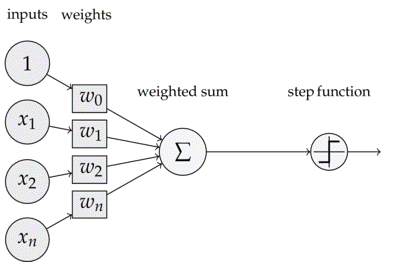
Perceptron
-
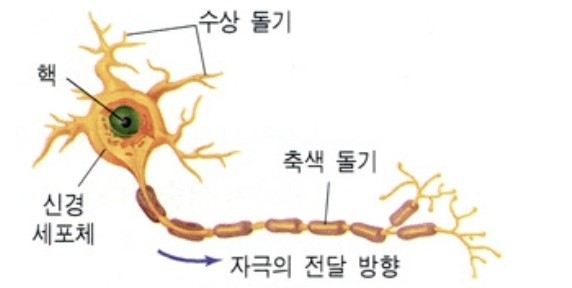
사람 두뇌에 있는 뉴런을 모델링한 것
→ 간단한 함수를 학습할 수 있음 -
뉴런
-
퍼셉트론(Perceptron) 모델
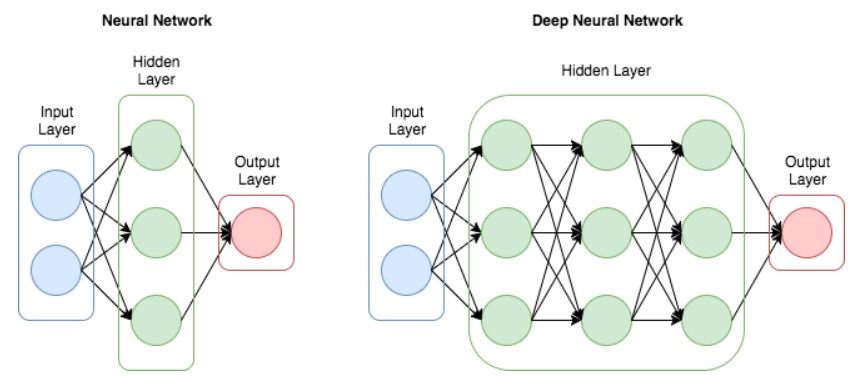
DNN(Deep Neural Network)
- 입력층과 출력층 사이에 여러 개의 은닉층(hidden layer)으로 이루어진 인공신경망
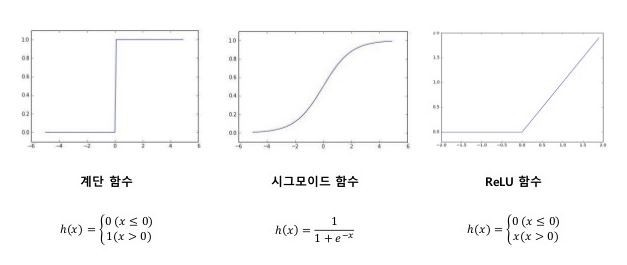
→ 신경망 출력에 비선형 활성화 함수를 추가하여 복잡한 비선형 관계를 모델링 할 수 있음
Activation function
Loss Function
-
신경망 학습의 목적함수로 출력값(예측값)과 정답(실제값)의 차이를 계산
-
회귀 (Regression)
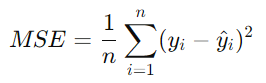
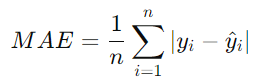
-
분류 (Classification)
→ 이진분류(Binary cross-entropy)
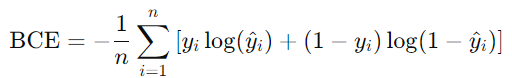
→ 다중 분류(Categorical cross-entropy)
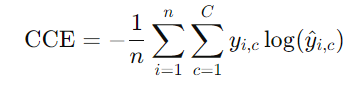
Gradient Descent
- 뉴럴넷이 가중치 파라미터들을 최적화하는 방법
→ 손실함수의 현 가중치에서 기울기(Gradient)를 구해서 Loss를 줄이는 방향으로 업데이트 해 나감
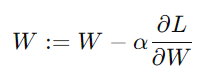
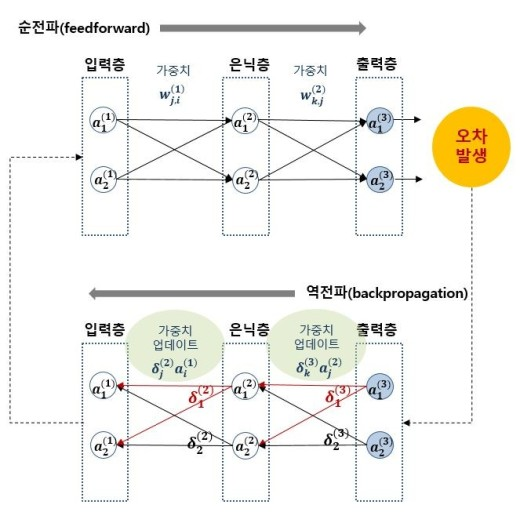
Back Propagation
- 실제값과 모델 결과 값에서 오차를 구해서 오차를 output에서 input 방향으로 보냄
→ 가중치를 재업테이트 하면서 학습
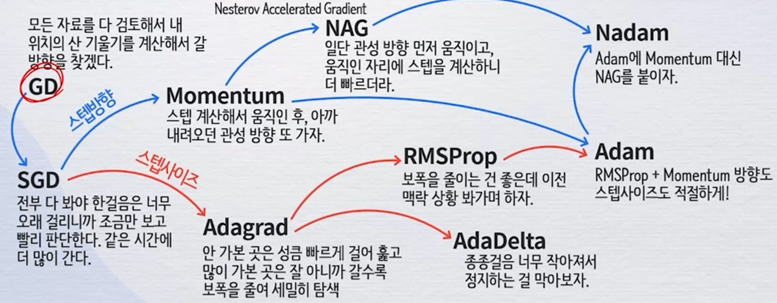
Optimization Algorithm
<딥러닝 용어 정리>
- Forward Propagation : 딥러닝 모델에 값을 입력해서 출력을 얻는 과정
- Error Backpropagation : 실제값과 모델 결과 값에서 오차를 구해서 오차를 input 방향으로 보내서 가중치를 재업데이트 하는 과정
- Loss Function : 신경망 학습의 목적으로(목적 함수) 출력값과 정답의 차이를 계산
- Optimization : 딥러닝 모델의 매개변수(weight, bias)를 조절해서 손실함수의 값을 최저로 만드는 과정
→ 경사하강법이 대표적 - Data Set
1 Epoch : 모든 데이터 셋을 한 번학습
1 iteration : 1화 학습
Minibatch : 데이터 셋을 batch size 크기로 쪼개서 학습
3. 딥러닝 주요 알고리즘
DNN 구현
-
DNN 모델 Layout
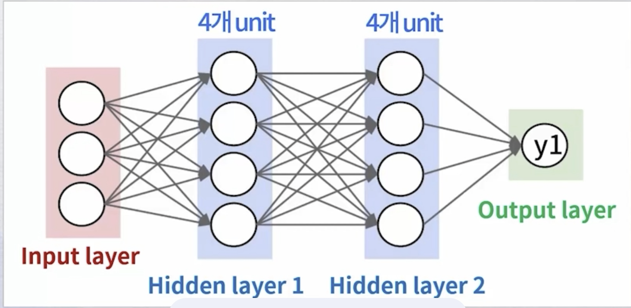
-
Dropout
과적합(Overfitting) 방지용, Train 학습 시에만 활용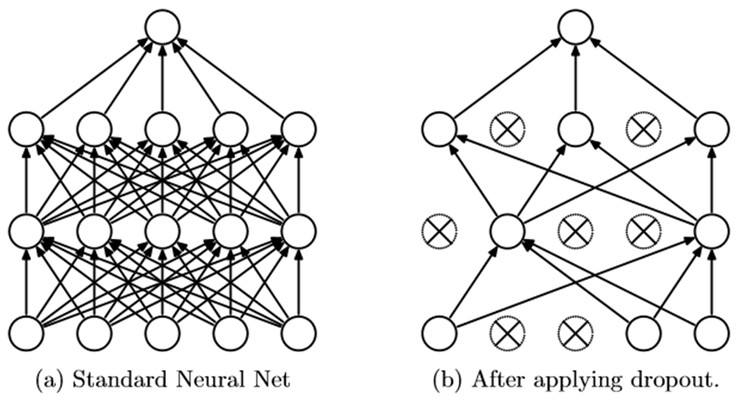
-
라이브러리 임포트
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Dropout
- 모델 생성 및 트레이닝
model = Sequential()
model.add(Dense 4, input_shape=(3,),activation='relu'))
model.add(Dropout(0.2))
model.add(Dense(4,activation='relu'))
model.add(Dense(1,activation='sigmoid'))

model.compile(loss='binary_crossentropy',optimizer='adam',metrice=['acc'])
history=model.fit(X_train,y_train,validation_data =(X_test, y_test), epochs=40,batch_size=10)
4. 딥러닝 주요 알고리즘2
CNN (Convolutional Neural Network)
DNN(Deep Neural Network)
- 이미지 처리를 DNN(Fully Connected Neural NEtwork) 수행 시 문제점
- 이미지 1차원 형태로 처리 : 위치 정보 소실 → 정보소실
- 이미지 사이즈가 커질 경우 비례해서 학습할 가중치 증가
CNN(Convolutional Neural Network)
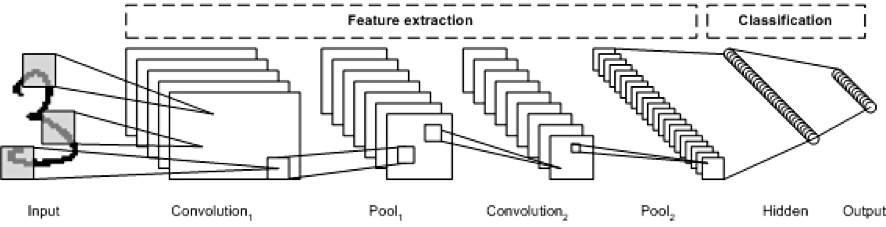
- 이미지의 특징을 추출하는 부분과 클래스를 분류하는 부분
- 특징 추출 영역: Convolution Layer와 Pooling Layer를 여러 겹 쌓는 형태로 구성
- 클래스 분류 영역 : Fully Connected Layer 구성하여 사용
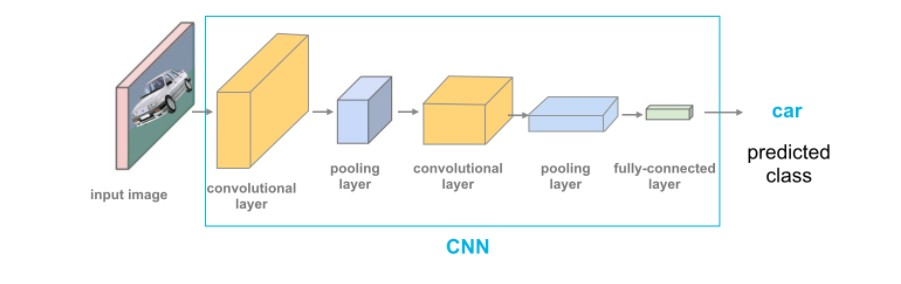
Convolutional Filter
- 가중치 필터로 학습되며, 이미지 특징/패턴 찾아내 이미지 분류가 가능함
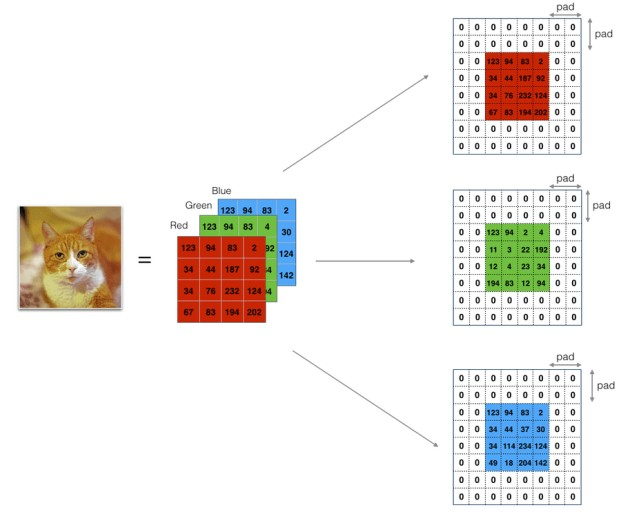
Padding
- Convolutional layer의 출력 데이터가 줄어드는 것을 방지하는 방법
→ 입력 데이터의 외곽에 0으로 채워 넣는 것
Pooling Layer
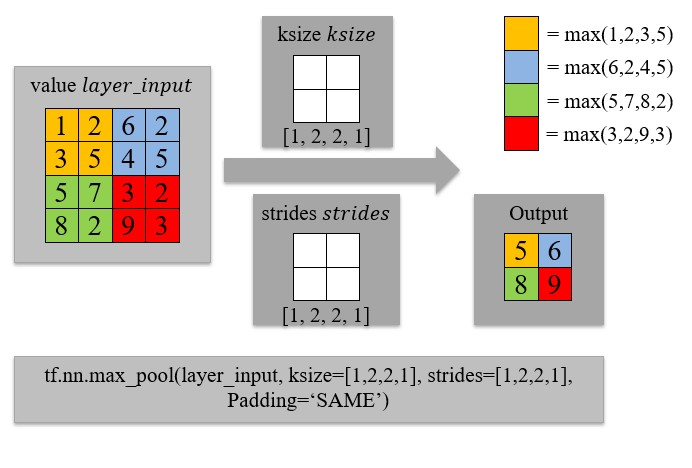
- 계산량, 메모리 사용량, 파라미터 수를 줄이기 위해 입력 이미지의 sub sample(축소본)을 만드는 것
→ 출력 데이터의 크기를 줄이거나 특정 데이터를 강조하는 용도로 사용
CNN 구성
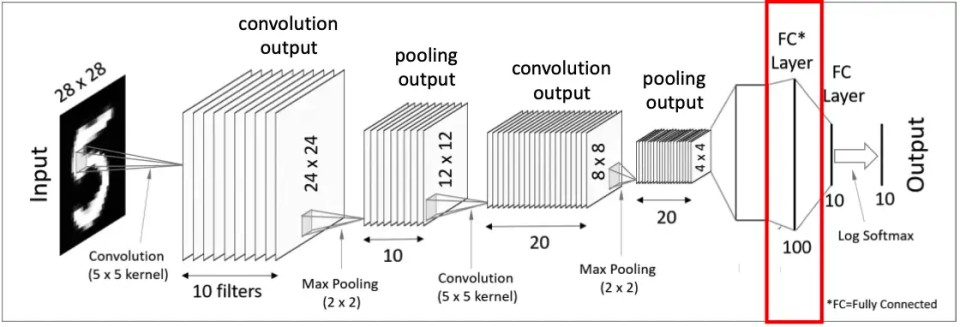
CNN 구현
import tensorflow as tf
from tensorflow import keras
from tensorflow.keras import layers
import numpy as np
import matplotlib.pyplot as plt

# 1️⃣ 데이터 불러오기 (MNIST 데이터셋)
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()

# 2️⃣ 데이터 전처리
x_train = x_train.reshape(-1, 28, 28, 1).astype("float32") / 255.0
x_test = x_test.reshape(-1, 28, 28, 1).astype("float32") / 255.0

# 3️⃣ CNN 모델 정의
model = keras.Sequential([
    layers.Conv2D(32, (3,3), activation='relu', input_shape=(28,28,1)),  # 3x3 필터 32개
    layers.MaxPooling2D((2,2)),  # 2x2 풀링
    layers.Conv2D(64, (3,3), activation='relu'),  # 3x3 필터 64개
    layers.MaxPooling2D((2,2)),  # 2x2 풀링
    layers.Flatten(),  # 1D로 변환
    layers.Dense(128, activation='relu'),  # 완전 연결층
    layers.Dense(10, activation='softmax')  # 출력층 (0~9 숫자 분류)
])

# 4️⃣ 모델 컴파일
model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])

# 5️⃣ 모델 학습
model.fit(x_train, y_train, epochs=5, batch_size=32, validation_split=0.1)

# 6️⃣ 테스트 데이터 평가
test_loss, test_acc = model.evaluate(x_test, y_test)
print(f"테스트 정확도: {test_acc:.4f}")

# 7️⃣ 예측 샘플 출력
predictions = model.predict(x_test[:5])

# 8️⃣ 결과 시각화
plt.figure(figsize=(10, 3))
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(x_test[i].reshape(28,28), cmap='gray')
    plt.title(f"예측: {np.argmax(predictions[i])}")
    plt.axis('off')
plt.show()
RNN
- Recurrent Neural Network(순환신경망)
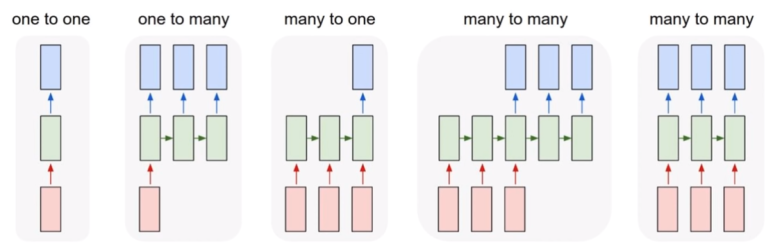
- 입력과 출력을 시퀀스(sequence) 단위로 처리하는 모델
→ 음성인식, 언어 모델링, 번역, 이미지 주석 생성에 활용 - 히든 노드가 방향을 가진 엣지로 연결돼 순환구조를 이루는(directed cycle) 인공신경망의 한 종류
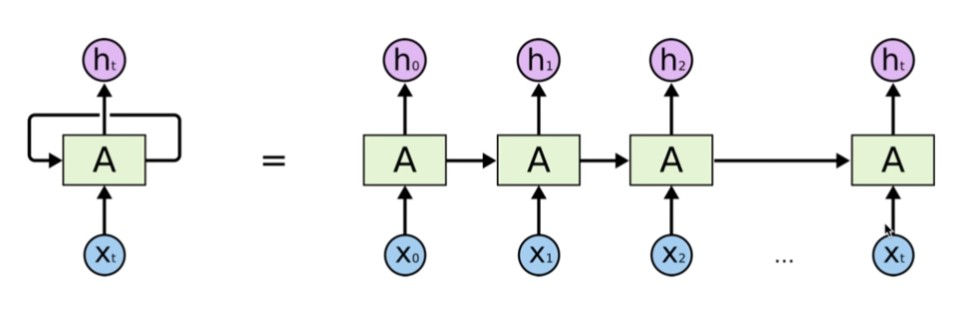
RNN 구조
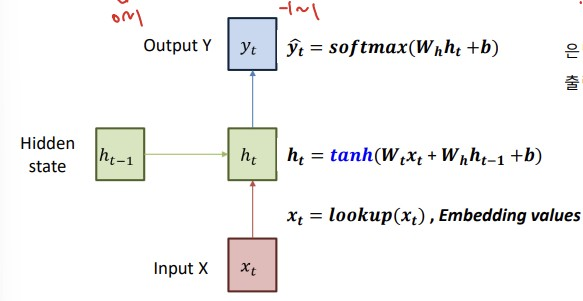
- RNN이 학습하는 파라미터는 무엇일까?
RNN의 다양한 구조
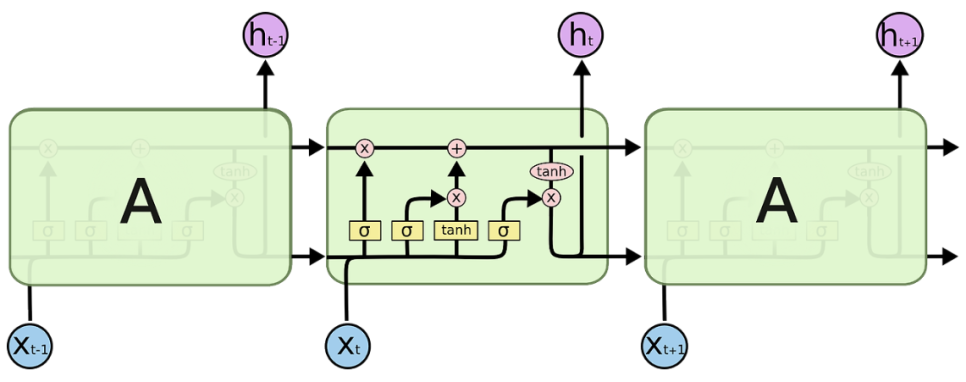
LSTM(Long Short-Term Memory)
-
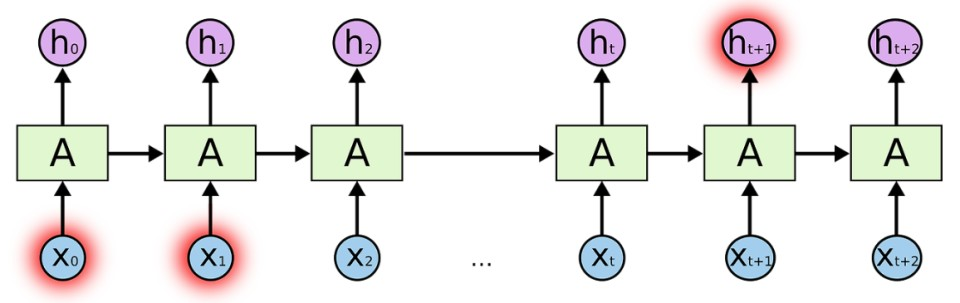
RNN 문제점(vanishing gradient problem)
RNN은 관련 정보와 그 정보를 사용하는 지점 사이 거리가 멀 경우 역전파 시 그래디언트가 점차 줄어 학습능력이 크게 저하되는 것으로 알려져 있음
-
RNN의 히든 state에 cell-state를 추가한 구조
-
오랫동안 정보를 전달할 수 있음
→ 문장과 같은 단어가 문장 안에서의 순서가 중요한 경우나 주가와 같은 시계열 데이터 효과
LSTM 구현
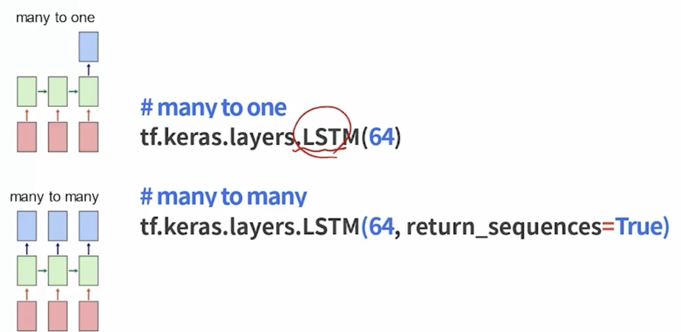
model.add(LSTM(4,input_shape=(7,2),return_sequences=True))->#,7,4
model.add(LSTM(3,return_sequences=True))=>#,7,3
model.add(Flatten())
model.add(dense(1,activation='sigmoid'))