1. Introduction
Variational Bayesian method
구하고자 하는 조건부 확률 P ( Z ∣ X ) P( Z | X ) P ( Z ∣ X )
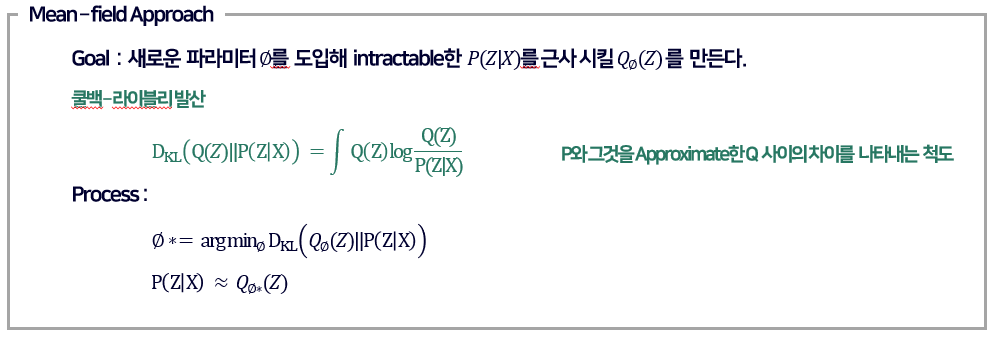
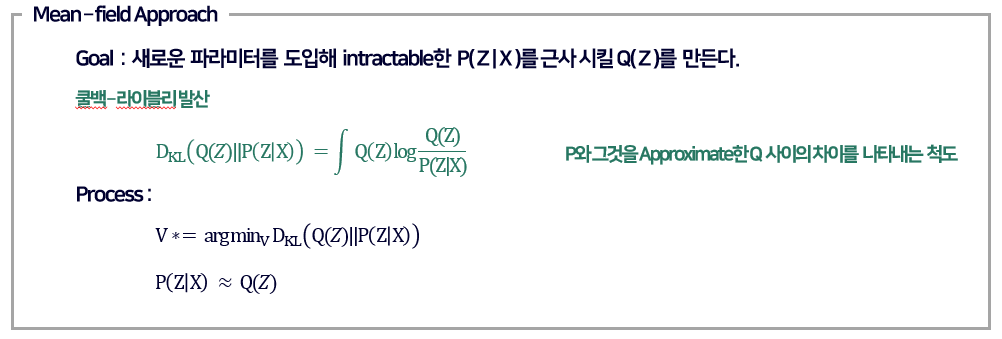
이 방법에서는 흔히 Mean-field Approach 라고 불리는 기법을 사용하는데, P ( Z ∣ X ) P(Z|X) P ( Z ∣ X ) Q ( Z ) Q(Z) Q ( Z ) Q ( Z ) Q(Z) Q ( Z ) Q ( Z ) Q(Z) Q ( Z )
연구진은 SGVB – Reparameterization trick 을 사용해 Mean-field Approach 를 위와 같이 변형함으로써 문제를 해결했다.
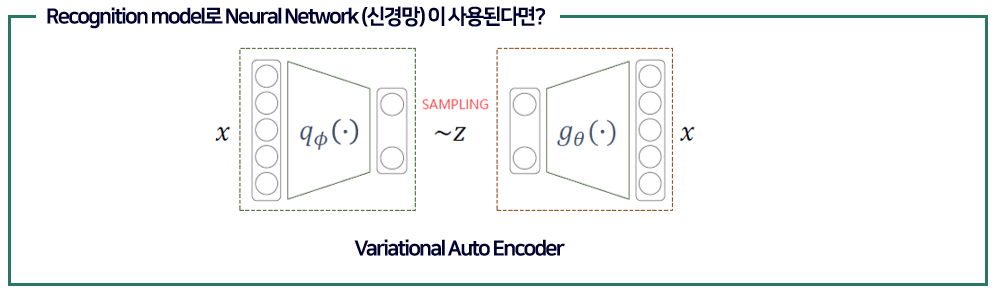
Recognition model q ∅ ( z ∣ x ) q_{\varnothing}(z|x) q ∅ ( z ∣ x )
데이터 x를 바탕으로 latent variable z z z p θ ( z ∣ x ) p_{\theta}(z|x) p θ ( z ∣ x )
AEVB (Auto-Encoding Variational Bayesian)
SGVB 기법을 사용해 Recognition model 을 학습시킨다
기존의 고비용 추론 모델 (ex : MCMC 알고리즘) 의 도움 없이 효율적으로 모델을 학습할 수 있다
학습된 모델은 인식, 노이즈 제거, 시각화에 쓰일 수 있다
VAE는 Auto Encoder와 동일한 구조를 갖지만, 오토인코더는 데이터를 압축하기 위한 앞단을 학습하기 위해 뒷단을 붙인 반면 Variational 오토 인코더는 데이터를 생성하기 위한 뒷단을 학습하기 위해 앞단을 붙이게 되었다.
2. Method
전제 조건
모든 데이터는 서로 독립적이고 동일한 확률분포를 갖는다 (i.i.d)
모든 데이터에 잠재 변수 (latent variable)가 있다
Global Parameters (θ \theta θ ∅ \varnothing ∅ ML 또는 MAP 추정을 시행하고, Latent Variables 에 대해서는 Variational Inference 를 시행한다Global Parameters 에 대해서도 Variational Inference 를 시행할 수 있지만 이것에 대한 실험은 나중의 작업에 맡긴다
문제 상황
i.i.d를 만족하는 연속 or 이산 변수 N개로 구성된 데이터셋 X = x ( i ) i = 1 N X = {x^{(i)}}^N_{i=1} X = x ( i ) i = 1 N
데이터 X X X 𝑝 θ ∗ ( 𝑥 ∣ 𝑧 ) 𝑝_{\theta ∗} (𝑥 | 𝑧) p θ ∗ ( x ∣ z ) Z Z Z 𝑝 θ ∗ ( 𝑧 ) 𝑝_{\theta *} (𝑧) p θ ∗ ( z )
𝑝 θ ∗ ( 𝑥 ∣ 𝑧 ) 𝑝_{\theta ∗} (𝑥 | 𝑧) p θ ∗ ( x ∣ z ) 𝑝 θ ∗ ( 𝑧 ) 𝑝_{\theta *} (𝑧) p θ ∗ ( z ) 𝑝 θ ( 𝑥 ∣ 𝑧 ) 𝑝_{\theta} (𝑥 | 𝑧) p θ ( x ∣ z ) 𝑝 θ ( 𝑧 ) 𝑝_{\theta} (𝑧) p θ ( z ) PDF 는 미분 가능하다θ ∗ \theta * θ ∗ z z z 계산 과정에서 확률을 간단하게 하는 가정을 만들지 않아 General 한 알고리즘을 도출할 것이다
목표
효율적인 ML or MAP 추정으로 θ \theta θ Generative Model 𝑝 θ ( 𝑧 ) 𝑝 θ ( 𝑥 ∣ 𝑧 ) 𝑝_{\theta}(𝑧) 𝑝_{\theta} (𝑥 | 𝑧) p θ ( z ) p θ ( x ∣ z )
데이터 x x x z z z 𝑝 θ ( 𝑧 ∣ 𝑥 ) 𝑝_{\theta} (𝑧 | 𝑥) p θ ( z ∣ x )
데이터 x x x P ( x ) P(x) P ( x ) P ( x ) P(x) P ( x )
목표 달성을 위한 아이디어
Intractable 한 𝑝 θ ( 𝑧 ∣ 𝑥 ) 𝑝_{\theta} (𝑧 | 𝑥) p θ ( z ∣ x ) Recognition model q θ ( z ∣ x ) q_{\theta} (z | x ) q θ ( z ∣ x ) mean-field 방식과는 다르게 θ \theta θ Closed-form 하게 계산될 필요가 없다.잠재 변수 z z z Code 라고 하면, q θ ( z ∣ x ) q_{\theta} (z | x ) q θ ( z ∣ x ) encoder , 𝑝 θ ( 𝑥 ∣ 𝑧 ) 𝑝_{\theta} (𝑥 | 𝑧) p θ ( x ∣ z ) decoder 로 볼 수 있다.
The variational bound
Total marginal likelihood p θ ( x ) p_{\theta}(x) p θ ( x )
l o g p θ ( x ( 1 ) , ⋅ ⋅ ⋅ , x ( N ) ) = ∑ i = 1 N l o g p θ ( x ( i ) ) log p_{\theta} (x^{(1)}, \cdot \cdot \cdot, x^{(N)}) = \sum_{i=1}^{N}log p_{\theta}(x^{(i)}) l o g p θ ( x ( 1 ) , ⋅ ⋅ ⋅ , x ( N ) ) = ∑ i = 1 N l o g p θ ( x ( i ) )
Marginal likelihood p θ ( x ( i ) ) p_{\theta}(x^{(i)}) p θ ( x ( i ) )
l o g p θ ( x ( i ) ) = D K L ( q ϕ ( z ∣ x ( i ) ) ∣ ∣ p θ ( z ∣ x ( i ) ) ) + L ( θ , ϕ ; x ( i ) ) log p_{\theta} (x^{(i)}) = D_{KL}(q_{\phi}(z|x^{(i)})||p_{\theta}(z|x^{(i)}))+L(\theta, \phi; x^{(i)}) l o g p θ ( x ( i ) ) = D K L ( q ϕ ( z ∣ x ( i ) ) ∣ ∣ p θ ( z ∣ x ( i ) ) ) + L ( θ , ϕ ; x ( i ) )
D K L ( ⋅ ⋅ ⋅ ) D_{KL}(\cdot\cdot\cdot) D K L ( ⋅ ⋅ ⋅ ) L ( θ , ϕ ; x ( i ) ) L(\theta, \phi; x^{(i)}) L ( θ , ϕ ; x ( i ) )
l o g ( p ( x ) ) = ∫ l o g ( p ( x ) ) q ϕ ( z ∣ x ) d z ∵ ∫ q ϕ ( z ∣ x ) d z = 1 log(p(x)) = \int log(p(x))q_\phi (z|x)dz\,\,\,\,\,\,\,\,\,\,\,\,\,\because \int q_\phi (z|x)dz=1 l o g ( p ( x ) ) = ∫ l o g ( p ( x ) ) q ϕ ( z ∣ x ) d z ∵ ∫ q ϕ ( z ∣ x ) d z = 1
= ∫ l o g ( p ( x , z ) p ( z ∣ x ) ) q ϕ ( z ∣ x ) d z ∵ p ( x ) = p ( x , z ) p ( z ∣ x ) \,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,=\int log({p(x,z)\over p(z|x)})q_\phi (z|x)dz\,\,\,\,\,\,\,\,\,\,\,\,\,\because p(x)={p(x,z)\over p(z|x)} = ∫ l o g ( p ( z ∣ x ) p ( x , z ) ) q ϕ ( z ∣ x ) d z ∵ p ( x ) = p ( z ∣ x ) p ( x , z )
= ∫ l o g ( p ( x , z ) q ϕ ( z ∣ x ) × q ϕ ( z ∣ x ) p ( z ∣ x ) ) q ϕ ( z ∣ x ) d z \,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,=\int log({p(x,z)\over {q_\phi (z|x)}}\times {q_\phi(z|x)\over {p(z|x)}})q_\phi(z|x)dz = ∫ l o g ( q ϕ ( z ∣ x ) p ( x , z ) × p ( z ∣ x ) q ϕ ( z ∣ x ) ) q ϕ ( z ∣ x ) d z
= ∫ l o g ( p ( x , z ) q ϕ ( z ∣ x ) ) q ϕ ( z ∣ x ) d z + ∫ l o g ( q ϕ ( z ∣ x ) p ( z ∣ x ) ) q ϕ ( z ∣ x ) d z \,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,=\int log({{p(x,z)}\over {q_\phi(z|x)}})q_\phi(z|x)dz+\int log({{q_\phi(z|x)}\over {p(z|x)}})q_\phi(z|x)dz = ∫ l o g ( q ϕ ( z ∣ x ) p ( x , z ) ) q ϕ ( z ∣ x ) d z + ∫ l o g ( p ( z ∣ x ) q ϕ ( z ∣ x ) ) q ϕ ( z ∣ x ) d z
= L ( θ , ϕ ; x ) + D K L ( q ϕ ( z ∣ x ) ∣ ∣ p ( z ∣ x ) ) \,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,=L(\theta,\phi;x)+D_{KL}(q_\phi (z|x)||p(z|x)) = L ( θ , ϕ ; x ) + D K L ( q ϕ ( z ∣ x ) ∣ ∣ p ( z ∣ x ) )
위와 같은 유도를 통해 Total marginal likelihood를 두 개의 항으로 나눌 수 있다.
이때, 두번째 항 D K L ( q ϕ ( z ∣ x ) ∣ ∣ p ( z ∣ x ) ) D_{KL}(q_\phi (z|x)||p(z|x)) D K L ( q ϕ ( z ∣ x ) ∣ ∣ p ( z ∣ x ) ) p ( z ∣ x ) p(z|x) p ( z ∣ x )
하지만 이 값은 항상 양수이기 때문에 첫번째 항을 Lower Bound로 보고 이것을 최대화하여 Total marginal likelihood에 가까워질 수 있다.
l o g p θ ( x ( i ) ) ≥ L ( θ , ϕ ; x ( i ) ) = − D K L ( q ϕ ( z ∣ x ( i ) ) ∣ ∣ p θ ( z ) ) + E q ϕ ( z ∣ x ( i ) ) [ l o g p θ ( x ( i ) ∣ z ) ] log \,p_{\theta}(x^{(i)})\geq L(\theta, \phi; x^{(i)})=-D_{KL}(q_\phi(z|x^{(i)})||p_\theta(z))+E_{q_\phi(z|x^{(i)})}[log p_\theta(x^{(i)}|z)] l o g p θ ( x ( i ) ) ≥ L ( θ , ϕ ; x ( i ) ) = − D K L ( q ϕ ( z ∣ x ( i ) ) ∣ ∣ p θ ( z ) ) + E q ϕ ( z ∣ x ( i ) ) [ l o g p θ ( x ( i ) ∣ z ) ]
목표는 m a x ϕ m a x θ L ( θ , ϕ ; x ( i ) ) max_\phi max_\theta L(\theta, \phi; x^{(i)}) m a x ϕ m a x θ L ( θ , ϕ ; x ( i ) ) q θ ( z ∣ x ) q_\theta(z|x) q θ ( z ∣ x )
이와 같은 문제를 해결하기 위해, 연구진은 Reparameterization trick이라는 이론을 만들었다.
자세한 내용은 뒤에서 다루고, 지금은 q ϕ ( z ∣ x ) q_\phi(z|x) q ϕ ( z ∣ x ) g ϕ ( ϵ , x ) g_\phi(\epsilon, x) g ϕ ( ϵ , x )
z ~ = g ϕ ( ϵ , x ) w i t h ϵ ∼ p ( ϵ ) \widetilde{z}=g_\phi(\epsilon, x)\,\,with\,\,\epsilon \sim p(\epsilon) z = g ϕ ( ϵ , x ) w i t h ϵ ∼ p ( ϵ )
이때, 샘플링 함수 g ϕ ( ϵ , x ) g_\phi(\epsilon, x) g ϕ ( ϵ , x ) ϵ \epsilon ϵ
E q ϕ ( z ∣ x ( i ) ) [ f ( z ) ] = E p ( ϵ ) [ f ( g ϕ ( ϵ , x ( i ) ) ) ] ≃ 1 L ∑ l = 1 L f ( g ϕ ( ϵ ( l ) , x ( i ) ) ) w h e r e ϵ ( l ) ∼ p ( ϵ ) E_{q_\phi(z|x^{(i)})}[f(z)]=E_{p(\epsilon)}[f(g_\phi(\epsilon, x^{(i)}))]\simeq {1\over L}\sum_{l=1}^Lf(g_\phi(\epsilon^{(l)}, x^{(i)}))\,\, where\,\,\epsilon^{(l)}\sim p(\epsilon) E q ϕ ( z ∣ x ( i ) ) [ f ( z ) ] = E p ( ϵ ) [ f ( g ϕ ( ϵ , x ( i ) ) ) ] ≃ L 1 ∑ l = 1 L f ( g ϕ ( ϵ ( l ) , x ( i ) ) ) w h e r e ϵ ( l ) ∼ p ( ϵ )
z ∼ q ϕ ( z ∣ x ( i ) ) z\sim q_\phi(z|x^{(i)}) z ∼ q ϕ ( z ∣ x ( i ) )
ϵ ∼ p ( ϵ ) \epsilon \sim p(\epsilon) ϵ ∼ p ( ϵ )
Reparametrization trick을 이용하면 아래와 같이 몬테카를로 추정을 할 수 있다.
몬테카를로 추정
E q θ ( z ∣ x ( i ) ) [ f ( z ) ] ≃ 1 L ∑ l = 1 L f ( g ϕ ( ϵ ( l ) , x ( i ) ) ) w h e r e ϵ ( l ) ∼ p ( ϵ ) E_{q_\theta(z|x^{(i)})}[f(z)]\simeq {1\over L}\sum^L_{l=1}f(g_\phi(\epsilon^{(l)}, x^{(i)})) \,\,where \,\,\epsilon^{(l)}\sim p(\epsilon) E q θ ( z ∣ x ( i ) ) [ f ( z ) ] ≃ L 1 ∑ l = 1 L f ( g ϕ ( ϵ ( l ) , x ( i ) ) ) w h e r e ϵ ( l ) ∼ p ( ϵ )
p ( ϵ ) p(\epsilon) p ( ϵ )
SGVB estimator (1st version)
L ( θ , ϕ ; x ( i ) ) = E q ϕ ( z ∣ x ( i ) ) [ − l o g q ϕ ( z ∣ x ( i ) ) + l o g p θ ( x ( i ) , z ) ] L(\theta, \phi; x^{(i)})=E_{q_\phi(z|x^{(i)})}[-log \,q_\phi(z|x^{(i)})+log\, p_\theta(x^{(i)}, z)] L ( θ , ϕ ; x ( i ) ) = E q ϕ ( z ∣ x ( i ) ) [ − l o g q ϕ ( z ∣ x ( i ) ) + l o g p θ ( x ( i ) , z ) ]
L ~ A ( θ , ϕ ; x ( i ) ) = 1 L ∑ l = 1 L − l o g q ϕ ( z ( i , l ) ∣ x ( i ) ) + l o g p θ ( x ( i ) , z ( i , l ) ) \widetilde{L}^A(\theta, \phi; x^{(i)})={1\over L}\sum^L_{l=1}-log\,q_\phi(z^{(i,l)|x^{(i)}})+log\,p_\theta(x^{(i)}, z^{(i, l)}) L A ( θ , ϕ ; x ( i ) ) = L 1 ∑ l = 1 L − l o g q ϕ ( z ( i , l ) ∣ x ( i ) ) + l o g p θ ( x ( i ) , z ( i , l ) )
w h e r e z ( i , l ) = g ϕ ( ϵ ( i , l ) , x ( i ) ) a n d ϵ ( l ) ∼ p ( ϵ ) \,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,where \,\,z^{(i, l)}=g_\phi(\epsilon^{(i, l)}, x^{(i)})\,\, and\,\, \epsilon^{(l)}\sim p(\epsilon) w h e r e z ( i , l ) = g ϕ ( ϵ ( i , l ) , x ( i ) ) a n d ϵ ( l ) ∼ p ( ϵ )
L ~ A ( θ , ϕ ; x ( i ) ) ≃ L ( θ , ϕ ; x ( i ) ) \widetilde{L}^A(\theta, \phi; x^{(i)})\simeq L(\theta, \phi; x^{(i)}) L A ( θ , ϕ ; x ( i ) ) ≃ L ( θ , ϕ ; x ( i ) )
이 방식은 Lower Bound 전체를 샘플링해 평균을 구해서 추정하는 방식이다.
SGVB estimator (2nd version)
L ( θ , ϕ ; x ( i ) ) = − D K L ( q ϕ ( z ∣ x ( i ) ) ∣ ∣ p θ ( z ) ) + E q ϕ ( z ∣ x ( i ) ) [ l o g p θ ( x ( i ) ∣ z ) ] L(\theta, \phi; x^{(i)})=-D_{KL}(q_{\phi}(z|x^{(i)})||p_\theta(z))+E_{q_\phi(z|x^{(i)})}[log\, p_\theta(x^{(i)}|z)] L ( θ , ϕ ; x ( i ) ) = − D K L ( q ϕ ( z ∣ x ( i ) ) ∣ ∣ p θ ( z ) ) + E q ϕ ( z ∣ x ( i ) ) [ l o g p θ ( x ( i ) ∣ z ) ]
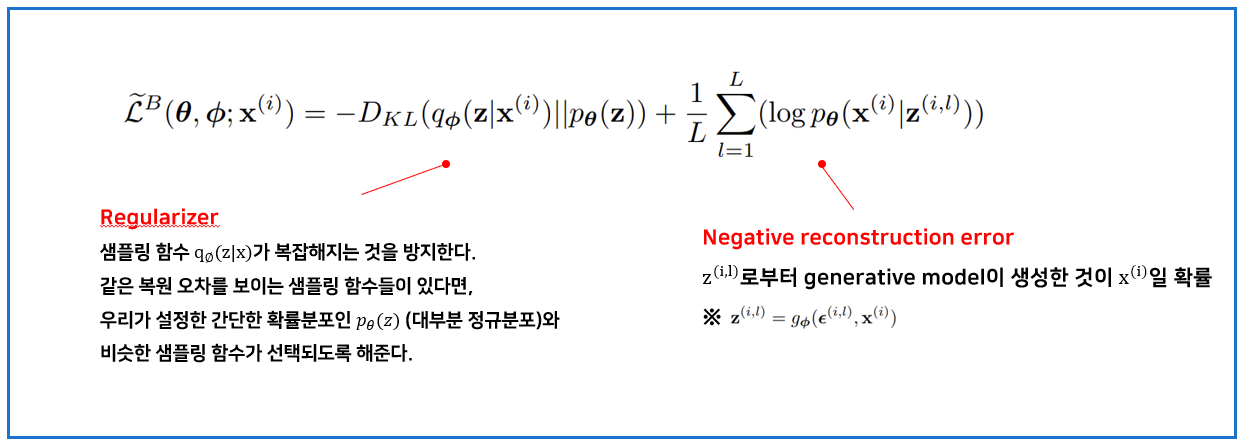
L ~ B ( θ , ϕ ; x ( i ) ) = − D K L ( q ϕ ( z ∣ x ( i ) ) ∣ ∣ p θ ( z ) ) + 1 L ∑ l = 1 L ( l o g p θ ( x ( i ) ∣ z ( i , l ) ) ) \widetilde{L}^B(\theta, \phi; x^{(i)})=-D_{KL}(q_{\phi}(z|x^{(i)})||p_\theta(z))+{1\over L}\sum^L_{l=1}(log\,p_\theta(x^{(i)}|z^{(i,l)})) L B ( θ , ϕ ; x ( i ) ) = − D K L ( q ϕ ( z ∣ x ( i ) ) ∣ ∣ p θ ( z ) ) + L 1 ∑ l = 1 L ( l o g p θ ( x ( i ) ∣ z ( i , l ) ) )
w h e r e z ( i , l ) = g ϕ ( ϵ ( i , l ) , x ( i ) ) a n d ϵ ( l ) ∼ p ( ϵ ) \,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,\,where\,\,\,\,z^{(i,l)}=g_\phi(\epsilon^{(i,l)},x^{(i)})\,\,\,\,and\,\,\,\,\epsilon^{(l)}\sim p(\epsilon) w h e r e z ( i , l ) = g ϕ ( ϵ ( i , l ) , x ( i ) ) a n d ϵ ( l ) ∼ p ( ϵ )
L ~ B ( θ , ϕ ; x ( i ) ) ≃ L ( θ , ϕ ; x ( i ) ) \widetilde{L}^B(\theta, \phi; x^{(i)})\simeq L(\theta, \phi; x^{(i)}) L B ( θ , ϕ ; x ( i ) ) ≃ L ( θ , ϕ ; x ( i ) )
이 방식은 p θ ( z ) p_\theta(z) p θ ( z ) q ϕ ( z ∣ x ) q_\phi(z|x) q ϕ ( z ∣ x )
따라서 쿨백-라이블리 발산은 샘플링 없이 계산 가능하고, 나머지 항만 샘플링해 추정한다.
전체 데이터셋의 lower bound의 marginal likelihood 계산 방법
L ( θ , ϕ ; X ) ≃ L ~ M ( θ , ϕ ; X M ) = N M ∑ i = 1 M L ~ ( θ , ϕ ; x ( i ) ) L(\theta, \phi; X)\simeq \widetilde{L}^M(\theta, \phi; X^M)={N\over M}\sum^M_{i=1}\widetilde{L}(\theta, \phi; x^{(i)}) L ( θ , ϕ ; X ) ≃ L M ( θ , ϕ ; X M ) = M N ∑ i = 1 M L ( θ , ϕ ; x ( i ) )
L ~ M ( θ , ϕ ; X M ) \widetilde{L}^M(\theta, \phi; X^M) L M ( θ , ϕ ; X M )
L ~ ( θ , ϕ ; x ( i ) ) \widetilde{L}(\theta, \phi; x^{(i)}) L ( θ , ϕ ; x ( i ) )
전체 N개의 데이터 중 minibatch X M = x ( i ) i = 1 M X^M={x^{(i)}}^M_{i=1} X M = x ( i ) i = 1 M
이후 추정한 estimator를 미분해 gradient를 구하고 SGD나 Adagrad로 최적화해 θ \theta θ ϕ \phi ϕ
오토 인코더와의 연관성
Reparametrization trick
문제 상황
q θ ( z ∣ x ) q_\theta(z|x) q θ ( z ∣ x ) z ∼ q θ ( z ∣ x ) z\sim q_\theta(z|x) z ∼ q θ ( z ∣ x )
해결 방법
z ( i , l ) = g ϕ ( ϵ ( i , l ) , x ( i ) ) w h e r e ϵ ∼ p ( ϵ ) z^{(i,l)} = g_\phi(\epsilon^{(i,l)}, x^{(i)})\,\,\,where\,\,\,\epsilon\sim p(\epsilon) z ( i , l ) = g ϕ ( ϵ ( i , l ) , x ( i ) ) w h e r e ϵ ∼ p ( ϵ )
q θ ( z ∣ x ) q_\theta(z|x) q θ ( z ∣ x ) z z z g g g g g g
E x ) Ex) E x )
z ∼ p ( z ∣ x ) = N ( μ , σ 2 ) z\sim p(z|x)=\mathcal{N}(\mu, \sigma^2) z ∼ p ( z ∣ x ) = N ( μ , σ 2 ) μ \mu μ σ \sigma σ
z = μ + σ ϵ w h e r e ϵ ∼ N ( 0 , 1 ) z=\mu+\sigma \epsilon \,\,\,where \,\,\,\epsilon\sim \mathcal{N}(0,1) z = μ + σ ϵ w h e r e ϵ ∼ N ( 0 , 1 )
∴ E N ( z ; μ , σ 2 ) [ f ( z ) ] = E N ( ϵ ; 0 , 1 ) [ f ( μ + σ ϵ ) ] ≃ 1 L ∑ l = 1 L f ( μ + σ ϵ ( l ) ) w h e r e ϵ ( l ) ∼ N ( 0 , 1 ) \therefore\,\mathbb{E}_{\mathcal{N}(z;\mu,\sigma^2)}[f(z)]=\mathbb{E}_{\mathcal{N}(\epsilon;0,1)}[f(\mu+\sigma\epsilon)]\simeq {1\over L}\sum^L_{l=1}f(\mu+\sigma\epsilon^{(l)})\,\,where\,\,\epsilon^{(l)}\sim\mathcal{N}(0,1) ∴ E N ( z ; μ , σ 2 ) [ f ( z ) ] = E N ( ϵ ; 0 , 1 ) [ f ( μ + σ ϵ ) ] ≃ L 1 ∑ l = 1 L f ( μ + σ ϵ ( l ) ) w h e r e ϵ ( l ) ∼ N ( 0 , 1 )