3. Variational Auto-Encoder
Key Point
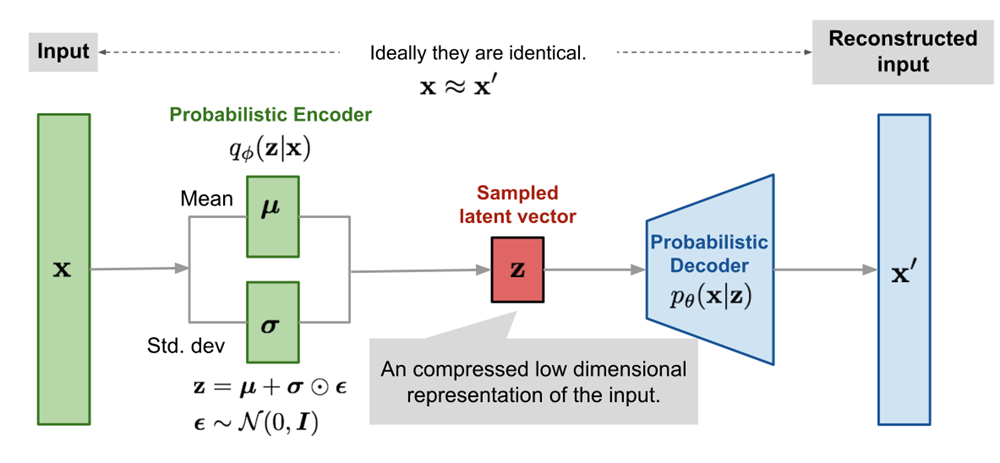
- 를 Neural Network로 구현해 Auto-Encoder와 같은 구조를 갖는다
- AEVB 알고리즘으로 와 를 최적화한다
수식 설명
데이터의 분포 를 구하고 싶지만 잠재 변수 를 모르기 때문에 계산이 불가능하다.
를 알면 베이즈 정리를 이용해 를 우회해서 구할 수 있지만 이 역시 모른다.
따라서 를 로 근사시키고 Reparametrization trick을 이용한다.
가 정규 분포라고 설정하면 와 가 학습되어야 하는데, VAE에서 이들은 Neural Network로 만들어진 Encoder를 통해 학습된다.
Lower Bound 수식
또한 정규 분포라고 설정하면 Lower Bound의 첫번째 항인 쿨백-라이블리 발산을 정해진 공식에 따라 계산할 수 있고, 나머지 항은 몬테카를로 추정을 통해 구할 수 있다.
이때, 흑백 사진처럼 데이터가 Binary할때는 로 베르누이 분포를 설정하고, 칼라 얼굴 사진처럼 데이터가 Continuous하면 가우시안 분포를 설정한다.
4. Experiments
비교 대상
Wake-sleep Algorithm
- VAE를 제외하고 연속적인 잠재 변수에 general하게 적용될 수 있는 유일한 on-line 학습 방식이다
- VAE의 처럼 True posterior 를 근사시키는 Recognition model이 있다
- 두가지 목적 함수가 동시에 최적화되어야 하는데, 이는 Marginal Likelihood 의 최적화와 일치하지 않는다는 단점이 있다
- 이산적인 잠재 변수에도 적용될 수 있다는 장점이 있다
- AEVB 알고리즘과 동일한 시간복잡도를 갖는다
Monte Carlo EM
- Encoder 없이 posterior의 gradient를 이용한 MCMC로 10개의 샘플 z를 만들어낸다
- 얻은 샘플로 Adagrad optimizer 방식을 이용해 5번의 가중치 학습을 진행한다
실험 1. Variational Lower Bound
MNIST 데이터셋을 이용해 Wake-sleep 알고리즘과 VAE의 AEVB 알고리즘을 잠재 변수 의 차원에 따라서 비교한 실험이다.
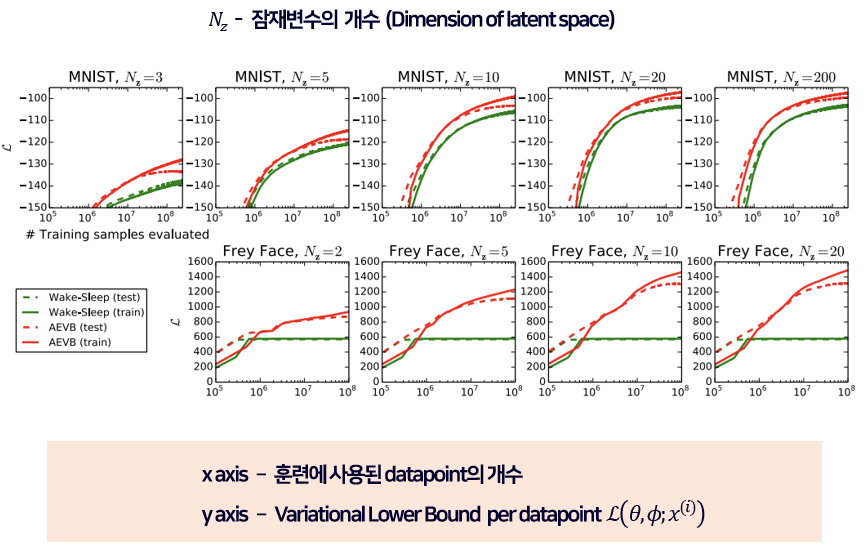
모든 경우에서 AEVB 알고리즘이 더 빠르게 수렴했으며 더 높은 Lower Bound를 보여주었다.
또한 잠재 변수의 차원을 높이더라고 오버피팅이 일어나지 않았는데, 이는 VAE의 Lower Bound에 있는 Regularizer의 덕분으로 볼 수 있다.
실험 2. Marginal Likelihood
MNIST 데이터셋을 이용해 Wake-sleep 알고리즘, AEVB 알고리즘, Monte-Carlo EM 알고리즘의 Marginal Likelihood를 비교한 실험이다.
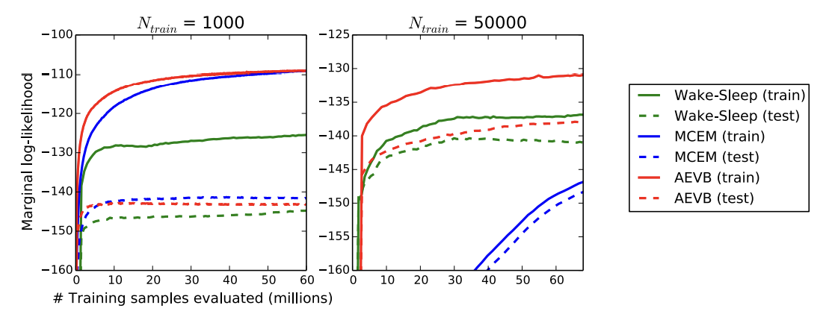
훈련 데이터의 개수가 1000개일 때는 MCEM이 1순위, AEVB가 2순위를 차지했지만 데이터의 개수가 50000개일 때는 AEVB가 1순위, MCEM이 3순위를 차지한 것을 볼 수 있다.
연구진은 Wake-sleep, AEVB와는 다르게 MCEM은 배치 학습을 진행하기 때문에 전체 MNIST 데이터셋에 효율적으로 적용되지 못한다고 설명했다.
Visualization
다음은 잠재 변수 를 시각화한 그림이다.
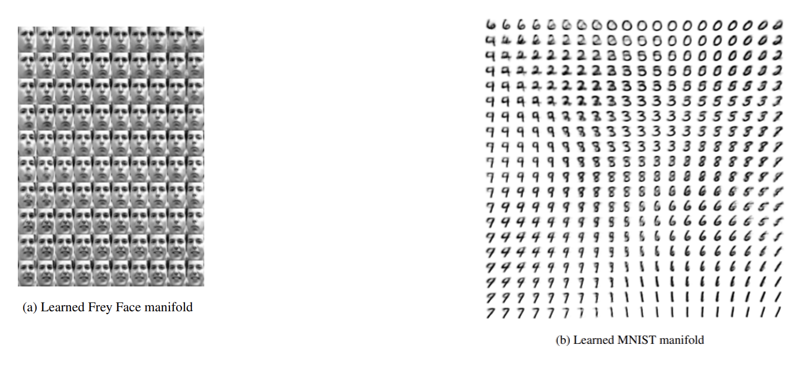
- 데이터보다 낮은 차원의 잠재변수를 이용하면 Encoder가 높은 차원의 데이터를 낮은 차원으로 투영시킨 manifold를 시각화할 수 있다
- 왼쪽 그림은 Frey Face 데이터의 manifold로, x축을 얼굴의 각도를, y축은 얼굴의 표정을 학습했다
- 오른쪽 그림은 MNIST 데이터의 manifold로, 구간에 따라 다른 숫자들과 각도가 학습되었다
다음은 잠재 변수의 차원에 따른 샘플링의 차이를 시각화한 그림이다.
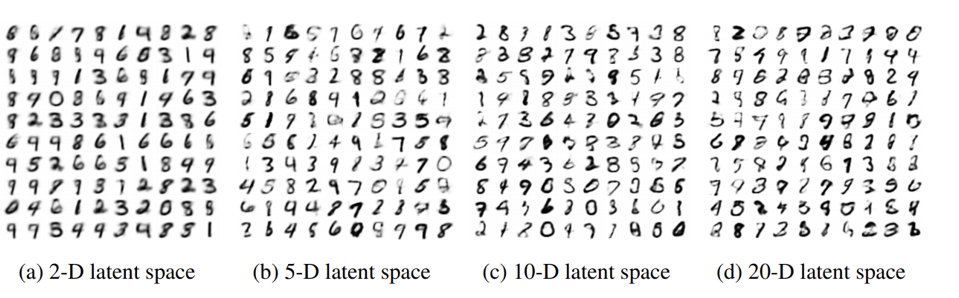
- 잠재 변수의 차원이 높을 수록 데이터의 특징을 더 잘 학습해서 더욱 선명한 그림이 생성되었다
5. Future Work
연구진은 SGVB estimator와 AEVB 알고리즘이 연속형 잠재 변수가 쓰이는 어떠한 추론, 학습 상황에도 적용될 수 있기 때문에 미래에 다음과 같은 여러 가지 연구가 시행될 것을 기대했다.
- AEVB 알고리즘과 함께 학습이 가능한 계층 구조의 Deep Neural Network를 Encoder와 Decoder 모두에 적용한다
- 시계열 모델을 이용한다 (ex: Dynamic Bayesian Networks)
- SGVB 알고리즘을 Global parameters(, )에도 적용한다
- 잠재 변수로 강화학습을 실시해 복잡한 노이즈 분포를 학습한다
6. GAN과의 차이점
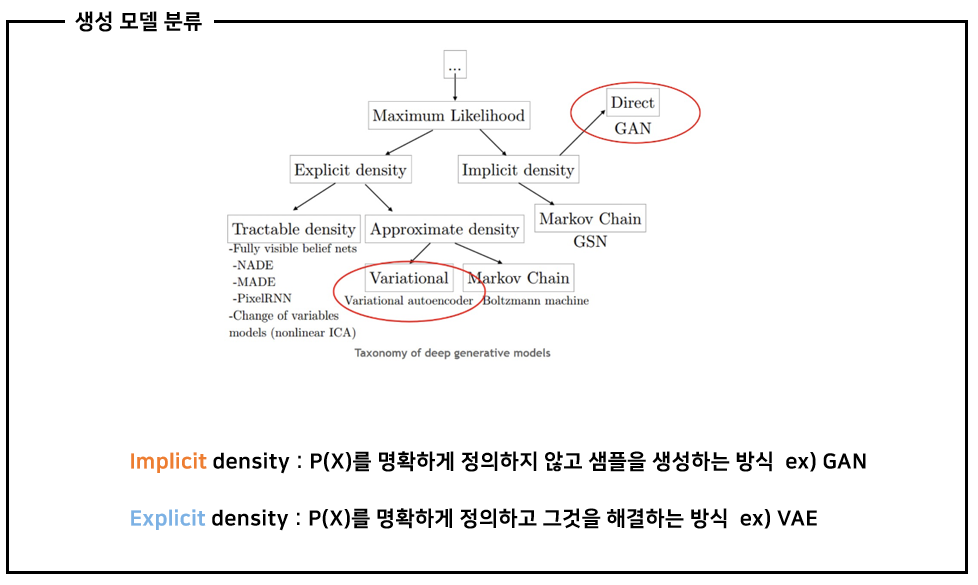
implicit density : 데이터의 분포 를 명확하게 정의하지 않고 그 분포로부터 샘플을 만들 수 있는 모델을 학습하는 방식
Explicit density : 데이터 분포 를 명확하게 정의하고 그것을 구하는 방식
GAN은 진짜 같은 sample을 생성하기 위해 Implicit density 방식을 이용하는 반면, VAE는 data의 분포를 구하기 위해 Explicit density 방식을 이용한다.
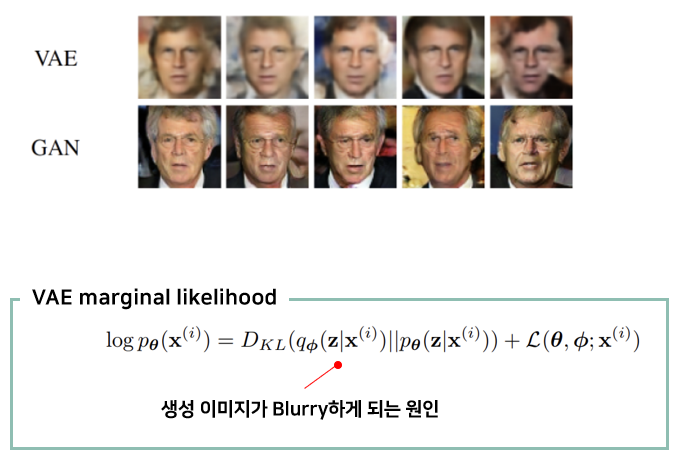
VAE가 생성한 이미지와 GAN이 생성한 이미지를 비교하면 흔히 VAE가 더 Blurry한 이미지를 만들어내는 것을 볼 수 있다.
이는 데이터의 분포 를 명확하게 정의하지만 쿨백-라이블러 발산 항을 계산할 수 없어 Lower Bound를 최대한 근사시킨 분포를 구하기 때문으로 생각할 수 있다.
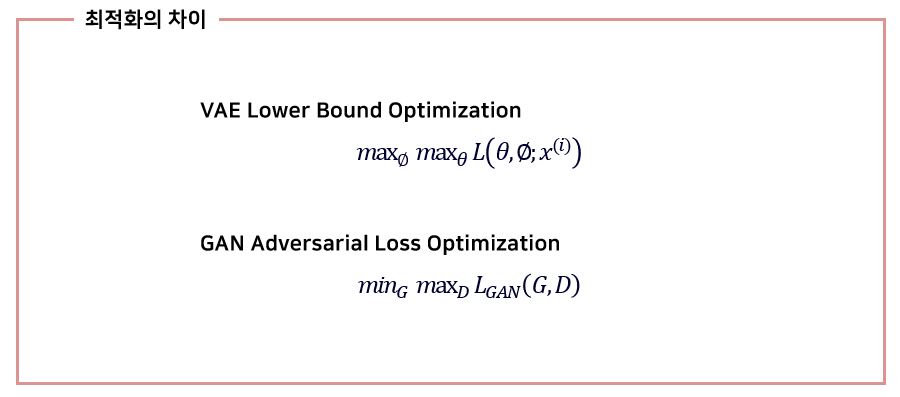
VAE는 두 파라미터 와 가 함께 Lower Bound를 최대화하는 방향으로 학습이 진행되는 반면,
GAN은 Generator와 Discriminator가 서로 역행하는 방향으로 학습이 진행된다.
이 방식은 시간이 오래 걸릴 뿐만 아니라 Generator가 비슷한 output으로만 Discriminator를 속여 loss의 최솟값이 도출되는 mode collapse가 발생할 수 있다.
하지만 VAE는 두 파라미터가 같은 방향으로 학습되기 때문에 mode collapse가 발생하지 않는다.