LLM Hallucination은 왜 발생하는가: 다음 토큰 예측부터 RAG 평가까지
LLM hallucination은 단순히 "모델이 거짓말을 한다"로 설명하면 부족하다. 개발 관점에서는 생성 방식, 컨텍스트 설계, 검색 품질, 평가 체계가 같이 얽힌 문제다.
수업에서 이 주제를 다룰 때 가장 먼저 분리해서 설명하는 것은 다음 두 가지다.
- LLM은 정답 조회기가 아니라 next token predictor다.
- 유창한 문장 생성 능력과 사실 검증 능력은 같은 능력이 아니다.
1. Autoregressive decoding 관점
GPT 계열 모델은 이전 토큰들을 보고 다음 토큰 분포를 계산한다.
p(x_t | x_<t)프롬프트가 들어오면 모델은 다음 토큰 후보들의 확률 분포를 만들고, decoding 전략에 따라 하나를 선택한다. 이 과정을 반복하면 문장이 된다.
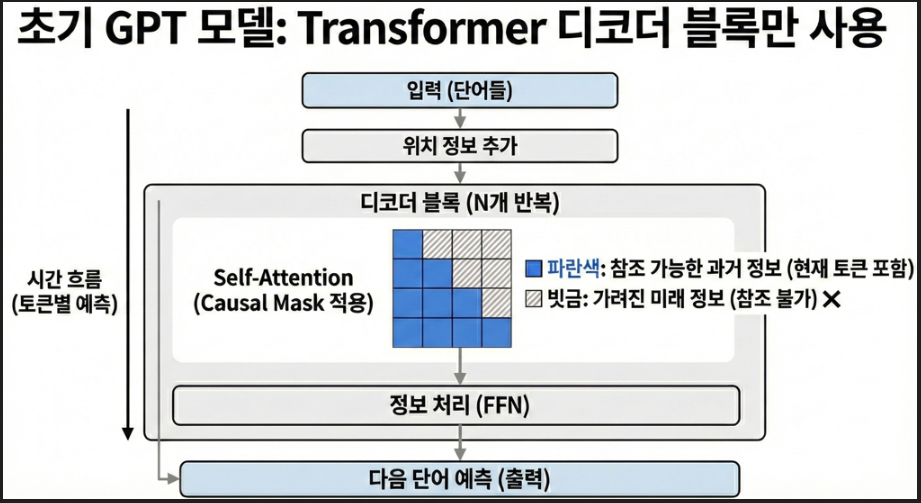
이 구조는 자연스러운 문장 생성에 강하다. 하지만 "생성된 문장이 외부 세계의 사실과 일치하는가"는 별도의 문제다.
예를 들어 질문이 다음과 같다고 하자.
우리 회사 2026년 해외 출장비 규정에서 임원 숙박비 한도는?모델 입장에서 이 질문은 문법적으로 익숙하다. "회사 규정", "해외 출장비", "숙박비 한도"라는 패턴은 학습 데이터 어딘가에 많이 있었을 가능성이 높다. 그래서 문장 형태는 만들 수 있다.
하지만 해당 회사의 2026년 최신 내부 규정이 컨텍스트에 없다면 정답을 알 수 없다. 이때도 모델은 답변 형식을 생성할 수 있다. 이 지점에서 hallucination이 발생한다.
2. 왜 temperature를 낮춰도 완전히 없어지지 않는가
temperature를 낮추면 sampling의 무작위성은 줄어든다. 같은 입력에 대해 더 안정적인 답변이 나오는 경우도 많다.
하지만 temperature는 근거 부재 문제를 해결하지 않는다.
temperature = 0이 설정은 "가능성이 가장 높은 토큰을 더 결정적으로 고르겠다"에 가깝다. "답변이 사실인지 검증하겠다"가 아니다.
따라서 hallucination의 원인을 sampling randomness 하나로만 보면 안 된다. 더 자주 보는 원인은 다음과 같다.
- 질문에 필요한 정보가 프롬프트나 컨텍스트에 없음
- 모델의 parametric memory에 오래되었거나 불완전한 패턴이 있음
- 질문이 모호해서 여러 가능한 답 중 하나를 자연스럽게 생성함
- RAG를 붙였지만 검색된 문서가 질문과 맞지 않음
- 검색은 맞았지만 생성 단계에서 문서 밖 추론을 섞음
3. Prompt는 제어 장치이지 사실 저장소가 아니다
프롬프트로 hallucination을 줄일 수는 있다.
제공된 문서에 근거해서만 답하세요.
근거가 없으면 "문서에서 확인할 수 없습니다"라고 답하세요.
추측하지 마세요.
이런 지시는 필요하다. 특히 업무용 챗봇에서는 fallback policy가 명확해야 한다.
하지만 프롬프트만으로는 부족하다. 컨텍스트에 근거 문서가 없는데 정답을 만들어내라고 요구하면, 좋은 프롬프트도 한계가 있다.
교육생 프로젝트를 리뷰하다 보면 자주 나오는 패턴이 있다. 답변이 틀렸을 때 프롬프트만 계속 고친다. 하지만 실제 원인은 retriever가 엉뚱한 청크를 가져온 경우가 많다.
그래서 RAG 디버깅에서는 답변보다 검색 결과를 먼저 봐야 한다.
4. 최소한의 RAG 답변 정책
업무용 LLM 애플리케이션에서는 "답변 생성"보다 "답하지 않아야 할 때 멈추는 정책"이 더 중요할 때가 많다.
아래는 API 호출과 무관한 프롬프트 빌더 예시다.
def build_grounded_prompt(question: str, contexts: list[str]) -> str:
    if not contexts:
        return f"""
질문: {question}

참고 문서가 없습니다.
답변: 문서에서 확인할 수 없습니다.
"""

    context_text = "\n\n".join(
        f"[문서 {i + 1}]\n{doc}" for i, doc in enumerate(contexts)
    )

    return f"""
당신은 사내 문서 기반 Q&A 어시스턴트입니다.

규칙:
1. 아래 참고 문서에 있는 내용만 사용하세요.
2. 문서에 없는 내용은 추측하지 마세요.
3. 답변 마지막에 사용한 문서 번호를 표시하세요.

참고 문서:
{context_text}

질문:
{question}

답변:
"""
이 코드는 hallucination을 제거하지 않는다. 대신 애플리케이션이 지켜야 할 최소 정책을 명시한다.
- 컨텍스트가 없으면 답하지 않는다.
- 컨텍스트가 있으면 문서 번호를 남긴다.
- 답변 정책을 프롬프트 레벨에서 반복 가능하게 만든다.
실무에서는 여기에 retriever, reranker, citation, logging, evaluation을 붙여야 한다.
5. RAG를 붙여도 평가가 없으면 원인을 모른다
RAG는 모델에게 외부 문서를 제공하는 방식이다. 하지만 RAG가 있다고 해서 모든 답변이 자동으로 grounded answer가 되지는 않는다.
RAG 실패는 보통 두 층으로 나눠야 한다.
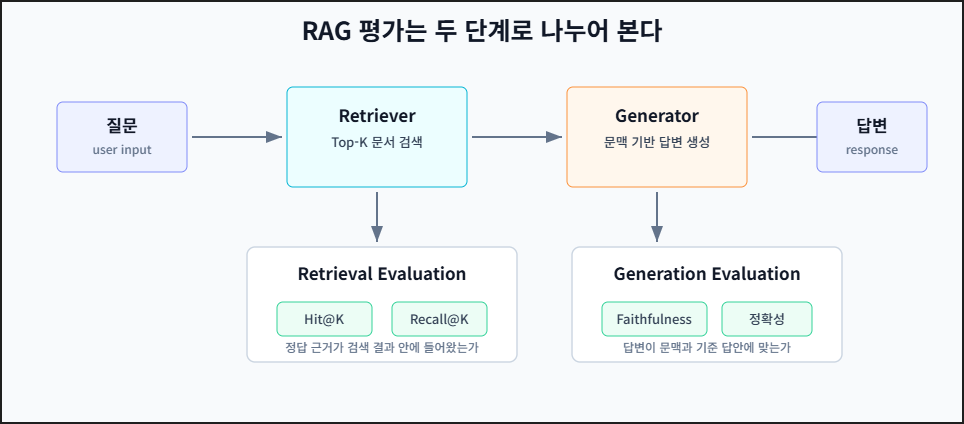
| 구분 | 질문 | 대표 지표 |
|---|---|---|
| Retrieval | 필요한 근거 청크를 찾았는가 | Hit@K, Recall@K, Precision@K |
| Generation | 찾은 문서에 근거해 답했는가 | Faithfulness, factual consistency |
검색이 실패했는데 프롬프트만 고치면 문제는 반복된다. 반대로 검색은 잘 되었는데 모델이 문서 밖 내용을 섞는다면 generation policy와 평가를 봐야 한다.
RAG 교육에서 tel-rag/3일차.ipynb를 다룰 때도 이 분리를 강조한다. 평가셋은 도구 이름보다 먼저다. 질문, 기준 답변, 근거 청크가 준비되어 있어야 RAGAS든 Langfuse든 의미 있게 쓸 수 있다.
6. 디버깅 체크리스트
LLM 답변이 그럴듯하게 틀렸다면 다음 순서로 보는 편이 좋다.
- 질문에 필요한 정보가 모델 입력에 있었는가
- RAG라면 검색된 청크가 질문과 맞았는가
- 검색 결과에 정답 근거가 있는데도 답변이 벗어났는가
- 프롬프트에 "근거 없음" 응답 정책이 있는가
- 모델 출력에 citation이나 trace가 남는가
- 같은 질문을 회귀 테스트할 평가셋이 있는가
정리
Hallucination은 LLM의 문장 생성 능력이 뛰어나기 때문에 더 위험해 보인다. 문장이 자연스럽고 구조가 깔끔하면 사용자는 정확하다고 느끼기 쉽다.
하지만 개발자는 유창함과 근거성을 분리해서 봐야 한다.
- next token prediction은 사실 검증이 아니다.
- prompt는 행동을 유도하지만 지식을 새로 만들지는 않는다.
- RAG는 근거를 제공하지만 검색과 생성 평가가 없으면 원인 분석이 어렵다.
- 운영 환경에서는 답변 품질보다 trace, citation, fallback, regression test가 더 중요해질 때가 많다.
결국 LLM 애플리케이션에서 중요한 질문은 "모델이 얼마나 똑똑한가"만이 아니다.
"모델이 틀렸을 때 우리가 그 이유를 추적할 수 있는가"가 실무 품질을 가른다.