Power BI 실습
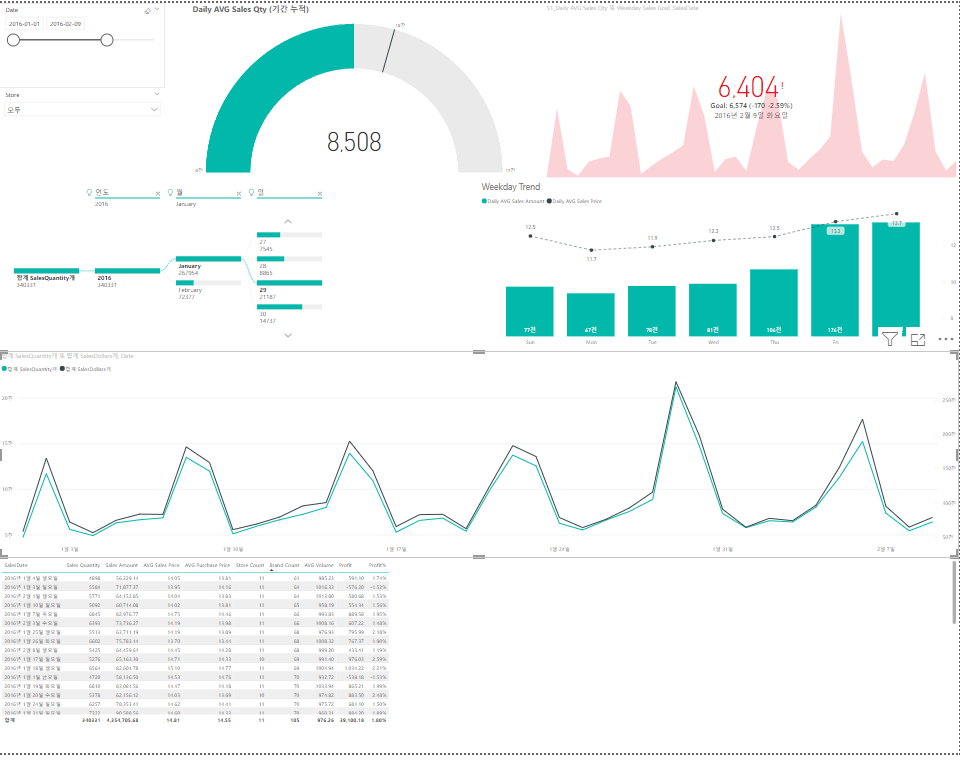
-Sales 대시보드 만들기
-분해 트리
-테이블 병합 , 이익 계산
-Calendar Dax식
-계기 차트
-KPI 시각화
-AVERAGEX , ALL , FILTER Dax식
Spark학습 및 환경 세팅하기
분산 클러스터
:시스템의 전반적인 성능을 향상시키기 위해 계산 부하량을 여러 노드에서 분담하여 병렬 처리하도록 구성하는 방식
Spark의 구조
클러스터 관리자
-사용 가능한 자원을 파악
-클러스터의 데이터 처리 작업을 관리하고 조율
-사용자는 클러스터 관리자에 스파크 에플리케이션을 제출
Driver 프로세스
-클러스터 노드 중 하나
-드라이버 프로그램의 명령을 Executor에서 실행하도록 분석 , 배포 , 스케쥴링
Executor 프로세스
-각 executor는 드라이버 프로세서가 할당한 작업을 수행
-진행 상황을 다시 드라이버 노드에 보고하는 역할
Saprk Session
-스파크 응용 프로그램의 통합 진입점
-스파크의 기능들과 구조들이 상호방식하는 방식을 제공
-
Spark의 데이터 처리 방식 : Partition
모든 Executor가 병렬로 작업을 수행할 수 있도록 파티션이라고 불리는 청크 단위로 데이터를 분할
파티션은 클러스터의 물리적 머신에 존재하는 Row의 집합
-> Spark의 병렬성은 파티션과 익스큐터의 갯수로 결정됨 -
Spark의 데이터 처리 방식 : Transformation
Spark의 핵심 데이터 구조는 불변성을 가짐
-> 변경을 원할 때 변경 방법을 Spark에게 알려주는 Transformation
-> 논리적 실행 계획을 세우게 됨
-> 즉 , 실제 연산이 일어나는 것은 아니다. -
Spark의 데이터 처리 방식 : Lazy Evaluation & Action
Lazy Evaluation : 특정 연산 명령이 내려진 즉시 데이터를 수정하지 않고 , 원시 데이터에 적용할 트랜스포메이션만 실행
-> 액션 전까지 전체 데이터 흐름을 최적화하는 강점을 지님
Action : 실제 연산을 수행하기 위한 사용자 명령 ( 트랜스포메이션으로부터 결과를 계산하도록 지시 )
ex) 카운트 , 콘솔에서 데이터를 보는 액션 , 출력 데이터 소스에 저장하는 액션
스파크의 카탈리스트
:트랜스포메이션을 적용할 때 , 스파크 SQL은 논리 계획이 담긴 트리 그래프를 생성
:해당 Optimizer에 의해 최적의 논리를 받아와 데이터를 반환해주기 때문에 성능이 더욱 좋음
카탈리스트의 논리 계획 4단계
Analysis -> Logical Optimization -> Physical Planning -> Code Generation
장점 : Spark에서 Partition은 부분으로 나눈다는 의미
데이터를 Shuffling하고 Partition하여 나뉜 데이터에서 연산을 처리하는 경우
네트워크 연산(node들의 통신)이 일어나게 된다.
연산 속도는 인메모리 >> 디스크I/O >> 네트워크 순으로 빠르다.
그런데 Shuffling은 네트워크 연산이기 때문에 앞에서 데이터가 어느정도 정리가 된 후에 해야 한다.
Pyspark : Python환경에서 Apache Spark를 사용할 수 있는 인터페이스 -> PySpark는 Spark용 API
PySpark 기능 및 라이브러리
1. Spark SQL and DataFrames
-대용량 정형 데이터 처리를 위해 SQL인터페이스를 지원하는 PySpark
-SQL 쿼리 사용 가능
-데이터 표현 방식은 DataFrame이며, 이는 RDBMS의 table과 유사한 2차원 구조
2. Pandas API on Spark
-Pandas API를 지원
-Pandas와 같은 문법을 사용할 수 있다는 장점
3. Structured Streaming
-Spark SQL 엔진에 구축된 스트림 처리 엔진
-정적 데이터에 배치 계산을 하는 것과 같은 방식으로 스트리밍 계산을 표현할 수 있는 장점
4. Machine Learning
-Spark의 머신러닝 라이브러리
-데이터 병렬 처리 방법론을 활용해 모델링이 가능
-Classification, Regression , Clustering , Dimension Reduction , Optimization등 다양한 활용처