사용된 명령어 알아보기
- apt-get: 시스템에서 사용 가능한 패키지에 대한 설치, 패키지 검색, 업데이트 및 기타 여러 작업을 수행
- wget: 웹 상의 파일을 다운로드 받을 때 사용하는 명령어
- tar: 여러 개의 파일을 하나의 파일로 묶거나 풀 때 사용하는 명령어
- pip: 파이썬에서 외부 라이브러리(패키지)를 설치, 업그레이드, 제거, 검색 등의 작업을 수행
사용된 명령어 알아보기
- mkdir: 디렉토리(폴더) 생성 명령어
- cp: 파일 복사/이동 명령어
- chmod: 기존 파일 또는 디렉토리에 대한 접근권한 변경
- 600: 나에게만 읽기,쓰기 권한
- unzip: zip 으로 압축된 파일을 푸는 명령어
- csv 포맷 말고도 JSON, Parquet, Avro, ORC, JDBC 등 다양한 파일 형식 읽기를 지원함
- header: 열 이름이 데이터 내에 포함되어 있으면 True
- inferschema: 스키마 자동 설졍 (=True)
pyspark가 지원하는 다양한 파일 형식
- csv
- 단순한 값 목록
- 각 항목은 쉼표 또는 다른 구분 문자로 나타냄
- 첫 번째 헤더 필드 행은 선택
- json
- 사람이 읽을 수 있는 텍스트를 사용하여 데이터를 저장하고 전송
- 데이터 공유를 위한 개방형 표준 파일 형식
- JDBC
- 자바에서 데이터베이스에 접속할 수 있도록 하는 자바 API
- 즉, DB의 데이터를 불러와 데이터프레임으로 처리
- Avro
- row (행) 기반으로 저장
- 따라서, 모든 필드에 접근해야 할때 유용 (큰 분량을 쓰는데 유리)
- 가장 compatible한 플랫폼: Kafka, Druid
- Parquet
- Column (열) 기반 저장
- 따라서, 특정 필드 (열)에 자주 접근해야할 때 유용 (큰 분량을 읽어서 분석해야하는 환경에 최적화)
- 가장 compatible한 플랫폼: Impala, Spark
- ORC
- Column (열) 기반 저장
- 따라서, 특정 필드 (열)에 자주 접근해야할 때 유용 (큰 분량을 읽어서 분석해야하는 환경에 최적화)
- 가장 compatible한 플랫폼: Hive, Presto
5-2. 두 방식의 장단점
- Spark SQL
- 장: 문자열 형태의 쿼리로 읽기 쉬움
- 쿼리에 대한 유지보수가 어려움 (문자열 형태의 query)
- DataFrame API
-
장: code의 모듈화 (효율성이 높음)
-
단: 로직이 복잡할 경우 이해하기 어려울 수도 있음
DataFrame을 선호하는 이유
-
spark를 다루는 경우는 보통 대용량 데이터 처리를 위해서
-
대용량 데이터의 경우 low level의 데이터가 많음
- 예. 로그 데이터
-
따라서, 지속적으로 로그 형태가 변하거나 비즈니스 로직이 변화함에 따라 코드 역시 변화
- 위에서 이야기했던 sql 쿼리의 유지보수가 힘들다는 단점이 크리티컬
- Dataframe api를 활용해 모듈화 및 버전 관리를 하는 경우가 많음
-
본인의 경우 sql 쿼리는 보통 단건 분석을 진행을 할 때 사용
- 예. 이번 분기 매출을 뽑아서 알려주세요~### 1. 결측치 찾기 from pyspark.sql import functions as Fdf.select(
[F.count(F.when(F.isnull(c), c)).alias(c) for c in df.columns]
).show()
-
예제
#python list comprehension
#리스트를 쉽게, 짧게 한 줄로 만들 수 있는 파이썬의 문법
value_list = [1, 2, 3, 4, 5, 6]
#result = [value의 output for value in value_list]
print([str(value) for value in value_list])
#result = [if 조건에 맞는 value의 output for value in value_list if 조건]
print([str(value) for value in value_list if value >= 3])
#result = [if 조건에 맞는 value의 output if 조건 else if 조건에 맞지 않는 value의 output for value_list]
print([str(value) if value >= 3 else value for value in value_list])
-
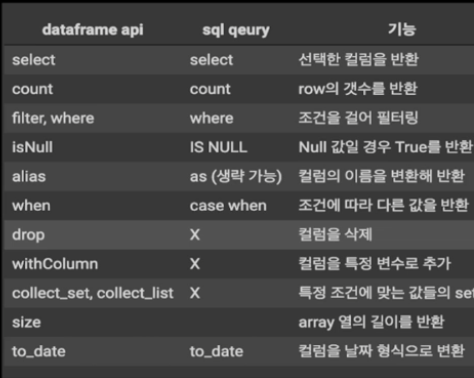
select
- 특정 컬럼을 선택하기 위한 함수
-
count
- 데이터프레임의 행 갯수를 연산
-
when
- 데이터프레임에서 if문과 같은 조건문을 만드는 함수
- F.when(조건(True), 조건에 부합할 시 반환값).otherwise(조건에 부합하지 않을 시 반환값)
-
isnull
- 해당 값이 null인 경우 True를 반환
-
alias
- 새롭게 연산된 컬럼의 컬럼명 설정
df.filter(F.col("CountyNumber").isNull()).filter(F.col("County").isNotNull()).count()
=
df.filter(
(F.col("CountyNumber").isNull())
& (F.col("County").isNotNull())
).count()
#CountyNumber가 없어도 County는 있는 경우가 많음
#County를 쓰자!
- withColumn
- 기존 컬럼의 업데이트, 타입 변경, 신규 컬럼 값 추가
- withColumn(신규 컬럼명, 신규 컬럼값)
- 컬럼명 변경은 withColumnRename() 메서드
- size
- 컬럼에 있는 array의 길이를 반환
- list 형태의 len과 유사한 기능
- collect_set
- object들의 고유 집합 (= distinct한)을 반환
- 요소를 set으로 묶음
- (자매품) collect_list
- object들의 집합을 반환
- 요소를 list로 묶음
- over
- 컬럼의 window를 정의
- window란
- 일정한 기준으로 묶인 row들
- Window
- 위 window를 정의하기 하기위해 사용
- partitionBy
- window 중 그룹을 묶는 함수
- groupBy와 유사
from pyspark.sql import functions as F
from pyspark.sql import Window as W
(
df
.withColumn(
"CategoryName_cnt",
F.size(
F.collect_set("CategoryName").over(W.partitionBy("Category"))
)
)
.filter(F.col("CategoryName_cnt") >= 2)
).show()
df = (
df
.withColumn(
"CategoryName", #원래 있는 컬럼과 동일한 이름으로 withColumn을 할 경우, 기존 컬럼에 덮어쓰기가 됩니다.
F.first(
F.col("CategoryName"), ignorenulls=True #null인 경우를 제외하고 가장 첫번째
).over(W.partitionBy(F.col("Category")).orderBy(F.col("Date").desc()))
     # 다른경우가 존재하기 때문에 가장 최근 날짜 기준 이름으로 덮어쓰기
    )
)-
to_date
- string을 date 형태로 바꿔줌
- F.to_date(변형할 컬럼, format="현재 string이 어떤 형태로 써져있는지 명시")
-
시간 형태를 위한 또 다른 매서드
- to_timestamp
- string을 timestamp 형태로 변형
- F.to_timestamp(변형할 컬럼, format="현재 string이 어떤 형태로 써져있는지 명시")
- MM-dd-yyyy HH:mm:ss.SSS'
- to_timestamp
#Date 컬럼이 string으로 되어있으며, 월/일/년 이라는 특이한 방식으로 저장되어있음
df = df.withColumn("Date", F.to_date(F.col("Date"), 'MM/dd/yyyy'))
- dataframe api: count
- sql query: count
- 여기서 잠깐! 두 함수의 차이점 알아보기
- dataframe api의 action 함수
- 항상 return 값이 dataframe의 형태로 나오는 것이 아님
- dataframe api의 action 함수
- sql query의 결과
- dataframe 형태를 반환
- dataframe api: isNull
- sql query: IS NULL
- dataframe api: alias
- sql query: as (생략 가능)
- dataframe api: when
- sql query: case when
- pyspark drop
- sql query: X
왜 다를까?
- pyspark의 output은 또 다른 dataframe 객체를 반환
- select를 사용하지 않으면, 기본적으로 기본 table에서의 모든 column을 반환
- sql query: 항상 select를 지정
- 즉, select에서 제외되면 자동으로 drop
- 모든 column을 반환하고 싶다면 * 사용
- dataframe api: withColumn
- sql query: X
- 기본적으로 원래 테이블의 구조를 변경하지 않음
- select에 새로운 계산으로 만들어진 컬럼을 반환하는 방식으로 진행
- dataframe api: collect_set, collect_list
- sql qeury: X
- sql table은 array 형태의 column을 지원하지 않음