import re, html
from math import comb

import numpy as np
import pandas as pd
import scipy.sparse as sp
from scipy.stats import binom
import matplotlib.pyplot as plt
from matplotlib import font_manager
from matplotlib.patches import Patch
from sklearn.feature_extraction.text import CountVectorizer, TfidfVectorizer

SEED = 42
pd.set_option("display.width", 120)
_installed = {f.name for f in font_manager.fontManager.ttflist}   # 그래프의 한글 표시: 설치된 첫 한글 폰트 (Windows → macOS → Linux)
plt.rcParams["font.family"] = next((f for f in ["Malgun Gothic", "AppleGothic", "NanumGothic"] if f in _installed), "DejaVu Sans")
plt.rcParams["axes.unicode_minus"] = False

DATA_DIR = "ml-1m"
ratings = pd.read_csv(f"{DATA_DIR}/ratings.dat", sep="::", engine="python",
                      names=["user", "item", "rating", "ts"])
users = pd.read_csv(f"{DATA_DIR}/users.dat", sep="::", engine="python",
                    names=["user", "gender", "age", "occupation", "zip"])
movies = pd.read_csv(f"{DATA_DIR}/movies.dat", sep="::", engine="python",
                     names=["item", "title", "genres"], encoding="latin-1")

assert len(ratings) == 1_000_209 and len(users) == 6_040 and len(movies) == 3_883
print(ratings.shape, users.shape, movies.shape)
Part A. 데이터의 전체 지도와 이벤트 로그
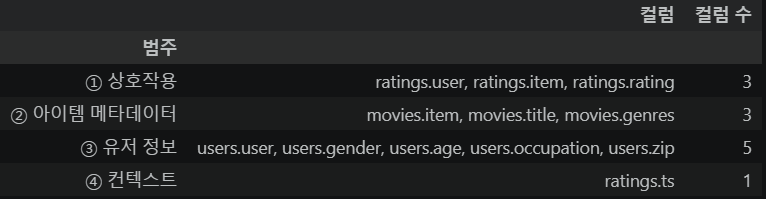
A-1. ① 상호작용 ② 아이템 메타데이터 ③ 유저 정보 ④ 컨텍스트 중 하나로 매핑하는 딕셔너리 생성
DATA_MAP = {
    "ratings.user":      "① 상호작용",        # 누가 (이벤트의 주체)
    "ratings.item":      "① 상호작용",        # 무엇에
    "ratings.rating":    "① 상호작용",        # 얼마나 (explicit 값)
    "ratings.ts":        "④ 컨텍스트",        # 언제 → 시간대·요일 등 '지금 이 순간'의 정보
    "movies.item":       "② 아이템 메타데이터",
    "movies.title":      "② 아이템 메타데이터",  # 비구조 텍스트 (+ 개봉연도 포함)
    "movies.genres":     "② 아이템 메타데이터",  # 구조적 다중 범주
    "users.user":        "③ 유저 정보",
    "users.gender":      "③ 유저 정보",
    "users.age":         "③ 유저 정보",
    "users.occupation":  "③ 유저 정보",
    "users.zip":         "③ 유저 정보",
}
① 상호작용 : user, item, rating
(rating.ts는 context를 위한 정보이기 때문에 아님)
② 아이템 메타데이터 : item, title, genres
(item 자체의 data이므로 영화의 설명과 관련된 것 존재)
③ 유저 정보 : user, gender, age, occupation, zip
(user 자체의 data이므로 개인의 취향과 관련된 것 존재)
④ 컨텍스트 : ts
(MovieLens에는 기기·위치 정보 X, 시간(ts)만 존재 → ts에서 파생한 요일·시간대만 사용)
A-2. ratings를 이벤트 로그 형식 DataFrame으로 변환
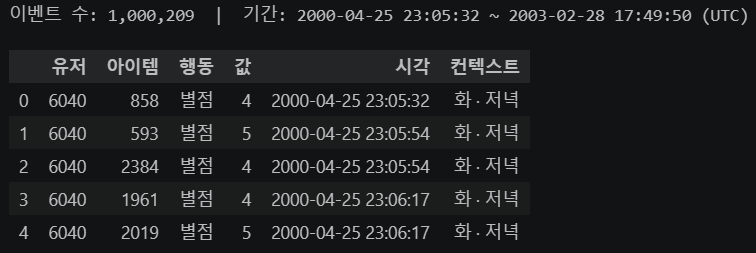
이벤트 로그 :
def to_event_log(ratings):
    t = pd.to_datetime(ratings["ts"], unit="s")
    log = pd.DataFrame({
        "유저":     ratings["user"],
        "아이템":   ratings["item"],
        "행동":     "별점",          # MovieLens 1M의 행동 종류는 '별점'
        "값":       ratings["rating"],
        "시각":     t,
        "컨텍스트": WEEKDAY_KO[t.dt.dayofweek] + " · " + time_of_day(t.dt.hour).astype(str),
})- 유저
- 아이템
- 행동 : MovieLens 1M의 행동 종류는 rating이 유일
- 값 : rating의 값
- 시각(ts)
- 컨텍스트 : ts에서 파생한 요일·시간대만 사용
Part B. 상호작용 데이터
: Explicit feedback + Implicit feedback
B1. explicit feedback의 해부
B1-1. 평점 1–5의 빈도와 비율 출력 + 히스토그램
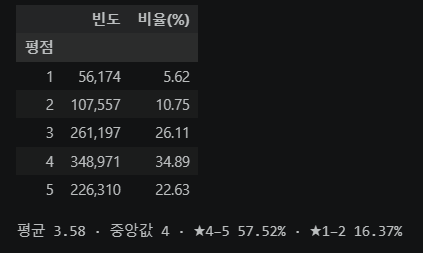
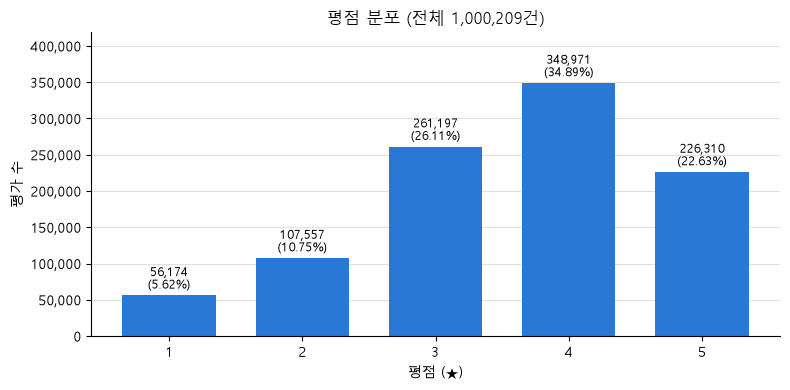
★4–5가 57.52%, ★1–2는 16.37%
평균(3.58)이 척도 중간(3)보다 높고 중앙값은 4
→ 분포가 높은 점수 쪽에 쏠려 있다 (★4–5에 쏠린 J자형)
이것은 MNAR로 설명 가능하다.
유저는 좋아할 것 같은 영화를 골라 보고 평가하므로, 관측된 평점의 평균이 '모든 영화에 대한 취향'을 과대평가한 상황일 수 있다.
하지만 평가하지 않은 칸의 평점은 로그에 없으므로, 이 설명을 관측 로그만으로 직접 검증할 수는 없다.
B1-2. 유저별 평균 평점: 후한 평가자(≥ 4.2)와 짠 평가자(≤ 3.0)
-
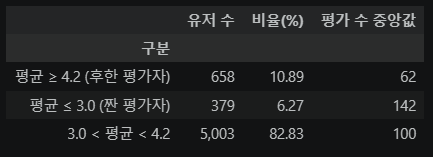
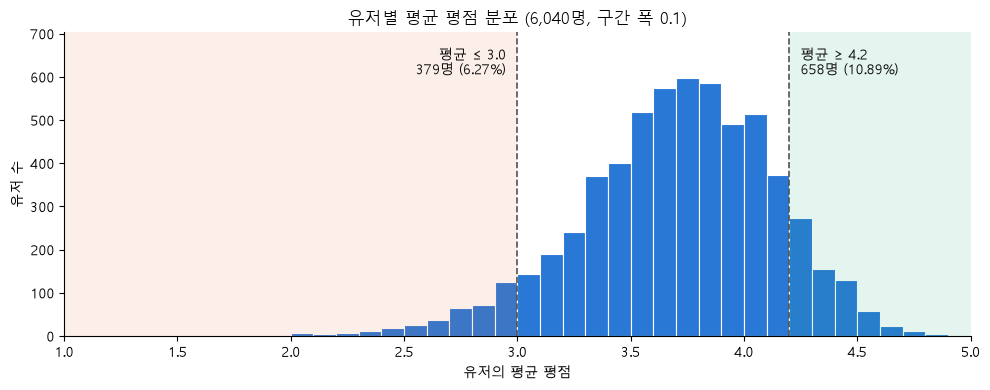
같은 데이터 안에 평균 ≥ 4.2인 후한 평가자 658명(10.89%)과 평균 ≤ 3.0인 짠 평가자 379명(6.27%)이 섞여 있다.
같은 ★4라도 후한 유저에게는 '보통', 짠 유저에게는 '극찬'이므로 원점수를 그대로 비교할 수 없다.
→ 유저별 평균을 빼는 중심화가 필요해보임 -
평가 수 중앙값은 짠 평가자가 142건, 후한 평가자가 62건이다(전체 96건).
그래서 유저 평균의 평균(3.70)이 평점 전체 평균(3.58)보다 높다.
헤비 유저는 평가 건수가 많아 전체 평균에서 비중이 큰데,
평가를 많이 하는 유저일수록 짠 경향이 있는 것을 확인할 수 있다.
→ '평균 평점'을 평가 단위로 내느냐 유저 단위로 내느냐 선택할 필요 있음
B1-3. 평가 수 기준 5분위 구간별 영화 수·평균 평점
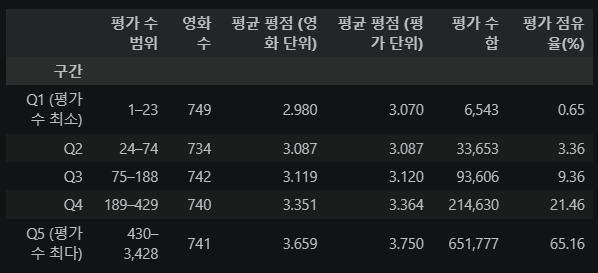
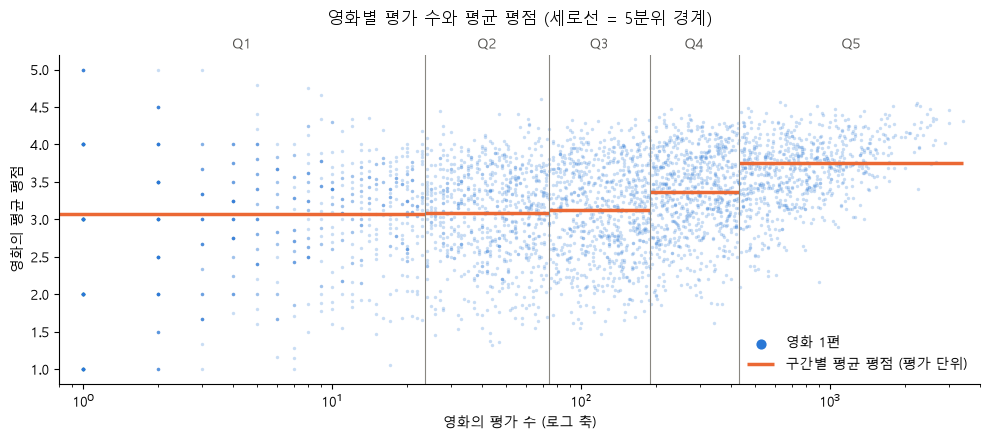
- Popularity Bias 관찰 가능
평가 단위 평균은 Q1 3.070 → Q5 3.750으로 단조 증가한다.
히트작이 실제로 더 매력적이라 많이 보고 높게 평가했을 수도 있고(취향의 쏠림),
좋은 평판이 노출을 부르고 노출이 다시 평가 수를 키웠을 수도 있다(노출의 증폭). - long-tail distribution 관찰 가능
평가 수가 가장 많은 Q5(430건 이상, 741편)가 전체 평가의 65.16%를 가져가고,
가장 적은 Q1(23건 이하, 749편)은 0.65%에 불과하다. - 산점도의 깔때기 모양
Q1 영화의 평균은 1점부터 5점까지 흩어진다.
평가 몇 건으로 낸 평균은 믿기 어렵다는 뜻이다.
B2. implicit feedback의 해부
B2-1. implicit '평가함 = 1' 이진 행렬
평가를 '평가함 = 1'로 바꿔 6,040 × 3,706 CSR(Compressed Sparse Row) 행렬을 만들었다.
대부분의 칸이 비어 있는 희소 행렬을 효율적으로 저장하는 방식이다.
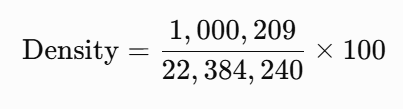
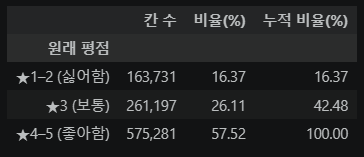
- ★1~2: 163,731개 (16.37%)
- ★3: 261,197개 (26.11%)
- ★4~5: 575,281개 (57.52%)
하지만 implicit 이진 행렬을 쓰면 칸 수는 그대로인데 ★1의 "싫다"까지 양성이 된다.
즉, 좋아해서 평가한 영화와 싫어서 평가한 영화를 구분할 수 없게 되는 상황이 된다.
(= 평점 대신 1을 넣는 단순 대체를 경계해야 하는 이유)
B2-2. 유저별 시간순 80/20 분할 + 음성 샘플링 (균등 / 인기 기반)