추천시스템
1.Recommendation System #01 Overview
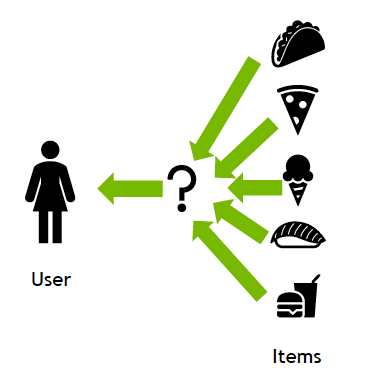
아이템의 수가 인간의 탐색 능력을 넘어선 지 오래 된 정보 과잉의 시대가 도래했다.하지만 아이템이 기하급수적으로 늘어나면 실제 취향을 우연히 만날 확률이 0으로 수렴하게 된다.탐색 비용 증가검색에 실패하지 않도록 유도하는 과정이 필요로 되어졌고,누군가 대신 골라줘야 하
2.Recommendation System #02-1. Data의 이해

제 1원칙: Model은 Data보다 좋아질 수 없다 Garbage In, Garbage Out : Model은 데이터의 패턴을 증폭할 뿐, 데이터에 없는 진실을 만들어내지 못 한다. 실무에서도 Model보다 로그 정의 / 데이터 검증 / 특징 설계와 같은 곳에 시간
3.Recommendation System #02-2. Data의 이해
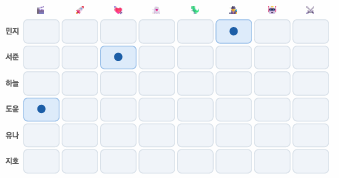
02-1. 에서는 어떤 Data를 다루는지 했다면,02-2. 에서는 어떻게 Data를 다루는지 정리한다.같은 로그라도 결정에 따라 전혀 다른 행렬이 나오게 된다.그 사이에서 고려해야 될 지점은 다음과 같다.어떤 행동을 셀 것인가(ex. 클릭, 시청, 구매 중 반영할 것
4.Recommendation System #04 유사도와 거리
지난 W3에서는 User-Item Matrix를 행(Row)과 열(Column)로 나누어 User Vector와 Item Vector로 표현했다.이번 Chapter에서는 이러한 벡터들이 얼마나 비슷한지(Similarity) 측정하는 방법을 알아본다.추천시스템에서 유사도
5.Recommendation System #03 Assignment_01 : MovieLens 1M
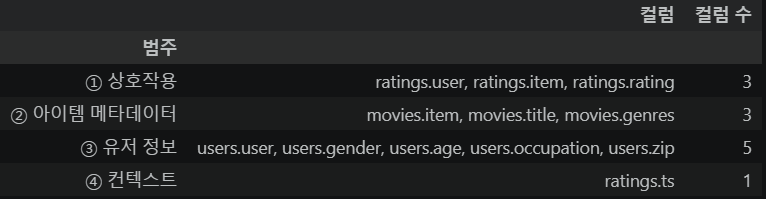
① 상호작용 : user, item, rating(rating.ts는 context를 위한 정보이기 때문에 아님)② 아이템 메타데이터 : item, title, genres(item 자체의 data이므로 영화의 설명과 관련된 것 존재)③ 유저 정보 : user, gen