혼공머신 Ch3
회귀 : 두 변수 사이의 상관관계를 분석하는 방법
(클래스 중 하나로 분류하는 것이 아닌 임의의 어떤 숫자를 예측)
k-최근접 이웃 회귀
샘플에 가장 가까운 샘플 k개를 선택
이때 이웃한 샘플의 타겟은 어떤 클래스가 아니라 임의의 수치이다.
이웃한 샘플 수치들의 평균을 구한다.
import numpy as np
import matplotlib.pyplot as plt
perch_length = np.array([8.4, 13.7, 15.0, 16.2, 17.4, 18.0, 18.7, 19.0, 19.6, 20.0, 21.0,
21.0, 21.0, 21.3, 22.0, 22.0, 22.0, 22.0, 22.0, 22.5, 22.5, 22.7,
23.0, 23.5, 24.0, 24.0, 24.6, 25.0, 25.6, 26.5, 27.3, 27.5, 27.5,
27.5, 28.0, 28.7, 30.0, 32.8, 34.5, 35.0, 36.5, 36.0, 37.0, 37.0,
39.0, 39.0, 39.0, 40.0, 40.0, 40.0, 40.0, 42.0, 43.0, 43.0, 43.5,
44.0])
perch_weight = np.array([5.9, 32.0, 40.0, 51.5, 70.0, 100.0, 78.0, 80.0, 85.0, 85.0, 110.0,
115.0, 125.0, 130.0, 120.0, 120.0, 130.0, 135.0, 110.0, 130.0,
150.0, 145.0, 150.0, 170.0, 225.0, 145.0, 188.0, 180.0, 197.0,
218.0, 300.0, 260.0, 265.0, 250.0, 250.0, 300.0, 320.0, 514.0,
556.0, 840.0, 685.0, 700.0, 700.0, 690.0, 900.0, 650.0, 820.0,
850.0, 900.0, 1015.0, 820.0, 1100.0, 1000.0, 1100.0, 1000.0,
1000.0])
plt.scatter(perch_length, perch_weight)
plt.xlabel('length')
plt.ylabel('weight')
plt.show()
from sklearn.model_selection import train_test_split
train_input, test_input, train_target, test_target = train_test_split(perch_length, perch_weight, random_state = 42)
사이킷런은 사용한 훈련 세트는 2차원 배열이어야한다.
특성을 1개만 사용한다면 수동으로 2차원 배열을 만들어야 한다.
넘파이 배열은 크기를 바꿀 수 있는 reshape() 메서드를 제공한다.
reshape() 메서드는 크기가 바뀐 새로운 배열을 반환할 때 지정한 크기가 원본 배열에 있는 원소의 개수와 다르면 에러가 발생한다.
예를 들어 (4,) 크기의 배열을 (2,3)으로 바꾸려고 하면 에러가 발생한다.
원본 배열의 원소는 4개인데 2*3 = 6개로 바꾸려고 하니깐...
reshape(-1,1) 과 같이 크기에 -1을 지정하면 나머지 원소 개수로 모두 채우라는 의미이다. 즉 배열의 전체 원소 개수를 매번 외우지 않아도 됨.
train_input = train_input.reshape(-1,1)
test_input = test_input.reshape(-1,1)
print(train_input.shape, test_input.shape)
from sklearn.neighbors import KNeighborsRegressor
knr = KNeighborsRegressor()
knr.fit(train_input, train_target)
print(knr.score(test_input,test_target))
분류의 경우는 테스트 세트에 있는 샘플을 정확하게 분류한 개수의 비율이 score 였다.
-회귀에서는 결정계수를 점수로 나타낸다. 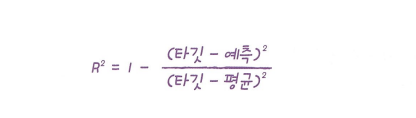
-결정계수는 대표적인 회귀 문제의 성능 측정 도구
-1에 가까울 수록 좋고 0에 가깝다면 성능이 나쁜 모델이다.
-정확도처럼 R^2가 직감적으로 얼마나 좋은지 이해하기 어렵다.
-사이킷런은 sklearn.metrics 패키지에서 mean_absolute_error는 타깃과 예측의 절댓값 오차를 평균하여 반환한다.
from sklearn.metrics import mean_absolute_error
test_prediction = knr.predict(test_input)
mae = mean_absolute_error(test_target, test_prediction)
print(mae)
print(knr.score(train_input, train_target))
score 기준
과대적합 : test set < train set
과소적합 : test set > train set 이거나 test,train set 모두 너무 낮은 경우
과소적합 해결 방법 -> 모델을 복잡하게 만든다
k-최근접 이웃 알고리즘에서는 이웃의 개수 k를 줄이는 것
(= 국지적인 패턴에 민감해짐)
knr.n_neighbors = 3
knr.fit(train_input, train_target)
print(knr.score(train_input, train_target))
print(knr.score(test_input, test_target))
k-최근접 이웃의 한계
print(knr.predict([[50]]))
distances, indexes = knr.kneighbors([[50]])
plt.scatter(train_input, train_target)
(훈련 세트 중에서 이웃 샘플만 다시 그린다.)
plt.scatter(train_input[indexes], train_target[indexes], marker = 'D')
plt.scatter(50, 1033, marker='^')
plt.show()
k-최근접 이웃 회귀는 가장 가까운 샘플을 찾아 타깃을 평균한다.
따라서 새로운 샘플이 훈련 세트의 범위를 벗어나면 엉뚱한 값을 예측할 수 있다. 이때 k-최근접 이웃을 사용하려면 새로운 샘플의 값이 포함된 훈련 세트를 다시 만들어야 한다.
(사실 머신러닝 모델은 시간과 환경이 변화하면서 데이터도 바뀌기 때문에 주기적으로 새로운 훈련 데이터로 모델을 다시 훈련해야 한다.)
선형 회귀
사이킷런은 sklearn.linear_model 패키지 아래에 LinvearRegression 클래스로 선형 회귀 알고리즘을 구현한다.
from sklearn.linear_model import LinearRegression
lr = LinearRegression()
lr.fit(train_input, train_target)
print(lr.predict([[50]]))
y = a*x + b
LinearRegression 클래스가 찾은 a 와 b 는 lr객체의 coef 와 Intercept속성에 저장된다.
print(lr.coef, lr.intercept)
coef 와 Intercept 를 머신러닝 알고리즘이 찾은 값이라는 의미로 모델 파라미터라고 부른다.
머신러닝 알고리즘의 훈련 과정은 최적의 모델 파라미터를 찾는 것과 같다.
이를 모델 기반 학습이라고 부르고 k-최근접 이웃에는 모델 파라미터가 없는 사례 기반 학습이라고 한다.
plt.scatter(traininput, train_target)
plt.plot([15, 50], [15*lr.coef + lr.intercept, 50*lr.coef + lr.intercept_])
plt.scatter(50, 1241.8, marker = '^')
plt.show()
print(lr.score(train_input, train_target))
print(lr.score(test_input, test_target))
train_poly = np.column_stack((train_input 2, train_input))
test_poly = np.column_stack((test_input 2, test_input))
print(train_poly.shape, test_poly.shape)
lr = LinearRegression()
lr.fit(trainpoly, train_target)
print(lr.predict([[50**2, 50]]))
print(lr.coef, lr.intercept_)
point = np.arange(15, 50)
plt.scatter(train_input, train_target)
plt.plot(point, 1.01point**2 - 21.6point + 116.05)
plt.scatter([50], [1574], marker = '^')
plt.show()
print(lr.score(train_poly, train_target))
print(lr.score(test_poly, test_target))
선형 회귀 : 특성과 타깃 사이의 관계를 가장 잘 나타내는 선형 방정식을 찾는다. 특성이 하나면 직선 방정식
선형 회귀가 찾은 특성과 타깃 사이의 관계는 선형 방정식의 계수 또는 가중치에 저장. 기울기와 절편을 모두 의미하는 경우가 많다
모델 파라미터 : 선형 회귀가 찾은 가중치처럼 머신러닝 모델이 특성에서 학습한 파라미터를 말한다.
다항 회귀 : 다항식을 사용하여 특성과 타깃 사이의 관계를 나타냄. 이 함수는 비선형일 수 있지만 여전히 선형 회귀로 표현할 수 있다.
다중 회귀 : 여러 개의 특성을 사용한 선형 회귀
특성 1개 -> 직선
특성 2개 -> 평면을 학습
특성 공학 : 기존의 특성을 사용해 새로운 특성을 뽑아내는 작업
import pandas as pd
df = pd.read_csv('https://bit.ly/perch_csv')
perch_full = df.to_numpy()
print(perch_full)
import numpy as np
perch_weight = np.array([5.9, 32.0, 40.0, 51.5, 70.0, 100.0, 78.0, 80.0, 85.0, 85.0, 110.0,
115.0, 125.0, 130.0, 120.0, 120.0, 130.0, 135.0, 110.0, 130.0,
150.0, 145.0, 150.0, 170.0, 225.0, 145.0, 188.0, 180.0, 197.0,
218.0, 300.0, 260.0, 265.0, 250.0, 250.0, 300.0, 320.0, 514.0,
556.0, 840.0, 685.0, 700.0, 700.0, 690.0, 900.0, 650.0, 820.0,
850.0, 900.0, 1015.0, 820.0, 1100.0, 1000.0, 1100.0, 1000.0,
1000.0])
from sklearn.model_selection import train_test_split
train_input, test_input, train_target, test_target = train_test_split(perch_full, perch_weight, random_state = 42)
사이킷런의 변환기
from sklearn.preprocessing import PolynomialFeatures
poly = PolynomialFeatures()
poly.fit([[2,3]])
print(poly.transform([[2,3]]))
fit(훈련)을 해야 transform(변환)이 가능하다.
사이킷런의 일관된 api 때문에 두 단계로 나누어져 있다.
fit_transform 메서드도 있다.
fit() 메서드는 새롭게 만들 특성 조합을 찾고
transform() 메서드는 실제로 데이터를 변환한다.
변환기는 입력 데이터를 변환하는 데 타깃 데이터가 필요하지 않는다.
fit() 메서드에 입력데이터만 전달.
즉 2개의 특성을 가진 샘플 [2,3]이 6개의 특성을 가진 샘플[1.2.3.4.6.9.]으로 바뀜
poly = PolynomialFeatures(include_bias = False)
poly.fit([[2,3]])
print(poly.transform([[2,3]])) #절편을 위한 항이 제거되고 특성의 제곱과 특성끼리 곱한 항만 추가
poly = PolynomialFeatures(include_bias = False)
poly.fit(train_input)
train_poly = poly.transform(train_input)
print(train_poly.shape)
poly.get_feature_names_out()
test_poly = poly.transform(test_input)
from sklearn.linear_model import LinearRegression
lr = LinearRegression()
lr.fit(train_poly, train_target)
print(lr.score(train_poly, train_target))
print(lr.score(test_poly, test_target))
test set의 점수가 오르진 않았지만 train set 점수가 올라 과소적합 문제 해결
poly = PolynomialFeatures(degree = 5, include_bias=False)
poly.fit(train_input)
train_poly = poly.transform(train_input)
test_poly = poly.transform(test_input)
print(train_poly.shape)
lr.fit(train_poly, train_target)
print(lr.score(train_poly, train_target))
print(lr.score(test_poly, test_target))
규제란? 머신러닝 모델이 훈련 세트를 너무 과도하게 학습하지 못하도록 훼방하는 것
ex) 선형 회귀 모델의 경우 특성에 곱해지는 계수(기울기)의 크기를 작게 만드는 일
릿지는 계수를 제곱한 값을 기준으로 규제를 적용
라쏘는 계수의 절댓값을 기준으로 규제를 적용
일반적으로 릿지를 조금 더 선호
두 알고리즘 모두 계수의 크기를 줄이지만 라쏘는 아예 0으로 만들 수 도있음.
from sklearn.preprocessing import StandardScaler
ss = StandardScaler()
ss.fit(train_poly)
train_scaled = ss.transform(train_poly)
test_scaled = ss.transform(test_poly)
from sklearn.linear_model import Ridge
ridge = Ridge()
ridge.fit(train_scaled, train_target)
print(ridge.score(train_scaled, train_target))
print(ridge.score(test_scaled, test_target))
릿지와 라쏘 모델을 사용할 때 규제의 양을 임의로 조절할 수 있다.
모델 객체를 만들 때 alpha 매개변수로 규제의 강도를 조절
alpha 값이 크면 규제 강도가 세지므로 계수 값을 줄이고 조금 더 과소적합되도록 유도한다.
alpha 값이 작으면 계수를 줄이는 역할이 줄어들고 선형 회귀 모델과 유사해지므로 과대적합될 가능성이 커진다.
alpha 값은 릿지 모델이 학습하는 것이 아니라 사전에 지정해야 하는 값이다. 이렇게 머신러닝 모델이 학습할 수 없고 사람이 알려줘야 하는 파라미터를 하이퍼파라미터 라고 표현한다.
import matplotlib.pyplot as plt
train_score = []
test_score = []
alpha_list = [0.001, 0.01, 0.1 , 1, 10, 100]
for alpha in alpha_list:
ridge = Ridge(alpha=alpha)
ridge.fit(train_scaled, train_target)
train_score.append(ridge.score(train_scaled, train_target))
test_score.append(ridge.score(test_scaled, test_target))
plt.plot(np.log10(alpha_list), train_score)
plt.plot(np.log10(alpha_list), test_score)
plt.show()
ridge = Ridge(alpha = 0.1)
ridge.fit(train_scaled, train_target)
print(ridge.score(train_scaled, train_target))
print(ridge.score(test_scaled, test_target))
Ridge 클래스를 Lasso 클래스로 변환
from sklearn.linear_model import Lasso
lasso = Lasso()
lasso.fit(train_scaled, train_target)
print(lasso.score(train_scaled, train_target))
print(lasso.score(test_scaled, test_target))
train_score = []
test_score = []
alpha_list = [0.001, 0.01, 0.1, 1, 10, 100]
for alpha in alpha_list:
lasso = Lasso(alpha=alpha, max_iter=10000)
lasso.fit(train_scaled, train_target)
train_score.append(lasso.score(train_scaled, train_target))
test_score.append(lasso.score(test_scaled, test_target))
plt.plot(np.log10(alpha_list), train_score)
plt.plot(np.log10(alpha_list), test_score)
plt.show()
lasso = Lasso(alpha=10)
lasso.fit(train_scaled, train_target)
print(lasso.score(train_scaled, train_target))
print(lasso.score(test_scaled, test_target))
