혼공머신 Ch4
4-1 로지스틱 회귀
import pandas as pd
fish = pd.read_csv('https://bit.ly/fish_csv_data') # 7종류의 생선에 대한 문제
fish.head()
데이터프레임은 판다스에서 제공하는 2차원 표형신의 주요 데이터 구조이다.
print(pd.unique(fish['Species'])) #판다스의 unique()함수 = 특정 열에서 고유한 값 추출
fish_input = fish[['Weight', 'Length', 'Diagonal', 'Height', 'Width']].to_numpy()
print(fish_input[:5])
fish_target = fish['Species'].to_numpy()
from sklearn.model_selection import train_test_split
train_input, test_input, train_target, test_target = train_test_split(fish_input, fish_target, random_state = 422)
from sklearn.preprocessing import StandardScaler
ss = StandardScaler()
ss.fit(train_input)
train_scaled = ss.transform(train_input)
test_scaled = ss.transform(test_input)
from sklearn.neighbors import KNeighborsClassifier
kn = KNeighborsClassifier(n_neighbors = 3) # 최근접 이웃 개수 k = 3 모델
kn.fit(train_scaled, train_target)
print(kn.score(train_scaled, train_target))
print(kn.score(test_scaled, test_target))
타깃 데이터에 2개 이상의 클래스가 포함된 문제를 다중 분류 (multi class classfication)이라고 한다.
print(kn.classes) # KNeighborsClassifier에서 정렬된 타깃값은 classes 속성에 저장되어 있다.
print(kn.predict(test_scaled[:5]))
import numpy as np
proba = kn.predict_proba(test_scaled[:5])
print(np.round(proba, decimals = 4)) #소숫점 네 번째 자리까지 표기
첫 번째 열이 Bream, 두 번째 열이 Parkki 에 대한 확률
[[0. 0. 0.3333 0. 0. 0.6667 0. ][0. 0.3333 0.3333 0. 0.3333 0. 0. ]
[0. 0. 0.6667 0. 0.3333 0. 0. ][1. 0. 0. 0. 0. 0. 0. ]
[0. 0. 0.3333 0. 0.3333 0. 0.3333]]
distances, indexes = kn.kneighbors(test_scaled[3:4]) #네 번째 샘플의 최근접 이웃 클래스 확인
print(train_target[indexes])
로지스틱 회귀(logistic regression)는 이름은 회귀이지만 분류모델이다.
선형 회귀와 동일하게 선형 방정식을 학습한다.(교재에 있는 방정식 캡쳐 p.181)
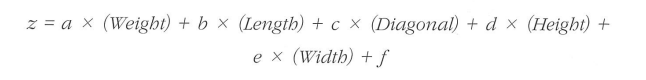
z는 어떤 값도 가능하지만 확률이 되려면 0~1이어야 하므로 시그모이드 함수 or 로지스틱 함수 를 사용한다.!
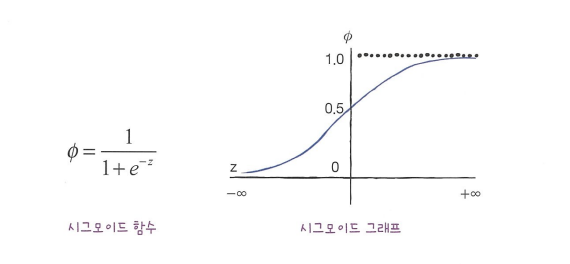
import numpy as np
import matplotlib.pyplot as plt
z = np.arange(-5, 5, 0.1)
phi = 1 / (1 + np.exp(-z))
plt.plot(z, phi)
plt.show()
char_arr = np.array(['A', 'B', 'C', 'D', 'E'])
print(char_arr[[True, False, True, False, False]]) # boolean indexing
도미(Bream)와 빙어(Smelt) 행만 골라내기
bream_smelt_indexes = (train_target == 'Bream') | (train_target == 'Smelt')
train_bream_smelt = train_scaled[bream_smelt_indexes]
target_bream_smelt = train_target[bream_smelt_indexes]
from sklearn.linear_model import LogisticRegression
lr = LogisticRegression()
lr.fit(train_bream_smelt, target_bream_smelt)
print(lr.predict(train_bream_smelt[:5]))
print(lr.predict_proba(train_bream_smelt[:5]))
#알파벳순으로 Bream이 음성 Smelt 가 양성
#첫 번째 열이 음성의 확률 두 번째가 양성의 확률
['Bream' 'Bream' 'Bream' 'Smelt' 'Smelt'][9.85882487e-01 1.41175128e-02][9.99417647e-01 5.82353143e-04]
[9.99535562e-01 4.64438498e-04][2.76815106e-02 9.72318489e-01]
[6.24989863e-02 9.37501014e-01]]
print(lr.coef, lr.intercept)
#교재 p.185 방정식 참고
로지스틱 회귀 모델이 학습한 방정식은 아래와 같이 나온다.
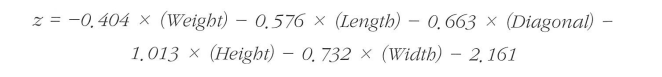
decisions = lr.decision_function(train_bream_smelt[:5]) # train_bream_smelt의 처음 5개 샘플
print(decisions) # 이 z 값을 시그모이드 함수에 통과시키면 확률을 얻을 수 있다
from scipy.special import expit
print(expit(decisions)) #predict_proba() 메서드 출력의 두 번째 열의 값과 동일 = 즉 양성 클래스에 대한 z값 반환
여기까지가 이진 분류를 위해 2개의 생선 샘플을 고르고 이를 로지스틱 회귀 모델 훈련.
이진 분류일 경우 predictproba() 메서드는 음성 클래스와 양성 클래스에 대한 확률을 출력, decision_function() 메서드는 양성 클래스에 대한 z값을 계산, coef속성과 intercept_속성에는 로지스틱 모델이 학습한 선형 방정식의 계수가 들어있다.
LogisticRegression은 기본적으로 릿지 회귀와 같이 계수의 제곱을 규제한다. (L2규제라고도 부른다) 릿지 회귀에서는 alpha 매개변수로 규제의 양을 조절했다. alpha가 커지면 규제도 커진다. LogisticRegression에서 규제를 제어하는 매개변수는 C이다. C는 alpha와 반대로 작을수록 규제가 커진다.
C의 기본값은 1.
#LogisticRegression 클래스로 다중 분류 모델을 훈련하는 코드
lr = LogisticRegression(C=20, max_iter=1000)
lr.fit(train_scaled, train_target)
print(lr.score(train_scaled, train_target))
print(lr.score(test_scaled, test_target))
print(lr.predict(testscaled[:5]))
proba = lr.predict_proba(test_scaled[:5])
print(lr.classes) # 각 열에 맞는 생선들의 확률 값
print(np.round(proba, decimals=3))
print(lr.coef.shape, lr.intercept.shape)
coef 와 intercept의 행이 7개인것은 이진 분류에서 보았던 z를 7개나 계산한다는 의미이다. 이렇듯 다중 분류는 클래스마다 z값을 하나씩 계산한다. 다중 분류는 이중 분류에서 시그모이드 함수를 사용한 것과 다르게 소프트맥스 softmax 함수를 사용하여 7개의 z 값을 확률로 변환한다.
시그모이드 함수는 하나의 선형 방정식의 출력값을 0~1 사이로 압축한다.
소프트맥스 함수는 여러 선형 방정식의 출력값을 0~1 사이로 압축하고
전체 합이 1이 되도록 만든다. 이를 위해 지수 함수를 사용하기 때문에 정규화된 지수 함수라고도 한다.
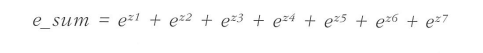
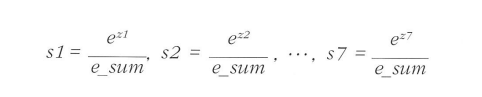
#decision_function() 매서드로 z1~z7 값을 구한 다음 소프트맥스 함수를 사용해 확률로 변환
decision = lr.decision_function(test_scaled[:5])
print(np.round(decision, decimals=2))
from scipy.special import softmax
proba = softmax(decision, axis=1) #axis=1로 지정하여 각 행(샘플)에 대해 소프트맥스를 계산한다. 지정하지 않으면 배열 전체에 대해 계산
print(np.round(proba, decimals=3)) #앞의 proba 배열과 일치, 즉 로지스틱 회귀로 얻은 확률이 소프트맥스로 계산한 값과 같음을 보인다.
4-2 확률적 경사 하강법
점진적인 학습
훈련 데이터가 한 번에 준비되는 것이 아닌 조금씩 전달되는 것이 문제
- 데이터가 쌓일 때까지 무작정 기다릴 수 없음
- 기존 훈련 데이터에 새로운 데이터를 추가하여 모델을 매일 다시 훈련시킨다? -> 시간이 지나면 데이터가 늘어나 서버를 늘려야 할 것임
- 새로운 데이터를 추가할 때 이전 데이터를 버림으로써 훈련 데이터 크기를 일정하게 유지한다? -> 데이터를 버릴 때 다른 데이터에 없는 중요한 데이터가 포함되어 있다면 ..?
앞서 훈련한 모델을 버리지 않고 새로운 데이터에 대해서만 조금씩 더 훈련할 수는 없나? -> 이런 식의 훈련 방식을 점진적 학습이라고 한다.
대표적인 점진적 학습 알고리즘으로는 확률적 경사 하강법이 있다.
<확률적 경사 하강법>은 훈련 세트에서 랜덤하게 하나의 샘플을 선택하여 가파른 경사를 조금 내려간다. 그다음 훈련 세트에서 랜덤하게 또 다른 샘플을 하나 선택하여 경사를 조금 내려가며 전체 샘플을 모두 사용할 때까지 계속한다.
만약 경사를 다 내려오지 못했다면? -> 다시 처음부터 시작..ㅋㅋ;;
확률적 경사 하강법에서 훈련 세트를 한 번 모두 사용하는 과정을 에포크(epoch)라고 부른다.
1개씩 말고 무작위로 몇 개의 샘플을 선택해서 경사를 따라 내려간다면?
-> 가능함! 여러 개의 샘플을 사용해 경사 하강법을 수행하는 방식을 미니배치 경사 하강법이라고 한다.
극단적으로 한 번 경사로를 따라 이동하기 위해 전체 샘플을 사용할 수도 있음 -> 배치 경사 하강법 -> 전체 데이터를 사용하기 때문에 가장 안정적인 방법이 될 수 있지만 전체 데이터를 사용하면 그만큼 컴퓨터 자원을 많이 사용하고 데이터가 너무 많아 한 번에 전체 데이터를 모두 읽을 수 없을 수도 있음
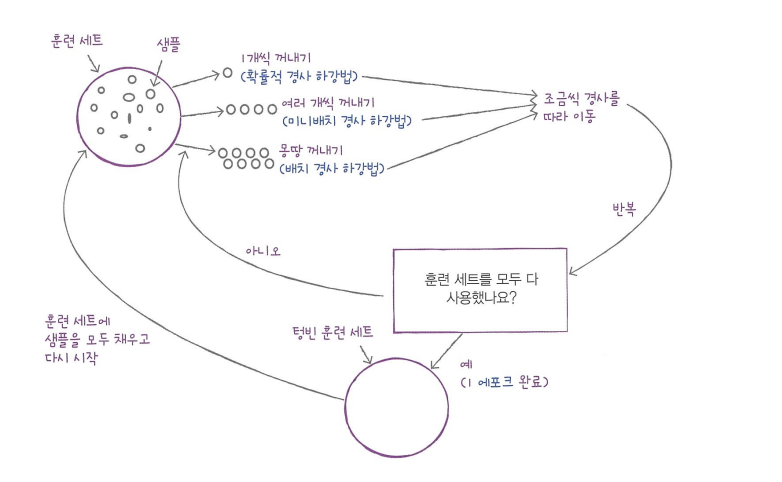
확률적 경사 하강법은 훈련 세트를 사용해 최적의 장소로 조금씩 이동하는 알고리즘으로 훈련 데이터가 모두 준비되어 있지 않고 매일매일 업데이트되어도 학습을 계속 이어나갈 수 있다.
(확률적 경사 하강법은 신경망 알고리즘에서 꼭 사용된다. 신경망은 일반적으로 많은 데이터를 사용하기 때문에 한 번에 모든 데이터를 사용하기 어렵고 모델이 매우 복잡하기 때문에 수학적인 방법으로 해답을 얻기 어렵다. 신경망 모델은 확률적 경사 하강법이나 미니배치 경사 하강법을 사용한다.)
<손실 함수> (loss function)는 어떤 문제에서 머신러닝 알고리즘이 얼마나 엉터리인지를 측정하는 기준이다. 작을 수록 좋지만 최솟값을 알지 못하므로 가능한 많이 찾아보고 만족할만한 수준이면 인정해야됨..ㅜ
(손실 함수는 샘플 하나에 대한 손실을 정의하고 비용 함수는 훈련 세트에 있는 모든 샘플에 대한 손실 함수의 합을 말하지만 엄격히 구분하지는 않음)
기술적으로 말하면 손실 함수는 미분 가능(연속적, not 듬성듬성)해야 한다.
분류에서 손실 = 정답을 못 맞히는 것
<로지스틱 손실 함수>
샘플의 예측 정답(양성 클래스의 타깃) -> 음수로 변환
샘플의 타깃이 음성 클래스인 경우 : (1-샘플의 예측)정답(양성 클래스처럼 1로 바꿈) -> 음수로 변환
예측 확률을 사용해 계산하면 연속적인 손실 함수를 얻을 수 있다.
예측 확률에 로그 함수를 적용 -> 예측 확률의 범위는 0~1 사이인데 로그함수는 이 사이에서 음수가 되므로 최종 손실 값은 양수가 된다.
로그 함수는 0에 가까울 수록 아주 큰 음수가 되기 때문에 손실을 아주 크게 만들어 모델이 큰 영향을 미친다. 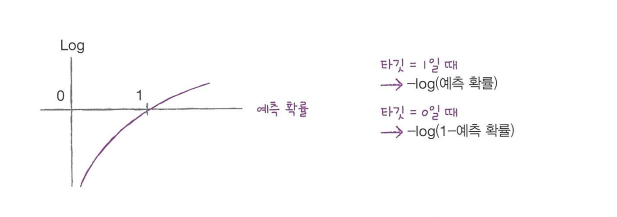
이 손실 함수를 로지스틱 손실 함수(이진 크로스엔트로피 손실 함수)라고 부른다.
다중 분류에서 사용하는 손실 함수 : 크로스엔트로피 손실 함수
(회귀의 손실 함수는 타깃에서 예측을 뺀 절댓값을 모든 샘플에 평균한 값인 평균 절댓값 오차를 사용할 수 있다. 또는 평균 제곱 오차. 값이 작을수록 좋은 모델이다.)
#SGDClassifier
import pandas as pd
fish = pd.read_csv('https://bit.ly/fish_csv')
fish_input = fish[['Weight', 'Length', 'Diagonal', 'Height', 'Width']].to_numpy()
fish_target = fish['Species'].to_numpy() #Species열을 제외한 나머지는 5개의 입력데이터로 사용, Species열은 타겟데이터
#훈련/테스트 세트로 데이터를 나눈다
from sklearn.model_selection import train_test_split
train_input, test_input, train_target, test_target = train_test_split(fish_input, fish_target, random_state=42)
#훈련/테스트 세트의 특성을 표준화 전처리한다.
from sklearn.preprocessing import StandardScaler
ss = StandardScaler()
ss.fit(train_input) #(강조 : 꼭 훈련 세트에서 학습한 통계 값으로 테스트 세트도 변환해야 한다.)
train_scaled = ss.transform(train_input)
test_scaled = ss.transform(test_input)
#사이킷런에서 확률적 경사 하강법을 제공하는 대표적인 분류용 클래스는 SGDClassifier이다
from sklearn.linear_model import SGDClassifier
sc = SGDClassifier(loss='log', max_iter=10, random_state=42)
#로지스틱 손실 함수 지정 : loss='log'
#수행할 에포크 횟수 지정 : max_iter = 10
sc.fit(train_scaled, train_target)
print(sc.score(train_scaled, train_target))
print(sc.score(test_scaled, test_target))
ConvergenceWarning 경고 -> max_iter 매개변수 값을 늘려 주는 것이 좋다
지정한 반복 횟수 10번이 부족한 것으로 보임
sc.partial_fit(train_scaled, train_target)
print(sc.score(train_scaled, train_target))
print(sc.score(test_scaled, test_target))
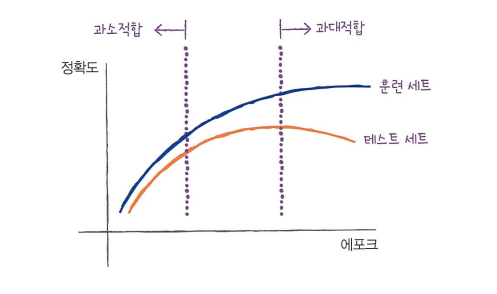
에포크과 과대/과소적합
import numpy as np
sc = SGDClassifier(loss='log', random_state=42)
train_score = []
test_score = []
classes = np.unique(train_target)
#fit 이 아닌 partial_fit 메서드만 사용 -> 훈련 세트에 있는 전체 클래스의 레이블을 partial_fit 메서드에전달해줘야한다
#이를 위해 np.unique 함수로 train_target에 있는 7개 생선의 목록을 만들고 에포크마다 훈련/테스트 세트에 대한 점수를 기록하기 위한 리스트 준비
for _ in range(0, 300):
sc.partial_fit(train_scaled, train_target, classes=classes)
train_score.append(sc.score(train_scaled, train_target))
test_score.append(sc.score(test_scaled, test_target))
import matplotlib.pyplot as plt
plt.plot(train_score)
plt.plot(test_score)
plt.show()
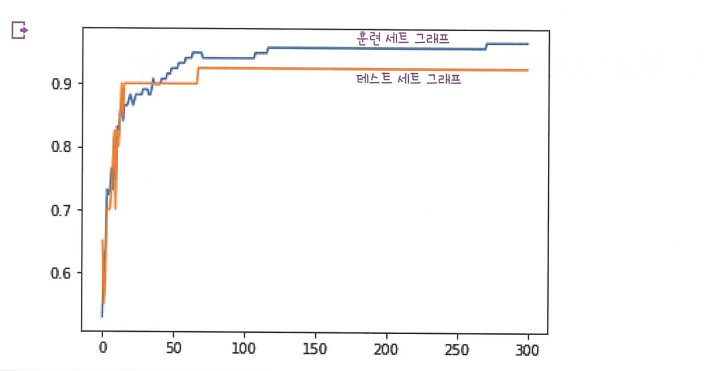
#SGDClassifier의 반복 횟수를 100에 맞추고 다시 훈련
sc = SGDClassifier(loss ='log', max_iter=100, tol=None, random_state=42)
sc.fit(train_scaled, train_target)
print(sc.score(train_scaled, train_target))
print(sc.score(test_scaled, test_target))
SGDClassifier는 일정 에포크 동안 성능이 향상되지 않으면 훈련을 종료한다. tol 매개변수에서 향상될 최솟값을 지정한다.
loss 매개변수의 기본값은 'hinge' 이다. 힌지손실/서포트 벡터 머신이라 불리는 다른 머신러닝 알고리즘을 위한 손실 함수이다.
