[논문 리뷰 & 코드 구현] U-Net (U-Net: Convolutional Networks for Biomedical Image Segmentation)
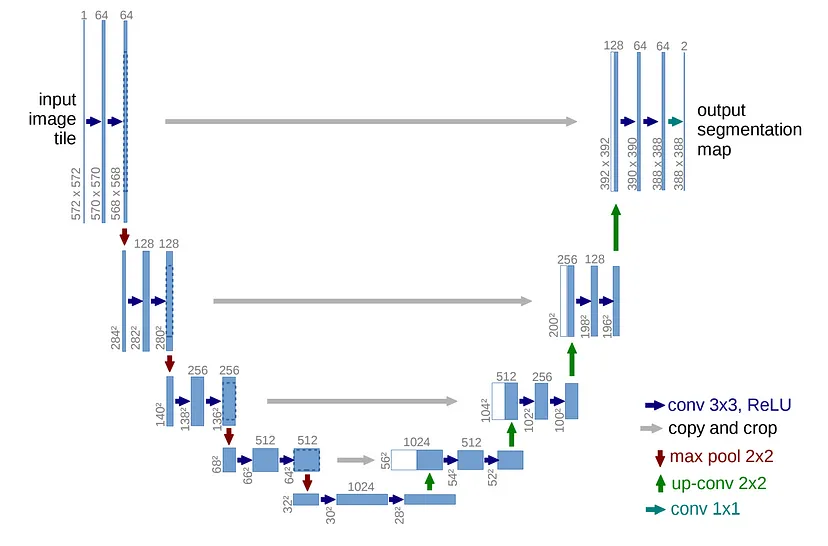
Image segmentation에서 유명한 모델인 U-Net에 대해 알아보자. 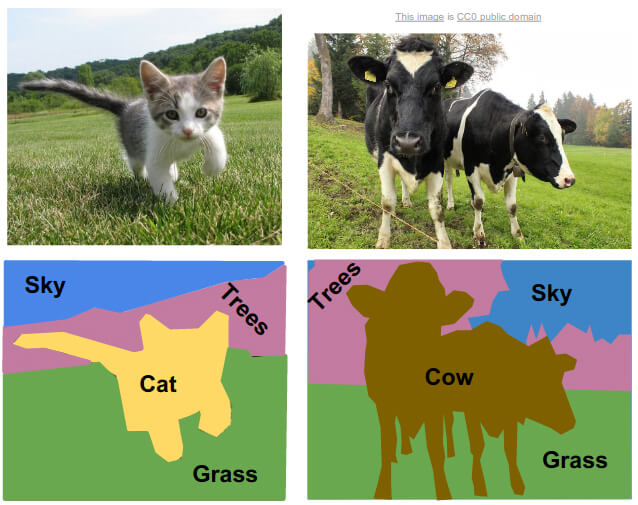 단순히 객체의 클래스를 예측(classification)하거나 감지(object detection)하는 것 뿐만 아니라, 이미지의 모든 픽셀을 클래스로 분류하는 작업이다.
U-Net은 특히 biomedical 목적으로 만들어진 네트워크인데, 세포 등 작은 이미지에 대해 효과적으로 image segmentation을 수행한다. 전체적으로 U 모양으로 네트워크가 구성돼있어 U-Net이라고 한다.
논문 링크
0. Abstract
먼저 본 논문에서는 훈련과정에서 data augmentation을 적극 활용하고자 한다. 참고로 U-Net이 사용한 데이터셋은 "Transmitted light microscopy images"로, 30여 개의 굉장히 적은 데이터이다. 그래서 높은 성능을 위해 데이터 증강에 노력을 기울인 것 같다.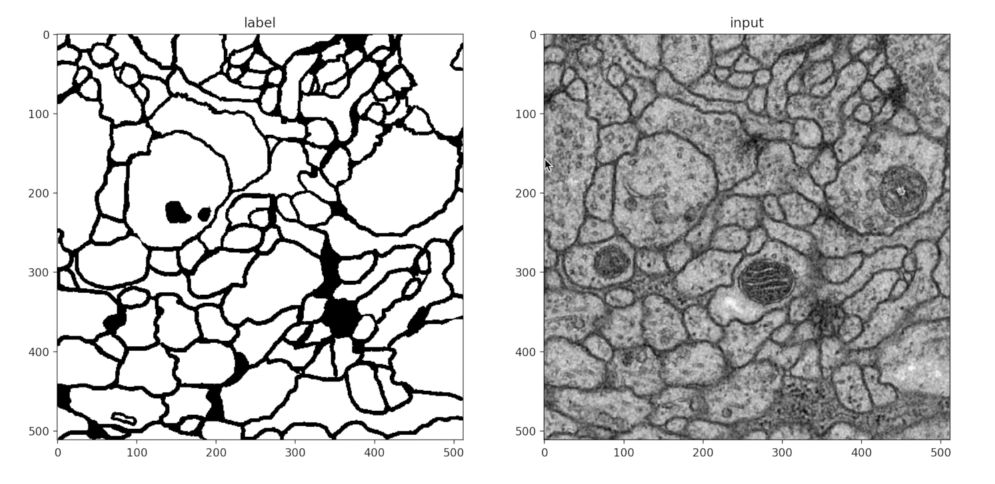 또한, contracting path (인코더)와 expanding path (디코더)로 구성된 end-to-end 네트워크를 제시한다. 결과적으로 U-Net은 적은 수의 이미지로도 정확한 segmentation 성능을 낸다.
1. Introduction
Biomedical 분야에서는 앞서 설명했듯이 단순 classification 보다 localization이 중요하다. 각 픽셀 별로 classification을 수행해야 하는 것이다. 이를 위해 과거에는 특정 픽셀과 그 주변 부분을 patch로 만들어 입력 데이터로 활용하는 sliding window setup 방식이 제시됐다.
하지만 이 방식은 두 가지의 문제가 있었는데:
1) patch 마다 네트워크를 적용하여 속도가 느리고 겹치는 영역이 많아 연산량은 늘어남
2) patch 크기에 따라 localization과 특징 추출 사이 trade-off가 발생함
U-Net은 FCN (Fully Convolutional Network) 구조를 활용하여 이러한 문제들을 개선한다! FCN 논문
U-Net 만의 특징을 세 가지로 정리하자면:
1) 인코더의 feature map과 디코더의 feature map이 concat되는 구조
2) elastic deformation을 통해 적은 데이터셋을 보완
3) 거리에 따른 가중치를 부여한 loss를 활용해 경계를 더 잘 구분
2. Network Architecture
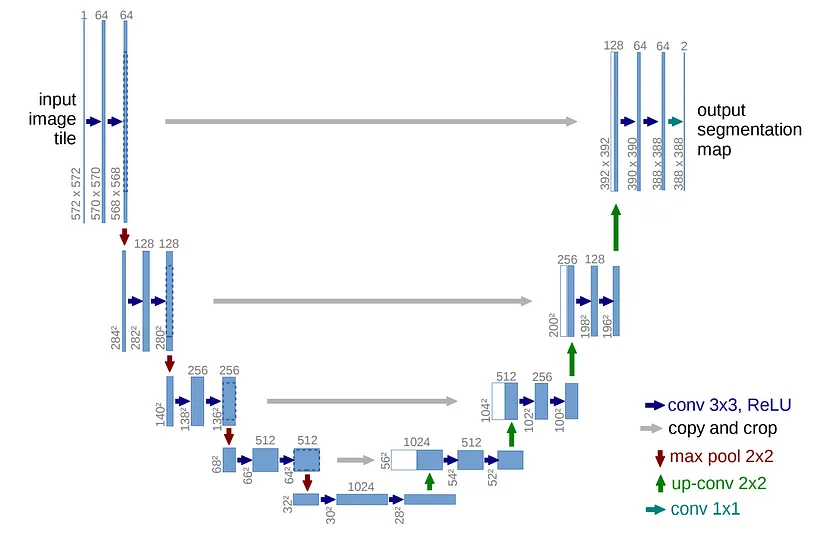 U-Net은 왼쪽 부분인 contracting path와 오른쪽 부분인 expanding path으로 구성돼있다. 회색 화살표는 skip architecture를 통해 concat하는 과정이다.
1) Contracting path (encoder)
입력 이미지의 특징 추출을 위한 단계로, 일반적인 CNN 구조를 활용한다. 각 step마다 두 번의 3x3 conv와 ReLU를 적용 (보라색 화살표)한다. 이때 padding이 존재하지 않아 이미지 크기는 약간 줄어든다.
다음 step으로 넘어갈 때는 2x2 maxpool을 이용해 downsampling하며, 이때 채널 수는 2배 늘리게 된다 (빨간색 화살표)
2) Expanding path (decoder)
정확한 localization을 위한 단계이며, contracting path와 구조가 symmetric 하다. 다만 이전 단계에서 추출된 feature map을 up-sampling하여 확장한다.
다음 step으로 넘어갈 때마다 2x2 up-convolution (초록색 화살표)을 통해 이미지 사이즈는 2배로 늘리고 채널 수는 절반으로 줄인다.
또한, 마찬가지로 각 step 별로 두 번의 3x3 conv와 ReLU를 적용한다. 이때 역시 padding이 없기 때문에 최종적인 output size (388x388)는 input size (572x572) 보다 작다.
그림을 자세히 보면 각 step의 첫 layer의 채널 수는 2배 크기인 것을 알 수 있다 (하얀 block과 파란 block 붙어있음). 이는 바로 skip connection (회색 화살표)으로, 같은 level의 contracting path step에서 나온 feature map을 적절하게 crop 하여 concat하는 것이다.
Context 정보와 localization 정보를 결합하는 것이라고 생각할 수 있다.
마지막에는 fc layer가 아니라 1x1 conv layer로 mapping 해주는데, 픽셀 별 위치정보를 최대한 보존하기 위해서이다.
3. Training
1) Data Preprocessing (Overlap-tile strategy & Mirroring Extrapolation)
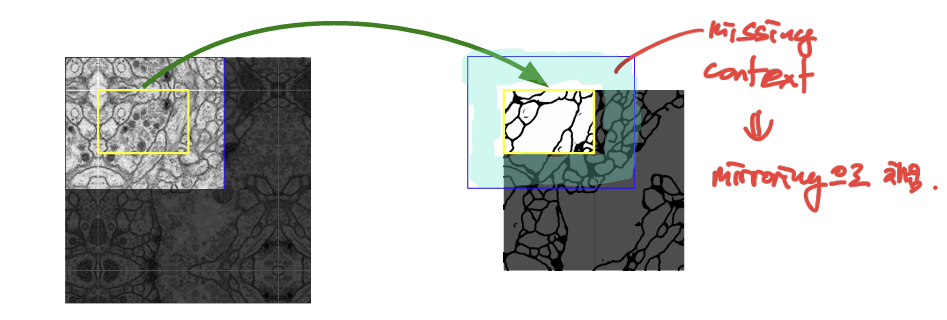 입력 데이터 크기의 제약 없이 U-Net을 활용하기 위해 overlap-tile strategy를 제안하였다. 이미지를 여러 tile로 나누어 입력 데이터로 사용하는데, 파란색 테두리 부분이 하나의 tile이다. U-Net에 이를 입력하면 노란색 테두리 부분이 segmentation 결과 일부분으로 출력된다 (padding이 없어서 출력 크기가 더 작다는 것을 기억해보자!).
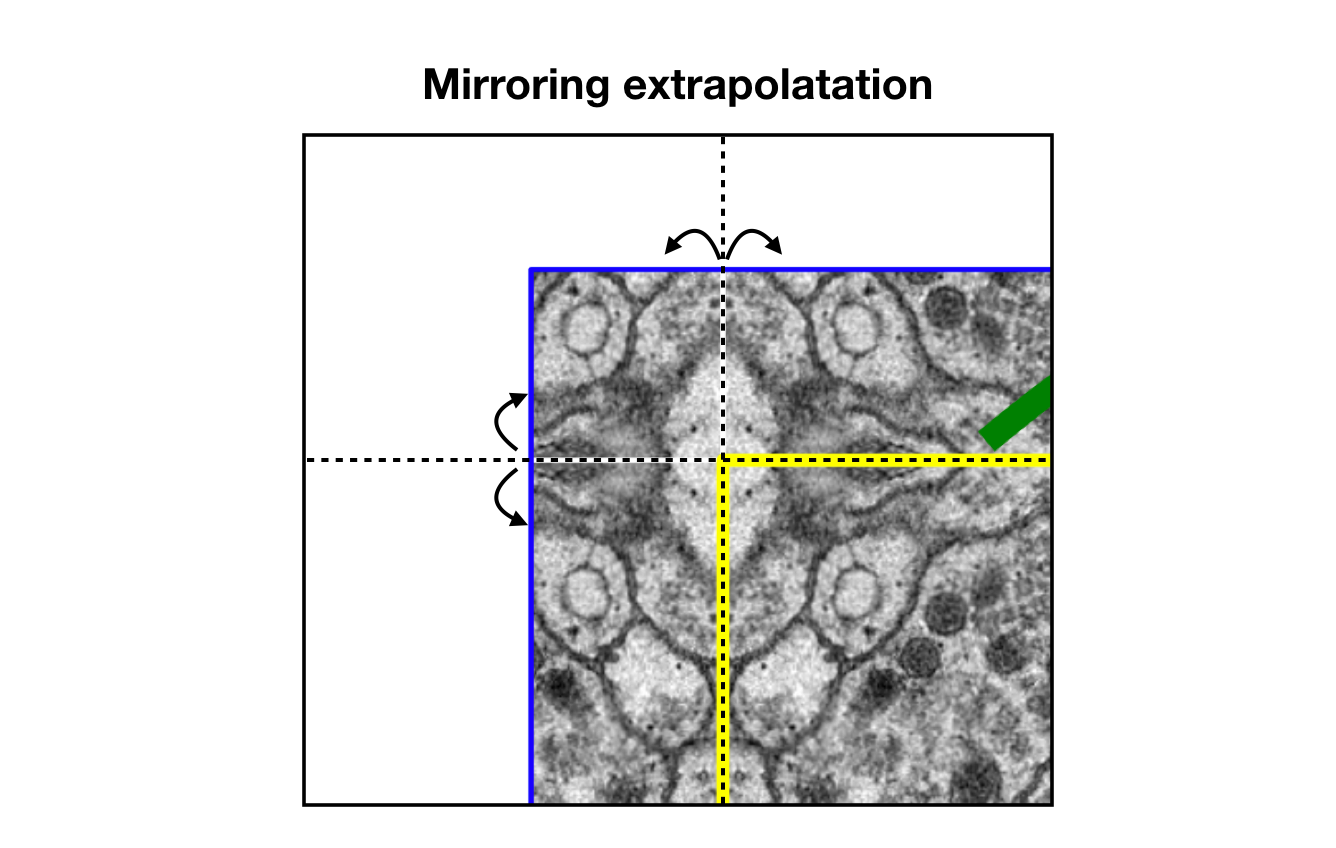 그 다음 segmentation 부분을 예측할 때는 이전 input의 일부분이 overlap 될 것이다. 이 경계 부분을 단순히 zero-padding 하는 대신 mirroring extrapolation을 한다. 마치 거울처럼, 해당 부분에 해당하는 노란색 영역을 반사한다.
2) Data Augmentation
앞서 설명했듯, U-Net이 학습하는 데이터셋은 30장의 이미지로 굉장히 적다. 따라서 data augmentation이 필수적인데, 논문에서는 shift, rotation, elastic deformation, gray value 총 4가지 방식을 사용한다.
참고로 elastic deformation은 아래 그림처럼 각 픽셀이 랜덤한 방향으로 뒤틀리게 만드는 것이다.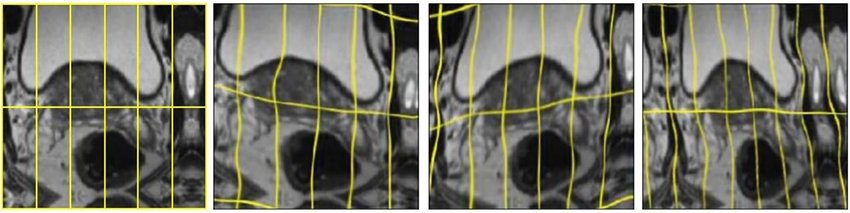
3) Weighted Loss
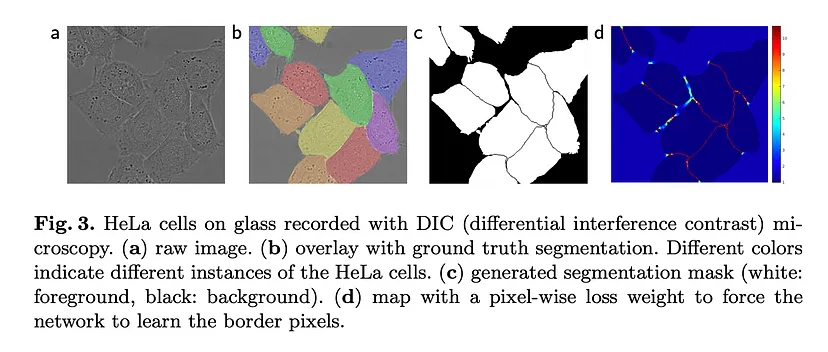 세포 사이 경계를 잘 구분하기 위해 weight map을 loss에 포함한다. Loss function은 다음과 같은데:
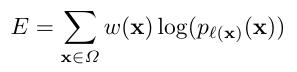 각 픽셀의 예측값에 weight 를 곱하여 cross entropy loss를 구한다.
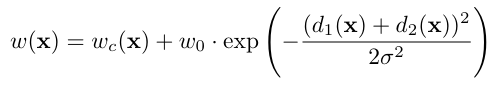 이때 이 weight map equation을 살펴보면, 픽셀에서 가장 가까운 ground truth cell (세포)까지의 거리를 , 두번째로 가까운 것은 로 정의하여 가중치를 구한다.
결과적으로 경계선에 해당하는 픽셀일 경우 더 큰 가중치를 갖게 된다.
(Fig.3.의 d 참고)
4. Experiments
 EM segmentation challenge (전자현미경으로 관측된 뉴런 구조)에서 높은 성능을 보여준다.
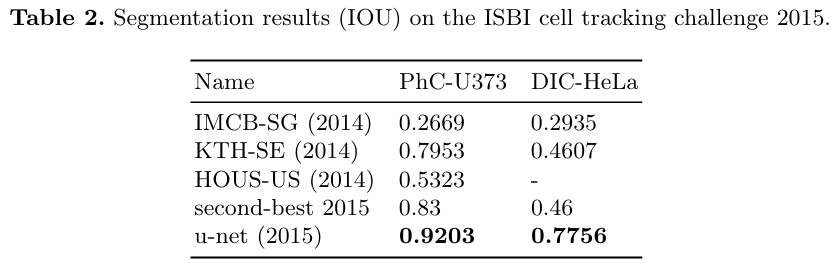 ISBI cell tracking challenge (광학현미경 관측 이미지)에서 역시 뛰어난 성능을 낸다!
모델 구현
U-Net을 pytorch로 직접 구현해보았다. 모델 구조만 구현하였으며, 실제 훈련을 위해서는 앞서 설명한 전처리 기법과 weighted loss를 추가적으로 구현해야 한다. 설명이 필요한 부분만 여기에서 다루겠다. 전체 코드는 깃허브 참고...
Expanding path의 up-sampling은 다음과 같이 ConvTranspose2d를 사용하여 구현하였다. 채널 수는 절반으로 줄이면서, 2x2 전치 합성곱으로 이미지 사이즈는 2배로 늘린다.
# expanding path (decoder)
for feature in reversed(features):
	self.dec_layer.append(nn.ConvTranspose2d(feature*2, feature, kernel_size=2, stride=2)) # up-sampling (decoder)
    self.dec_layer.append(DoubleConv(feature*2, feature))
Contracting path의 feature map을 expanding path에 skip connection으로 concat하는 과정은 다음과 같다. 이때 두 이미지의 사이즈가 다르므로 cropping을 한 뒤에 concat한다.
 # decoder + skip connection
 for idx in range(0, len(self.dec_layer), 2):
 	x = self.dec_layer[idx](x)
    skip_connection = skip_connections[idx//2]

    # image cropping for skip connection
    if x.shape != skip_connection.shape:
    	skip_connection = TF.resize(skip_connection, size=x.shape[2:])

    x = torch.cat((skip_connection, x), dim=1) # concat
    x = self.dec_layer[idx+1](x)
마지막으로, 논문에서 사용한 이미지 크기인 572x572를 넣었을 때 388x388 크기로 잘 출력되는 것을 확인할 수 있다.
model = UNet()
!pip install torchinfo
from torchinfo import summary
summary(model, (2, 3, 572, 572), device="cpu")==========================================================================================
Layer (type:depth-idx) Output Shape Param #
==========================================================================================
UNet [2, 2, 388, 388] --
├─MaxPool2d: 1-1 [2, 64, 284, 284] --
├─MaxPool2d: 1-2 [2, 128, 140, 140] --
├─MaxPool2d: 1-3 [2, 256, 68, 68] --
├─MaxPool2d: 1-4 [2, 512, 32, 32] --
├─DoubleConv: 1-5 [2, 1024, 28, 28] --
│ └─Sequential: 2-1 [2, 1024, 28, 28] --
│ │ └─Conv2d: 3-1 [2, 1024, 30, 30] 4,718,592
│ │ └─BatchNorm2d: 3-2 [2, 1024, 30, 30] 2,048
│ │ └─ReLU: 3-3 [2, 1024, 30, 30] --
│ │ └─Conv2d: 3-4 [2, 1024, 28, 28] 9,437,184
│ │ └─BatchNorm2d: 3-5 [2, 1024, 28, 28] 2,048
│ │ └─ReLU: 3-6 [2, 1024, 28, 28] --
├─Conv2d: 1-6 [2, 2, 388, 388] 130
==========================================================================================
Total params: 14,160,002
Trainable params: 14,160,002
Non-trainable params: 0
Total mult-adds (G): 23.33
==========================================================================================
Input size (MB): 7.85
Forward/backward pass size (MB): 60.00
Params size (MB): 56.64
Estimated Total Size (MB): 124.49
==========================================================================================상세 코드: https://github.com/tony3ynot/U-Net
마무리
U-Net은 비교적 간단하지만 획기적인 성능을 가진 모델이라고 생각한다. 특히 model architecture 뿐만 아니라 data preprocessing, augmentation 부분에서 성능을 끌어올리기 위해 노력한 것이 인상 깊었다.
오래된 모델이지만 U-Net은 뜻밖의 분야에서 굉장히 유용하게 사용되고 있다. DDPM (diffusion model)에서 model architecture로 U-Net을 활용하였고, 이는 생성형 ai 모델의 기반이 된다는 점에서 가치가 굉장히 큰 것 같다!
참고 자료
Ronneberger, et al. "U-Net: Convolutional Networks for Biomedical Image Segmentation". 2015.
U-Net: Convolutional Networks for Biomedical Image Segmentation - 논문 리뷰
U-Net 논문 리뷰 — U-Net: Convolutional Networks for Biomedical Image Segmentation