2016년 CVPR에 처음 발표되어 object detection 분야에서 큰 축을 차지한 YOLO 모델을 알아보자. 오늘 리뷰할 모델은 YOLO v1으로, 현재 무려 v11까지 나온 YOLO 시리즈의 첫 모델이다. 기존 객체 감지 분야는 R-CNN 등의 2-stage detector가 지배적이었는데, YOLO 시리즈를 시작으로 1-stage dectector 모델 역시 비약적인 성능 발전이 일어났다.
참고로 이 글을 읽기 전 R-CNN 시리즈를 먼저 읽으면 더 도움이 될 것 같다.
논문 링크
0. Abstract
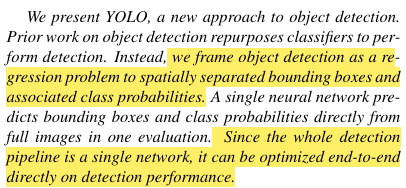 YOLO 이전의 객체 감지 모델들, 특히 2-stage dectector는 여러 면에서 속도가 느렸다. Detection을 위해 classifier를 여러 번 사용하였고, region proposal 단계와 feature extraction 단계가 나뉘어 있었다.
YOLO에서는 이 모든 것을 한 번에 처리하고자 한다. Bounding box와 class 예측을 한 번에 수행하고, 전체 pipeline이 single network이기에 end-to-end 학습이 가능하다!
괜히 "You Only Look Once" 가 아니다.
1. Introduction
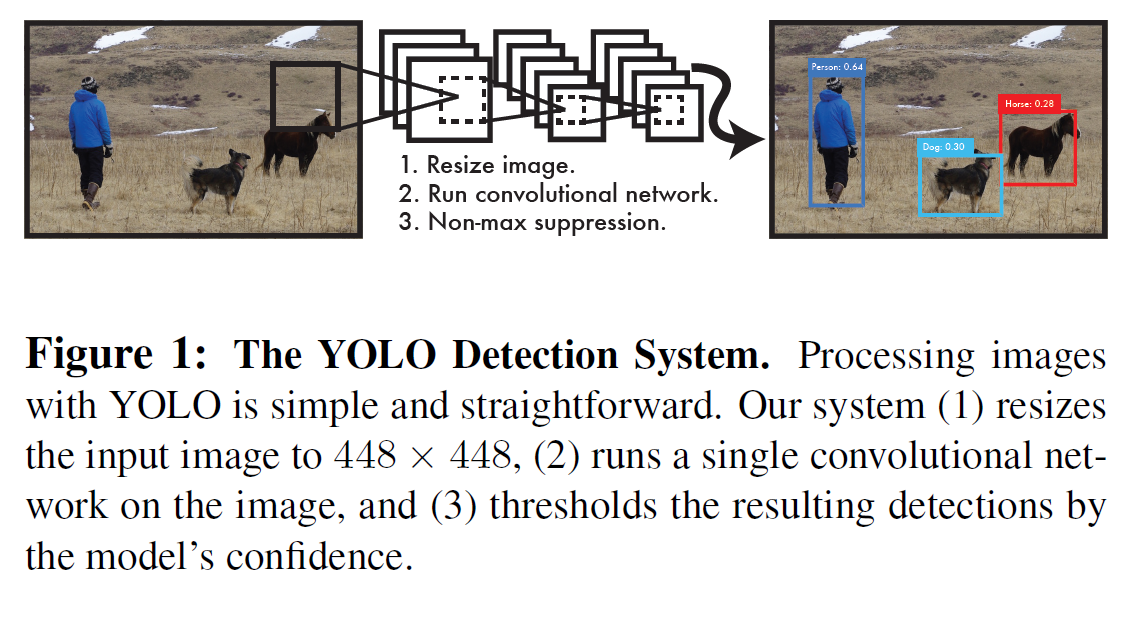 YOLO의 구조는 상당히 간단한데, **하나의 conv net**이 여러 개의 bounding box와 그 class probabilities를 **동시에 예측**한다. Object detection을 **single regression problem**으로 재정립할 수 있게 된 것이다.
이러한 구조에 따른 몇 가지의 장점이 존재하는데:
1) 굉장히 빠르다. 단순히 하나의 네트워크만 사용하여 예측하기 때문이다.
2) 이미지 전체 맥락을 고려한다. Sliding window나 region proposal 대신 이미지 전체를 다루므로 전체 맥락을 판단할 수 있다.
3) 일반화 능력이 뛰어나다. 사전 학습 이후 새로운 도메인 데이터 테스트 시 좋은 성능을 보였다.
다만 논문에서는 YOLO가 accuracy 측면 (특히 작은 물체 검출 시)에서 뒤쳐진다고 밝힌다. 속도와 정확도의 trade-off가 존재하는 것이다.
2. Unified Detection
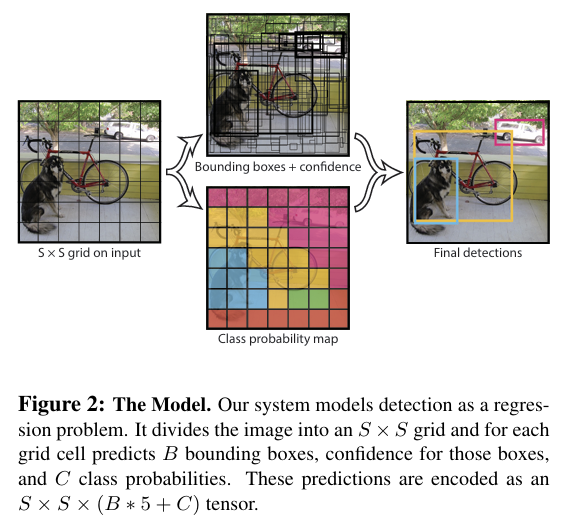 전체적인 과정을 살펴보면, 하나의 이미지를 S x S의 grid로 먼저 나눈다. 각 grid cell은 B개의 bounding box와 그 confidence score라는 것을 예측한다. 참고로 confidence score는 bounding box 안에 객체가 존재하는지에 대한 척도이다. 이후에 자세히 설명하도록 하겠다.
동시에 YOLO는 C개의 class를 예측하는 작업도 수행한다. 따라서 최종 예측 텐서는 S x S x 의 shape을 가지게 된다.
논문에서는 7 x 7 그리드, PASCAL VOC 데이터셋을 사용 (20개의 label), grid cell 당 2개의 b-box를 사용하여 (7 x 7 x 30) output이 나온다.
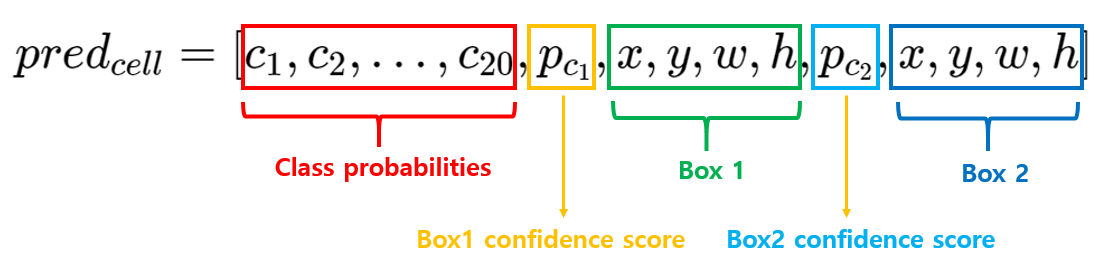 YOLO의 핵심 아이디어는 바로 이 pred output에 있다고 볼 수 있다.
1) 먼저 ~ 은 각 클래스에 대한 conditional class probabilities이다. , 즉 특정 grid cell에 object가 존재할 때 class i일 확률을 구한다. 자명하게도 이는 classification problem이 된다.
2) , 는 각 bounding box의 confidence score이다.
로 나타내는데,'box 안에 object가 존재할 확률()'과 'ground truth box를 얼마나 잘 예측했는지()'를 곱한 수치다. Confidence score는 0~1 사이이므로 regression problem이 된다.
3) 마지막으로 grid cell의 각 box 별로 존재하는 는 bounding box의 위치를 나타내는 좌표다. 마찬가지로 regression을 통해 각 box가 ground-truth box 위치에 가까워지도록 하는 것이다.
2-1. Network Design
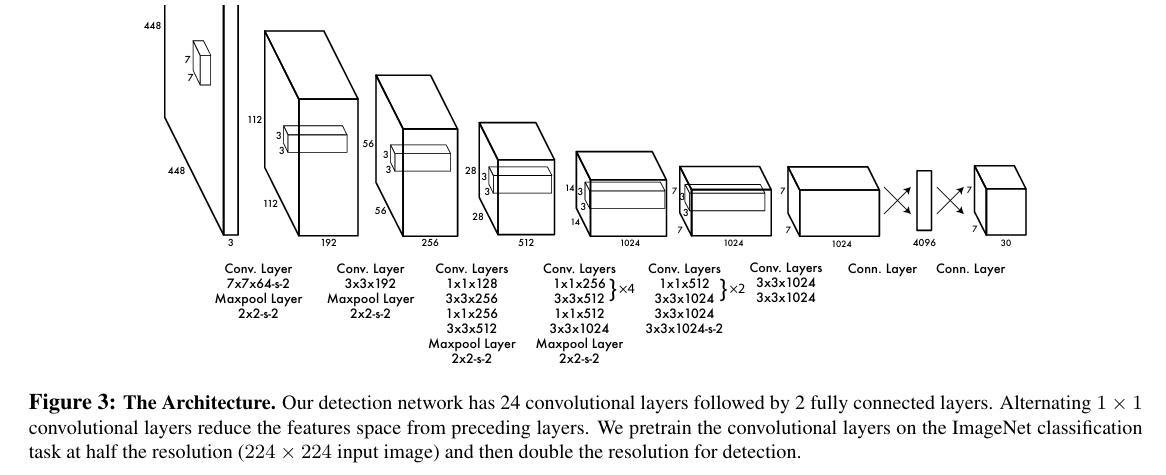 기본적으로 사전학습된 CNN 모델을 활용하는데, GoogLeNet을 변형한 DarkNet을 구현하였다.
2-2. Training
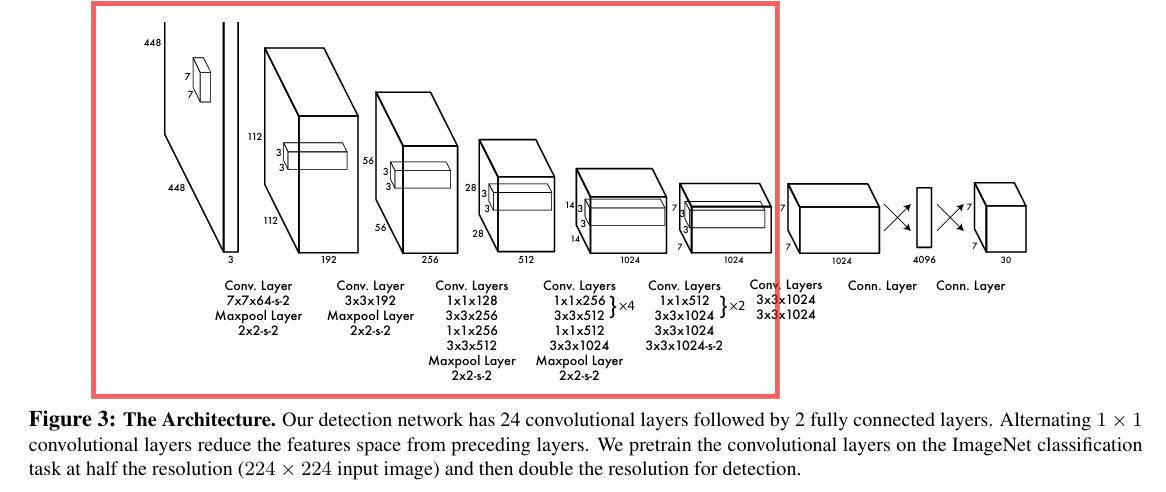 먼저 앞쪽 20개의 conv layer (빨간색 박스 부분)를 ImageNet 데이터셋에 사전학습시킨다. 객체 감지 데이터셋은 많지 않기 때문에, 사전학습으로 좀 더 풍부한 image feature 학습이 가능하도록 한 것이다. 이후 4개의 conv layer, 그리고 2개의 fc layer를 추가해 detection 과제에 적합한 모델로 변형한다.
ImageNet 데이터셋의 이미지 크기는 224 x 224인데 (사전 학습 시), detection을 위한 학습 단계에서는 448 x 448로 키운다. Detection 과제 특성상 'fine-grained' 시각 정보를 필요로 하기 때문이다.
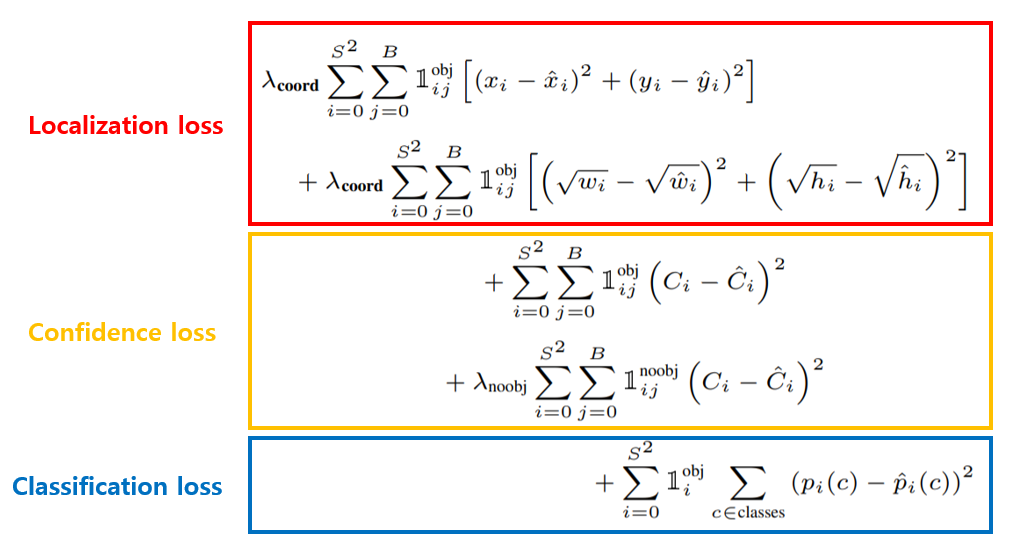
이제 YOLO의 loss function을 알아보자. 위에서 설명했듯이 YOLO는 3가지 정보를 예측해야 한다. 1) class 2) confidence score 3) box location. 이 모든 것을 따로 따로 하는 것이 아니라 한 번에 수행한다는 점에서 YOLO는 획기적이었다. Loss function 역시 독창적인 구조로, 총 3가지의 loss가 합쳐진 형태이다.
1) Classification Loss
먼저 가장 아래에 있는 classification loss 부터 살펴보자. 은 특정 cell 안에 객체가 있는지 여부를 나타내므로, 앞서 설명했듯 grid cell 안에 객체가 존재할 때 class conditional probability의 loss를 계산한다.
2) Confidence Loss
각 bounding box 별 confidence score의 loss를 계산하는데, bounding box 안에 객체가 존재할 경우와 존재하지 않을 경우로 나뉘어있다. 객체가 존재하지 않는 경우에는 confidence score가 0에 가까워지게 학습을 해야 한다. 이때 그 가중치 를 0.5로 설정하여 객체가 존재하지 않는 grid cell의 영향력을 줄였다.
3) Localization Loss
마지막으로 각 box의 위치 좌표 와 ground truth 좌표의 loss를 구한다. 여기서 는 두 개의 box 중 IOU가 더 큰 box를 1, 그렇지 않은 것을 0으로 나타내는 index parameter이다. 따라서 각 cell 별로 'responsible'한 box에 대해서만 위치 학습을 하는 것이다. 또한, localization loss 가중치 는 5로 설정하여 중요도를 높였는데, object detection의 특성상 객체가 존재하는 부분을 찾는 것이 중요하기 때문이다.
2-3. Inference
테스트 단계에도 마찬가지로 single network를 사용한다. 다만 training 때와 달리 각 box 별로 class-specific confidence score이라는 것을 구한다.
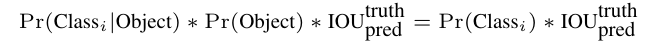 최종적으로 detection 결과를 나타낼 때는 98개의 box (7x7x2) 중 객체가 존재하는 box만을 남겨야한다. 또한, 하나의 객체에 대해서는 겹치는 box들 중 가장 score가 높은 하나의 box만 출력해야 한다. 이를 위해 NMS (Non-maximal suppression)이라는 알고리즘을 활용한다.
2-4. Limitations of YOLO
1) 각 grid cell은 2개의 bounding box만 예측하고 하나의 class만 나타내므로 작은 물체나 모여있는 물체들을 감지하는데 성능이 떨어진다.
2) 학습 데이터와 다른 비율과 형태를 지닌 객체에 대한 일반화에 어려움이 있다.
3) Loss function 특성상 크기가 작은 b-box의 localization 성능이 특히 낮다.
3. 결과
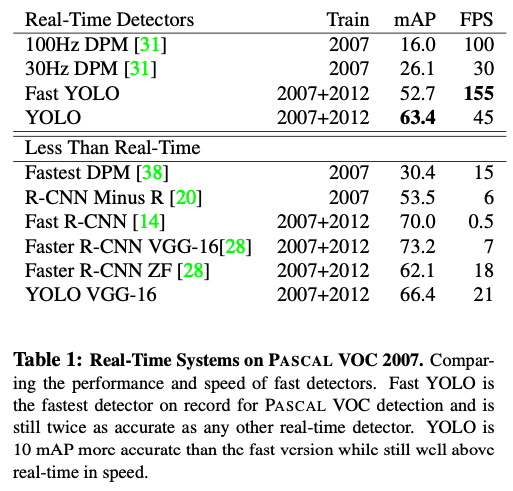 다른 real-time detectors (빠른 모델들)와 비교했을 때 준수한 속도와 훨씬 높은 정확도를 보여준다. R-CNN 등의 non real-time detectors와 비교했을 때도 정확도가 크게 뒤쳐지지 않는 모습니다.
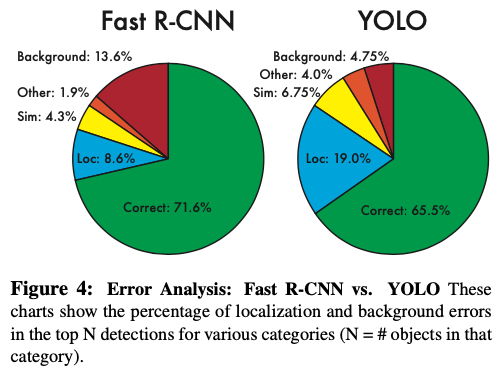 R-CNN과 YOLO의 error 종류를 비교했을 때, YOLO는 localization error가 가장 높지만 background error가 상당히 낮다는 것을 볼 수 있다.
즉 YOLO는 bounding box의 정확도가 떨어지지만, '객체와 배경을 구분하는 능력'이 뛰어나다!
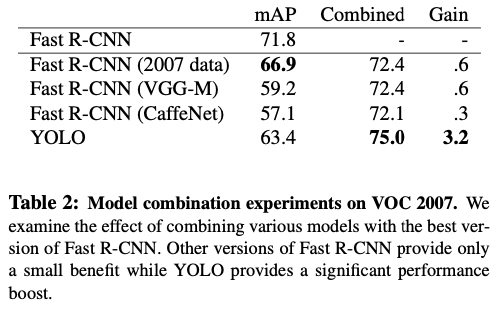 그렇다면 R-CNN과 YOLO 모델을 결합하면 background error와 localization error를 모두 낮출 수 있지 않을까? 결과적으로는 결합했을 때 더 좋은 성능이 나왔다!
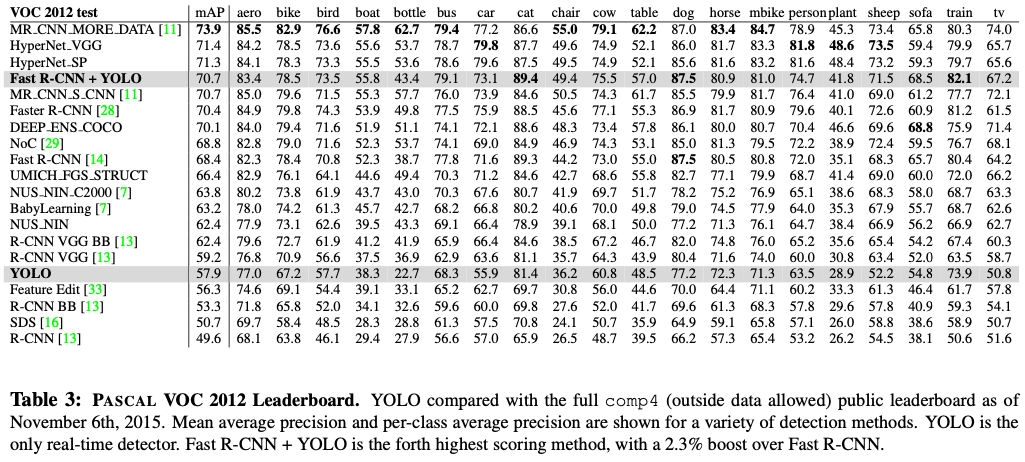 PASCAL VOC에서 성능을 보았을 때, 전반적으론 준수한 성능을 내지만 bottle, plant 등 작은 물체에 대해서는 성능이 많이 떨어진다.
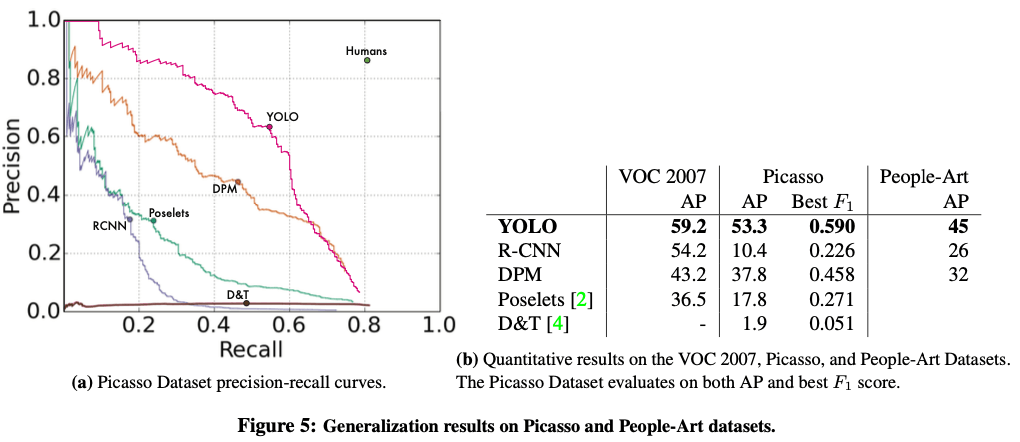
마지막으로 일반화 성능을 살펴보면, YOLO는 다른 데이터셋에서도 좋은 성능을 보인다. 반면 다른 모델들은 성능이 급격하게 떨어지는 모습이다.
모델 구현
이제 pytorch로 모델을 구현할 것인데, 우선 모델 architecture (DarkNet)와 Loss Function 부분만 구현해 보았다. 실제 훈련 과정에서는 ImageNet으로 pre-training 해야하며, inference 과정에서는 NMS 등의 추가적인 함수 구현이 필요하다. 깃허브
먼저 모델 전체 구조는 다음과 같은데, DarkNet 이후 2개의 fc layer가 구현된 모습이다. 특이한 점으로, YOLO에서는 activation function으로 LeakyReLU를 사용한다.
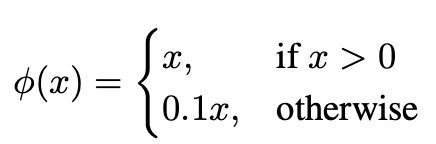
class CNNBlock(nn.Module):
    def __init__(self, in_channels, out_channels, **kwargs):
        super().__init__()
        self.conv = nn.Conv2d(in_channels, out_channels, bias=False, **kwargs)
        self.bn = nn.BatchNorm2d(out_channels)
        self.leakyrelu = nn.LeakyReLU(0.1)

    def forward(self, x):
        return self.leakyrelu(self.bn(self.conv(x)))

class Yolov1(nn.Module):
    def __init__(self, in_channels=3, **kwargs):
        super().__init__()
        self.architecture = architecture_config
        self.in_channels = in_channels
        self.darknet = self._create_conv_layers(self.architecture)
        self.fcs = self._create_fcs(**kwargs)

    def forward(self, x):
        x = self.darknet(x)
        return self.fcs(torch.flatten(x, start_dim=1))

    def _create_conv_layers(self, architecture):
        layers = []
        in_channels = self.in_channels

        for x in architecture:
            if type(x) == tuple:
                layers += [
                    CNNBlock(
                    in_channels, x[1], kernel_size=x[0], stride=x[2], padding=x[3])
                ]

                in_channels = x[1]

            elif type(x) == str:
                layers += [nn.MaxPool2d(kernel_size=2, stride=2)]

            elif type(x) == list:
                conv1 = x[0]
                conv2 = x[1]
                num_repeats = x[2]

                for _ in range(num_repeats):
                    layers += [
                        CNNBlock(
                        in_channels, conv1[1], kernel_size=conv1[0], stride=conv1[2], padding=conv1[3])
                    ]

                    layers += [
                         CNNBlock(
                         conv1[1], conv2[1], kernel_size=conv2[0], stride=conv2[2], padding=conv2[3])
                    ]

                    in_channels = conv2[1]

        return nn.Sequential(*layers)

    def _create_fcs(self, split_size, num_boxes, num_classes):
        S, B, C = split_size, num_boxes, num_classes
        return nn.Sequential(
            nn.Flatten(),
            nn.Linear(1024 * S * S, 4096),
            nn.Dropout(0.0),
            nn.LeakyReLU(0.1),
            nn.Linear(4096, S * S * (C + B * 5))
        )
Loss function 부분은 상당히 복잡하다. 먼저 IoU 함수를 구현하였으며, 이를 기반으로 위에서 설명한 세 가지의 loss가 결합된 loss function을 구현했다. 자세한 설명은 이 영상을 참고하면 큰 도움이 될 듯하다.
class YoloLoss(nn.Module):
    def __init__(self, S=7, B=2, C=20):
        super().__init__()
        self.mse = nn.MSELoss(reduction="sum")
        self.S = S
        self.B = B
        self.C = C
        self.lambda_noobj = 0.5
        self.lambda_coord = 5

    def forward(self, predictions, target):
        predictions = predictions.reshape(-1, self.S, self.S, self.C + self.B*5)

        iou_b1 = intersection_over_union(predictions[..., 21:25], target[..., 21:25])
        iou_b2 = intersection_over_union(predictions[..., 26:], target[..., 21:25])
        ious = torch.cat([iou_b1.unsqueeze(0), iou_b2.unsqueeze(0)], dim=0)
        iou_maxes, bestbox = torch.max(ious, dim=0)
        exists_box = target[..., 20].unsqueeze(3)

        ## Localization Loss
        box_predictions = exists_box * (
            bestbox * predictions[..., 26:30]
            + (1 - bestbox) * predictions[..., 21:25]
        )

        box_targets = exists_box * target[..., 21:25]

        box_predictions[..., 2:4] = torch.sign(box_predictions[..., 2:4]) * torch.sqrt(
            torch.abs(box_predictions[..., 2:4] + 1e-6))

        box_targets[..., 2:4] = torch.sqrt(box_targets[..., 2:4])

        # (N, S, S, 4) -> (N*S*S, 4)
        box_loss = self.mse(
            torch.flatten(box_predictions, end_dim=-2),
            torch.flatten(box_targets, end_dim=-2)
        )

        ## Confidence Loss
        pred_box = (
            bestbox * predictions[..., 25:26] + (1 - bestbox) * predictions[..., 20:21]
        )

        # (N*S*S)
        object_loss = self.mse(
            torch.flatten(exists_box * pred_box),
            torch.flatten(exists_box * target[..., 20:21])
        )

        # (N, S, S, 1) -> (N, S*S)
        no_object_loss = self.mse(
            torch.flatten((1-exists_box) * predictions[..., 20:21], start_dim=1),
            torch.flatten((1-exists_box) * target[..., 20:21], start_dim=1)
        )

        no_object_loss += self.mse(
            torch.flatten((1-exists_box) * predictions[..., 25:26], start_dim=1),
            torch.flatten((1-exists_box) * target[..., 20:21], start_dim=1)
        )

        ## Classification Loss
        # (N, S, S, 20) -> (N*S*S, 20)
        class_loss = self.mse(
            torch.flatten(exists_box * predictions[..., :20], end_dim=-2),
            torch.flatten(exists_box * target[..., 20], end_dim=-2)
        )

        ## LOSS
        loss = (
            self.lambda_coord * box_loss
            + object_loss
            + self.lambda_noobj * no_object_loss
            + class_loss
        )

        return loss
상세 코드: https://github.com/tony3ynot/YOLO-v1
마무리
YOLO 시리즈의 시초, YOLO v1을 정리해보았다. 현재 이보다 훨씬 발전된 모델들이 많지만 여전히 YOLO 기반의 시리즈가 계속 나온다는 점에서 가치가 높다. 또한 YOLO 만의 독창적인 아이디어와 그를 이론적으로 잘 뒷받침해주는 loss function에서 많은 것을 배울 수 있었다.
다만 object detection 쪽 분야는 이미 성능이 saturate된 면이 없지 않아 있어서 앞으로 더 깊게 공부해볼지는 약간 고민이 되는 부분이다.
그래도 이름 하나는 참 잘 지은 것 같다. You Only Live Look Once!
참고자료
Redmon, et al. "You Only Look Once: Unified, Real-Time Object Detection". 2016
YOLO v1 논문(You Only Look Once:Unified, Real-Time Object Detection) 리뷰
[16′ CVPR] YOLO v1 : You Only Look Once: Unified, Real-Time Object Detection