시나리오
여러 조각(parts)을 구분자 없이 이어 붙여 하나의 문자열을 만드는 join().
필요한 크기를 먼저 계산(joined_size)해 malloc 한 뒤, 각 조각을 순서대로 복사한다.
문제 풀이
1)
맨 처음 실행해보니 join()에서 문자열을 합치는 과정에서 SIGSEGV가 발생 확인.
bt로 어디에서 문제가 발생했는지 추적 시작
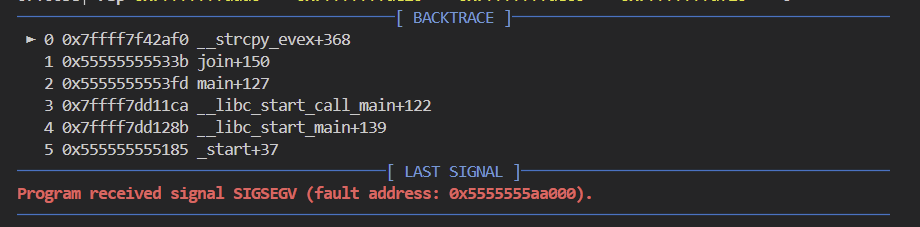
main -> join 타고 들어가서 strcpy 안에서 터짐 확인
2)
join 함수 내부로 들어가서 로컬 변수 찍어봄
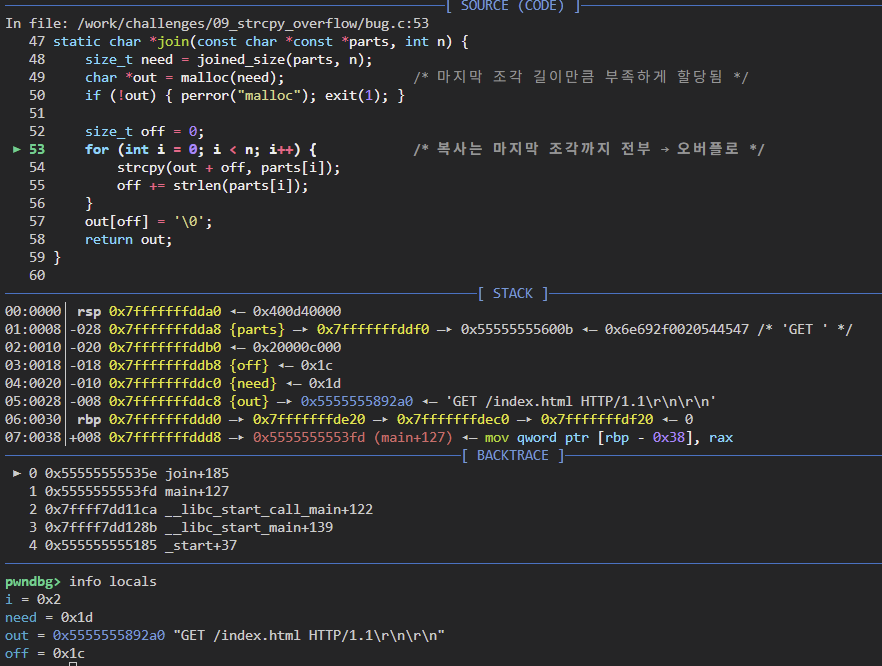
need = 0x1d (29)
off  = 0x1c (28)
out  = "GET /index.html HTTP/1.1\r\n\r\n"
i    = 2

need(malloc한 총 크기) = 29
off(이미 복사된 길이) = 28
→ 거의 꽉 찬 상태에서 i=3(body, 199999바이트)을 복사하려는 게 의심됨
3)
각 배열의 실제 길이를 gdb로 직접 찍어봄
pwndbg> p (size_t) strlen(parts[0])
$3 = 0x4

pwndbg> p (size_t) strlen(parts[1])
$4 = 0xb

pwndbg> p (size_t) strlen(parts[2])
$5 = 0xd

pwndbg> p (size_t) strlen(parts[3])
$6 = 0x30d3f
10진수로: parts[0]=4, parts[1]=11, parts[2]=13, parts[3]=199999.→ 4 + 11 + 13 + 1('\0') == 29 == need 랑 일치
△ 근데 parts[3](body, 199999)는 어디에도 안 더해짐
→ malloc은 29바이트만 받았는데, 복사 루프는 4개 전부(200028바이트) 쓰려고 함 → 너가 문제구만!
4)
joined_size() 소스 확인
static size_t joined_size(const char *const *parts, int n) {
    size_t total = 1;

    for (int i = 0; i < n - 1; i++) {
        total += strlen(parts[i]);
    }

    return total;
}n=4일 때 i < n-1이면 i는 0,1,2까지만 돎 → parts[3](마지막 원소 body)은 루프 진입조차 안 함
반면 join()의 복사 루프는 i < n 으로 4개 전부 복사
→ "크기를 재는 루프" != "실제로 쓰는 루프"
서로 다른 개수를 순회하고 있었던 게 원인
5)
정리해보면,
joined_size의 i < n-1 (마지막 원소 스킵)
→ need가 실제보다 작게 계산됨
→ malloc(need)가 필요한 것보다 훨씬 작은 힙 공간 확보
→ join의 복사 루프는 i < n으로 전부 복사 시도
→ body(199999바이트) 복사하는 순간 힙 버퍼 초과
→ strcpy 도중 SIGSEGV
5-1)
다른 곳도 괜히 의심해봄 ^.,^a
-
memset(body, 'x', sizeof body - 1);이 줄의-1도 처음엔 버그인 줄 알고 의심했음.
근데 확인해보니 오히려 반대로, 의도적으로 안전하게 짜인 코드였음.
body200000바이트를 전부'x'로 채우면 끝을 알리는 널 문자가 없어져서 문자열로 취급이 안 됨 → 그래서 마지막 1바이트를 일부러 비워뒀다가 바로 다음 줄에서body[sizeof body - 1] = '\0';로 채워줌.
→ 의심 가는 코드가 다 버그인 건 아니고, 이건 오히려 "자원을 안전하게 관리"한 좋은 예시였음. -
int n = (int)(sizeof(parts) / sizeof(parts[0]));도 처음엔 이게 뭐하는 코드인지 헷갈렸음.
parts[0]의 타입이const char*(포인터)라는 걸 놓쳐서sizeof(parts[0])이 1바이트인 줄 알았는데, 실제로는 포인터 크기(8바이트)라서 (배열 전체 바이트) / (포인터 하나 크기) = 원소 개수가 나오는 흔한 관용구였음. 버그랑 직접 관련은 없지만 헷갈렸던 부분.
6)
문제는 "덜 복사해서" 생긴 게 아니라, strcpy가 "너무 많이" 복사하려던 것.
strcpy는 자기가 받은 dst가 얼마나 큰지 전혀 모르는 채로 시키는 대로 복사했을 뿐이고,
진짜 잘못은 "공간을 준비하는 쪽"(joined_size)이 애초에 작게 계산한 것.
strcpy 대신 strncpy를 쓰면 되지 않을까?
strncpy(dest, origin, n)
: origin에 있는 문자열을 dest로 복사하되, 최대 n바이트까지만 복사하는 함수.
(str + n(number) + cpy → "n개만큼만 복사")
함수원형: char* strncpy(char* dest, const char* origin, size_t n);
strcpy보다 안전하다고 알려진 이유는, dest가 실제로 가진 공간의 크기(n)를
호출부에서 명시적으로 알려줄 수 있기 때문 → strcpy는 이런 제한이 아예 없음.
근데 이걸로 이 문제를 해결할 수 있을까?
여기서 n을 뭘로 넘기느냐에 따라 결과가 갈림:
-
n으로 그냥strlen(parts[i])(원본 길이)를 넘긴다면
→ strcpy랑 다를 게 없음. out에 남은 공간을 전혀 고려 안 한 거라 여전히 크래시 가능. -
n으로 "out에 실제로 남은 공간"을 정확히 계산해서 넘긴다면
→ joined_size의 n-1 버그를 그대로 둬도 크래시는 확실히 안 남.
strncpy는 n바이트를 넘는 쓰기 자체를 안 하니까 물리적으로 버퍼를 넘칠 방법이 없어짐.
근데 크래시가 안 난다고 문제가 해결된 건 아님.
남은 공간이 1바이트 정도밖에 없는 상태에서 body(199999바이트)를 복사하려 하면,
strncpy는 그 1바이트만 복사하고 나머지 199998바이트는 그냥 통째로 잘려나감.
→ 죽지는 않지만 body가 거의 다 날아간, 틀린 결과가 조용히 나오는 코드가 됨.
정리하면:
- 크래시 방지 관점: strncpy + 정확한 남은 공간 계산 = 확실히 효과 있음
- 문제 해결(올바른 결과 생성) 관점: 여전히 실패 — joined_size가 작게 계산한 값(29)이
진짜 필요한 값(200028)보다 작다는 근본 원인은 그대로 남고, 그 결과가
"크래시"에서 "데이터 유실"로 형태만 바뀐 것뿐
→ 이게 이 문제 해결을 위해 strncpy 대신 joined_size 자체를 고친 이유.
7)
그래서 joined_size()의 루프 범위를 join의 복사 루프와 동일하게 수정함
// 기존
for (int i = 0; i < n - 1; i++) {
    total += strlen(parts[i]);
}

// 수정
for (int i = 0; i < n; i++) {   /* n-1 -> n: join()의 복사 루프와 동일한 범위를 순회하도록 수정 */
    total += strlen(parts[i]);
}
n=4일 때 모든 parts의 길이를 계산하므로 필요한 크기는 4+11+13+199999+1(널문자) = 200028.
크기를 계산하는 로직과 실제 데이터를 쓰는 로직이 동일한 범위(i < n)를 순회하도록 맞춤.
malloc이 처음부터 정확한 크기(200028)를 확보하면 strcpy 자체는 원래부터 안전한 함수가 됨!
8) 수정 후 검증
joined length = 200027
\0을 제외한 길이이므로 4+11+13+199999=200027과 일치하고, 크래시 없이 정상 종료됨 확인.
이번 문제에서 가져갈 것
- strcpy가 무조건 위험한 함수라기보다는, 복사할 공간이 충분하다는 전제에서 동작하는 함수다. 이번처럼 malloc으로 잡은 공간의 크기가 잘못 계산되면 strcpy는 그 사실을 모르고 그대로 복사하다가 공간을 넘어가게 된다.
- 크래시가 사라졌다고 문제가 해결된 것은 아니다. strncpy처럼 복사 길이를 제한하는 방법으로 바꾸면 당장의 크래시는 피할 수 있지만, 근본 원인인 잘못된 크기 계산은 그대로 남는다. 오히려 데이터가 잘린 채 조용히 넘어가서 문제를 찾기 어려워질 수도 있다.
- 공간의 크기를 계산하는 로직과 실제로 그 공간을 사용하는 로직이 서로 다른 곳에 있다면, 두 로직의 범위가 일치하는지 확인해야 한다. 이번 문제처럼 한쪽은 n-1까지만 계산하고 다른 쪽은 n까지 사용하는 식의 불일치가 생길 수 있다.
- 루프 범위가 유독 다른 부분이 보인다면 “왜 여기만 범위가 다르지?”라고 한 번 더 확인해볼 필요가 있다. 특히 malloc 크기를 계산하는 부분과 할당된 공간을 실제로 채우는 부분은 함께 확인하는 습관을 들이자.
- 의심 가는 코드가 전부 버그는 아니다.
memset(... , sizeof body - 1)처럼, 오히려 자원을 안전하게 관리하기 위해 의도적으로 짜인 코드일 수도 있으니 "왜 이렇게 짰을까"부터 먼저 따져봐야 한다.