0. 당시 상황
블로그 서버를 만들고 있었고, 검색 기능도 함께 붙이고 있었다.
데이터가 적을 때는 검색이 잘 됬는데, 게시글을 늘려보니까 문제가 생겼다.
초기에는 DB에서 바로 검색했었다.
SELECT *
FROM post
WHERE title   LIKE CONCAT('%', :keyword, '%')
   OR content LIKE CONCAT('%', :keyword, '%')
ORDER BY created_at DESC
LIMIT :limit OFFSET :offset;
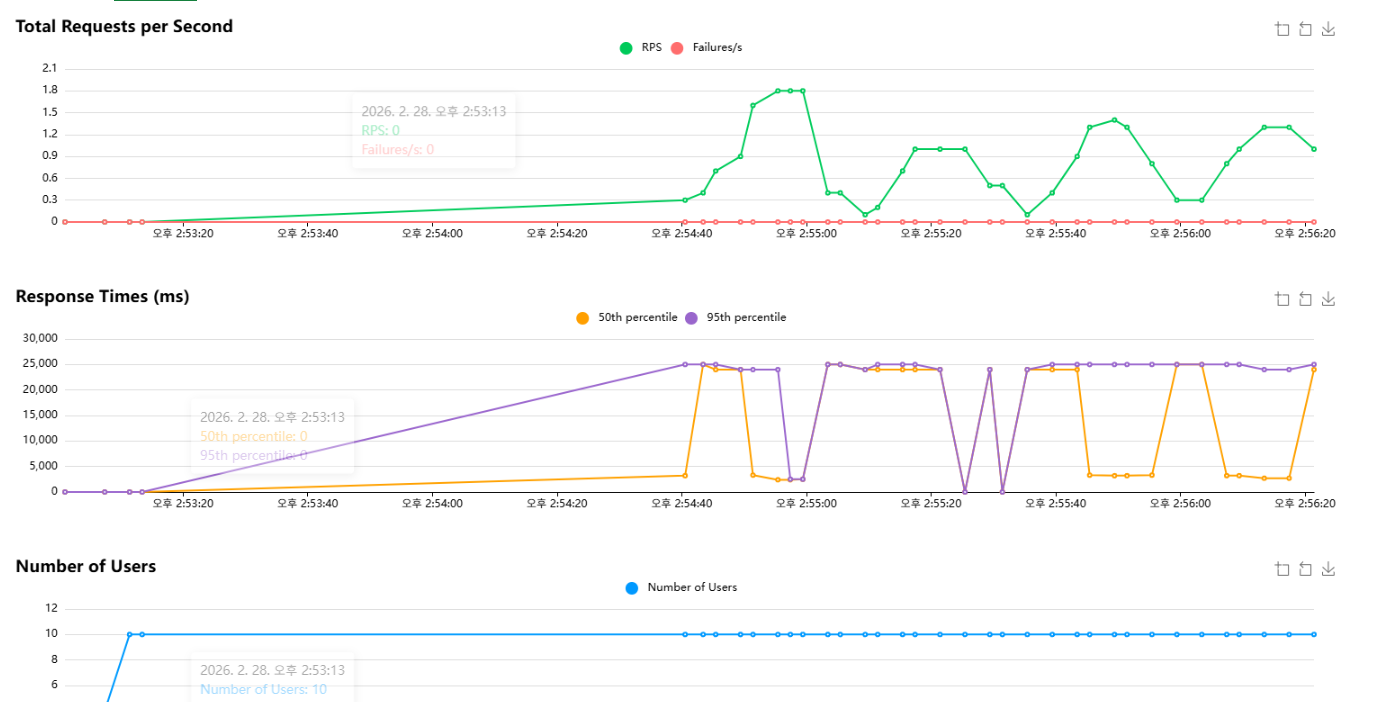
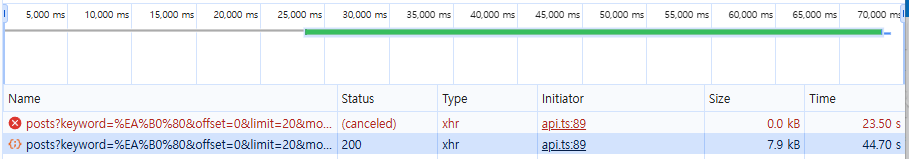
데이터가 커질수록 검색 응답시간이 급격히 늘어났고, 40초 이상 걸리는 구간도 나왔다.
0-1. 구현 흐름
- 검색 API:
GET /api/v1/search/posts?... - 검색 방식(초기 방법): MySQL
LIKE '%keyword%' - 정렬/페이징:
ORDER BY created_at DESC LIMIT/OFFSET
0-2. 실험 환경
- 앱: Spring Boot + JPA + MySQL8 + Tomcat
- 커넥션 풀: HikariCP
- 부하 도구: Locust
- 관측: access log, actuator metrics, MySQL, Elasticsearch/Kibana
0-3. 스펙
- CPU: 13th Gen Intel(R) Core(TM) i5-13500
- DB 분리 여부: 로컬 동일 머신
- Hikari 설정 maximumPoolSize: 10
0-4. 테스트 데이터 규모
데이터가 적었을때는 병목이 잘 보이지 않았다. 그래서 데이터 규모를 많이 크게 해서 확인해보았다.
- post 테이블: 약 990만 ~ 1,100만 건 규모 테스트
- 검색 요구사항: 부분 포함 검색 (%keyword%)
- 페이징: offset/limit
이 글은 위 조건에서 검색 병목을 관측하고, 여러가지 시도를 해보며 개선을 한 과정을 정리했다.
1. 부하 테스트 설계
같은 조건에서 검색 방식을 바꿨을 때 숫자로 비교했다.
1-1. 테스트 대상
검색 API (초기: MySQL 검색, 이후: ES 검색 API)
키워드 분포: 한글/영문 혼합
페이징 분포: offset=0, 1~200, 201~1000, 1001+
1-2. 성공/실패 기준
Locust
failure rate(실패율)
p95 / p99 응답시간
RPS 유지 여부
timeout 발생 여부
DB(MySQL)
EXPLAIN / EXPLAIN ANALYZE 결과
rows examined
filesort 여부
performance_schema / 상태 변수
서버/앱
access log 응답시간
HikariCP active / idle / pending
Tomcat thread / connection 메트릭
2. 원인 분석
LIKE '%keyword%'쿼리를 확인했다.
2-1. 왜 LIKE '%keyword%'가 문제일까
MySQL 공식문서의 B-Tree 인덱스 특성 설명에 따르면, LIKE 비교에서 인덱스는 상수 문자열이며 선행 와일드카드가 없는 경우에 사용할 수 있다. 반대로 LIKE '%Patrick%'처럼 선행 와일드카드가 있는 경우는 인덱스를 사용하지 않는 예시로 제시된다.
관련 문서: https://dev.mysql.com/doc/refman/8.4/en/index-btree-hash.html
그런데 %keyword%는 앞에 와일드카드가 있어서 시작점을 모른다. 그래서 B-Tree인덱스로는 범위 탐색에 불리하다.
- 인덱스로 빠르게 범위 탐색 못 함
- 테이블/인덱스를 넓게 훑음
- 조건 필터링
- ORDER BY 정렬
- OFFSET 있으면 앞부분을 읽고 버림
데이터가 커질수록 선형적으로 비싸지는 구조라고 생각했다.
2-2. EXPLAIN / EXPLAIN ANALYZE
EXPLAIN
SELECT
    p.post_id,
    p.title,
    p.created_at
FROM post p
WHERE p.post_status = 'PUBLISHED'
  AND p.deleted_at IS NULL
  AND p.title LIKE CONCAT('%', '검색', '%')
ORDER BY p.created_at DESC, p.post_id DESC
LIMIT 20 OFFSET 1000;
EXPLAIN ANALYZE
SELECT p.post_id, p.title, p.created_at
FROM post p
WHERE p.post_status = 'PUBLISHED'
  AND p.deleted_at IS NULL
  AND p.title LIKE CONCAT('%', '검색', '%')
ORDER BY p.created_at DESC, p.post_id DESC
LIMIT 20 OFFSET 1000;
-> Limit: 20 row(s) (cost=1.21e+6 rows=20) (actual time=6763..6763 rows=20 loops=1)
-> Sort: p.created_at DESC, p.post_id DESC, limit input to 20 row(s) per chunk (cost=1.21e+6 rows=10.9e+6) (actual time=6763..6763 rows=20 loops=1)
-> Filte...여기에서 확인한 것은
- type=ALL인가?(풀스캔 성향)
- key=NULL인가?
- Using where, Using filesort가 붙어 있는가?
- rows examined가 얼마나 큰가?
- actual time이 얼마나 나오는가?
확인한 결과 쿼리의 비용이 너무 크다고 생각했다.
3. 개선 가설과 실험 계획
3-1. 비교 후보
infix LIKE (%keyword%)
Prefix LIKE (keyword%)
MySQL Full-Text (기본)
MySQL Full-Text + ngram
Elasticsearch (전용 검색엔진)
3-2. 비교 포인트
- 실제로 검색 속도가 얼마나 빨라지나
- 한글 검색 퀄리티가 괜찮은가
- 운영하기 너무 복잡하지는 않나
4. infix LIKE (%keyword%)
일단 부분 포함 검색을 하고 싶어서 먼저 infix LIKE를 테스트 해보았다
4.1 %keyword%는 왜 위험한가?
MySQL 공식문서의 B-Tree 인덱스 특성 설명에 따르면, LIKE 비교에서 인덱스는 상수 문자열이며 선행 와일드카드가 없는 경우에 사용할 수 있다. 반대로 LIKE '%Patrick%'처럼 선행 와일드카드가 있는 경우는 인덱스를 사용하지 않는 예시로 제시된다.
https://dev.mysql.com/doc/refman/8.4/en/index-btree-hash.html
나는 LIKE '%keyword%'에 ORDER BY + OFFSET까지 붙으면서 비용이 엄청 커진 상황인것 같다.
4.2 Locust 테스트
타임 아웃을 90초로 늘려서 테스트 했다. 그 결과 infix 검색에서 60~70초대 응답시간도 확인됐다.
GET /search/posts/infix (offset=0)
- 평균 61,943ms
- p95 / p99 = 68,000ms / 68,000ms
GET /search/posts/infix (offset=1001+)
- 평균 65,939ms
- p95 / p99 = 71,000ms / 71,000ms
5. Prefix LIKE (keyword%)
대비 실험으로 prefix 검색도 같은 조건에서 확인했다.
EXPLAIN
SELECT
    p.post_id,
    p.title,
    p.created_at
FROM post p
WHERE p.post_status = 'PUBLISHED'
  AND p.deleted_at IS NULL
  AND p.title LIKE CONCAT('검색', '%')
ORDER BY p.created_at DESC, p.post_id DESC
LIMIT 20 OFFSET 1000;
5-1. prefix가 인덱스 후보가 맞는데 못탔다.
MySQL 공식문서 기준으로 B-Tree 인덱스는 LIKE 'abc%'처럼 선행 와일드카드가 없는 상수 문자열일 때 인덱스를 사용할 수 있다.
그런데 내 실험에는 아래처럼 나왔다.
type = ALL
key = NULL
rows = 10,852,380
Extra = Using where; Using filesort
나는 풀스캔 + filesort가 발생했다.
좀 더 찾아본 결과 아래 이유도 고려해야 한다고 한다.
- 옵티마이저는 조건 조합, 정렬, 선택도, 사용 가능한 인덱스 상태를 보고 계획을 정한다.
- MySQL 공식문서도 인덱스가 있어도 옵티마이저가 테이블 스캔을 선택할 수 있다고 설명한다.
5-2. EXPLAIN ANALYZE로 본 실제 비용 (prefix)
EXPLAIN ANALYZE
SELECT
    p.post_id,
    p.title,
    p.created_at
FROM post p
WHERE p.post_status = 'PUBLISHED'
  AND p.deleted_at IS NULL
  AND p.title LIKE CONCAT('검색', '%')
ORDER BY p.created_at DESC, p.post_id DESC
LIMIT 20 OFFSET 0;
-> Limit: 20 row(s) (cost=1.21e+6 rows=20) (actual time=5339..5339 rows=20 loops=1)
-> Sort: p.created_at DESC, p.post_id DESC, limit input to 20 row(s) per chunk (cost=1.21e+6 rows=10.9e+6) (actual time=5339..5339 rows=20 loops=1)
-> Filte...EXPLAIN ANALYZE에서도 prefix 쿼리는 가볍지 않았다.
prefix로 바꿨다고 해도 현재 스키마/실행계획에서는 대용량 스캔 + 정렬 비용이 아직 너무 크다는 것을 확인했다.
5-3. Locust 테스트
Locust 결과에서도 prefix가 기대만큼 빠르지 않았다.
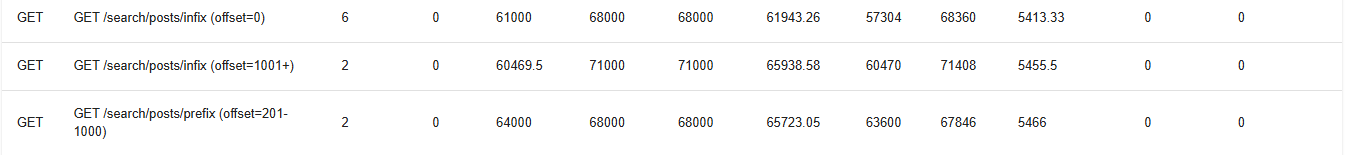
GET /search/posts/prefix (offset=200~1000)
- 평균 65,723ms
- p95 / p99 = 68,000ms / 68,000ms
5-4. prefix 정리
prefix LIKE는 B-Tree 인덱스를 탈 수 있는 형태가 맞다.
근데 내 실험 조건에서는 prefix도 EXPLAIN상 풀스캔/파일정렬로 나왔고, 부하 테스트에서도 병목이 해소되지 않았다.
그래서 prefix는 비교 기준점으로만 해보고, 이후 실험은 Full-Text / ngram / Elasticsearch로 넘어갔다.
6. MySQL Full-Text (기본)
LIKE '%keyword%' 병목을 확인한 뒤, 다음으로 시도한 것은 MySQL Full-Text 검색이었다.
목표는 단순했다.
- 풀스캔 성향을 줄일 수 있는지
- 실제 API 응답시간이 내려가는지
- 키워드(한글/영문)에 따라 어떤 차이가 나는지
6-1. Full-Text 인덱스 추가
ALTER TABLE post
ADD FULLTEXT INDEX ft_title_content (title, content);
6-2. MATCH ... AGAINST 사용해보기
SELECT post_id, title
FROM post
WHERE MATCH(title, content)
      AGAINST (:keyword IN NATURAL LANGUAGE MODE)
ORDER BY created_at DESC
LIMIT 20;
초기 가설은 이랬다.
- LIKE '%keyword%'보다 Full-Text가 유리할 가능성이 크다.
- 영문/공백 기반 검색에서는 개선될 가능성이 있다.
- 한글은 토큰화 방식 때문에 품질/성능 편차가 클 수 있다.
6-3. 수동 호출(브라우저 네트워크 탭)키워드별 속도
먼저 브라우저에서 키워드를 직접 넣어 호출해보니,키워드에 따라 시간이 크게 달랐다.
spring 검색: 약 13.75초

redis 검색: 약 8.98초

explain 검색: 약 1.20초

query 검색: 약 1.84초

Full-Text를 붙였다고 해서 일괄적으로 빨라지는 게 아니었다.
키워드에 따라 결과 건수(선택도), 토큰화 방식, 정렬 비용이 달라지면서 응답시간 편차가 나오는 것 같았다.
6-4. Locust 부하 테스트 결과 (Full-Text / Natural)
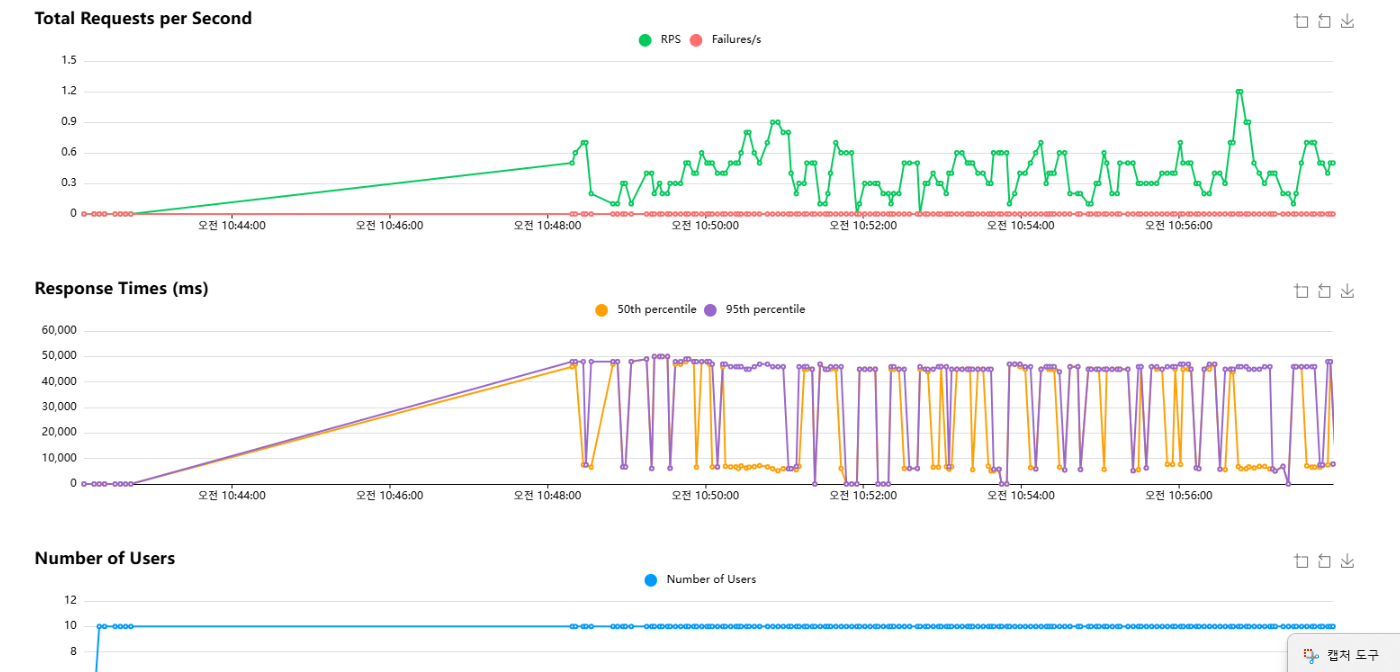
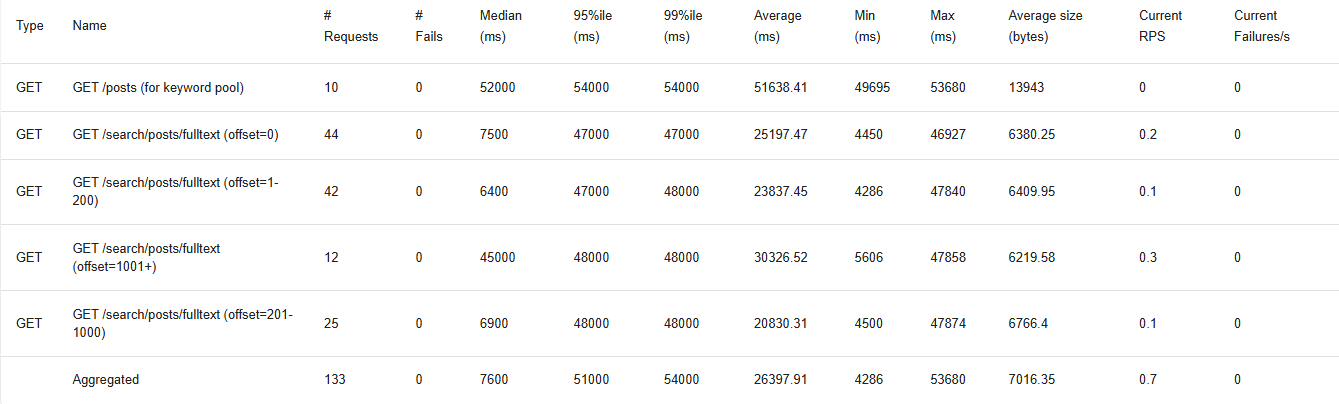
Locust로 같은 엔드포인트를 부하 테스트했을 때도 비슷한 패턴이 나왔다.
응답시간 분포가 넓었다. 키워드에 따라 편차가 있었다.
6-4-1. 초기 Locust 스크립트의 /posts 키워드 풀 요청도 매우 느렸다.
초기 테스트 스크립트에는 키워드 풀 갱신용 /posts 요청이 포함되어 있었는데, 이 요청 자체도 느려서 aggregate 수치를 제대로 나오지 않게 할 수 있던 것 같다.
그래서 이후로는 합계만 보지 않고, 검색 엔드포인트 row를 따로 보는 방식으로 정리해야겠다고 생각했다.
6-4-2. Full-Text 검색 엔드포인트 자체도 여전히 느리다.
동일 표에서 Full-Text 검색 API는 아래 수준이었다
GET /search/posts/fulltext (offset=0)- 평균 11,165.51ms
- p95 25,000ms
- p99 25,000ms
GET /search/posts/fulltext (offset=1~200)- 평균 12,805.45ms
- p95 25,000ms
- p99 25,000ms
GET /search/posts/fulltext (offset=201~1000)- 평균 14,099.95ms
- p95 26,000ms
- p99 26,000ms
GET /search/posts/fulltext (offset=1001+)- 평균 13,082.16ms
- p95 26,000ms
- p99 27,000ms
LIKE '%keyword%'보다 개선된 구간이 있더라도, 서비스 응답시간 관점에서 봤을 때 여전히 수 초~수십 초가 나오고 있었다. 내 목표에서는 아직 충분하지 않았다고 생각했다.
6-5. Full-Text 기본 파서에서 확인한 한계
이 실험에서 확인한 건 단순히 느리다/빠르다가 아니었다.
- 키워드별 편차가 매우 큼 (query는 몇초, spring/redis는 수십초까지)
ORDER BY created_at DESC + LIMIT/OFFSET가 붙으면서 정렬 비용이 계속 커짐- 한글/짧은 키워드는 검색 품질과 성능이 모두 불안정할 수 있음. 어떤 단어는 아예 안나오기도 하고 너무 느리기도 했다.
7. MySQL Full-Text + ngram
기본 Full-Text의 다음 후보는 ngram 파서였다.
한글 검색에서 찾아보니 많이 보여서 직접 해보고 싶었다.
- 기본 파서: 단어/공백 기반에 가까움
- ngram 파서: 문자열을 n-그램(예: 2글자 단위)으로 쪼개서 색인
한글 부분 검색 기대치에는 더 맞을 수 있다. 대신 인덱스/성능 비용이 늘어날 수 있다고 한다.
7-1. ngram 인덱스 생성
ALTER TABLE post
ADD FULLTEXT INDEX ft_title_content_ngram (title, content) WITH PARSER ngram;
7-2. 동일 쿼리로 비교
SELECT post_id, title
FROM post
WHERE MATCH(title, content)
      AGAINST (:keyword IN NATURAL LANGUAGE MODE)
LIMIT 20;
7-3. 브라우저에서 본 ngram/boolean 편차
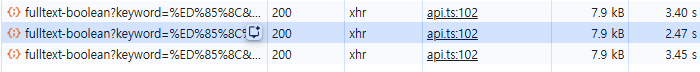
브라우저에서 FULL-TEXT-BOOLEAN 테스트를 해보니, 한글 키워드에서도 결과가 나오긴 하지만 편차가 매우 컸다. 어떤 키워드는 잘나오기도 했지만 아예 검색이 안되기도 하고, ngram없을때보다 더 느리게 나오기도 했다.
테스, 테 계열: 약 2.47초 ~ 3.45초
query: 약 12.33초

추적: 약 2.40초

쿼리: 약 55.68초

같은 모드에서도 키워드 선택도와 토큰 분해 결과에 따라 시간 편차가 매우 큰 걸 확인할 수 있었다.
7-4. Locust 결과 (Full-Text + ngram 키워드)
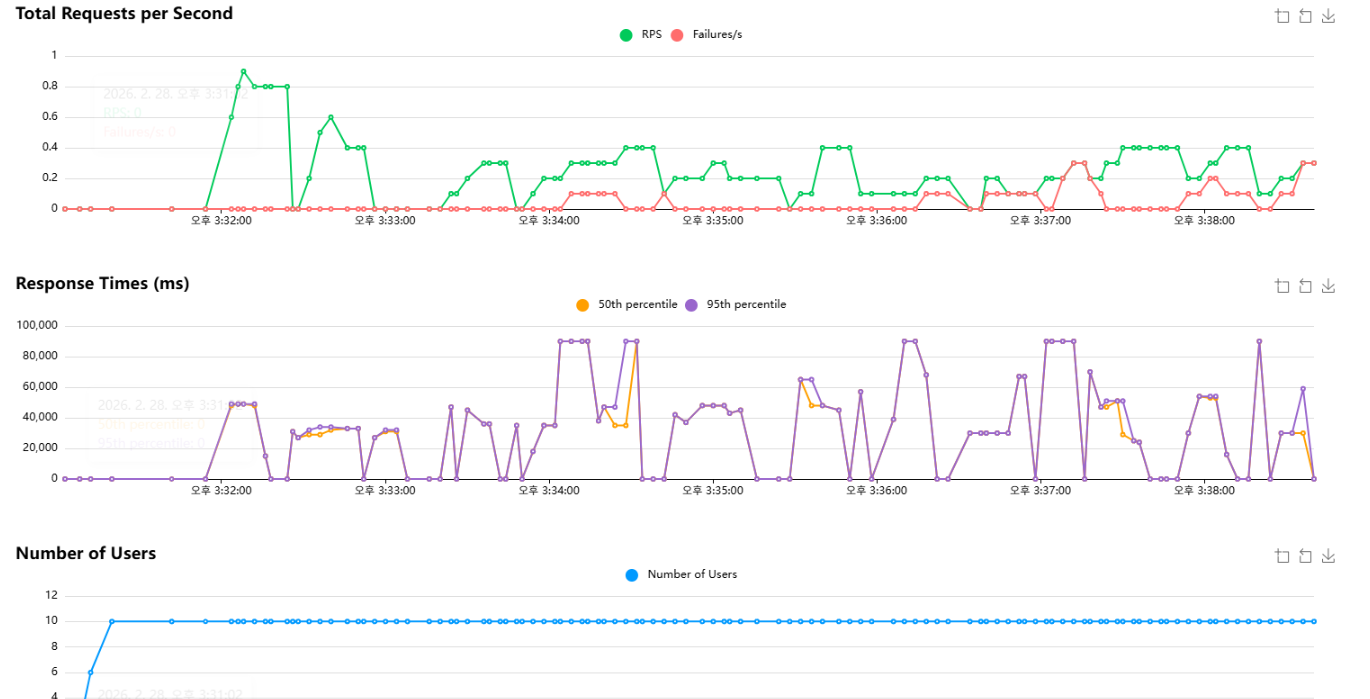
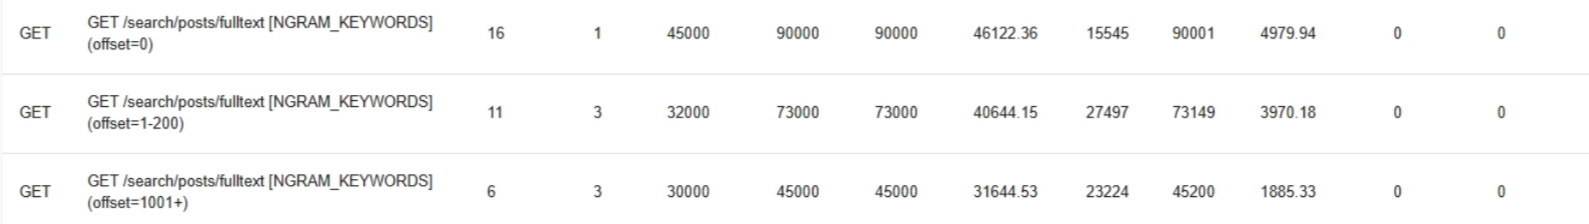
Locust에서도 NGRAM_KEYWORDS (한글 + 영어 키워드)로 분리해서 테스트했는데, 응답시간 분포가 더 거칠게 나왔다.
- offset=0
- 평균 46,122.36ms
- p95/p99 90,000ms / 90,000ms
- 최대 90,001ms
- offset=1~200
- 평균 40,644.15ms
- p95/p99 73,000ms / 73,000ms
- offset=201~1000
- 평균 29,365.20ms
- p95/p99 48,000ms / 48,000ms
- offset=1001+
- 평균 31,644.53ms
- p95/p99 45,000ms / 45,000ms
Locust 설정의 read timeout(90초)로 설정을 해놨기 때문에 90초동안 못받고 실패한 것이다.
7-5. Boolean 모드

Boolean 모드도 같이 테스트했지만, 키워드/offset에 따라 편차가 컸다.
-
GET /search/posts/fulltext-boolean (offset=0)- 평균 52,375.67ms
- p95/p99 90,000ms / 90,000ms
-
GET /search/posts/fulltext-boolean (offset=1~200)- 평균 52,556.51ms
- p95/p99 90,000ms / 90,000ms
오히려 키워드와 데이터 분포에 따라 극단적인 지연/타임아웃이 계속 발생했다.
7-6. ngram 정리
이번 실험에서 내 환경 기준으로 확인한 점은 다음과 같다.
- 기본 Full-Text에서 잘 안 맞는 부분 검색 기대치를 맞출 가능성이 있다.
- 짧은 한글 키워드는 후보가 많아질 수 있고 ORDER BY + OFFSET 비용과 겹치면 응답시간이 급격히 느려졌다.
- 키워드 편차가 상당히 크다.
ngram은 검색 품질 개선에는 유효할 가능성이 있었지만, 내 조건에서는 성능 안정성이 생각보다 나오지 않았다.
그래서 다음 단계로 Elasticsearch를 붙여 비교하게 되었다.
8. 정리
8-1. 증상
- LIKE '%keyword%' 검색에서 응답시간이 급격히 증가했다
- ORDER BY created_at DESC + LIMIT/OFFSET 조합으로 정렬/페이징 비용이 커졌다
- Locust에서 p95/p99가 빠르게 상승했고, 일부 구간은 타임아웃 상한에 걸렸다
- prefix LIKE(keyword%)도 이론상 유리할 수 있지만, 내 실험 조건에서는 EXPLAIN상 풀스캔(type=ALL, key=NULL)이 나왔다
- MySQL Full-Text / ngram도 적용해봤지만, 키워드/모드/offset에 따라 응답시간 편차가 매우 컸다 (+ 그래도 느렸다)
8-2. 이번 글 결론
이번 실험에서 확인한 핵심은 아래였다.
- 검색 병목의 출발점은 단순히 DB가 느리다가 아니라
LIKE '%keyword%' + 정렬 + OFFSET 의 비용이 상당히 컸다. - MySQL Full-Text와 ngram은 개선 가능성은 확인했지만, 나는 성능 안정성과 검색 품질이 좀 더 필요하다고 생각했었다.
- 데이터 규모와 요구사항에 맞는 검색 전략을 잘 선택해야 하겠다고 생각이 들었다.
8-3. 다음 글
그래서 다음 글에서는 Elasticsearch를 실제로 도입한 과정, DB데이터를 ES에 적재한 경험, 테스트 결과를 정리하려고 한다.
- 대량 적재 중 겪었던 문제들 (OFFSET 병목, document_id 덮어쓰기, 필드명 mismatch)
- MySQL → Logstash → Elasticsearch 재색인 과정
- Spring 검색 API 연동 시 발생한 매핑/날짜 파싱 이슈
- Locust로 확인한 ES 검색 성능 결과
개선 과정은 다음 글에 정리하겠습니다.