0. 왜 Elasticsearch를 도입하게 됐는가
1편에서는 MySQL 기반 검색을 단계적으로 비교했다.
LIKE '%keyword%'prefix LIKE ('keyword%')- MySQL Full-Text (기본)
- MySQL Full-Text + ngram
1편에서는 검색 결과 후보 수 + 정렬(ORDER BY) + OFFSET 페이징 + 동시성 부하가 합쳐진 비용이었다는 점이다.
MySQL Full-Text / ngram까지 적용해보면서 개선 가능성은 확인했지만, 내 환경에서는 아래 문제가 남았다.
- 키워드/모드/offset에 따라 응답시간 편차가 큼
- p95/p99 관점에서 성능 안정성이 부족함
- 일부 구간은 여전히 타임아웃 발생
- 한글 검색 품질과 성능을 동시에 맞추기 어려움
그래서 검색 부하를 DB에서 분리하고, 검색 전용 인덱싱/분석/튜닝이 가능한 Elasticsearch를 다음 단계로 선택했다.
1. 이번 글 내용 요약
이번 글에서는 Elasticsearch를 실제로 붙이면서 겪은 과정을 정리했다.
- MySQL => Logstash => Elasticsearch 재색인 과정
- 대량 적재 최적화와 병목 대응
- 재색인 중 발생한 트러블슈팅 (
document_id, 필드명, refresh 등) - Spring 검색 API 연동 시 발생한 매핑/날짜 파싱 이슈
- Locust로 확인한 Elasticsearch 검색 성능 결과
1편이 왜 DB 검색에서 병목이 생겼는지 다뤘고, 이번 글은 DB 데이터를 어떻게 옮겼고, 결과가 어떻게 바뀌었는지를 다룬다.
2. 도입 구조 (MySQL → Logstash → Elasticsearch)
Elasticsearch 도입 구조는 아래처럼 잡았다.
- MySQL: 원본 데이터 저장소
- Logstash (JDBC input): MySQL 데이터를 읽어 Elasticsearch로 적재
- Elasticsearch: 검색 인덱스 저장소
- Spring Boot API: 검색 요청을 Elasticsearch로 조회
즉, 검색 요청이 DB를 직접 때리지 않고, 검색 전용 인덱스(Elasticsearch) 를 조회하도록 분리했다.
2-1. 왜 Logstash를 선택했는가
대량 재색인을 빠르게 붙이는 게 먼저 목표였기 때문에, ETL 파이프라인을 코드로 직접 짜기보다 Logstash JDBC input을 사용했다.
장점:
- JDBC 기반으로 빠르게 구성 가능
- MySQL → ES 적재 파이프라인을 짧은 시간 안에 만들 수 있음
- 대량 적재 설정(
paging, batch, workers) 조절 가능
3. Elasticsearch 인덱스 적재 전략
3-1. 대량 적재 중 Elasticsearch 설정
대량 적재 중에는 검색 가시성보다 적재 성능이 중요해서 아래 설정을 사용했다.
refresh_interval = -1number_of_replicas = 0
이렇게 하면 인덱싱 중 refresh/replica 비용을 줄여 적재 성능을 높일 수 있다고 한다.
적재가 끝난 뒤에는 운영용 값으로 다시 돌려놓았다.
(refresh_interval='1s', replicas=0)
3-2. Logstash JDBC paging 사용
Logstash JDBC input에서 paging을 켰다.
jdbc_paging_enabled => truejdbc_page_size => 5000jdbc_fetch_size => 5000
처음에는 이걸로 충분할 줄 알았는데, 뒤로 갈수록 속도가 점점 느려지는 문제가 나타났다.
원인은 OFFSET 페이징 병목이었다.
4. 재색인 병목: Logstash JDBC OFFSET이 뒤로 갈수록 느려짐
Logstash JDBC paging은 내부적으로 LIMIT ... OFFSET ... 형태로 페이지를 가져오는데, 뒤 페이지로 갈수록 OFFSET 비용이 커진다.
[dac520dce07779dc404cec35c0fbaec9d88feb4eac871abdc56f519785748ee3] (1.893400s)
SELECT * FROM ( logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 840000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 940000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1040000 logstash_1-1 | [2026-02-28T23:23:27,400][INFO ][logstash.inputs.jdbc ][main]
[dac520dce07779dc404cec35c0fbaec9d88feb4eac871abdc56f519785748ee3] (2.203273s)
SELECT * FROM ( logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1140000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1240000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1340000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1400000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1440000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1540000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1640000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1740000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1840000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 1940000 logstash_1-1 | [2026-02-28T23:32:44,666][INFO ][logstash.inputs.jdbc ][main]
[dac520dce07779dc404cec35c0fbaec9d88feb4eac871abdc56f519785748ee3] (3.940005s) SELECT * FROM ( logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 2040000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 2140000 logstash_1-1 | ) AS t1 LIMIT 5000 OFFSET 2240000
1.8s => 2.2s => 3.9s
실제로 로그를 보면 뒤로 갈수록 같은 5000건을 가져오는 쿼리 시간이 증가했다. 하나의 Logstash로 1000만개를 하니 5000개당 10초수준으로 되기도 했다. 1편에서 검색 쿼리의 OFFSET 병목을 본 것과 비슷했다.
4-1. 해결: post_id 범위 분할 + 병렬 재색인
한 개 Logstash 파이프라인으로 끝까지 미는 대신, post_id 범위 기준으로 4분할해서 병렬 적재했다.
나는 1000만개의 row가 있기 때문에 250만개씩 분할 해서 적재했다.
- 1번:
post_id <= 2500000 - 2번:
2500000 < post_id <= 5000000 - 3번:
5000000 < post_id <= 7500000 - 4번:
post_id > 7500000
이렇게 하면 각 파이프라인이 처리하는범위가 줄어 OFFSET 깊이가 작아졌고, 재색인 속도가 훨씬 나아졌다.
4-2. 병렬 실행 시 주의점
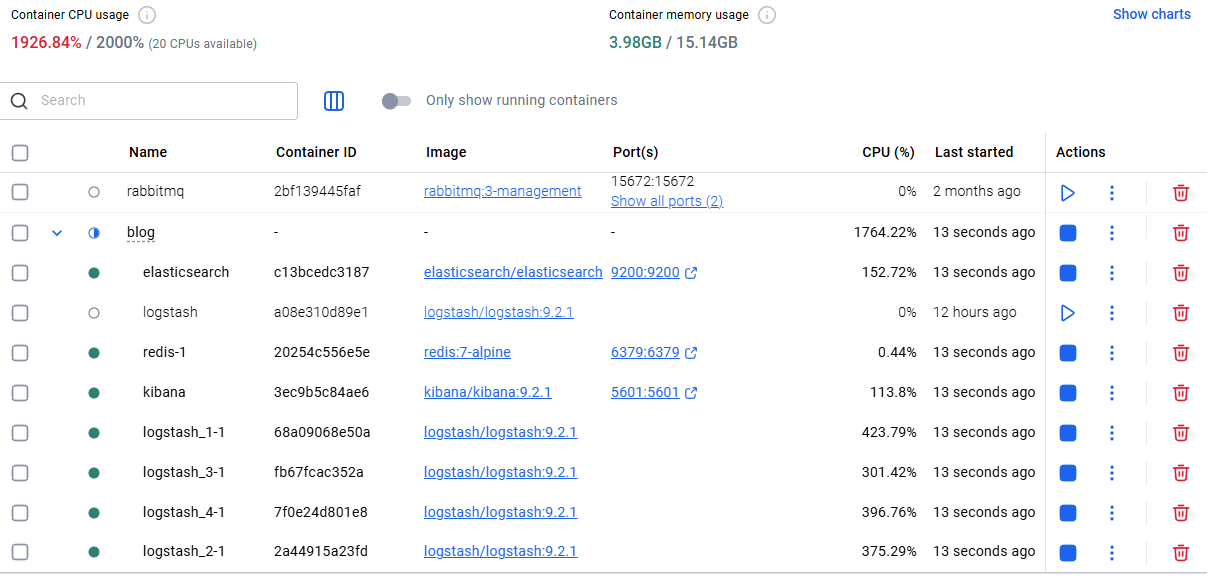
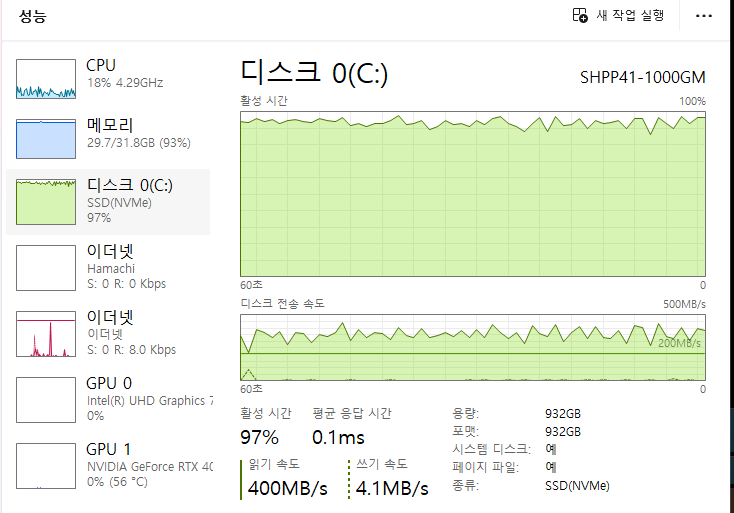
4개를 동시에 돌릴 때 기본 worker 설정으로 두면 오히려 로컬 리소스가 과포화될 수 있어서, 서비스별 pipeline workers를 줄여서 실행했다.
logstash_1:
  image: docker.elastic.co/logstash/logstash:9.2.1
  depends_on:
    - elasticsearch
  command: >
    logstash -f /usr/share/logstash/pipeline
    --pipeline.workers 2
    --pipeline.batch.size 200
  volumes:
    - ./logstash/pipeline-1:/usr/share/logstash/pipeline
    - ./logstash/mysql-connector-j.jar:/usr/share/logstash/mysql-connector-j.jar
병렬성은 늘리고 서비스당 과도한 worker를 줄이는 방식으로 조절해서 사용했다.
5. 재색인 트러블슈팅
성능 튜닝보다 더 시간을 잡아먹은 건, 재색인 중 데이터 정합성/필드명/가시성 문제였다.
5-1. Kibana 문서 수가 안 올라가 보였던 문제
Logstash 로그에서는 데이터가 많이 들어가는 것처럼 보이는데 Kibana 문서 수가 적게 보이는 상황이 있었다.
-
refresh_interval=-1영향- 대량 적재 중에는 바로 검색 가능 상태로 보이지 않을 수 있음
-
실제로 적재 건수가 적은 경우도 있음
_stats,_count,_cat/indices로 확인 필요
5-2. document_id 문제로 deleted만 폭증
재색인 중 1 document + deleted만 폭증하는 이상한 상태를 겪었다.
원인은 document_id에 넣은 필드명이 실제 이벤트 필드명과 달랐기 때문이었다.
예를 들어서 SQL에서는 AS postId로 alias를 줬지만, Logstash JDBC가 컬럼명을 소문자로 내리면서 실제 필드가 postid로 들어왔다.
그 상태에서 아래처럼 쓰면:
document_id => "%{postId}"치환에 실패해서 모든 문서가 같은 _id로 들어가고, 결과적으로 한 문서만 계속 덮어쓰기 되는 현상이 발생했다.
증상:
- Kibana 문서 수는 1개만 늘어났다.
deleted수치만 계속 증가, 감소하는 패턴이 보였다.
해결:
- 나는
document_id => "%{postid}"로 변경해서 해결 했다. lowercase_column_names => false사용해도 가능하다고 한다.
문제 원인 찾는 데 시간이 꽤 걸렸었다.
5-3. hosts => ["http://elasticsearch:9200"] vs localhost:9200
output {
  elasticsearch {
    hosts => ["http://elasticsearch:9200"]
    index => "post_search_v4"
    document_id => "%{postid}"
    action => "index"
  }
}
처음엔 localhost:9200로 써야 하는지 헷갈렸는데, Logstash가 Docker 컨테이너 안에서 돌고 있을 때는 localhost가 컨테이너 자기 자신을 가리킨다.
Docker Compose 네트워크에서 Elasticsearch 컨테이너 서비스명(elasticsearch)으로 접근하는 설정이 맞았다.
- 컨테이너 내부 Logstash →
http://elasticsearch:9200(정상) - 호스트에서 직접 실행하는 클라이언트 →
http://localhost:9200
6. 최종 적재 결과
필드명/document_id 문제를 정리하고 재색인을 다시 수행한 뒤, 최종적으로 post_search_v4 인덱스에 약 9,824,079건이 적재되었다.
Kibana 기준으로 문서 수와 저장 크기가 정상 범위로 올라오는 것을 확인했다.
- 인덱스:
post_search_v4 - Documents: 약 9,824,079
- Storage: 약 2.07GB (실험 기준)
재색인 문제는 해결했으니 이제 Spring 검색 API와 Elasticsearch 조회를 제대로 연결을 해야했다.
7. Spring 검색 API 연동과 쿼리 이슈
Elasticsearch 인덱스가 만들어졌다고 끝이 아니었다.
애플리케이션 코드와 실제 ES 문서 필드명이 맞지 않으면 검색이 바로 깨졌다.
7-1. all shards failed 발생
재색인한 문서의 필드명은 Logstash 문제를 해결하며 소문자로 바꿨었다.
postidcreatedatpoststatusviewcountlikecount
그런데 Spring 코드에서 예전 camelCase 기준으로 정렬/조회 필드를 쓰면, 예를 들어 createdAt 같은 필드로 정렬할 때 Elasticsearch에서 all shards failed가 발생할 수 있었다.
해결 방향:
- ES 쿼리에서 실제 필드명(
createdat,postid,poststatus) 사용 PostSearchDocument매핑에서@JsonProperty로 소문자 필드명 매핑
7-2. 날짜 파싱 이슈
필드명 문제를 해결한 뒤에는 날짜 파싱 이슈가 발생했다.
Elasticsearch에서 내려온 날짜 값은 아래처럼 Z(UTC offset)가 포함된 문자열이었다.
2026-02-25T09:52:02.000Z
처음에는 LocalDateTime.parse()로 바로 파싱했는데, Z를 처리하지 못해서 DateTimeParseException이 발생했다.
해결은 Instant.parse()(또는 OffsetDateTime.parse())로 먼저 파싱한 뒤, 필요한 시간대(예: Asia/Seoul)로 변환하는 방식으로 했다.
즉, Elasticsearch 연동에서는 성능 이전에 필드명/매핑/날짜 포맷 정합성을 맞추는 작업이 중요했다.
8. Elasticsearch 부하 테스트 설계
Elasticsearch 검색 성능을 깔끔하게 보기 위해, Locust 스크립트도 수정했다.
초기에는 /posts 목록 API를 같이 호출해서 키워드 풀을 만들었는데, 이 요청 자체가 aggregate 수치를 오염시킬 수 있었다.
그래서 최종 테스트에서는 ES 검색 API만 호출하도록 분리했다.
테스트 대상:
GET /api/v1/search/posts/es
분포:
- 키워드: 한글/영문 혼합 + 핫키워드
- offset:
0,1~200,201~1000,1001+
9. Elasticsearch 부하 테스트 결과 (Locust)
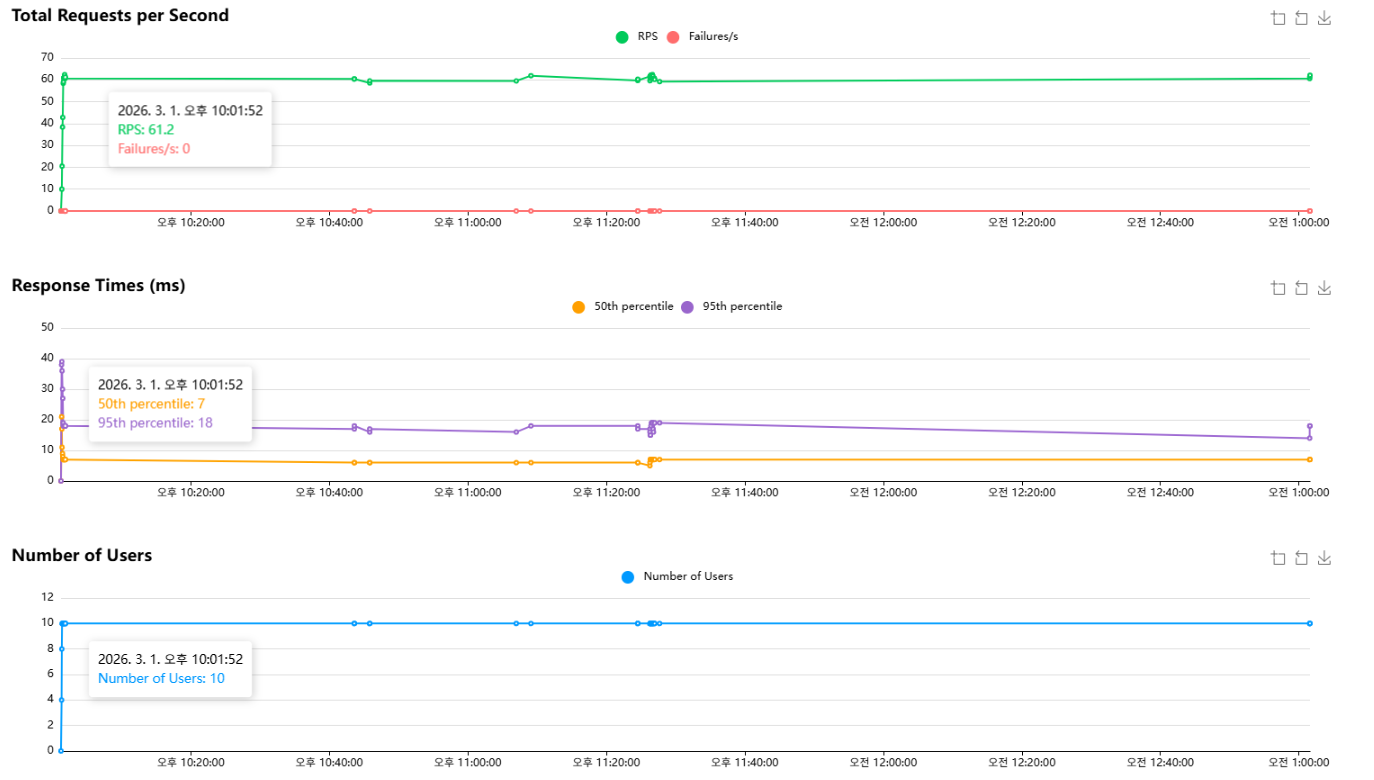
9-1. 전체 집계
실측 결과는 아래와 같았다.
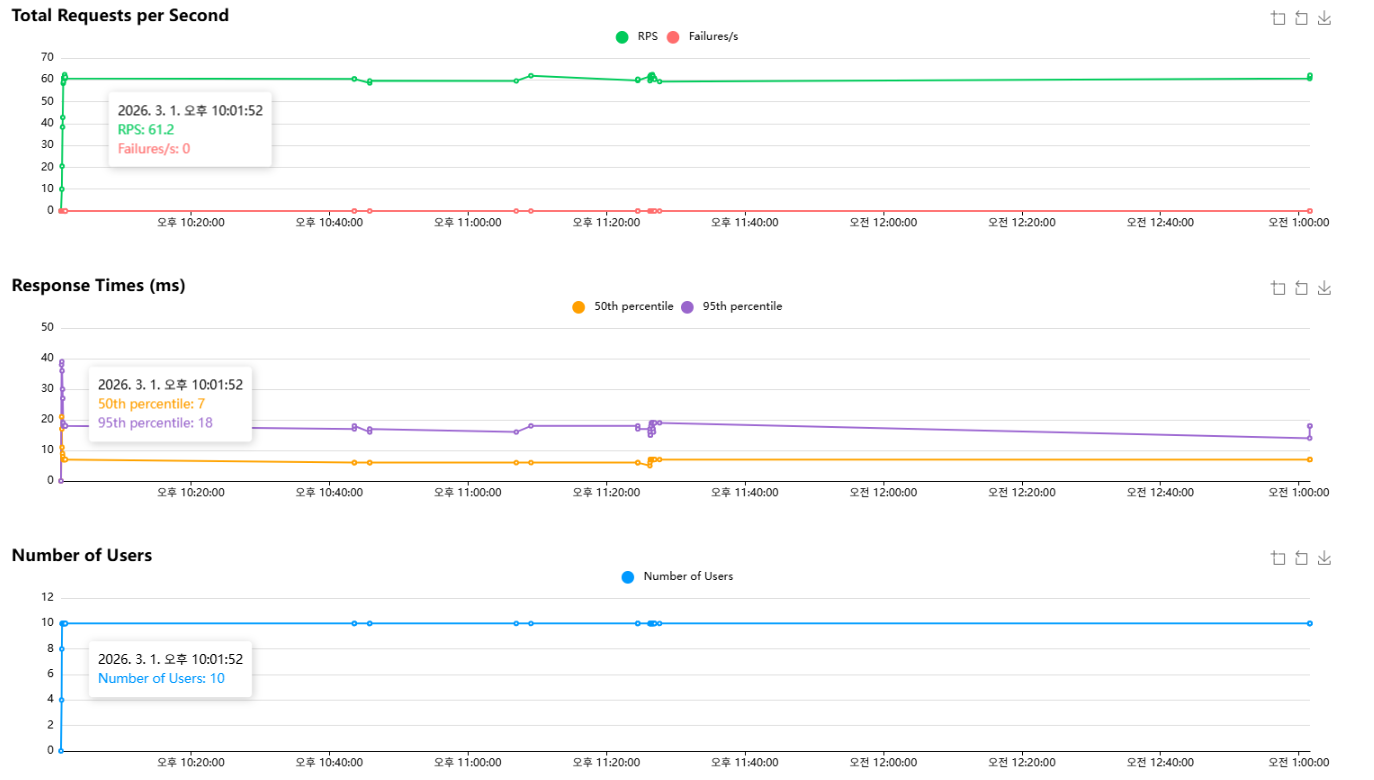
- 총 요청 수: 653,979
- 실패 수: 0
- 평균 응답시간: 8.69ms
- 중앙값(p50): 7ms
- p95: 18ms
- p99: 26ms
- 최대 응답시간: 178ms
- RPS: 약 62.1
1편에서 했던 MySQL 기반 검색 결과와 완전히 다른 차원이었다. 너무 빨랐다.
9-2. offset 구간별 결과
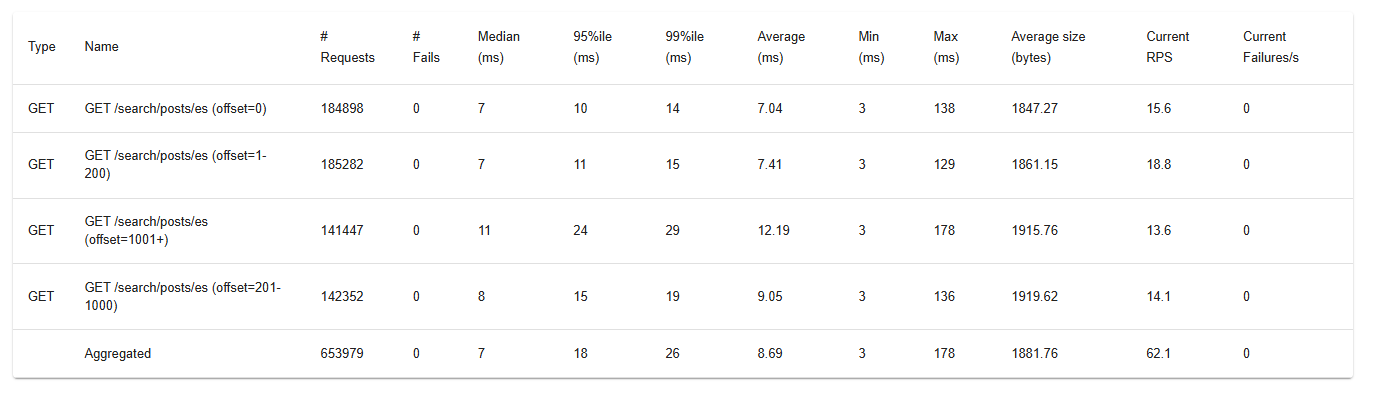
offset 구간이 커질수록 응답시간이 올라가는 패턴은 여전히 보였다.
-
offset=0- 평균 7.04ms
- p95 10ms
- p99 14ms
-
offset=1~200- 평균 7.41ms
- p95 11ms
- p99 15ms
-
offset=201~1000- 평균 9.05ms
- p95 15ms
- p99 19ms
-
offset=1001+- 평균 12.19ms
- p95 24ms
- p99 29ms
9-3. 해석
Elasticsearch로 바꿔도 from/size 기반 offset 페이징 비용은 완전히 사라지지 않았다.
offset이 커질수록 느려지는 패턴 자체는 남아 있었다.
- 실패율 0
- p95 18ms / p99 26ms
- RPS 안정적 유지
내가 원했던 건 평균값 몇 ms보다도 p95/p99와 timeout 안정성이었는데, 그 기준에서 Elasticsearch 도입 효과가 확실했다.
10. 최종 비교 요약
이번 실험에서 얻은 결론을 정리하면 아래와 같다.
LIKE '%keyword%': 구현은 단순하지만 대용량 + 정렬/offset 조합에서 병목이 크게 발생했다.- prefix LIKE: 이론상 인덱스 후보이지만, 내 실험 조건에서는 실행계획상 풀스캔 + 파일정렬
- MySQL Full-Text / ngram: 개선 가능성은 있지만 키워드/모드/offset 편차가 크고 안정성 부족 + 한글 검색 빈약
- Elasticsearch: 재색인/동기화/매핑 관리 비용은 늘지만, 제품 API 응답시간 안정성은 크게 개선
실험 한계와 해석 범위
이번 글의 비교는 내 데이터 분포 / 내 쿼리 구조 / 내 정렬·페이징 조건 / 내 튜닝 수준에서의 결과다.
MySQL Full-Text / ngram은 설정과 데이터 특성에 따라 결과가 달라질 수 있다.
따라서 이 글의 결론은 MySQL Full-Text/ngram이 항상 느리다가 아니라,
현재 조건에서는 키워드/모드/offset에 따른 편차가 크고, 내가 목표로 한 p95/p99·timeout 안정성을 만족시키기 어려웠다는 의미로 해석해야 한다.
11. 결론
Elasticsearch를 붙이고 나서 가장 크게 느낀 점은 두 가지였다.
-
검색 엔진 도입보다 어려운 건 데이터 이행과 정합성 관리다
- Logstash JDBC paging 병목
document_id덮어쓰기- 필드명 소문자화
- Spring-ES 매핑/날짜 파싱 이슈
-
최종 사용자 관점 성능은 확실히 개선됐다
- 1편의 MySQL 기반 검색은 최악 구간에서 수십 초 ~ 타임아웃
- 2편의 ES 기반 검색은 p95/p99가 수십 ms 수준으로 안정적
현재 데이터 규모와 검색 요구사항, 그리고 내가 중요하게 본 지표(p95/p99/timeout 안정성) 기준을 보고 내상황에서는 ES가 더 맞았던 선택인 것 같다.
12. 다음 개선 포인트
아직 해야할 것들이 많이 남았다.
from/size→search_after전환 (커서 기반 페이징)- 검색 품질 튜닝 (analyzer, ranking)
- 재색인 자동화/운영 개선
- MySQL ↔ ES 동기화 전략 정리 (최종적 일관성 포함)
다음 글에서는 search_after 적용 전/후 비교를 정리해보려고 한다.