Transformer를 만든 논문, Attention Is All You Need
Transformer? 자동차가 로봇으로 변신하는거?
당연히 그 로봇 트랜스포머는 아니다.
AI를 조금 공부하면 이 단어를 자주 만나게 된다. ChatGPT도 Transformer, BERT도 Transformer, 요즘 나오는 LLM도 대부분 Transformer를 기반으로 한다.
그런데 막상 Transformer가 뭔지 설명해보라고 하면 조금 애매해진다.
1: Transformer가 뭐야?
2: Attention을 사용하는 모델이야
1: Attention은 뭔데? 왜 써?
그래서 이번에 Transformer가 처음 등장한 2017년 논문, Attention Is All You Need를 읽어봤다.
이 논문의 아이디어는 상당히 센세이션하다
문장을 굳이 앞에서부터 하나씩 읽어야 할까?
당시 널리 사용되던 RNN과 LSTM을 아예 빼버리고, Attention만으로 문장을 처리해보자는 것이다.
1. Transformer 이전에는 문장을 어떻게 읽었을까?
예를 들어서 이런 문장이 있다고 해보자.
나는 어제 친구와 영화를 보고 집에 돌아왔다.
사람은 이 문장을 읽을 때 단어 하나하나를 완전히 독립적으로 이해하지 않는다.
돌아왔다를 보면 자연스럽게
- 누가 돌아왔지 ?? -> 나
- 언제 ?? -> 어제
- 뭘 했는데 ?? -> 영화를 보고
같은 관계를 동시에 생각한다. 그런데 당시 대표적인 방식이었던 RNN은 조금 다르다.
문장을 이런 식으로 순서대로 처리한다.
나는 → 어제 → 친구와 → 영화를 → 보고 → 집에 → 돌아왔다앞 단어를 처리한 결과가 다음 단어를 처리하는 데 사용된다.
h1 → h2 → h3 → h4 → h5 ...처럼 이전 계산이 끝나야 다음 계산을 할 수 있다. 문장이 짧을 때는 큰 문제가 아닐 수 있다.
하지만 문장이 길면? -> 앞부분의 계산이 끝나기를 계속 기다려야 한다.
GPU가 아무리 빨라도 문장 내부 계산 자체가 순차적이기 때문에 병렬화하기 어렵다.
Attention Is All You Need의 저자들은 이 부분을 RNN 계열 모델의 제약으로 짚었다.
그래서 아예 다른 방향을 생각했다.
각 단어가 문장 전체에서 필요한 정보를 직접 찾게 하면 안 될까?
여기서 Transformer가 시작됐다.
2. 지금 이 단어와 관련 있는 단어는 뭘까? ( Self-Attention )
이런 문장을 봐보자
나는 어제 시장에서 사과를 먹었다.
먹었다라는 단어를 이해할 때 어떤 단어를 참고하면 좋을까? 아마 사과를이 눈에 들어올 것이다.
기존 RNN에서는 정보가 앞에서부터 전달된다.
나는 → 어제 → 시장에서 → 사과를 → 먹었다Self-Attention에서는 먹었다가 문장 안의 다른 단어들과 직접 관련도를 계산할 수 있다.
예를 들어서 이런식이다.
나는		-> 관련도 낮음
어제		-> 조금 관련
시장에서 -> 조금 관련
사과를	-> 관련도 높음
그러면 모델은 먹었다를 표현할 때 사과를의 정보를 더 많이 참고할 수 있다.
Self-Attention은 이런 질문을 각 단어마다 하는 방식이라고 생각하면 편하다.
지금 이 단어를 이해하는데 어떤 단어가 얼마나 관련있을까?
논문에서는 Self-Attention을 하나의 sequence 안에 있는 서로 다른 위치 사이의 관계를 계산하는 Attention이라고 설명한다.
3. Q, K, V는 뭘까?
Transformer를 공부하다 보면 여기서 갑자기 세 글자가 등장한다.
Q, K, V
Query, Key, Value다.
이것은 검색이라고 생각하면 꽤 단순하다.
예를 들어서 갑자기 오디세이 원작 소설을 읽어보고 싶어졌다고 해보자. 서점에 가서 책을 찾을 것이다.
호메로스의 오디세이아 책을 찾고 싶다.
이게 Query다. 그리고 서점에는 수많은 책이 있다.
그리스 로마 신화
오디세이
일리아스
그리스 여행 가이드
영화 각본집
...
각 책에는 제목이나 카테고리처럼
나는 이런 책이야.
라고 알려주는 정보가 있다. 이것을 Key라고 생각할 수 있다.
내가 찾고 싶은 것(Query)과 책이 가진 정보(Key)를 비교하면,
Query: 오디세이 원작을 찾고 싶다

오디세이       → 관련도 매우 높음
일리아스       → 어느 정도 관련 있음
여행 가이드    → 관련도 낮음
이런 식으로 관련도를 계산할 수 있다. 내가 실제로 꺼내 읽을 책의 내용이 Value다.
정리하면 이렇다.
Query
내가 지금 무엇을 찾고 있는가?

        ↓ 비교

Key
각 정보는 무엇과 관련되어 있는가?

        ↓

	관련도 계산

        ↓

Value
실제로 가져올 정보Transformer도 문장의 각 단어에서 Q, K, V를 만들고 비슷한 일을 한다.
4. 논문에 나오는 Attention 수식도 같은 이야기다
Transformer의 유명한 수식이다.
처음 보면 꽤 많이 부담스러울 수 있다. 그래도 방금 서점 이야기를 생각해보면 쉽다.
먼저
QKᵀ를 이용해 Query와 Key가 얼마나 관련 있는지 계산한다.
그다음 softmax를 거치며 아래처럼 정보의 비중을 만든다. (중요도)
이 정보는 70%
저 정보는 20%
다른 정보는 10%
마지막으로 그 비중을 이용해 Value를 가져온다.
Q와 K 비교
   ↓
관련도 계산
   ↓
Softmax
   ↓
비중 결정
   ↓
Value를 비중만큼 가져오기
5. 왜 로 나눌까?
수식을 자세히 보면 QKᵀ만 있지 않다. 로 나눈다.
그래서 이름도 그냥 Dot-Product Attention이 아니라 Scaled Dot-Product Attention이다.
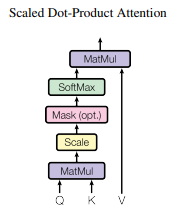
출처: Vaswani et al., Attention Is All You Need, NeurIPS 2017, Figure 2.
Q와 K의 차원이 커지면 dot product 값도 너무 커질 수 있다.
그 상태에서 softmax통과하면 결과가 한쪽으로 심하게 몰릴 수 있고, gradient도 매우 작아질 수 있다. 그래서 값이 너무 커지지 않도록 로 한 번 조절해준다.
Attention score가 너무 커지지 않도록 한 번 줄여준다.
정도로 이해해도 충분할 것이다.
6. Attention 하나로는 부족했나?
이런 문장을 보자.
민수는 영희에게 책을 빌려주었고, 그녀는 다음 날 책을 돌려주었다.
사람은 이 문장에서 여러 관계를 동시에 본다.
빌려주었다를 보면 민수와 연결되고, 그녀를 보면 영희와 연결되고, 돌려주었다를 보면 책과 연결된다.
문장 안에는 관계가 하나만 있는 게 아니다. 그래서 Transformer는 Attention을 하나만 사용하지 않는다. 여러 Attention을 동시에 돌린다.
이게 Multi-Head Attention이다.
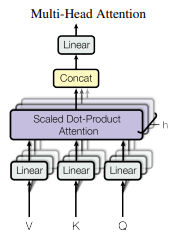
출처: Vaswani et al., Attention Is All You Need, NeurIPS 2017, Figure 2.
하지만
"Head 1은 주어 담당, Head 2는 목적어 담당"
처럼 사람이 역할을 정해놓는게 아니다. 모델이 학습하면서 서로 다른 위치와 서로 다른 표현을 바라보게 된다.
실제로 논문 뒤쪽의 Attention 시각화를 보면, 일부 Head가 멀리 떨어진 단어 사이의 관계를 포착하거나 문장의 구조와 관련된 서로 다른 패턴을 학습한 것을 볼 수 있다.
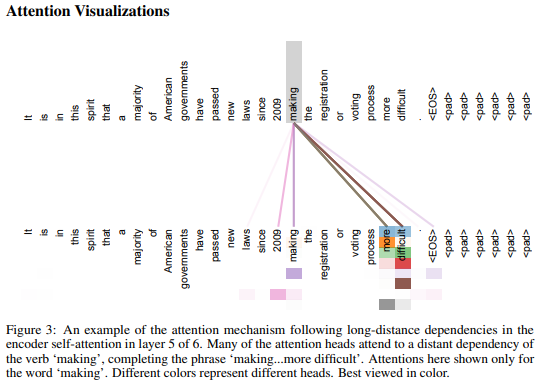
출처: Vaswani et al., Attention Is All You Need, NeurIPS 2017, Figure 3.
7. RNN을 없앴더니 문제가 하나 생겼다
지금까진 RNN을 없애면 모든 게 좋아지는 것처럼 보인다. 그런데 문제가 생겼다.
다음 두 문장을 보자.
개가 사람을 물었다.
사람이 개를 물었다.
사용된 단어는 거의 똑같다. 그런데 뜻은 전혀 다르다. 순서 때문이다.
RNN은 구조 자체가
1 → 2 → 3 → 4형태이기 때문에 자연스럽게 순서 정보가 들어간다. 그런데 Self-Attention은 여러 단어들을 동시에 바라본다.
모델 입장에서는
"그래서 이 단어가 몇 번째야?"
라는 정보가 필요하다. 그래서 Transformer는 Positional Encoding을 추가한다.
단어의 의미
Embedding

    +

문장에서의 위치
Positional Encoding

    ↓

Transformer
논문에서는 sine과 cosine 함수를 이용해 위치 정보를 만들어 입력 Embedding에 더해준다.
Transformer의 입력에는 무슨 단어인지 + 몇 번째 단어인지 가 함께 담긴다.
8. Transformer 그림을 보자
Transformer를 처음 검색하면 거의 반드시 이 그림을 보게 된다.
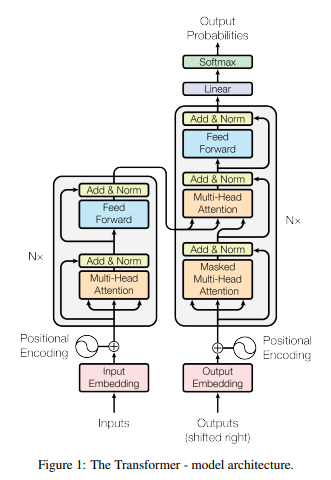
출처: Vaswani et al., Attention Is All You Need, NeurIPS 2017, Figure 1.
논문 3페이지에 나오는 Encoder-Decoder 그림이다.
Multi-Head Attention, Add & Norm, Feed Forward, Masked Multi-Head Attention이 한꺼번에 나와서 상당히 복잡해 보인다.
그래도 지금까지 이야기한 내용을 알고 보면 조금? 다르게 보일 수 있다.
Encoder쪽만 간단하게 줄이면 이렇다.
입력 문장
   ↓
Embedding
   +
Positional Encoding
   ↓
Multi-Head Self-Attention
   ↓
Feed Forward Network
   ↓
다음 Layer
논문에서는 이런 Encoder Layer를 6개 쌓았다.
각 Layer는 이런걸 한다.
1. Attention으로 단어들의 관계를 본다.

2. Feed Forward Network로
   각 위치의 정보를 다시 가공한다.
이 과정을 여러 번 반복한다.
9. Decoder에는 왜 Mask가 붙어 있을까?
논문의 Transformer 그림을 보면 Encoder에는 그냥 Multi-Head Attention이 있는데,
Decoder에는 Masked Multi-Head Attention 이라는 게 있다. Masked 라는 이름 그대로 뭔가를 가린다는 뜻이다. 왜 가릴까?
만약에 번역한다고 생각해보자.
I love this movie.
Decoder가 지금까지
나는 이
까지 만들었다면 다음 단어를 예측해야 한다.
근데 모델을 학습할 때 미래의 정답까지 미리 볼 수 있다면? 그건 사실상 답안지를 펼쳐놓고 문제를 푸는 것이다.
그래서 현재 단어보다 뒤에 있는 단어를 못 보게 가린다.
현재까지 생성한 단어 -> 볼 수 있음
미래에 생성할 단어   -> 볼 수 없음
이게 Masked Self-Attention이다.
10. 그래서 RNN보다 뭐가 좋았을까?
Transformer의 가장 큰 장점 중 하나는 병렬화였다.
RNN은 구조상
1 → 2 → 3 → 4 → 5처럼 앞에 계산이 끝나야 다음 계산으로 넘어갈 수 있다.
Self-Attention은 문장 안의 여러 위치에 대한 연산을 병렬화할 수 있다. 멀리 떨어진 단어를 연결하는 방식도 다르다.
RNN에서 첫 번째 단어의 정보가 마지막 단어까지 전달되려면 여러 단계를 거쳐야 한다.
A → B → C → D → E하지만 Self-Attention은 두 위치 사이의 관계를 바로 계산할 수 있다.
A ------------- E논문의 Table 1에서는 maximum path length를 다음처럼 비교한다.
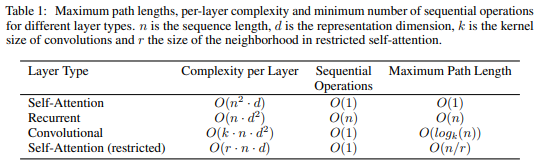
출처: Vaswani et al., Attention Is All You Need, NeurIPS 2017, Table 1.
순차 연산 수도 Self-Attention은 O(1), recurrent layer는 O(n)으로 분석한다.
그렇다고 Transformer가 언제나 RNN보다 계산량 자체가 적다는 뜻은 아니다.
Self-Attention은 sequence 길이에 대해 O(n²·d)의 계산 복잡도를 가진다.
문장이 아주 길어지면 Attention 자체의 계산량이 빠르게 커지는 문제가 있다.
Transformer의 강점은 단순히 연산량이 적어서가 아니라, 병렬화하기 쉽고, 멀리 떨어진 단어끼리 직접 관계를 계산할 수 있고, 번역 성능까지 잘 나온 것이다.
11. 실제 성능은?
RNN과 CNN까지 뺐는데, 성능은 오히려 어떻게 나왔을까?
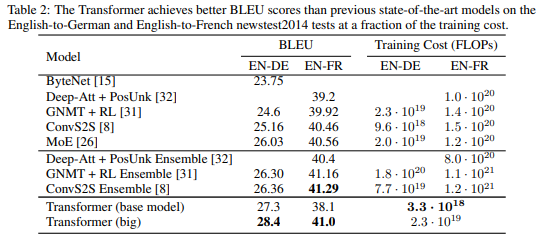
출처: Vaswani et al., Attention Is All You Need, NeurIPS 2017, Table 2.
논문에서는 WMT 2014 영어→독일어 번역 문제에서 Transformer Big이 BLEU 28.4를 기록했다. 당시 비교된 기존 최고 결과보다 2 BLEU 이상 높은 성능이었다.
RNN과 CNN을 뺀 구조였는데도, 당시 비교한 기존 모델보다 더 높은 성능을 냈다.
12. Attention을 만든 논문이 아니다
Attention Is All You Need라는 제목만 보면
그럼 이 논문에서 Attention이 처음 나온 건가?
라고 생각하기 쉽다. 근데 Attention은 이 논문 이전에도 이미 사용되고 있었다.
당시에는 주로 RNN / LSTM + Attention 처럼 기존 sequence model에 Attention을 함께 사용하는 방식이었다.
Transformer가 다른건 이거였다.
Attention이 이렇게 잘 되는데, RNN이 정말 필요할까?
그리고 RNN과 CNN을 제거했다.
기존 방식

RNN / CNN
   +
Attention


Transformer

Self-Attention
      +
Feed Forward
Transformer를 한 문장으로 설명하면?
문장을 반드시 앞에서부터 하나씩 처리하지 말고, 각 단어가 필요한 다른 단어를 직접 바라보게 하자.
그 방법이 Self-Attention이고, 그 Self-Attention을 모델의 중심으로 놓은 구조가 Transformer이다.
결국에 Transformer를 하나씩 뜯어보면 비슷한 질문으로 돌아온다.
"지금 이 단어를 이해하려면 어디를 봐야 할까?"
2017년에 나온 이 구조는 이후 BERT와 GPT 같은 모델로 이어졌고, 지금의 LLM을 이해할 때도 빠지지 않는 구조가 됐다.
논문 정보
이 글은 Vaswani et al.이 2017년 NeurIPS에서 발표한 「Attention Is All You Need」 논문을 읽고, 쉽게 이해할 수 있도록 제 방식대로 정리한 글입니다. 감사합니다.
- 논문명: Attention Is All You Need
- 저자: Ashish Vaswani et al.
- 발표: NeurIPS 2017
- arXiv: 논문 페이지
- PDF: 원문 PDF 보기
- NeurIPS: 공식 Proceedings
논문에 사용된 표와 그림은 원 논문에 명시된 이용 허가에 따라 출처를 표기하여 사용했습니다.
Source: Vaswani et al., Attention Is All You Need, NeurIPS 2017.