지난 글에서는 Transformer를 보면서 이런 질문에서 시작했다.
문장을 굳이 순서대로 읽어야 하나?
RNN은 문장을 앞에서부터 순서대로 읽었다. Transformer는 이 구조를 버리고 Self-Attention을 사용해서 각 단어가 다른 단어를 직접 볼 수 있게 만들었다.
그런데 Transformer가 NLP에서 그렇게 잘 된다면 이런 생각도 해볼 수 있다.
이미지도 Transformer로 보면 안 되나?
이미지 쪽에서는 이미 CNN이 너무 잘하고 있었다. AlexNet, VGG, ResNet 등을 거치면서 이미지를 처리한다면 CNN을 사용하는 게 거의 당연하게 여겨졌다.
그런데 2021년, 이런 논문이 등장한다.
An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale
이름부터 상당히 특이하다. 이미지가 16×16개의 단어라는 걸까?
그런 뜻은 아니다. 이 논문의 아이디어는 생각보다 단순하다.
이미지를 작은 조각으로 나누고, 그 조각들을 단어처럼 Transformer에 넣으면 안 될까?
이렇게 등장한 모델이 Vision Transformer, 줄여서 ViT다.
1. 그런데 이미지는 원래 어떻게 보고 있었지?
ViT를 보기 전에 CNN부터 다시 생각해보자.
예를 들어 크기가 224 × 224 × 3인 고양이 사진 하나가 있다고 해보자. 224 × 224는 이미지의 높이와 너비이고, 3은 RGB 채널을 의미한다.
CNN은 이 이미지를 처음부터 통째로 보는 게 아니다. 예를 들어 3 × 3 kernel을 사용한다면 이미지의 아주 작은 영역부터 본다.
전체 이미지

┌───────────────────────────┐
│                         │
│        ┌─────┐           │
│        │ 3×3 │          │
│        └─────┘           │
│                         │
└───────────────────────────┘
이 kernel이 이미지 전체를 이동하면서 각 위치의 픽셀 값과 kernel의 weight를 이용해 가중합을 계산한다. 학습을 반복하면 kernel의 weight도 계속 바뀌고, 어떤 kernel은 경계나 texture 같은 특정 패턴에 잘 반응하게 될 수 있다.
깊은 CNN에서는 앞쪽 layer에서 얻은 feature들이 다시 조합되면서 점점 복잡한 표현을 만든다. 아주 단순하게 생각하면 초반에는 edge나 texture 같은 비교적 단순한 특징을 잡고, 뒤로 갈수록 부분적인 형태와 더 복잡한 특징을 표현하게 된다.
물론 실제 신경망을 보고
"이 kernel은 정확히 고양이 귀를 찾는다."
라고 딱 잘라 말할 수 있는 건 아니다. 중요한 건 CNN이 작은 영역부터 특징을 만들어간다는 점이다.
2. 왜 CNN은 굳이 작은 영역부터 볼까?
여기서 질문이 하나 생긴다.
왜 굳이
3 × 3같은 작은 영역부터 보는 걸까?
생각해보면 이미지에는 꽤 강한 특징이 있다. 어떤 픽셀 하나가 물체의 어떤 부분인지 판단한다고 했을 때, 이미지 반대편 끝의 픽셀보다 바로 주변 픽셀이 더 중요할 가능성이 높다.
· · ·
· X ·
· · ·
예를 들어 고양이 눈에 해당하는 픽셀 주변에는 다른 눈 픽셀이나 털, 얼굴과 관련된 픽셀이 있을 가능성이 높다. 따라서 가까운 픽셀끼리 관계가 강할 것이다라는 가정은 꽤 합리적이다.
CNN은 이 생각을 모델의 구조 자체에 넣었다. 3 × 3 kernel을 사용한다는 것 자체가 모델에게 일단 주변부터 봐라고 알려주는 것과 비슷하다.
또 하나 있다. 어떤 kernel이 특정 특징에 잘 반응하게 학습되었다면 그 특징이 이미지 왼쪽 위에 있든 오른쪽 아래에 있든 비슷하게 잡아내는 것이 좋을 것이다. 그래서 CNN에서는 같은 kernel을 이미지 전체에 공유해서 사용한다.
        같은 Kernel
      ↙      ↓      ↘
    왼쪽     중앙    오른쪽
즉 CNN은 학습을 시작하기 전부터 이미지에 대해 어느 정도 힌트를 받고 있다.
가까운 픽셀끼리 중요할 것이다.
같은 특징이라면 위치가 바뀌어도 비슷하게 볼 수 있을 것이다.
이런 식으로 모델에 미리 넣어주는 가정을 Inductive Bias라고 한다. 이름은 어려운데 개인적으로는 모델에게 미리 주는 힌트 정도로 이해하면 편했다.
CNN은 이미지를 완전히 아무것도 모르는 상태에서 보는 것이 아니다. 이미지 처리에 유리한 규칙을 어느 정도 가지고 시작하고, 이러한 inductive bias 덕분에 상대적으로 적은 데이터에서도 잘 학습할 수 있다.
그런데 여기서 ViT가 재미있는 질문을 던진다.
이런 규칙을 우리가 꼭 미리 넣어줘야 할까?
3. Transformer는 조금 다르게 생각했다
다시 문장으로 돌아가보자.
The cat sat on the matTransformer의 Self-Attention에서는 cat이 반드시 바로 옆 단어만 볼 필요가 없다. 문장 안의 다른 token들과 직접 관계를 계산할 수 있다.
즉 누구와 관계가 중요한지는 모델이 직접 학습한다.
그러면 이미지도 이런 식으로 보면 안 될까?
CNN처럼 가까운 영역부터 보고 layer를 쌓으면서 점점 넓은 영역의 정보를 합치는 대신, 이미지의 서로 멀리 떨어진 영역도 처음부터 직접 관계를 계산하게 만드는 것이다.
왼쪽 위 영역 <----------------> 오른쪽 아래 영역문제는 하나다. Transformer는 원래 이미지를 입력받는 모델이 아니다.
4. 그럼 이미지를 어떻게 Transformer에 넣지?
Transformer가 받는 입력은 기본적으로 sequence다.
Token 1 → Token 2 → Token 3 → ... → Token N반면 이미지는 형태다. 예를 들어 224 × 224 × 3 크기의 이미지를 Transformer에 넣는다고 생각해보자.
가장 단순하게 생각하면 픽셀 하나를 token 하나로 만들 수도 있다. 하지만 그러면
개의 token이 생긴다.
Self-Attention은 token 사이의 관계를 계산하기 때문에 token 수가 이라면 계산량은 대략
으로 증가한다. 5만 개가 넘는 token을 모두 서로 보게 만드는 것은 너무 비싸다.
그래서 ViT에서는 픽셀 하나를 token으로 사용하지 않는다.
픽셀 하나 말고, 이미지의 작은 영역 하나를 token으로 쓰자.
이 작은 영역이 바로 Patch다.
5. 이미지를 Patch로 잘라보자
224 × 224 이미지를 16 × 16 크기의 patch로 자른다고 해보자. 가로와 세로에 각각 14개씩 들어가므로 총 patch의 개수는
개가 된다.
224 × 224 Image
        ↓
16 × 16 Patch로 분할
        ↓
196 Patches
이제 이 196개의 patch를 문장의 단어처럼 생각한다.
문장  : Word 1, Word 2, Word 3, ...
이미지: Patch 1, Patch 2, Patch 3, ...
이게 ViT의 핵심 아이디어다.
논문의 제목인 An Image is Worth 16×16 Words도 여기에서 나온다. 이미지가 정말 16 × 16개의 단어라는 뜻이 아니라, 16 × 16 pixel 크기의 이미지 조각을 하나의 단어처럼 다룬다는 의미다.
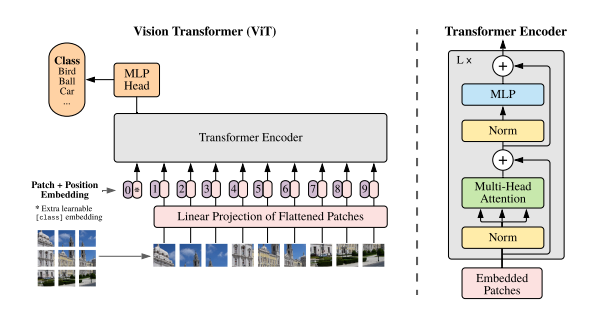
Figure 1. Vision Transformer의 전체 구조
이미지를 일정한 크기의 Patch로 나누고 Linear Projection한 뒤 Position Embedding을 더해 Transformer Encoder에 입력한다.
출처: Dosovitskiy et al., An Image is Worth 16×16 Words, ICLR 2021.
논문의 전체 구조를 보면 생각보다 단순하다. 이미지를 patch로 나누고 Transformer가 받을 수 있는 vector로 바꿔준 뒤에는 기존 Transformer Encoder를 거의 그대로 사용한다.
이제 그림의 앞부분부터 하나씩 뜯어보자.
6. 그런데 Patch를 그냥 Transformer에 넣을 수 있나?
아직 안 된다.
RGB 이미지에서 16 × 16 patch 하나에는
개의 값이 들어 있다.
우선 이 patch를 길게 펼치면 하나의 768차원 vector를 만들 수 있다.
16 × 16 × 3 Patch → Flatten → 768차원 Vector그리고 이 vector를 Linear Projection에 통과시켜 Transformer가 사용하는 차원의 vector로 바꿔준다.
Patch → Flatten → Linear Projection → Patch Embedding식으로 표현하면 대략 다음과 같다.
여기서 도 학습되는 weight다. 단순히 patch의 픽셀을 펼쳐서 그대로 사용하는 것이 아니라, 이 patch를 어떤 vector로 표현해야 분류에 유리한지도 학습 과정에서 같이 배우는 것이다.
이를 Patch Embedding이라고 한다.
이 과정은 NLP의 Word Embedding과 상당히 비슷하다.
NLP : Word        → Word Embedding  → Transformer
ViT : Image Patch → Patch Embedding → Transformer
Patch Embedding이 끝난 순간부터 Transformer 입장에서는 이 vector가 이미지에서 왔는지 문장에서 왔는지가 크게 중요하지 않다. 그냥 여러 개의 vector로 이루어진 sequence를 받은 것이고, 이제 이 vector들 사이에서 Self-Attention을 계산하면 된다.
7. 그런데 이미지에서 위치가 바뀌면 큰일 아닌가?
여기서 또 문제가 하나 생긴다.
얼굴에서 눈, 코, 입이라는 특징이 모두 존재하더라도 위치가 뒤섞이면 전혀 다른 이미지가 된다. 이미지에서는 무엇이 있는가뿐만 아니라 어디에 있는가도 중요하다.
하지만 Self-Attention 자체는 token이 원래 어디에 있었는지를 자동으로 알지 못한다. Transformer에서도 같은 문제가 있었고, 이를 해결하기 위해 위치 정보를 따로 추가했다.
ViT도 마찬가지로 Patch Embedding에 Position Embedding을 더한다.
Patch Embedding + Position Embedding → Transformer Input각 patch에게 너는 원래 이미지의 이 위치에 있었어라는 정보를 같이 주는 것이다.
ViT에서는 학습 가능한 Position Embedding을 사용한다. 흥미로운 부분은 처음부터 2차원 이미지의 구조를 아주 강하게 설계해서 넣어준 것이 아니라, 학습 과정에서 patch 사이의 위치 관계도 같이 배우게 했다는 점이다.
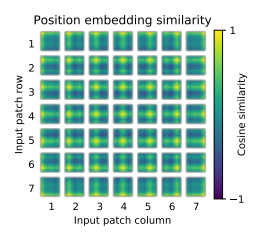
Figure 7 (Center). 학습된 Position Embedding의 유사도
출처: Dosovitskiy et al., An Image is Worth 16×16 Words, ICLR 2021.
실제로 학습이 끝난 Position Embedding을 확인해보면 가까이에 있는 patch들의 embedding이 서로 비슷해지고, 같은 행이나 열에 있는 patch 사이에서도 구조가 나타난다.
처음부터 복잡한 2차원 위치 규칙을 강하게 넣어주지 않았는데도 모델이 학습하면서 이미지의 2차원 공간 구조를 어느 정도 스스로 만들어낸 것이다.
8. 갑자기 [CLS]는 왜 나올까?
ViT 구조를 보면 patch들 앞에 [CLS]라는 특별한 token 하나가 붙어 있다.
[CLS] [P1] [P2] [P3] ... [P196]이 token도 다른 patch들과 함께 Self-Attention에 참여한다. Transformer layer를 여러 개 지나면서 [CLS]에는 이미지 전체를 분류하는 데 필요한 정보가 모이게 되고, 마지막에는 이 vector를 classifier에 넣어 고양이인지 강아지인지 등을 판단한다.
즉 [CLS]는 이미지 전체를 대표하는 token처럼 사용하는 것이다.
9. 여기까지 왔으면 이제 거의 Transformer다
전체 흐름을 다시 보면 다음과 같다.
Image
 → Patch
 → Flatten
 → Linear Projection
 → Patch Embedding + Position Embedding
 → [CLS] 추가
 → Transformer Encoder × L
 → [CLS]
 → Classifier
Transformer Encoder 내부도 기존 Transformer와 크게 다르지 않다. LayerNorm, Multi-Head Self-Attention, MLP와 Residual Connection이 반복된다.
결국 ViT에서 정말 중요한 아이디어는 엄청나게 새로운 Attention을 만든 것이 아니다.
이미지를 Transformer가 받을 수 있는 형태로 바꿔버렸다.
이미지를 patch들의 sequence로 만들고 나면 그 이후에는 기존 Transformer 구조를 거의 그대로 사용할 수 있다.
10. 근데 CNN도 작은 영역을 보고 ViT도 Patch를 보잖아?
여기서 나도 처음에 궁금했던 게 있다.
CNN도 작은 영역을 보는데 ViT도 이미지를 작은 patch로 자르면 둘이 비슷한 거 아닌가?
겉으로 보면 비슷해 보이지만 작은 영역을 사용하는 목적과 그 이후의 처리 방식이 다르다.
CNN에서는 작은 영역에 convolution을 적용해 local feature를 만들고, 그 feature에 다시 convolution을 적용하면서 점점 넓은 영역의 정보를 합친다.
CNN: Local → Local → Local → 점점 넓은 영역반면 ViT의 patch는 convolution을 수행하기 위한 영역이라기보다 하나의 token 단위다. patch가 token으로 변환된 이후에는 첫 Transformer layer부터 서로 멀리 떨어져 있는 patch 사이의 관계를 계산할 수 있다.
ViT: Patch → Token → Global Self-Attention예를 들어 이미지 왼쪽 위의 patch와 오른쪽 아래의 patch도 첫 layer부터 직접 Attention을 계산할 수 있다.
물론 CNN이 global 정보를 못 본다는 뜻은 아니다. CNN도 layer가 깊어지면서 receptive field가 커지고 결국 전체 이미지 정보를 사용할 수 있다.
차이는 전체 정보를 만들어가는 방식이다.
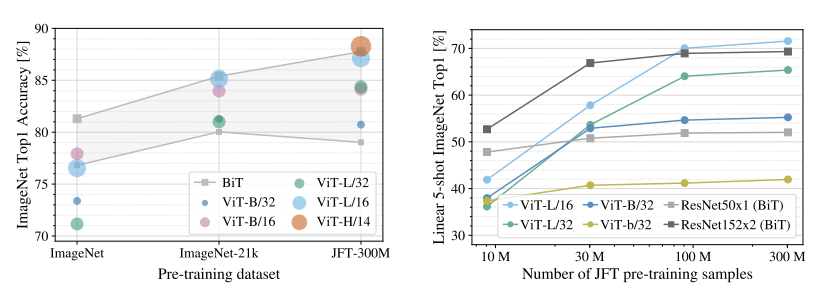
Figure 6. ViT의 Attention 시각화
출처: Dosovitskiy et al., An Image is Worth 16×16 Words, ICLR 2021.
논문에서는 실제로 ViT가 이미지의 어디에 Attention을 두는지도 확인했다. 강아지 사진에서는 강아지가 있는 영역, 비행기 사진에서는 비행기가 있는 영역처럼 분류에 의미 있는 부분에 Attention이 모이는 것을 볼 수 있다.
즉 patch들을 무작정 섞는 것이 아니라, 이미지 분류에 필요한 영역 사이의 관계를 실제로 학습하고 있는 것이다.
11. 그럼 ViT가 CNN보다 무조건 좋은 건가?
여기서 가장 조심해야 한다.
ViT 논문을 보고
CNN은 이제 필요 없다.
라고 이해하면 안 된다.
오히려 작은 규모의 데이터에서는 CNN이 상당히 강했다. 이유는 앞에서 봤던 Inductive Bias다.
CNN은 가까운 픽셀부터 보는 것이 좋다, 같은 특징은 위치가 달라져도 비슷하게 처리할 수 있다 같은 이미지에 유리한 힌트를 가지고 시작한다.
반면 ViT는 이런 이미지 전용 힌트가 상대적으로 적다.
조금 과장해서 표현하면 CNN은
이미지는 이런 특징이 있으니까 이런 방식으로 보면 좋아.
라는 힌트를 받고 시작하는 반면, ViT는
여기 Patch들이 있어. 어떤 관계가 중요한지는 데이터를 보고 네가 알아내.
에 더 가깝다.
따라서 데이터가 적을 때는 CNN이 유리할 수 있다. ViT는 이미지가 가진 구조 자체도 데이터에서 더 많이 학습해야 하기 때문이다.
실제로 논문에서도 작은 규모의 데이터에서는 ViT가 비슷한 크기의 ResNet보다 좋지 않았다.
그런데 데이터가 많아지면서 상황이 달라진다.
12. 데이터가 엄청 많아지면?
ViT 논문에서는 서로 다른 규모의 데이터로 pre-training을 진행했다.
| Dataset | 이미지 수 |
|---|---|
| ImageNet | 약 130만 장 |
| ImageNet-21k | 약 1,400만 장 |
| JFT | 약 3억 장 |
작은 데이터에서는 CNN의 inductive bias가 강력했다. 하지만 pre-training 데이터가 커지면서 ViT의 성능이 계속 올라갔고, 대규모 데이터에서는 굉장히 강력한 결과를 보여줬다.
즉 이 논문의 이야기는 단순히
Transformer를 이미지에 사용했더니 CNN보다 좋더라.
가 아니다.
오히려 다음 질문에 더 가깝다.
충분한 데이터가 있다면 사람이 미리 넣어준 규칙을 줄이고, 필요한 구조를 데이터에서 직접 배우게 할 수도 있지 않을까?
CNN은 강한 inductive bias를 가지고 있고 ViT는 상대적으로 그 bias가 적다. 대신 ViT는 그만큼 많은 것을 데이터에서 배워야 한다.
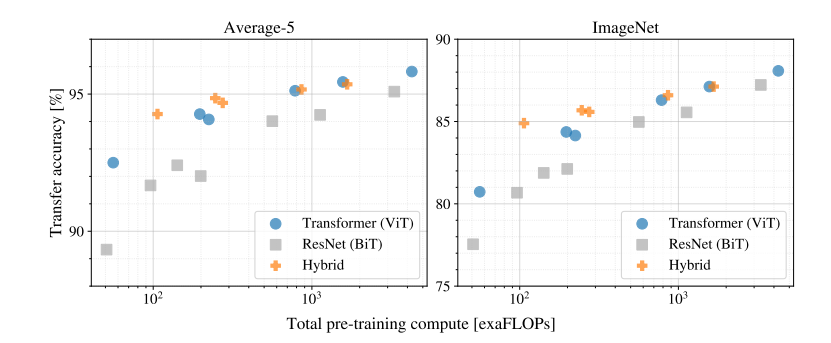
Figure 3, 4. Pre-training 데이터 규모에 따른 ViT와 ResNet의 성능 변화
출처: Dosovitskiy et al., An Image is Worth 16×16 Words, ICLR 2021.
이 두 그림이 사실 ViT 논문의 핵심 결과 중 하나다.
Figure 3을 보면 작은 데이터에서는 큰 ViT가 ResNet보다 좋지 않다. 하지만 ImageNet-21k를 거쳐 JFT-300M으로 pre-training 데이터가 커질수록 상황이 달라진다.
Figure 4에서는 이 차이가 조금 더 직접적으로 나타난다. 데이터가 적을 때는 ResNet이 강하지만 데이터의 규모가 커지면서 ViT의 성능도 계속 증가한다.
결국 작은 데이터에서는 CNN이 가지고 있는 inductive bias가 큰 도움이 되지만, 데이터가 충분히 많다면 필요한 이미지 구조를 모델이 데이터에서 직접 학습하는 것도 가능하다는 것이다.
13. 그러면 Patch 안에서 CNN을 쓰면 더 좋은 거 아닌가?
ViT를 보다 보면 이런 생각도 들 수 있다. 나도 이 부분이 처음에 궁금했다.
16×16 patch 안에서 convolution으로 특징을 먼저 뽑아주면 더 좋은 token을 만들 수 있지 않을까?
가능하다. CNN이 먼저 local feature를 뽑고 Transformer가 그 feature 사이의 관계를 학습하도록 만들 수 있다.
다만 patch를 먼저 완전히 잘라놓은 뒤 각각 독립적으로 convolution하는 것보다는 이미지 전체에 CNN을 적용한 후 만들어진 feature map을 Transformer의 token으로 사용하는 방식이 더 자연스럽다.
Image → CNN → Feature Map → Tokens → Transformerpatch를 먼저 잘라버리면 patch 경계에 걸린 local feature를 CNN이 한 번에 보기 어렵기 때문이다.
실제로 원래 ViT 논문에서도 ResNet + Transformer 형태의 Hybrid Architecture를 함께 실험했다. CNN이 local feature extraction을 담당하고 Transformer가 global relationship을 담당하는 식이다.
Figure 5. ViT, ResNet, Hybrid 모델의 Pre-training Compute 대비 성능
파란색은 순수 ViT, 회색은 ResNet, 주황색은 ResNet과 ViT를 결합한 Hybrid 모델이다.
출처: Dosovitskiy et al., An Image is Worth 16×16 Words, ICLR 2021.
그렇다고 CNN과 Transformer를 합치면 항상 더 좋은 것도 아니었다. 작은 computational budget에서는 Hybrid가 순수 ViT보다 조금 유리했지만, 모델과 계산 규모가 커질수록 그 차이는 거의 사라졌다.
결국 중요한 질문은 CNN이 좋냐 Transformer가 좋냐보다, 모델에 이미지에 대한 inductive bias를 얼마나 넣어줄 것이냐에 더 가깝다.
CNN을 앞에 붙이면 local feature를 쉽게 학습할 수 있도록 다시 강한 힌트를 주는 셈이고, 순수 ViT는 그런 가정을 줄인 대신 더 많은 것을 데이터에서 직접 학습한다.
14. Patch는 작을수록 좋은 거 아닌가?
16×16 patch보다 8×8 patch를 사용하면 이미지를 더 세밀하게 볼 수 있다. 그렇다면 patch를 그냥 최대한 작게 만들면 되는 걸까?
그렇게 간단하지는 않다.
224×224 이미지에서 32×32 patch를 사용하면
개의 token이 생기지만, 16×16 patch를 사용하면
개의 token이 생긴다.
patch가 작아질수록 이미지의 정보를 더 세밀하게 유지할 수 있는 대신 token의 개수가 크게 늘어난다. 문제는 Self-Attention의 계산량이 token 수에 대해 대략 으로 증가한다는 점이다.
즉 작은 Patch → 더 많은 Token → 더 세밀한 표현 → 더 큰 Attention 계산 비용이라는 trade-off가 있다.
그래서 ViT-B/16 같은 모델 이름에서 B는 Base 크기의 Transformer를, /16은 16 × 16 patch를 사용한다는 의미다. 같은 방식으로 ViT-L/32라면 Large 모델에 32×32 patch를 사용하는 구조라고 이해하면 된다.
15. 결국 ViT는 뭘 한 걸까?
처음 보면 ViT가 상당히 복잡해 보이지만 전체 흐름만 다시 보면 의외로 단순하다.
Image
 → Patch로 분할
 → Patch Embedding
 → Position Embedding 추가
 → Transformer Encoder
 → [CLS]
 → Classification
먼저 이미지를 여러 patch로 자르고, 각 patch를 Transformer가 사용할 수 있는 vector로 바꾼다. 여기에 위치 정보를 추가한 뒤 Transformer Encoder에 넣고, 마지막 [CLS] representation으로 이미지를 분류한다.
결국 ViT가 한 가장 중요한 일은 이미지를 단어들의 sequence처럼 바꿔 Transformer가 처리할 수 있게 만든 것이라고 볼 수 있다.
마치며
Transformer 논문에서는 이런 질문을 던졌다.
문장을 굳이 순서대로 읽어야 하나?
RNN이 당연하게 사용하던 순차적인 계산 방식을 버리고 Self-Attention이라는 다른 방법을 선택했다.
ViT도 비슷하다. Computer Vision에서는 CNN을 사용하는 것이 너무나 당연하게 여겨지고 있었는데, 여기서 다시 질문을 던졌다.
이미지를 굳이 CNN으로 봐야 하나?
그리고 이미지를 patch로 자른 뒤 각 patch를 단어처럼 Transformer에 넣었다. 기존 Transformer가 Word ↔ Word의 관계를 봤다면 ViT에서는 Patch ↔ Patch의 관계를 보는 셈이다.
처음에는 조금 이상해 보인다. CNN은 이미지에 정말 잘 맞는 구조이고 이미지에는 실제로 locality 같은 성질도 존재한다. 그런데 ViT는 이런 가정을 상대적으로 줄이고, 대신 많은 데이터를 통해 어떤 관계가 중요한지를 직접 학습하게 만들었다.
그리고 데이터의 규모가 충분히 커지자 이 단순한 방식이 굉장히 강력해졌다.
그래서 개인적으로 이 논문의 핵심은
Transformer를 이미지에도 사용할 수 있다.
라는 사실보다도 다음 질문에 더 가까운 것 같다.
우리가 모델에 당연하게 넣고 있던 구조는 정말 반드시 필요한가?
기존 CNN을 조금 수정하는 것이 아니라, 이미지를 바라보는 방식 자체를 다시 생각했다는 점에서 재미있는 논문이었다.
논문 정보
이 글은 Dosovitskiy et al.이 2021년 ICLR에서 발표한 「An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale」 논문을 읽고, 쉽게 이해할 수 있도록 제 방식대로 정리한 글입니다. 감사합니다.
- 논문명: An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale
- 저자: Alexey Dosovitskiy et al.
- 발표: ICLR 2021
- arXiv: 논문 페이지
- PDF: 원문 PDF 보기
- ICLR: 공식 발표 페이지
- Google Research: 공식 연구 페이지
본문에 사용된 논문의 표와 그림에는 원 출처를 함께 표기했습니다.